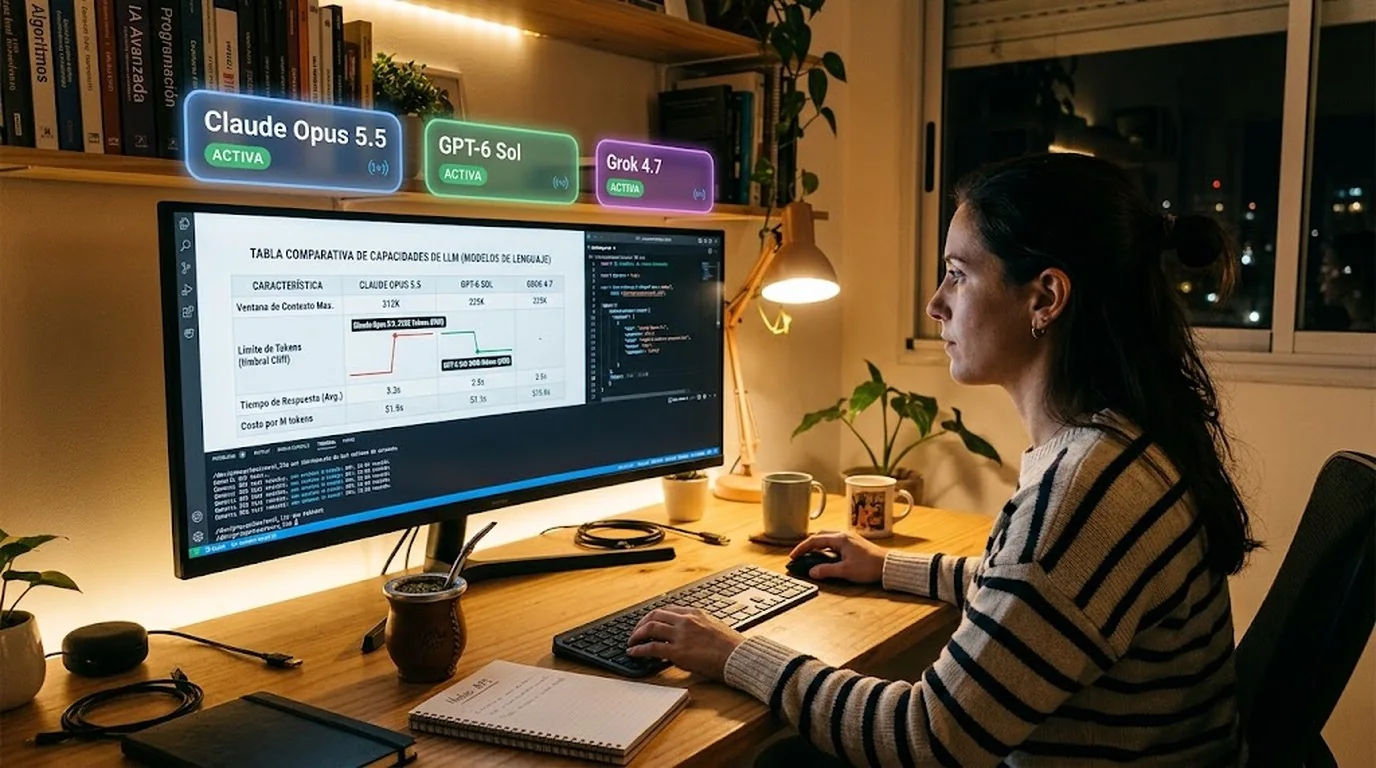
En pocas palabras: Entre el 21 y el 22 de septiembre de 2026 salieron Grok 4.7, Claude Opus 5.5 y GPT-6 Sol/Luna. Cambiar de modelo entre ellos ya no es editar un string: implica revisar protocolo de request, cliff de contexto largo (272.000 tokens en GPT-6 Sol, 200.000 en Grok 4.7), effort por defecto y consumo real de tokens.
Entre el 21 y el 22 de septiembre de 2026, SpaceXAI, Anthropic y OpenAI lanzaron tres modelos de IA en menos de 48 horas: Grok 4.7, Claude Opus 5.5 y GPT-6 Sol/Luna. Cambiar de modelo IA entre estas versiones dejó de ser editar un string en el código: ahora implica revisar protocolo de request, límite de contexto largo, nivel de esfuerzo por defecto y consumo real de tokens.
Cambiar de modelo IA es el proceso de migrar una aplicación de producción de un modelo de lenguaje a otro actualizando el identificador en la API. Con los lanzamientos casi simultáneos de Claude Opus 5.5, GPT-6 Sol y Grok 4.7, la migración exige ajustar protocolo, umbral de contexto largo, effort y presupuesto de tokens, no solo cambiar el campo model.
En este artículo:
- En 30 segundos
- ¿Qué tres modelos de IA lanzaron Anthropic, OpenAI y SpaceXAI en menos de 48 horas?
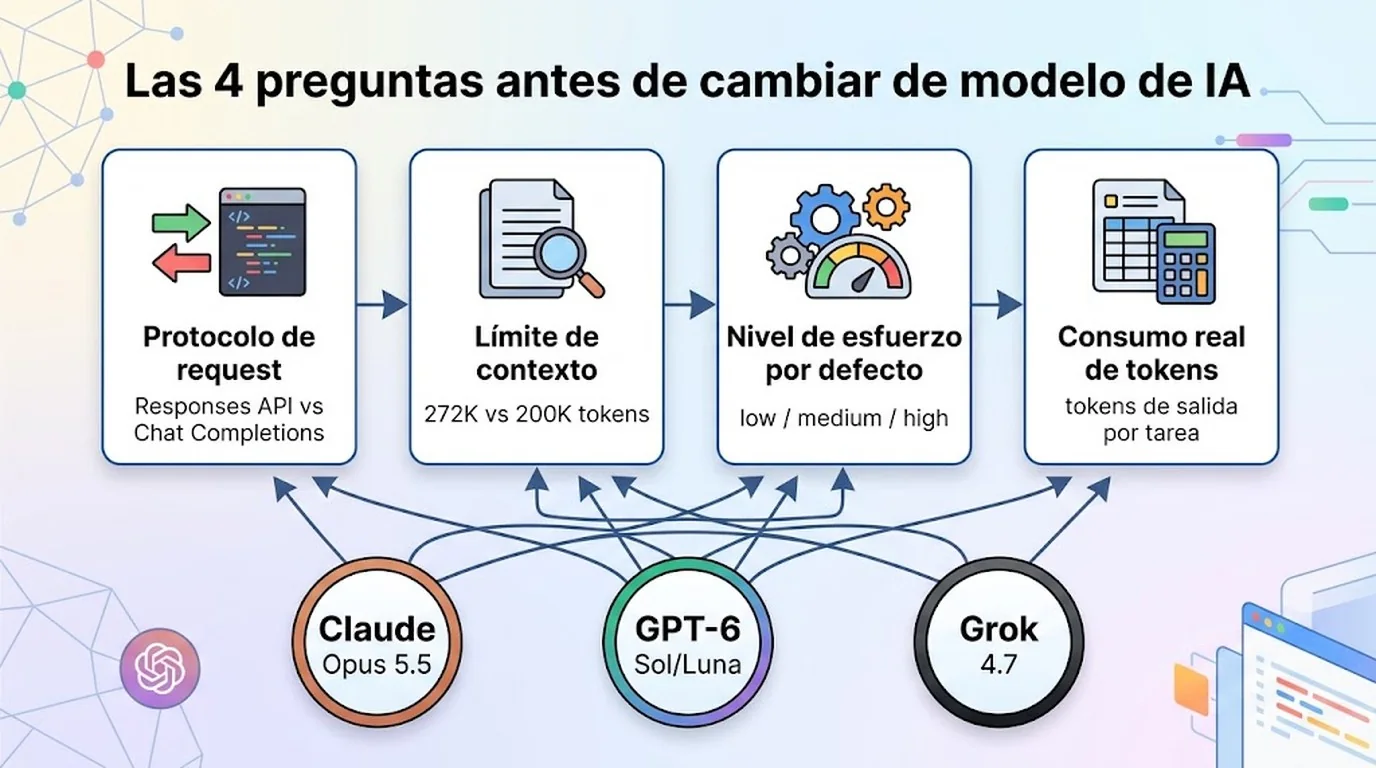
- ¿Cuáles son las cuatro preguntas que hay que responder antes de cambiar de modelo de IA?
- ¿Qué cambia en el protocolo de request entre Opus 5.5, GPT-6 y Grok 4.7?
- ¿Dónde está el límite de contexto largo (cliff) de cada modelo y cómo cambia el precio?
- ¿Cómo impacta el nivel de esfuerzo por defecto en el costo real por tarea?
- Errores comunes al migrar entre estos tres modelos
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Grok 4.7 salió el 21/9, Claude Opus 5.5 el 22/9 y GPT-6 Sol/Luna unos 90 minutos después ese mismo día, según el análisis técnico original.
- El cliff de contexto largo está en 272.000 tokens en GPT-6 Sol y en 200.000 tokens en Grok 4.7, con multiplicadores de precio distintos.
- Opus 5.5 bajó su effort por defecto de high a medium; Grok 4.7 quedó en high pero sus benchmarks se reportan en xhigh.
- OpenRouter midió un spread de 1.75x en el precio efectivo de Opus 5.5 entre cinco endpoints con el mismo precio de lista.
- En Chat Completions de OpenAI, el function calling solo funciona con
reasoning_efforten none; para todo lo demás hay que usar la Responses API.
¿Qué tres modelos de IA lanzaron Anthropic, OpenAI y SpaceXAI en menos de 48 horas?
SpaceXAI lanzó Grok 4.7 el 21 de septiembre de 2026. Anthropic sacó Claude Opus 5.5 al día siguiente, y OpenAI respondió con GPT-6 Sol y GPT-6 Luna unas 90 minutos después, según el análisis técnico que reconstruye la cronología. Tres tablas de precios en tres días, y la prensa cubrió la guerra de precios hasta el cansancio.
El problema es que los incidentes de producción no tienen nada que ver con el precio de lista. Tienen que ver con cuatro cosas bien concretas: el protocolo de la request, el precio a partir de cierto umbral de contexto (el “cliff”), el nivel de esfuerzo por defecto y cuántos tokens gasta cada modelo en la práctica. Si manejás ruteo multi-modelo con fallback automático, esta tanda de lanzamientos te deja cuatro preguntas para completar, y ninguna es sobre precio.
¿Cuáles son las cuatro preguntas que hay que responder antes de cambiar de modelo de IA?
Las cuatro preguntas son: qué protocolo de request acepta el modelo nuevo, dónde está el umbral de contexto largo que dispara un multiplicador de precio, cuál es el nivel de esfuerzo (effort) que usa por defecto, y cuántos tokens consume realmente por tarea. Ninguna aparece en la tabla de precios que publican los vendors el día del lanzamiento. Más contexto en el lanzamiento de Mythos 5 y GPT-5.6.
Acá está el detalle: podés tener dos modelos con el mismo precio por millón de tokens y terminar pagando el doble por uno de los dos, simplemente porque tu prompt promedio cruza un cliff que el otro no tiene. O podés migrar código que andaba bien y encontrarte con un 400 en producción porque el nuevo modelo ya no acepta el parámetro que usabas para forzar una tool call. Ponele que armaste un router automático hace seis meses: ese router asumía que cambiar de proveedor era tocar un solo campo. Esa asunción murió esta semana.
¿Qué cambia en el protocolo de request entre Opus 5.5, GPT-6 y Grok 4.7?
Claude Opus 5.5 rompe compatibilidad en cuatro puntos según la documentación oficial de migración de Anthropic: el thinking ya no se puede desactivar, el forced tool use devuelve error 400, los thinking blocks quedan atados al modelo y a la conversación, y en la Claude API y Google Cloud ya no se acepta la tool computer_20251124 anterior. Los primeros tres cambios también aplican a Claude Fable 5.1.
Hay un quinto cambio que no tira error pero altera la forma de la respuesta: las notas cortas que el modelo escribe entre tool calls ahora llegan como bloques thinking de tipo progress-update, con texto vacío bajo la configuración por defecto (display: "omitted"). ¿Qué pasa con una interfaz que mostraba esas notas como progreso? Exacto, se queda muda entre llamadas a herramientas, sin ningún error visible. Para recuperarlas hay que setear thinking.display en updates o summarized, con el beta header correspondiente.
GPT-6 tiene su propia restricción. Según la ficha técnica de GPT-6 Sol, las tools integradas y el function calling apuntan a la Responses API; en Chat Completions, el function calling solo funciona si reasoning_effort está en none. Eso pega fuerte en las capas de compatibilidad que normalizan todos los vendors sobre /v1/chat/completions y después reparten el tráfico, porque la idea de que “solo hay que cambiar el modelo” se cae apenas entran tools en juego.
¿Dónde está el límite de contexto largo (cliff) de cada modelo y cómo cambia el precio?
GPT-6 Sol pone el cliff en 272.000 tokens; Grok 4.7 lo pone en 200.000. Esa diferencia de 72.000 tokens no es un detalle menor: cruzar el umbral en GPT-6 duplica el input pero solo sube el output un 50%, mientras que en Grok 4.7 duplica input y output por igual. Una request de 300K tokens de input factura el doble en Sol, y el doble más output creciendo en Grok 4.7. Te puede servir nuestra cobertura de nuestra guía completa de modelos de lenguaje.
Esto es un cliff, no una tarifa marginal. Dividir 300K en dos requests de 150K suele salir más barato que mandarlos juntos (spoiler: casi nadie lo hace hasta que ve la factura). Un detalle que se pasa por alto fácil: el cache read de Grok 4.7 cuesta $0.50 por debajo de 200K, pero hay que pedirlo explícitamente, seteando prompt_cache_key en la Responses API o mandando el header x-grok-conv-id en Chat Completions. Sin ese aviso, los cache hits son poco confiables, y el input cacheado cuesta 75% menos que el fresco.
| Modelo | Cliff de contexto | Multiplicador sobre el cliff | Effort por defecto | Precio input/output (por MTok) |
|---|---|---|---|---|
| Claude Opus 5.5 | Sin cliff reportado en las fuentes | – | medium | $4 / $20 |
| GPT-6 Sol | 272.000 tokens | 2x input, 1.5x output | medium | $2 / $10 |
| Grok 4.7 | 200.000 tokens | 2x input y output | high (benchmarks en xhigh) | $2 / $6 |
¿Cómo impacta el nivel de esfuerzo por defecto en el costo real por tarea?
Cada vendor definió un default distinto, y eso solo ya invalida cualquier comparación de “mismo prompt, mismo resultado”. El effort por defecto de Opus 5.5 bajó de high (en Opus 5) a medium, según la documentación de Anthropic. GPT-6 Sol y Luna también arrancan en medium. Grok 4.7 arranca en high, pero varios de sus benchmarks de referencia se reportan en xhigh. Tres vendors, tres defaults, ninguno igual al anterior.
El consumo de tokens importa más de lo que parece. El precio por token de Grok 4.7 es idéntico al de Grok 4.6 ($2 de input / $6 de output, con cache reads a $0.50 por debajo de 200K), pero Artificial Analysis midió cerca de 81.000 tokens de salida por tarea del Intelligence Index en modo xHigh, contra unos 36.000 en Grok 4.6 en modo High. Eso es 125% más output para el mismo tipo de tarea. En ese mismo índice, una tarea sale cerca de $3.74 en Grok 4.7 contra unos $1.99 en GPT-5.6 Sol. El precio unitario no subió: subió la tarea unitaria.
Un dato de OpenRouter sobre Claude Opus 5.5 termina de mostrar por qué fijar el effort a mano no es opcional. En una ventana que incluye el 23 de septiembre, cinco endpoints listaban exactamente el mismo precio de $4/$20, pero la tasa de cache hit variaba entre 80.6% y 91.7%, y el precio efectivo de input iba de $0.580 a $1.016: un spread de 1.75x. El precio de lista promedio ponderado de input cayó a $0.8623, menos de un cuarto del precio nominal, mientras el output promedio ponderado se mantuvo en $20.13 porque el output no tiene descuento por cache. La disponibilidad también varió: 99.92% con ruteo automático contra 98.48% sin él. Tema relacionado: cómo elegir entre Claude Sonnet y Opus.
Errores comunes al migrar entre estos tres modelos
- Confiar en el effort por defecto sin fijarlo. Cada vendor cambió su default en este ciclo. Si no lo seteás explícitamente en cada request, estás comparando manzanas con peras sin darte cuenta.
- Asumir que
tool_choice: "auto"garantiza una tool call. No la garantiza en ninguno de los tres modelos. Hay que validar la respuesta y reintentar si el modelo no llamó a la herramienta esperada. - Mandar la request sin chequear el cliff antes. Si el input pasa los 272.000 tokens en GPT-6 o los 200.000 en Grok 4.7, el multiplicador se aplica a todo el request. Conviene dividir el contexto o compactar el historial antes de mandarlo, no esperar el aviso del vendor.
- Streamear notas de progreso sin revisar el nuevo formato de thinking blocks. En Opus 5.5, esas notas llegan vacías por defecto. Si tu UI dependía de verlas, hay que pedir explícitamente
display: "updates". - Normalizar todo sobre Chat Completions y asumir que el function calling anda igual. En GPT-6, function calling en Chat Completions solo funciona con
reasoning_efforten none. Para todo lo demás hay que pasarse a la Responses API.
Preguntas Frecuentes
¿Por qué falla mi código al cambiar de Claude Opus a GPT-6?
Lo más probable es que tu código esté usando forced tool use o un parámetro de thinking que Opus 5.5 ya no acepta, o que estés llamando function calling desde Chat Completions de GPT-6 sin poner reasoning_effort en none. Revisá primero los cuatro breaking changes documentados por Anthropic y la restricción de la Responses API en OpenAI antes de asumir que es un bug del modelo.
¿Cuál es el límite de contexto largo de GPT-6 Sol y Grok 4.7?
GPT-6 Sol tiene su cliff de precio en 272.000 tokens de input, con un contexto máximo de 1.050.000 tokens y 128.000 tokens de output según su ficha técnica. Grok 4.7 pone el cliff en 200.000 tokens, con un contexto de hasta 500.000 tokens según DataNorth.
¿Cuánto cuesta realmente usar Grok 4.7 comparado con GPT-6?
El precio por token es similar ($2 de input en ambos), pero el costo por tarea no lo es: en el Intelligence Index de Artificial Analysis, una tarea salió cerca de $3.74 en Grok 4.7 en modo xHigh contra unos $1.99 en GPT-5.6 Sol, porque Grok 4.7 consume alrededor de 125% más tokens de salida por tarea. El precio unitario del token no cambió; lo que cambió fue cuántos tokens gasta el modelo para responder. Cubrimos ese tema en detalle en lo que cambia con GPT-5.6 Sol.
¿Qué diferencia hay entre la Responses API y Chat Completions de OpenAI?
En GPT-6 Sol, las tools integradas (búsqueda web, code interpreter, computer use, MCP, entre otras) y el function calling completo están pensados para la Responses API. En Chat Completions, el function calling solo funciona si seteás reasoning_effort en none, lo que en la práctica limita el razonamiento del modelo cuando usás herramientas por ese endpoint.
¿Cómo evito errores 400 al migrar de modelo de IA en producción?
Armá una tabla de capacidades por modelo (protocolo soportado, cliff de contexto, effort por defecto) antes de tocar el campo model en producción, y corré el modelo viejo y el nuevo en paralelo contra una muestra real de requests para medir tasa de errores 400, hit rate de tool calls y costo por tarea antes de migrar el tráfico entero.
Conclusión
Lo que cambió esta semana no está en las tablas de precios que todos citaron. Opus 5.5 hizo que el thinking sea un default que no se puede apagar, GPT-6 ató el function calling completo a la Responses API, y Grok 4.7 mantuvo el precio por token pero subió el consumo real de tokens por tarea. Cada vendor movió una pieza distinta (protocolo, cliff, effort, consumo) y equivocarte en cualquiera de las cuatro rompe la cuenta de “la mitad de precio” que viste en el anuncio.
Si estás por migrar, la recomendación concreta es escribir la tabla de capacidades y los umbrales de cliff en tu capa de ruteo antes de tocar producción, y correr el modelo viejo y el nuevo en paralelo contra una muestra de requests reales para medir errores, hit rate de tools y costo por tarea. Eso no te lo da ningún price table, lo tenés que medir vos con tu propio tráfico.
Fuentes
- Anthropic – Qué hay de nuevo en Claude Opus 5.5 (documentación oficial de migración)
- OpenAI – Ficha técnica de GPT-6 Sol (precios, contexto y endpoints)
- Releasebot – Notas de lanzamiento de Anthropic sobre Claude Opus 5.5
- OpenRouter – Página del modelo Claude Opus 5.5 (precios efectivos por endpoint)
- Análisis técnico original: Three New Models in 48 Hours