GRPO reward model: el critic se fue, no él
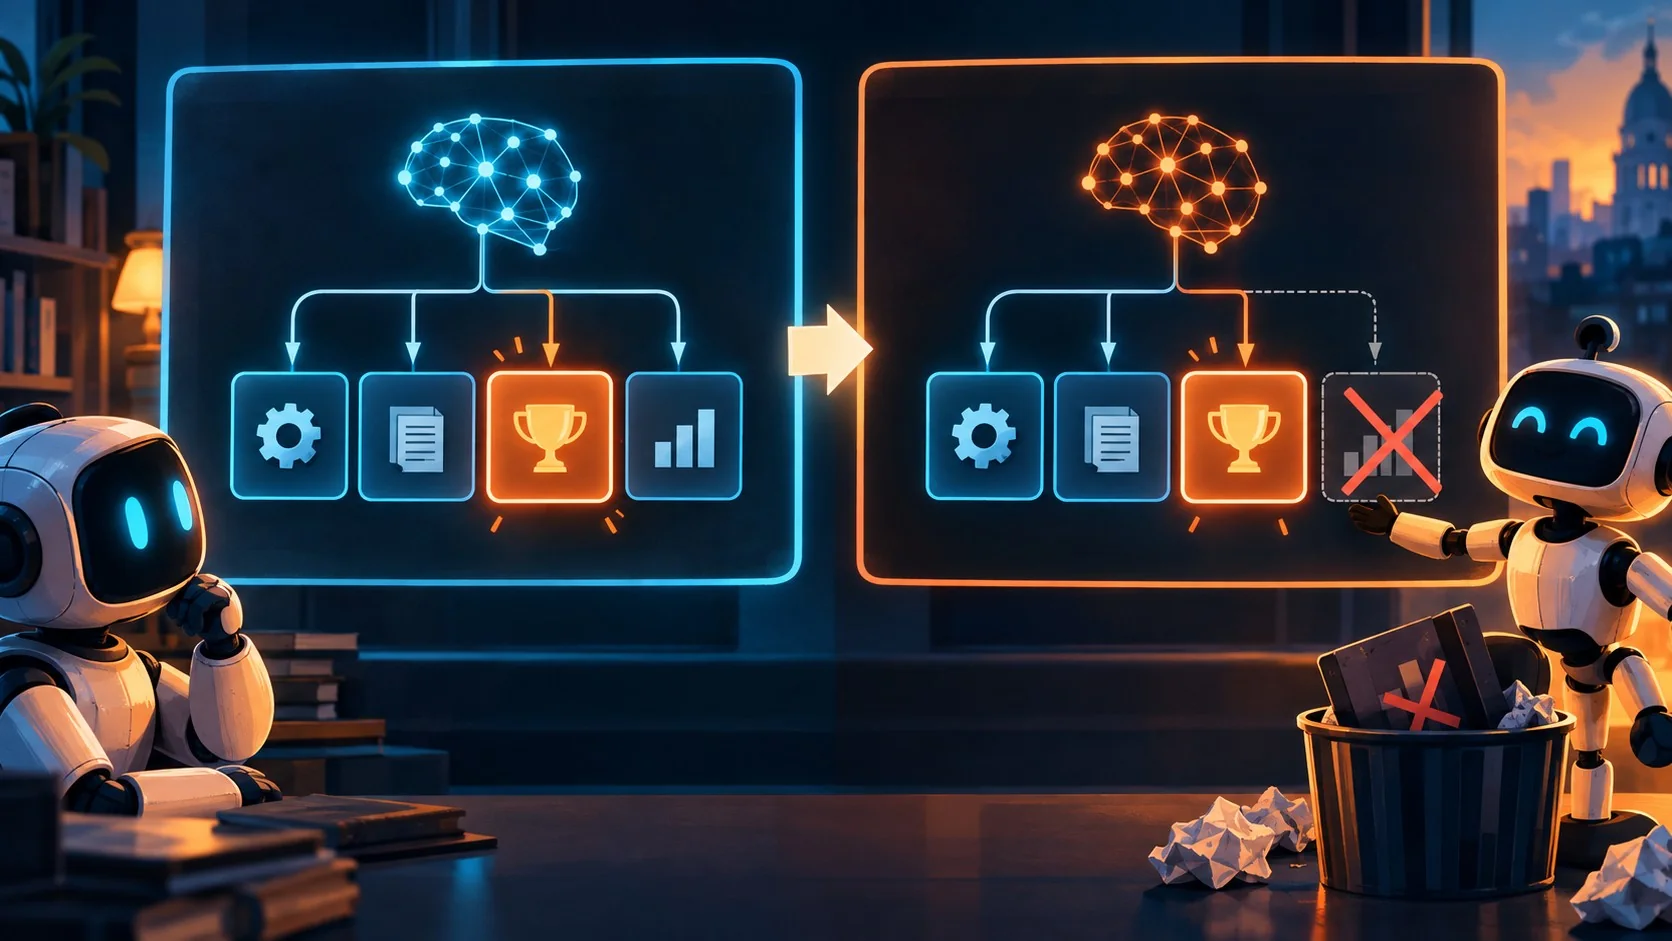
GRPO no elimina el reward model, elimina el value model (critic). El paper de DeepSeekMath explica la diferencia y qué se ahorra en memoria.
GRPO no elimina el reward model, elimina el value model (critic). El paper de DeepSeekMath explica la diferencia y qué se ahorra en memoria.
Liu Shengyu, ingeniero de DeepSeek, dice que la IA va a igualar su trabajo en kernels de GPU en 6 a 12 meses, y compara a Anthropic con la Alemania nazi.
Un sitio cobró 0,01 USDC por página a agentes de IA usando x402, y Claude Code pagó de forma automática el 15 de septiembre de 2026.
DeepSeek publicó el artículo 10 de su serie sobre dsh: un plugin completo llamado workspace-context con tool, permisos y observabilidad.
DeepSeek V4.1 Flash cuesta USD 0,003 por millón de tokens y supera a su propio flagship: la brecha de costo con GPT-5.6 y Claude Opus 5 llega a 33x.
Un desarrollador conectó un Actor de auditoría a Claude vía MCP y descubrió que su input schema inyectaba tres paquetes npm no solicitados en cada llamada.
Anthropic lanzó Claude Docs y Claude Slides en beta y disolvió Cowork, fusionando sus capacidades agénticas al chat estándar de Claude.
GitHub migró el runtime de Copilot a Rust con sus propios agentes; Bun (Anthropic) hizo lo mismo con Claude Code en 11 días. Comparamos los dos enfoques.
Un desarrollador documentó casos donde Claude niega conversaciones previas archivadas y armó clawrush para auditar el problema.
Peter Vijeh usó Gemini 3.1 Pro para etiquetar 4.290 comentarios y entrenó un GLiNER local que llegó a 0,83 F1 por apenas US$11,50 en total.