En pocas palabras: El creador de PodCrisp contó el 16/10/2026 en dev.to que sobrecargar los prompts confundía al modelo y que las reglas concisas funcionaban mejor: para títulos fijó 5 a 10 palabras y prohibió el clickbait; para show notes impuso estructura markdown con Llama 3 8B Instruct.
Un desarrollador publicó el 16/10/2026 en dev.to lo que aprendió construyendo PodCrisp, un conjunto de herramientas de IA para podcasts que genera títulos y show notes. Usa prompts cortos con reglas y Llama 3 8B Instruct, de Meta, sobre Cloudflare Workers, sin métricas independientes.
Las herramientas de IA para podcasts son aplicaciones que usan modelos de lenguaje para resolver el trabajo de texto que queda después de grabar y editar un episodio: títulos, descripciones, show notes y esquemas de guion. Sirven a quienes producen un podcast y no quieren redactar cada episodio a mano. Este caso trata de texto a partir de transcripciones, no de edición de audio, y el autor tiene interés comercial.
En este artículo:
- En 30 segundos
- ¿Por qué las herramientas de IA genéricas fallan con las show notes y los títulos?
- ¿Cómo armar un prompt para generar títulos de podcast que no suenen a clickbait?
- ¿Cómo generar show notes en markdown a partir de una transcripción desordenada?
- ¿Qué errores y límites reconoce el autor de PodCrisp?
- ¿Qué está confirmado y qué no del post de PodCrisp?
- ¿Qué podés aplicar hoy de estas herramientas de IA para podcasts?
- Errores comunes al usar IA para show notes y títulos
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Quién y cuándo: el creador de PodCrisp publicó su experiencia el 16/10/2026. Meta no anunció nada con este post: Llama 3 salió en abril de 2024 y la familia ya tiene versiones posteriores.
- Títulos: el prompt final usa reglas cortas: 5 a 10 palabras por título, ganchos concretos, tono parametrizable y prohibición de clickbait.
- Show notes: un Cloudflare Worker llama a
@cf/meta/llama-3-8b-instructcon max_tokens 800 y fuerza cuatro secciones en markdown. - Límite: no hay cifras de latencia, costos ni usuarios, y los timestamps son estimaciones del modelo, no marcas del audio.
¿Por qué las herramientas de IA genéricas fallan con las show notes y los títulos?
Fallan porque no conocen el formato de un podcast. Según el autor, los modelos genéricos no extraen timestamps de forma natural, no saben armar una plantilla de show notes y generan títulos que suenan robóticos o a clickbait de hace una década. Cuando termina la edición queda ese trabajo administrativo, y saltearlo te cuesta alcance, porque las plataformas dependen de búsqueda y recomendaciones.
El propio autor lo resume así (traducción nuestra): “pasaba más tiempo arreglando los errores de la IA que el que me hubiera llevado escribirlo yo mismo”. Cualquiera que haya pedido una descripción a un modelo genérico conoce la sensación: el texto sale, pero hay que reescribirlo.
Meta no lanzó nada nuevo con este post. Llama 3, el modelo que corre por debajo, salió en abril de 2024, y Meta publicó versiones posteriores (Llama 3.1 en julio de 2024, Llama 4 en abril de 2025). Es decir, PodCrisp usa un modelo de una generación anterior de la familia. El post es de un desarrollador que al final avisa que es el autor de PodCrisp.
¿Cómo armar un prompt para generar títulos de podcast que no suenen a clickbait?
Con reglas cortas y estrictas en vez de instrucciones larguísimas. El primer error del autor fue la sobre-ingeniería: le dio al modelo todas las instrucciones posibles y lo confundió. La versión final, una función llamada buildTitlePrompt(topic, tone, count), define un rol de productor de podcast y un puñado de restricciones que cualquiera puede copiar. Lo explicamos a fondo en los modelos abiertos de Meta como Llama.
- Rol claro: el system prompt dice “expert podcast producer”.
- Largo fijo: entre 5 y 10 palabras por título.
- Ganchos concretos: curiosity gaps, números o hooks fuertes.
- Tono como variable: el parámetro
toneentra en el prompt. - Prohibición explícita: nada de clickbait que sobreprometa.
- Formato cerrado: lista numerada.
En el ejemplo del post, pidió 5 títulos con tono “inspirational” para un episodio sobre cómo empezar un podcast sin presupuesto. Según el autor, al prohibir el clickbait y fijar el largo, la calidad mejoró mucho. No publica ejemplos de salida ni una comparación contra el prompt anterior.
Lo más transferible, para mí, es otra cosa. El autor cuenta que las opciones de estilo (educational, conversational, provocative) importaron más de lo que esperaba. Ponele que producís un true crime y otro de marketing B2B: con un tono fijo, uno de los dos va a sonar mal.
Un ejemplo hipotético nuestro, adaptado al español y sin probar: rol de productor de podcast, tema “cómo grabar con el celular”, tono conversacional, 5 títulos de 5 a 10 palabras, cada uno con un número o una pregunta, sin prometer nada que el episodio no cubra, en lista numerada.
¿Cómo generar show notes en markdown a partir de una transcripción desordenada?
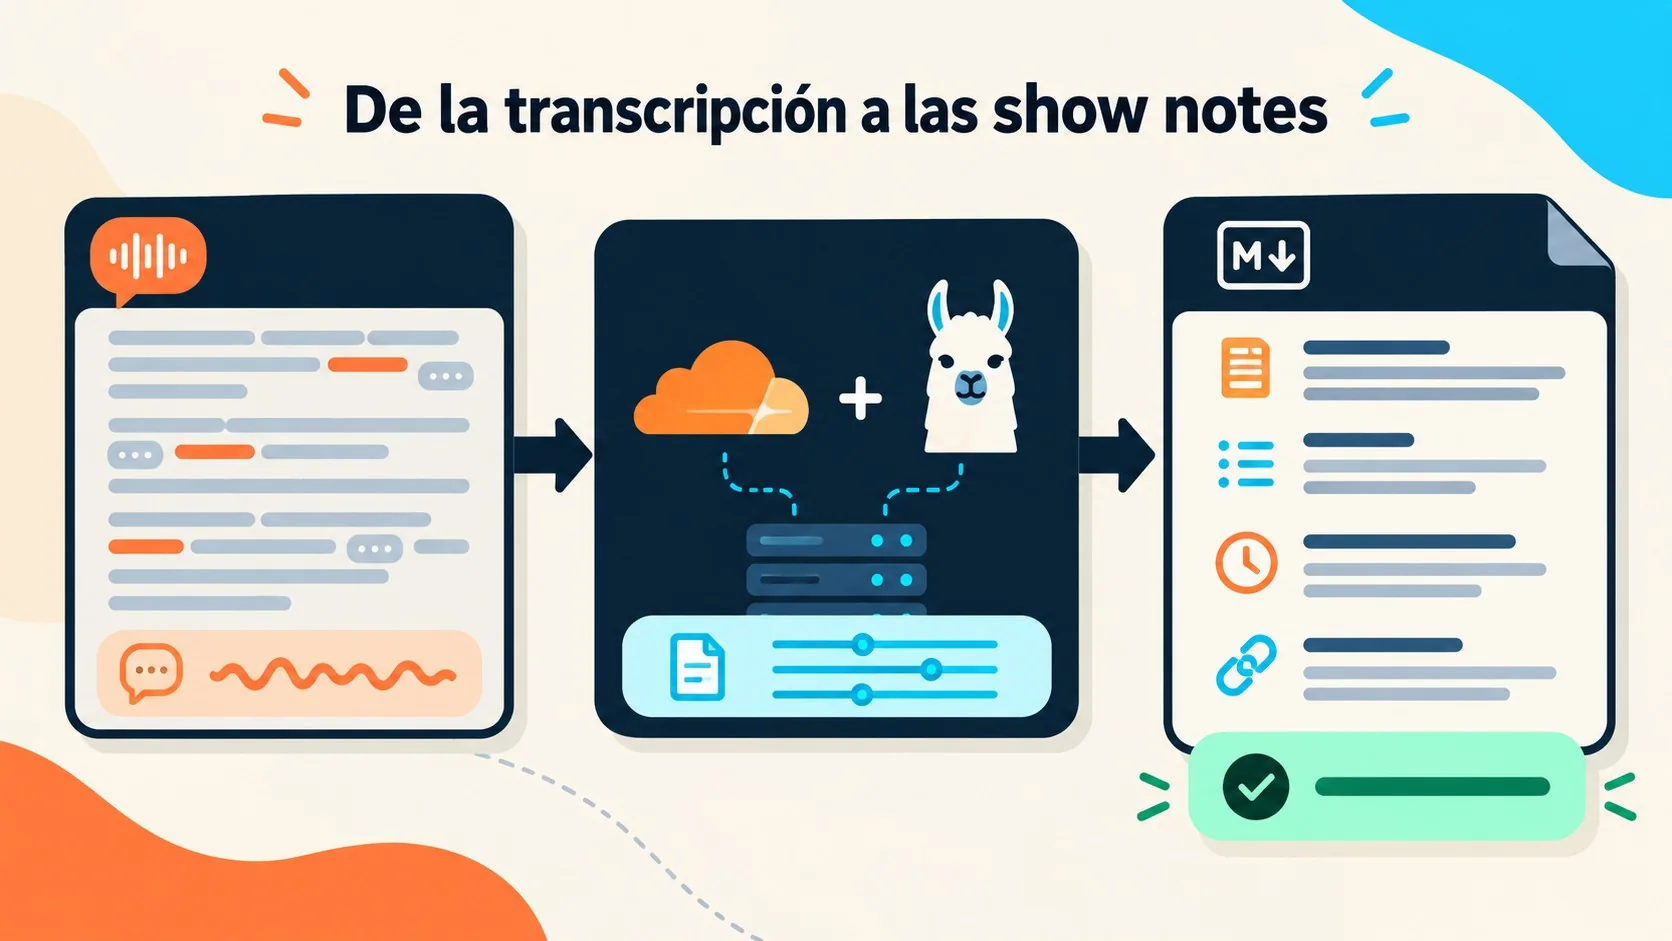
Con un pipeline que obliga al modelo a devolver una estructura fija. El autor primero pegó la transcripción cruda y obtuvo notas caóticas por las muletillas, las interrupciones y las divagaciones. Después armó un Cloudflare Worker que recibe el transcript por POST y llama a env.AI.run con el modelo @cf/meta/llama-3-8b-instruct, con max_tokens en 800. Tema relacionado: nuestra guía de herramientas para desarrolladores.
El system prompt exige cuatro secciones:
- Episode Summary: 2 a 3 oraciones.
- Key Takeaways: entre 5 y 7 bullets.
- Timestamps: estimados según el flujo del contenido.
- Resources Mentioned: lo que se nombró en el episodio.
Según el autor, correr esto en el edge de Cloudflare evita manejar infraestructura de GPU, y la salida queda lista para pegar en un CMS. Es cómodo (y es la parte que más me interesa del post), pero son afirmaciones sin números.
Ahora, el punto flojo. Los timestamps salen de la lectura del texto que hace el modelo, no del audio. Si tu herramienta de transcripción ya entrega marcas de tiempo, probablemente convenga pasárselas al modelo, aunque eso es una inferencia nuestra y el post no la prueba.
Imaginate esto: subís la transcripción, el Worker la manda al modelo, vuelve el markdown con las cuatro secciones, lo pegás en el CMS, publicás y tres días después alguien te escribe que el minuto 14:20 no era donde arrancaba el tema del presupuesto, porque el modelo calculó a ojo y nadie lo chequeó contra el audio.
¿Qué errores y límites reconoce el autor de PodCrisp?
Reconoce tres errores concretos: prompts sobrecargados, tratar outlines de guion y show notes como la misma tarea, y descuidar la subida de transcripciones grandes en el navegador. De haber empezado de nuevo, haría una subida por partes (chunked upload) desde el día uno. Es una autocrítica útil, aunque ninguno de los tres errores viene con números. Te puede servir nuestra cobertura de comparativa de herramientas de SEO con IA.
- Prompts sobrecargados: más instrucciones confundieron al modelo.
- Una sola tarea para todo: el outline mira hacia adelante y es estructural, mientras que las notas miran hacia atrás y resumen. Mezclarlos llevó varias iteraciones de arreglo.
- Interfaz de carga: pasó semanas ajustando el formato de salida y descuidó que subir un archivo de texto enorme en el navegador es torpe.
¿Hay cifras de latencia o de costos? Ninguna. El autor habla de costos “predecibles” y de una app “muy ágil”, pero no hay un solo número publicado. Tampoco hay usuarios, ni una comparativa de calidad contra otros modelos.
Y el post termina promocionando un generador gratuito de títulos. Tomalo con pinzas.
¿Qué está confirmado y qué no del post de PodCrisp?
Está confirmado lo que el autor describe de su propio sistema: el modelo, el esquema del prompt y los errores que admite. No está confirmado nada que requiera medición: latencia, costos, cantidad de usuarios o calidad frente a otras herramientas. Es una sola fuente, publicada el 16/10/2026, con interés comercial y sin validación independiente.
Confirmado según el autor
- Modelo y plataforma:
@cf/meta/llama-3-8b-instructvíaenv.AI.runen un Cloudflare Worker. - Estructura de las notas: cuatro secciones, resumen de 2 a 3 oraciones, 5 a 7 puntos clave y max_tokens 800.
- Reglas de títulos: 5 a 10 palabras, sin clickbait que sobreprometa, lista numerada.
- Estilos: educational, conversational y provocative.
- Divulgación: dice ser el desarrollador de PodCrisp.
Sin confirmar
- Rendimiento: no hay latencia ni costos en números.
- Calidad: no hay comparación con otros modelos ni herramientas.
- Precisión de los timestamps: no hay medición.
- Adopción: no hay datos de usuarios.
Una propuesta editorial nuestra, que no sale del post y que no probamos: antes de confiar en el flujo, elegí tres episodios con marcas de tiempo conocidas, corré el prompt y anotá cuántos timestamps estimados se desvían más de la tolerancia que definas. Si fallan muchos, usá las marcas de tu transcriptor. Cubrimos ese tema en detalle en agentes que configuran WhatsApp Business solos.
¿Qué podés aplicar hoy de estas herramientas de IA para podcasts?
Cinco ideas del post sirven aunque nunca uses PodCrisp, porque son decisiones de prompt y no de producto. Son hallazgos de un solo desarrollador, no resultados medidos, así que tomalas como punto de partida y probalas con tus episodios.
- Prompts cortos basados en reglas: pocas restricciones claras rinden más que una lista larga.
- Una tarea por prompt: títulos, show notes y outlines van por separado.
- Salida estructurada: definí las secciones y el largo que querés recibir.
- Controles de tono: un parámetro de estilo cambia mucho según el tipo de show.
- Timestamps con revisión: chequealos siempre contra el audio.
Si querés montar algo parecido, Cloudflare Workers AI es una opción técnica que describe el autor para correr el modelo sin administrar GPUs. Y si necesitás un sitio o un dominio propio donde publicar el podcast y las notas, podés mirar donweb.com.
Errores comunes al usar IA para show notes y títulos
- Pegar la transcripción cruda sin estructura: da notas caóticas. Corrección: fijá en el system prompt las secciones y el largo de cada una.
- Usar un solo prompt para todo: un outline y unas notas son tareas distintas. Corrección: un prompt por tarea.
- Dar demasiadas instrucciones: confunde al modelo. Corrección: dejá las reglas que cambian el resultado y borrá el resto.
- Publicar timestamps sin revisar: son estimaciones. Corrección: verificalos contra el audio.
- Pedir títulos sin prohibir nada: salen ganchos exagerados. Corrección: vetá explícitamente el clickbait que sobreprometa.
Preguntas Frecuentes
¿Cómo puedo generar show notes de un podcast con IA?
Pasale la transcripción a un modelo con un system prompt que fije la estructura: resumen de 2 a 3 oraciones, 5 a 7 puntos clave, timestamps estimados y recursos mencionados. Ese es el esquema que describe el autor de PodCrisp, con max_tokens en 800. Revisá el resultado antes de publicar.
¿Cómo escribir un buen prompt para títulos de podcast?
Con rol, largo y límites claros: productor de podcast, entre 5 y 10 palabras, ganchos o números, tono variable, prohibición de clickbait que sobreprometa y lista numerada. Según el autor, esas restricciones mejoraron la calidad más que instrucciones largas y vagas.
¿Se pueden sacar timestamps automáticamente de una transcripción con IA?
Se pueden estimar, no medir. En el pipeline descrito, el modelo los calcula a partir del flujo del contenido, sin leer el audio. Verificalos contra la grabación antes de publicarlos, porque el post no informa qué tan precisos son.
¿Se puede correr Llama 3 en Cloudflare Workers sin manejar GPUs?
Según el autor, sí: llama a env.AI.run con @cf/meta/llama-3-8b-instruct y no gestiona infraestructura de GPU. No publica latencia ni costos, así que antes de depender de eso revisá los límites y precios vigentes de Cloudflare.
¿Por qué ChatGPT escribe mal las descripciones de mi podcast?
La fuente no nombra a ChatGPT. Dice que las herramientas genéricas de escritura no entienden el formato de un podcast, no extraen timestamps de forma natural y producen títulos robóticos. Darles un rol, reglas, un formato de salida cerrado y un tono explícito suele ayudar, aunque no hay una medición que lo pruebe.
Conclusión
El post de PodCrisp no trae benchmarks, pero sí un criterio útil: separar tareas, acotar el prompt y fijar la estructura de salida. Eso lo podés probar hoy con tus propios episodios, con cualquier modelo.
Lo que no podés concluir es que Llama 3 8B en Cloudflare sea más rápido, barato o mejor que otras opciones, porque nadie midió nada. Mi sugerencia: copiá el esquema de reglas para títulos, probá el de show notes con tres episodios y revisá cada timestamp contra el audio. Si después de eso te ahorra tiempo, seguí. Si no, ya sabés dónde está el problema.