
En pocas palabras: Llama es la familia de modelos de lenguaje de Meta, presentada en un paper el 27 de febrero de 2023, con modelos de 7B a 65B parámetros. Sus pesos se pueden descargar y usar gratis bajo la Llama 4 Community License, que no es open source de la OSI.
Qué es Llama, en una línea: la familia de modelos de lenguaje de Meta, con pesos que podés descargar y correr en tu propia máquina. Esta guía repasa versiones y licencia, te da criterios para decidir si te conviene y termina con un modelo andando en local con llama.cpp en cinco pasos.
Llama (escrito LLaMA en el paper original) es una familia de modelos de lenguaje de gran tamaño que Meta presentó en un paper el 27 de febrero de 2023. Sirve para generar y entender texto. Meta distribuye los pesos con una licencia propia, la Llama 4 Community License, y desarrolladores, investigadores y empresas los usan para armar sus propios sistemas.
En este artículo:
- En 30 segundos
- ¿Quién creó Llama y cuándo salió el primer modelo?
- ¿Cómo funciona un modelo Llama?
- ¿Qué modelos Llama existen y en qué se diferencian?
- ¿Llama es de código abierto y gratis?
- ¿Qué es Llama y en qué se diferencia de llama.cpp?
- Qué vas a necesitar para correr Llama en tu compu
- Paso 1: Instalá llama.cpp
- Paso 2: Probá la instalación con un modelo chico
- Paso 3: Levantá un servidor con interfaz web
- Paso 4: Elegí un Llama en GGUF que entre en tu memoria
- Paso 5: Corré tu modelo Llama
- Resultado final
- Errores comunes al correr Llama en local
- ¿Qué limitaciones tiene Llama?
- ¿Sigue Meta desarrollando Llama en 2026?
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Origen: el paper original de LLaMA salió en arXiv el 27 de febrero de 2023, con modelos de 7B a 65B parámetros.
- Llama 4: la licencia está vigente desde el 5 de abril de 2025.
- Licencia: descargar y usar es gratis, pero no es una licencia open source de la OSI. Hay un tope de 700 millones de usuarios activos mensuales y reglas de nombre y atribución.
- llama.cpp: es un proyecto aparte, de ggml-org, que corre modelos en tu PC con cuantización de 1.5 a 8 bits.
- Tutorial: instalás llama.cpp, probás con un modelo chico, levantás un servidor, elegís un GGUF de Llama según tu memoria y lo corrés.
¿Quién creó Llama y cuándo salió el primer modelo?
Llama nació en Meta y su primer paper, firmado por Hugo Touvron y 13 coautores, llegó a arXiv el 27 de febrero de 2023. Presentaba modelos de 7B a 65B parámetros, entrenados con datasets públicos, que Meta liberó para la comunidad investigadora.
El dato que movió el avispero: según el paper de arXiv, LLaMA-13B supera a GPT-3 (175B) en la mayoría de los benchmarks, y LLaMA-65B compite con Chinchilla-70B y PaLM-540B. Son pruebas elegidas por los propios autores, así que tomalo con pinzas. Aun así, un modelo más de diez veces más chico que le gana al grande tiene una consecuencia práctica: el tamaño del modelo no decide por sí solo el rendimiento. Eso importa cuando tu límite es la memoria de tu máquina, porque a veces un modelo mediano alcanza.
Los autores escriben que es posible entrenar “state-of-the-art models using publicly available datasets exclusively”, o sea, modelos de punta usando solo datos públicos y sin recurrir a datasets propietarios e inaccesibles.
¿Cómo funciona un modelo Llama?
Un modelo Llama es un modelo de lenguaje autorregresivo: lee tokens (pedazos de palabras), calcula cuál es el siguiente más probable y repite el proceso hasta armar una respuesta. Los parámetros son los números que el entrenamiento ajustó para que esa predicción salga bien.
Ponele que escribís “La capital de Argentina es”. El modelo no consulta una enciclopedia: asigna probabilidades a los tokens que podrían venir después y elige uno. Después repite con el texto ya extendido. Primero se entrena con cantidades enormes de texto (el paper habla de trillones de tokens) y después se lo ajusta para que siga instrucciones y converse. Todo lo que parece “inteligencia” sale de esa mecánica, y por eso también se equivoca con total seguridad cuando le falta información.
¿Qué modelos Llama existen y en qué se diferencian?
Las fuentes de esta nota no traen las especificaciones de los modelos de Llama 4, así que para compararlos mirá la model card oficial.
| Modelo | Parámetros activos | Parámetros totales | Expertos | Dato clave |
|---|---|---|---|---|
| LLaMA original (2023) | 7B a 65B | 7B a 65B | No aplica | Entrenado solo con datasets públicos |
| Llama 4 | Sin dato en las fuentes | Sin dato en las fuentes | Sin dato en las fuentes | Para contexto y requisitos de hardware, mirá la model card oficial |
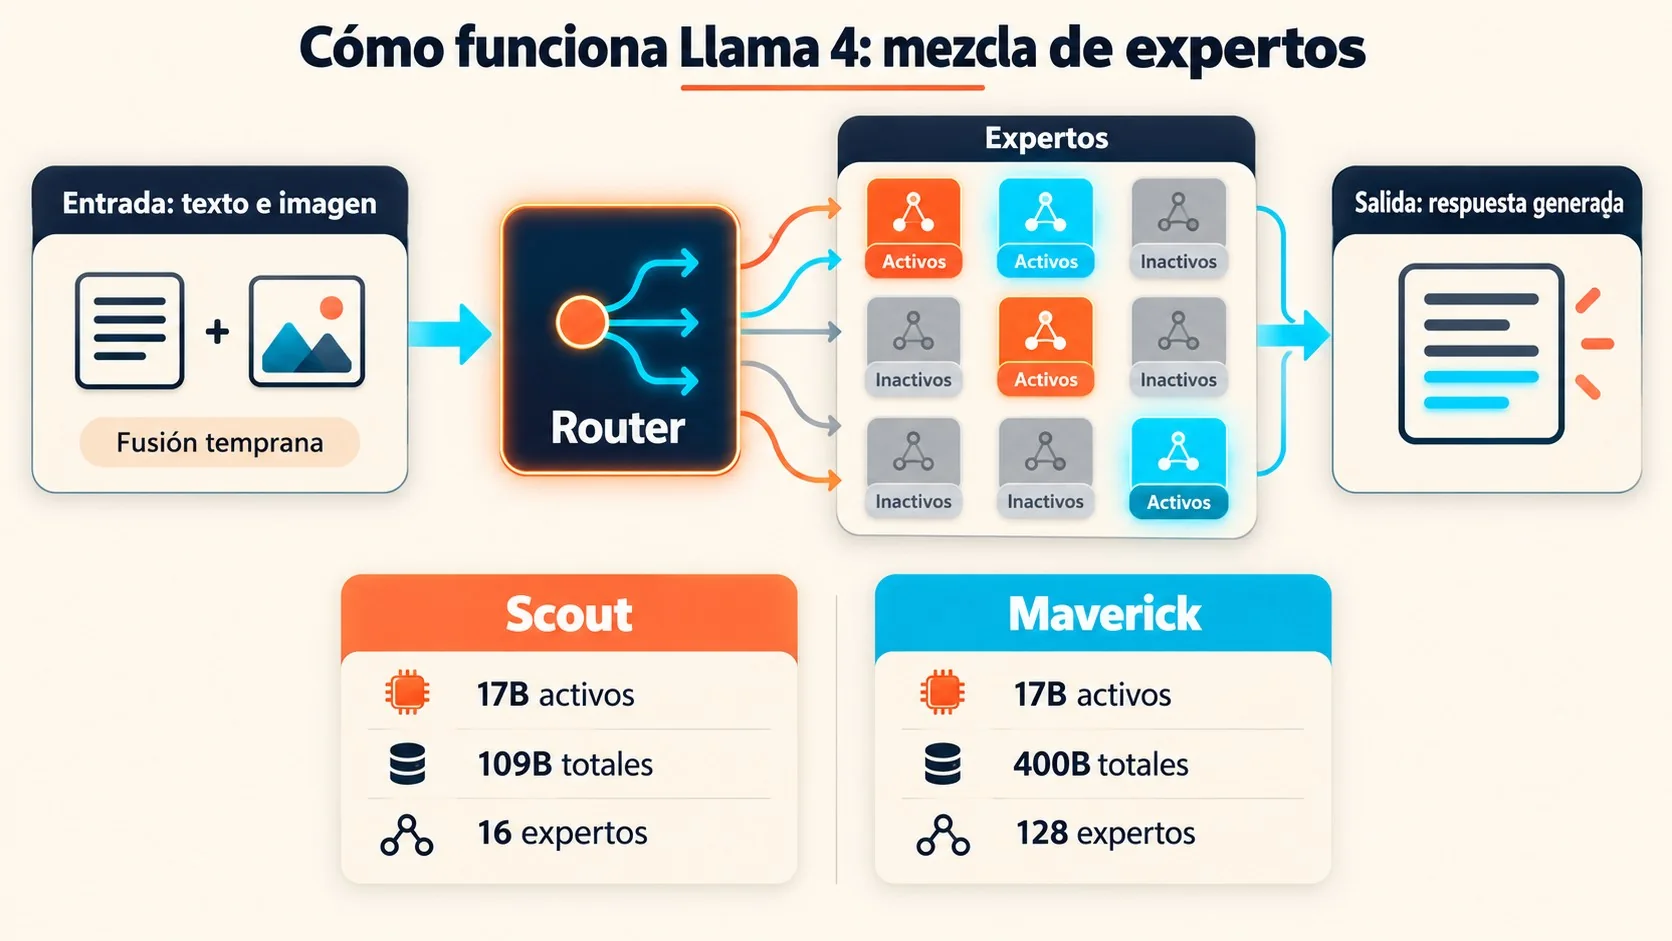
Faltan Llama 2 y las versiones 3.x (3.1, 3.2, 3.3). Existen, pero las fuentes de esta nota no traen datos para compararlas, así que no te voy a tirar tamaños de memoria. Tampoco incluyo benchmarks de Llama 4: los que circulan los publica Meta y no tengo una verificación independiente.
¿Llama es de código abierto y gratis?
Llama es gratis para descargar y usar, pero no es open source en el sentido de la OSI. Los pesos son “abiertos” y la licencia es propia de Meta. La Llama 4 Community License (versión del 5 de abril de 2025) concede una licencia no exclusiva, mundial y libre de regalías, con condiciones.
Estas son las que importan en la práctica:
- Tope de usuarios: si en la fecha de lanzamiento de la versión de Llama 4 tus productos o los de tus afiliadas tenían más de 700 millones de usuarios activos mensuales (en el mes calendario anterior), tenés que pedirle licencia a Meta, que la puede conceder o no a su criterio. Hasta que lo haga, no podés ejercer los derechos del acuerdo.
- Atribución visible: si distribuís Llama o un producto o servicio que lo contenga, tenés que mostrar “Built with Llama” en un sitio, interfaz, blog o documentación, y dar una copia del acuerdo.
- Nombre de los derivados: si usás Llama o sus resultados para crear, entrenar o mejorar otro modelo de IA que distribuyas o pongas a disposición, el nombre tiene que empezar con “Llama”.
- Aviso de copyright: hay que conservar un archivo “Notice” con el texto de atribución que fija la licencia.
- Política de uso aceptable: la licencia la incorpora por referencia, y tu uso tiene que cumplir las leyes aplicables.
- Derivados: lo que modifiques es tuyo, pero Meta conserva la propiedad de Llama.
- Demandas: si demandás a Meta alegando que Llama infringe tus derechos de propiedad intelectual, tus licencias terminan en esa fecha.
- Sin garantías: el material se entrega “as is” y los riesgos del uso corren por tu cuenta. La ley aplicable es la de California.
Mi lectura: para una pyme o un desarrollador independiente, el tope de 700 millones es un problema que casi nadie va a tener. Las reglas de atribución y de nombre sí te van a tocar si distribuís algo. No soy abogado y esto no es asesoramiento legal, así que leé siempre el texto vigente antes de lanzar un producto. Relacionado: ejecutar LLMs locales sin permisos de root.
Qué obligaciones te tocan según lo que hagas (ejemplos hipotéticos)
Los tres casos siguientes son hipotéticos, armados por mí para ordenar la lectura de la licencia. Son interpretaciones mías del texto y no reemplazan una consulta legal.
| Caso hipotético | Qué dice la licencia que se activa | Qué harías |
|---|---|---|
| Una pyme prueba Llama en una notebook para redactar borradores internos y no entrega nada a terceros. | Las obligaciones de la sección 1.b.i se disparan al distribuir o poner a disposición los materiales o un producto que los contenga. Siguen aplicando el cumplimiento de leyes y la política de uso aceptable. | Guardar una copia de la licencia y respetar la política de uso aceptable. |
| Una empresa lanza una app para clientes que usa Llama por detrás. | Es un producto o servicio que contiene Llama, así que corresponde “Built with Llama” visible y la copia del acuerdo. | Agregar la leyenda en el sitio o la documentación, incluir el archivo “Notice” y entregar el acuerdo. |
| Un equipo ajusta un modelo con salidas de Llama y publica el resultado como modelo propio. | Se trata de un modelo de IA mejorado con Llama que se distribuye: el nombre debe empezar con “Llama”, además de la atribución. | Renombrar el modelo (por ejemplo, con prefijo “Llama”) y conservar el “Notice”. |
El patrón que sale de la tabla: la pregunta clave no es “¿lo uso?”, sino “¿lo distribuyo o lo pongo a disposición de otros, solo o dentro de un producto?”. Si la respuesta es sí, sumá atribución, aviso y, si es un modelo derivado, nombre. Un detalle del texto: si recibís Llama dentro de un producto final integrado que te entregó otro licenciatario, la cláusula del tope de usuarios (sección 2) no te aplica a vos.
¿Llama es mejor que ChatGPT, Gemini o Claude?
Las fuentes de esta nota no traen una comparación independiente y actual, así que no puedo darte un ranking honesto. Lo verificable es la diferencia de acceso: con Llama podés bajar los pesos y correrlos vos; con los otros, en general, accedés por servicio. Cuál rinde mejor depende de tu tarea, y lo único serio es probarlo con tus propios casos.
¿Qué es Llama y en qué se diferencia de llama.cpp?
Llama es la familia de modelos de Meta. llama.cpp es otro proyecto: un motor de inferencia en C/C++ que mantiene la comunidad bajo la organización ggml-org, no Meta. Uno es el “cerebro” (los pesos) y el otro es el programa que lo ejecuta en tu hardware.
Según el README del repositorio, su objetivo es hacer inferencia de LLM y VLM con instalación mínima y rendimiento de primer nivel en una gran variedad de hardware, local o en la nube. Es una implementación en C/C++ sin dependencias y se apoya en la librería ggml. Las licencias de las librerías que usa están en el README.
Lo que lo hace útil:
- Cuantización de 1.5 a 8 bits: el README lista cuantización de enteros de 1.5, 2, 3, 4, 5, 6 y 8 bits para inferir más rápido y gastar menos memoria.
- Muchos backends: CUDA para GPU NVIDIA, HIP para AMD, Metal para Apple Silicon, Vulkan, SYCL y otros.
- Inferencia híbrida CPU+GPU: sirve para modelos más grandes que la VRAM disponible.
- Servidor compatible con OpenAI: el README documenta un API server y una interfaz web integrada.
Hoy el proyecto va más allá de LLaMA, como muestra la línea de ejemplo del propio README, que usa un modelo de Qwen. Sobre Ollama y otras herramientas: no tengo una fuente en esta nota que confirme qué motor usa cada una por debajo, así que no lo afirmo.
Qué vas a necesitar para correr Llama en tu compu
Para el tutorial necesitás una terminal, espacio en disco, memoria suficiente para el modelo y conexión para la primera descarga. Ningún componente tiene costo, salvo el hardware. Lo que sigue es lo concreto:
- llama.cpp: es gratis; revisá la licencia del proyecto en el repositorio. El README no fija una versión mínima en el fragmento que usé, así que instalá la última. Lo conseguís en llama.app o en la página de releases del repositorio.
- Una terminal: PowerShell en Windows, o una shell en macOS y Linux. Si ya tenés Docker, el README también documenta esa vía.
- Un modelo en formato GGUF: lo bajás desde Hugging Face. Los modelos son gratis, sujetos a la licencia de cada uno.
- Cuenta de Hugging Face: la necesitás si el repositorio pide aceptar la licencia de Llama antes de descargar.
- Memoria (RAM o VRAM): depende del tamaño y la cuantización. En el paso 4 hay una cuenta para estimarla.
Si tu proyecto propio necesita infraestructura en Argentina para desplegar una aplicación, en donweb.com tenés hosting y VPS. Ojo: no verifiqué que ese tipo de servidor tenga los recursos para un modelo Llama, y los modelos grandes piden mucha memoria, así que revisá las especificaciones antes de elegir.
Paso 1: Instalá llama.cpp
Ejecutá el instalador oficial según tu sistema. Las dos líneas salen de la sección “Quick start” del README.
# Windows (PowerShell)
irm https://llama.app/install.ps1 | iex
# macOS / Linux
curl -LsSf https://llama.app/install.sh | shResultado esperado: el script termina sin errores y, en una terminal nueva, el comando llama responde. Si preferís no ejecutar scripts de internet a ciegas (sana costumbre), el README también documenta Docker, binarios precompilados y compilación desde el código.
Ojo con esto: si ya tenías la terminal abierta, cerrala y abrí otra. El PATH no se actualiza en sesiones viejas.
Paso 2: Probá la instalación con un modelo chico
Antes de bajar nada pesado, verificá que todo ande con el ejemplo del README. Es un modelo de Qwen (no de Llama), de 0.8B, pensado para validar la instalación.
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUFResultado esperado: el comando baja el modelo directo desde Hugging Face y abre una sesión interactiva donde podés escribir y recibir respuestas. Ojo con la primera ejecución: tarda más porque descarga. Si tu conexión es lenta, dejalo terminar. Para más detalles técnicos, mirá nuestra guía completa de IA local.
Paso 3: Levantá un servidor con interfaz web
Con el mismo modelo, arrancá el servidor compatible con OpenAI que documenta el README. Sirve para conectar tus scripts o aplicaciones como si hablaran con una API.
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUFResultado esperado: la consola muestra que el servidor está escuchando. Abrí en el navegador la dirección que imprime y deberías ver la interfaz web integrada. El README no fija el puerto en el fragmento que consulté, así que leelo de la salida de la consola.
Ojo: si otra aplicación ocupa ese puerto, el servidor falla al arrancar. Cerrá la otra o cambiá el puerto según la documentación del servidor.
Paso 4: Elegí un Llama en GGUF que entre en tu memoria
Buscá en Hugging Face una versión GGUF del modelo Llama que quieras y calculá si entra en tu máquina. Los repositorios oficiales de Meta piden aceptar la licencia antes de bajar.
La cuenta de almacenero es esta: memoria aproximada en GB = parámetros totales (en miles de millones) × bits de cuantización ÷ 8. Sale de una idea simple: cada parámetro ocupa tantos bits como la cuantización, y 8 bits son un byte. Es una estimación mía, solo de los pesos: no incluye el contexto ni el overhead del motor, y los formatos reales de cuantización pueden ocupar algo distinto al número de bits nominal. Usala para descartar, no para prometerte que algo entra justo. Con los tamaños del LLaMA original que menciona el paper:
| Modelo (LLaMA original) | 4 bits | 8 bits |
|---|---|---|
| 7B | unos 3.5 GB | unos 7 GB |
| 13B | unos 6.5 GB | unos 13 GB |
| 65B | unos 32.5 GB | unos 65 GB |
Ejemplo hipotético: elegir modelo para una notebook de 16 GB
Este es un caso hipotético, armado para mostrar cómo se usa la fórmula; no es una medición ni algo que haya probado. Imaginá una notebook sin GPU dedicada con 16 GB de RAM, de la que el sistema operativo y el navegador ya se llevan una parte.
- 65B a 4 bits (≈32.5 GB): supera los 16 GB de entrada. Se descarta.
- 13B a 8 bits (≈13 GB): en el papel entra, pero deja muy poco para el sistema, el contexto y el motor. Riesgo alto de que el sistema mate el proceso.
- 13B a 4 bits (≈6.5 GB): deja margen amplio. Es un candidato razonable.
- 7B a 8 bits (≈7 GB): también deja margen, con menos pérdida de precisión por cuantización que a 4 bits. Es la alternativa si priorizás calidad por parámetro.
En este ejemplo empezaría por 13B a 4 bits o 7B a 8 bits y probaría ambos con los mismos prompts de trabajo. Cuál responde mejor no lo puedo adelantar: hay que probarlo.
Criterios para decidir
- ¿Entra con margen? Calculá con la fórmula y, como criterio prudente propio (no medido), no apuntes a llenar toda la memoria disponible: el contexto y el sistema también consumen.
- ¿Cuánta calidad perdés? Cuanto más cuantizás, más calidad se pierde, y el README no trae datos de ese costo. Bajá de bits solo si hace falta para que entre, y compará contra una versión menos cuantizada si podés.
- ¿Pesos en GPU o en CPU? Si el modelo supera tu VRAM, el README menciona inferencia híbrida CPU+GPU, pero espera más lentitud.
- ¿Tu caso es repetitivo? Si siempre hacés la misma tarea (clasificar, resumir), un modelo más chico y bien probado suele bastar. Si la tarea es abierta, probá un tamaño mayor. Esto es criterio mío, no un resultado de las fuentes.
Antes de bajar, revisá la sección de modelos de la documentación del repositorio para confirmar que llama.cpp soporte la arquitectura. No pude verificar en estas fuentes que Llama 4 esté soportado.
Paso 5: Corré tu modelo Llama
Usá la misma sintaxis del paso 2, pero cambiando el repositorio que va después de -hf por el del GGUF de Llama que elegiste. Lo mismo vale para llama serve si querés el servidor.
Resultado esperado: tras la descarga, tenés la sesión interactiva con tu Llama. Si el modelo es más grande que tu VRAM, el README menciona inferencia híbrida CPU+GPU, y tiene páginas sobre uso multi-GPU y resolución de problemas de rendimiento. En un agente de IA local y gratuito profundizamos sobre esto.
Ojo con esto: un modelo grande en CPU puede responder con una lentitud desesperante. No es un bug.
Resultado final
Al terminar tenés llama.cpp instalado y un modelo corriendo en tu máquina, por consola y vía un servidor con interfaz web. Para verificar, abrí la sesión con llama cli, escribí una pregunta y fijate que responda. Una vez descargado el modelo, no necesitás conexión para usarlo: la inferencia es local.
Lo que ganás: probar prompts sin mandar datos a un tercero y armar prototipos contra una API local. Lo que no ganás: la calidad de un servicio en la nube con un modelo enorme, salvo que tengas hardware para eso.
Errores comunes al correr Llama en local
“El término ‘llama’ no se reconoce como nombre de un cmdlet”
Aparece en el paso 1 o 2 en PowerShell. Pasa cuando la instalación no terminó o la terminal no leyó el PATH actualizado. Solución: cerrá todas las terminales, abrí una nueva y probá de nuevo. Si sigue igual, repetí el instalador o usá los binarios de la página de releases.
El proceso se cierra o la máquina se congela al cargar el modelo
Ocurre en el paso 5. Bajás el modelo, lo cargás, la consola se queda pensando un buen rato, el ventilador de la notebook arranca como si fuera a despegar, y al final el sistema mata el proceso porque el modelo no entraba en memoria y nadie te avisó antes. Solución: recalculá con la cuenta del paso 4, elegí un modelo más chico o una cuantización más agresiva, y cerrá otras aplicaciones pesadas.
Acceso denegado al descargar el modelo oficial
Pasa en el paso 4, con repositorios oficiales de Meta. Probablemente falte aceptar la licencia con tu cuenta de Hugging Face. Solución: iniciá sesión, abrí la página del modelo, aceptá las condiciones y reintentá.
El modelo no carga porque no está en formato GGUF
Pasa en el paso 5 cuando bajás pesos en otro formato. llama.cpp trabaja con GGUF. Solución: buscá una versión GGUF del mismo modelo en Hugging Face y usá ese repositorio con -hf.
¿Qué limitaciones tiene Llama?
Como cualquier modelo de lenguaje, Llama puede inventar datos con tono convencido, y la licencia lo entrega “as is”: los riesgos de usarlo son tuyos. Verificá todo lo que importe antes de publicarlo.
Sobre el español: las fuentes de esta nota no traen datos de rendimiento por idioma, así que no te prometo nada. Probalo con textos reales de tu rubro antes de apostar un producto. Lo explicamos a fondo en recortar los costos de la API de Llama.
¿Sigue Meta desarrollando Llama en 2026?
No hay una confirmación oficial de que Meta haya cerrado Llama. Hasta octubre de 2026, lo último que documentan estas fuentes de la familia es Llama 4. Separo lo confirmado de lo no confirmado:
- Confirmado: la licencia de Llama 4 está publicada con fecha del 5 de abril de 2025, y llama.cpp sigue siendo un proyecto activo con documentación vigente.
- No confirmado: si habrá nuevas versiones de Llama, y cuándo.
Mi opinión: si ya tenés algo en producción con Llama 4, los pesos que bajaste siguen siendo tuyos para usar bajo la licencia. El riesgo es de futuro, no de presente. Si estás por elegir una base para un proyecto largo, tené un plan B, y revisá novedades antes de decidir porque esto cambia rápido.
Preguntas Frecuentes
¿Qué es Llama y quién lo creó?
Llama es una familia de modelos de lenguaje creada por Meta, presentada en un paper de arXiv del 27 de febrero de 2023. El paper lo firman Hugo Touvron y 13 coautores, y describe modelos de 7B a 65B parámetros.
¿Llama es gratis?
Sí, descargar y usar los pesos de Llama 4 es gratis bajo la Llama 4 Community License, que es libre de regalías. Tiene condiciones: mostrar “Built with Llama” al distribuir y pedirle licencia a Meta si superás los 700 millones de usuarios activos mensuales.
¿Llama es de código abierto?
No según la definición de la OSI. Los pesos están disponibles para descargar, pero la licencia es propia de Meta y tiene restricciones, por eso lo correcto es hablar de pesos abiertos.
¿Cuál es la diferencia entre Llama y llama.cpp?
Llama es la familia de modelos de Meta; llama.cpp es un motor de inferencia en C/C++ de la comunidad ggml-org. El primero son los pesos, el segundo el programa que los ejecuta en tu hardware.
¿Se puede usar Llama en mi PC sin conexión?
Sí, una vez descargado el modelo la inferencia con llama.cpp es local y no necesita internet. Sí hace falta conexión para la primera descarga, y que tu memoria alcance para el tamaño elegido.
Conclusión
Quedaste con una idea clara de qué es Llama (los pesos de Meta, con licencia propia), con un criterio para saber qué obligaciones te tocan según lo que hagas con él, y con una cuenta para decidir qué tamaño y cuantización entran en tu máquina. Además tenés llama.cpp funcionando, verificado con un modelo chico y listo para cargar un Llama en GGUF. Tiene sentido repetir el proceso cada vez que cambies de modelo o de máquina, y escalar a un servidor propio cuando necesites que otras aplicaciones lo consuman.
Lo que sigue es probar tu caso real: un tamaño de modelo, una cuantización, un puñado de prompts de tu trabajo. Y antes de lanzar algo comercial, releé la licencia vigente y chequeá el estado de la familia, porque el futuro de Llama en Meta todavía no está claro.