
En pocas palabras: Al portar seis tareas de cli-bench a Kaggle (10 de octubre de 2026), su autor halló dos bugs propios: una tarea de XSS que ningún arreglo correcto aprobaba y otra que describía una regla distinta de la que evaluaba. Después, 35 de 36 corridas pasaron, incluido GPT-5.6 Luna.
Un benchmark de agentes de código mide si un modelo resuelve tareas de programación con un verificador automático. El 10 de octubre de 2026, el autor de cli-bench publicó su port a Kaggle: seis tareas, seis modelos, 35 de 36 corridas aprobadas y dos bugs propios descubiertos antes de empezar.
cli-bench es un benchmark abierto (licencia Apache-2.0) para agentes de código que trabajan en una terminal, según su repositorio en GitHub. Cada tarea es un repositorio chico con un bug para arreglar, una función para construir o un código para acelerar, más un script verificador que decide si pasa o falla. Ningún modelo califica a otro: o pasan los tests y los controles extra, o la corrida falla.
En este artículo:
- En 30 segundos
- ¿Cómo funciona este benchmark de agentes de código en Kaggle?
- ¿Qué bugs tenía el benchmark antes de probar los modelos?
- ¿Qué resultados dieron los modelos en una sola pasada?
- ¿Rinde mejor un agente con terminal o un modelo sin bucle de ejecución?
- ¿Cómo saber si un fallo es del modelo o del benchmark?
- Qué está confirmado y qué no
- Errores comunes al leer o armar un benchmark
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un solo intento: el autor portó seis tareas de cli-bench a Kaggle, donde el modelo ve todos los archivos y responde con bloques
FILE: path, sin shell ni reintentos. - 35 de 36 corridas pasaron: el único fallo fue Qwen3 Coder 480B en cb-perf-hot-loop.
- Dos bugs del propio benchmark: una tarea de XSS que un arreglo correcto no podía pasar y una consigna que definía mal error_rate. Según el autor, 5 de los 13 trials fallidos de su primer leaderboard venían de ahí.
- GPT-5.6 Luna rindió mejor sin bucle en hot-loop: como agente Codex pasó 1 de 3; en un intento pasó las seis tareas. Es una sola corrida y todo es autoinformado.
¿Cómo funciona este benchmark de agentes de código en Kaggle?
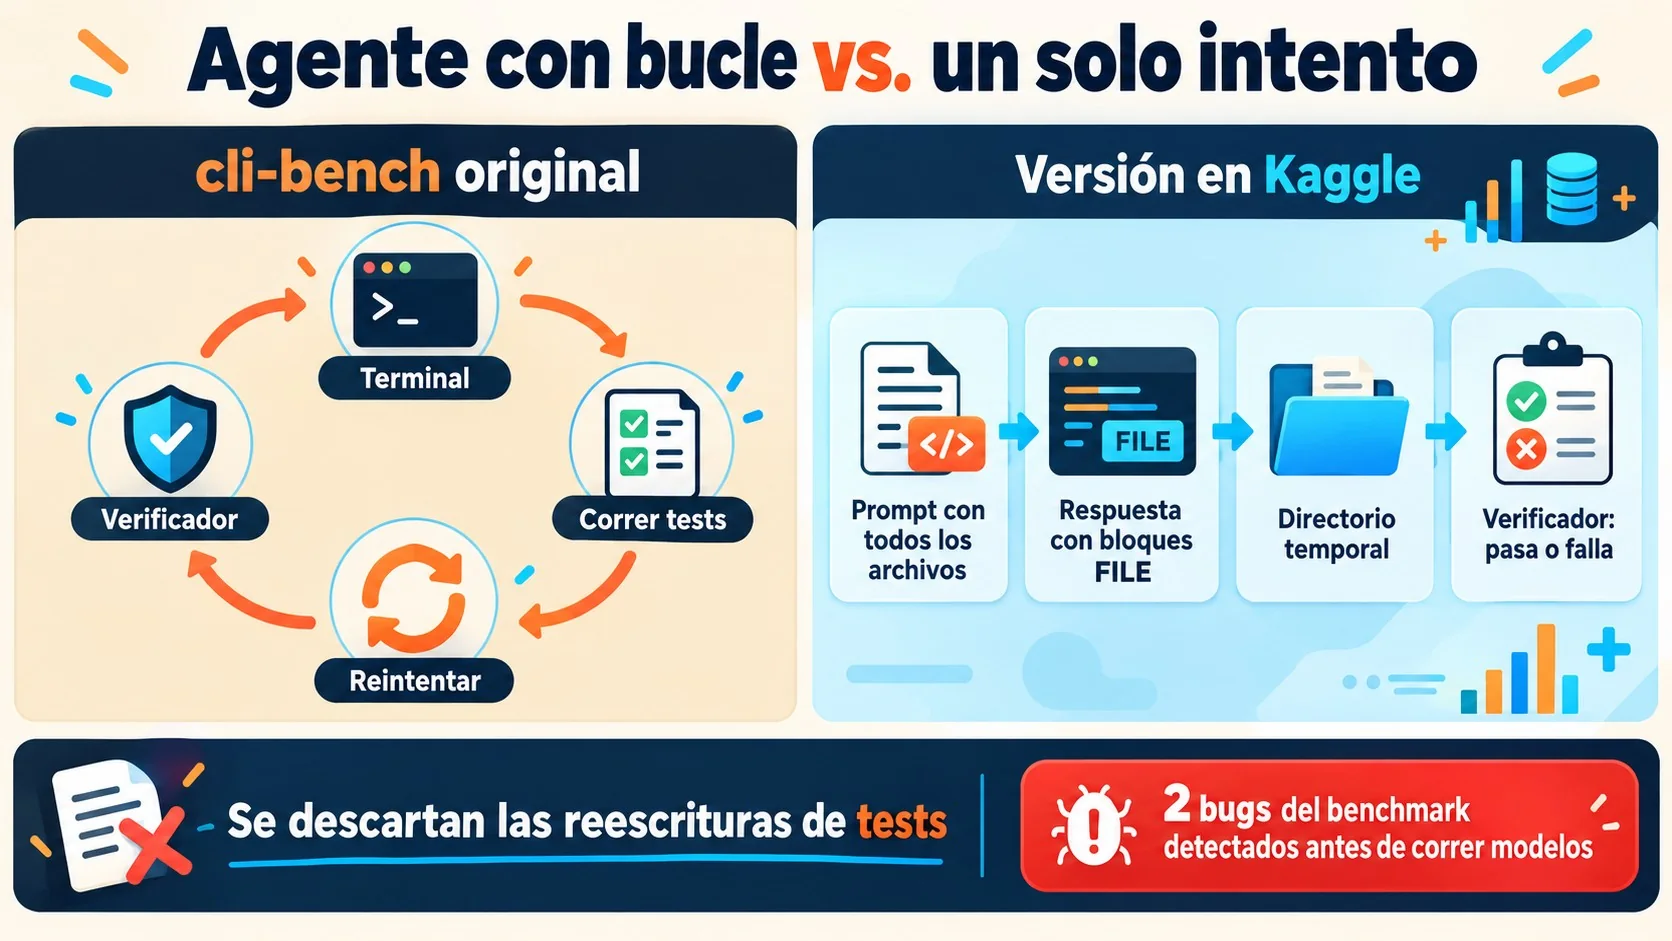
En la versión de Kaggle, el modelo recibe un único prompt con todos los archivos del repositorio y responde con archivos completos en bloques FILE: path. La tarea los escribe en un directorio temporal y corre los verificadores originales de cli-bench. La corrida pasa solo si pasan todos los controles, según el post del autor en dev.to.
Si la respuesta reescribe un archivo de tests o un input, la tarea descarta esa escritura y marca la corrida como fallida, igual que cli-bench con el sabotaje. En el cli-bench original el agente tiene una shell y un presupuesto de tiempo, y el README propone fijar un modelo y variar el arnés. El port saca el bucle del agente y deja al modelo solo frente al código.
La pregunta que plantea el autor: cuánto del puntaje viene de leer bien el código y cuánto de correr tests y reintentar.
- cb-debug-wrong-answer: encontrar el bug en una librería chica de estadística; pasa si la suite de pytest incluida pasa.
- cb-refactor-deadcode: borrar tres funciones sin uso y nada más; las seis funciones vivas tienen que seguir definidas.
- cb-feature-rate-limiter: escribir un token bucket thread-safe con tests de ráfaga, recarga, rollback atómico y 100 hilos a la vez.
- cb-perf-hot-loop: volver un contador de pares al menos 10 veces más rápido en Python puro, con la misma firma y equivalencia aleatoria.
- cb-data-log-analysis: responder siete preguntas exactas sobre un log que el modelo nunca ve, escribiendo un
solve.py. - cb-sec-patch-xss: cerrar un XSS en un tablero de comentarios.
¿Qué es Kaggle Benchmarks y cómo se publica una tarea?
Según el post, Kaggle Benchmarks es donde el autor publicó el benchmark cli-bench-one-shot y sus seis tareas públicas, cada una con el código completo en un notebook. Kaggle corre los modelos a través de su proxy y, al subir una tarea, ejecuta su modelo por defecto. El post no es una guía de publicación, así que el paso a paso no lo podemos confirmar desde acá.
¿Qué bugs tenía el benchmark antes de probar los modelos?
Tenía dos, y el autor los encontró leyendo cada verificador línea por línea y probando cada tarea con una solución de referencia y algunas respuestas incorrectas. En una tarea, un arreglo correcto no podía pasar. En la otra, la consigna describía una regla y el verificador calificaba otra. Más contexto en comparativa de benchmarks entre modelos de frontera.
- sec/patch-xss exigía algo imposible. Dos tests pedían que las palabras
alertyonerrorno aparecieran en la página, pero el probe del verificador pedía que el texto escapado,alertincluido, siguiera ahí. Conhtml.escape, el arreglo de manual, fallan los tests; si borrás el texto, pasan los tests y falla el probe. - data/log-analysis definía mal error_rate. La consigna hablaba de la “fracción de líneas con nivel ERROR”, pero el verificador dividía las líneas ERROR de request por las líneas de request, y cerca de una línea de log cada siete no es un request. Los dos trials de Codex que fallaron erraron solo en error_rate (0.0434 contra 0.05, y 0.038 contra 0.0441), que son los valores que da seguir el texto al pie de la letra.
En el XSS, dos de los tres trials de Codex usaron html.escape y fallaron los tests; el tercero borró el texto y falló el probe. El autor había anotado esos fallos como culpa del modelo. Sumando todo, 5 de los 13 trials fallidos de su primer leaderboard salían del benchmark.
La versión de Kaggle corrige ambos: los tests de XSS ahora buscan markup crudo en vez de palabras, y la consigna dice la regla que el verificador chequea. Ojo: todo esto es autoinformado, nadie lo replicó de forma independiente.
¿Qué resultados dieron los modelos en una sola pasada?
35 de las 36 corridas pasaron. El único fallo fue Qwen3 Coder 480B en cb-perf-hot-loop; los otros cinco modelos sacaron 6 de 6. Cada modelo corrió cada tarea una sola vez, por el proxy de Kaggle y con la temperatura por defecto del SDK, según el autor.
| Tarea | Opus 5.5 | Gemini 3.1 Pro | GPT-5.6 Luna | Qwen3 Coder 480B | gpt-oss-120b | Gemini 3.7 Flash |
|---|---|---|---|---|---|---|
| cb-debug-wrong-answer | pasa | pasa | pasa | pasa | pasa | pasa |
| cb-refactor-deadcode | pasa | pasa | pasa | pasa | pasa | pasa |
| cb-feature-rate-limiter | pasa | pasa | pasa | pasa | pasa | pasa |
| cb-perf-hot-loop | pasa | pasa | pasa | falla | pasa | pasa |
| cb-data-log-analysis | pasa | pasa | pasa | pasa | pasa | pasa |
| cb-sec-patch-xss | pasa | pasa | pasa | pasa | pasa | pasa |
| Total | 6/6 | 6/6 | 6/6 | 5/6 | 6/6 | 6/6 |
Los slugs de Kaggle son gpt-5.6-luna, claude-opus-5-5-default, gemini-3.1-pro-preview, qwen3-coder-480b-a35b-instruct y gpt-oss-120b. Gemini 3.7 Flash no estaba en el plan: Kaggle corre su modelo por defecto cuando se sube una tarea, así que entró gratis.
Lo que muestra la tabla es que estas seis tareas no separan modelos de frontera en un intento. Tomalo como dato sobre la dificultad de las tareas, no como ranking: con un 6/6 casi general no hay nada que ordenar. Ya lo cubrimos antes en rendimiento en tareas de código sobre repos reales.
¿Rinde mejor un agente con terminal o un modelo sin bucle de ejecución?
En una tarea y con GPT-5.6 Luna, rindió mejor sin bucle, pero con una sola corrida no se puede generalizar. Como agente Codex, ese modelo pasó 23 de 36 trials en la suite completa de cli-bench y 1 de 3 en hot-loop. En un intento, pasó las seis tareas de Kaggle.
Los números de hot-loop, medidos por el autor en su máquina: el agente Codex tuvo un speedup de peor caso de 1.2x en el dataset gridded, y en un intento el modelo escribió una grilla espacial que, cronometrada contra el mismo verificador, dio 42.5x en puntos uniformes, 26.5x en gridded y 14.6x en clustered. Las salvedades que reconoce el autor son reales: una corrida contra tres, una semilla de dataset contra tres y máquinas distintas. Su hipótesis (no una medición) es que tener shell empujó al agente a medir y parchear una solución lenta en vez de buscar la rápida.
Los seis modelos llegaron a la misma idea, bucketizar los puntos en una grilla. Para todos los que pasaron, el caso más duro fue clustered (entre 14.6x y 41x), no gridded.
¿Y qué atrapó el verificador que los tests incluidos no? La grilla de Qwen3 Coder pasaba los nueve unit tests que venían con la tarea y aun así subcontaba: en un caso aleatorio encontró 84 pares donde había 123. Solo la comparación aleatoria contra la versión ingenua lo detectó. Si el verificador hubiera parado en los tests incluidos, ese bug contaba como aprobado. Relacionado: cómo se comportan estos modelos en DeepSWE.
Qué decisión podés tomar con esto: si evaluás agentes para tu equipo, vale la pena correr también una línea base de un solo intento en tareas acotadas, porque puede igualar o superar al agente. Lo que estos datos no permiten es concluir que la terminal empeora a los agentes en general; es una tarea, un modelo y una corrida.
¿Cómo saber si un fallo es del modelo o del benchmark?
Hay que verificar el benchmark antes de culpar al modelo. El autor lo resume así: un benchmark que nunca se corrió contra una respuesta correcta conocida todavía no es un benchmark. Ahora cada tarea trae una solución de referencia, una respuesta vacía y una que reescribe tests, y solo cuenta si la primera pasa y las otras dos fallan, en el entorno donde corren los modelos.
Ponele cómo salió la primera tanda en Kaggle: 9 fallas, 7 del arnés. El runtime de Kaggle no trae pytest y el runner alternativo del autor no soportaba fixtures como tmp_path y monkeypatch, así que los seis modelos “fallaron” el XSS pese a haber escapado bien la salida. Además, el parser rechazó **FILE: solve.py** de gpt-oss-120b; el autor corrió ese script a mano contra el mismo log y todas las respuestas daban bien.
Las dos fallas reales fueron el bug de hot-loop de Qwen y un script de log que llamaba a statistics.quantiles con un nombre de método inexistente y se rompía. En la re-corrida, Qwen escribió otro script y pasó (una muestra a temperatura por defecto, no un veredicto). Dicho esto, el balance que deja el autor es incómodo: sus errores (dos consignas, un runner, un parser) causaron más fallas que los modelos. Complementá con agentes de IA que reescriben código en Rust.
Propuesta editorial, que no sale de la fuente: ante cualquier fallo, hacé tres chequeos.
- Mirá si fallan todos igual. Si seis modelos distintos tropiezan en la misma tarea con una salida que parece correcta, sospechá del verificador o del entorno primero.
- Reproducí a mano. Tomá la salida del modelo, correla contra el verificador fuera del arnés y compará.
- Repetí en el entorno real. Que pase en tu laptop no alcanza; el caso de pytest lo demuestra.
Qué está confirmado y qué no
- Confirmado por el autor: las seis tareas, los seis modelos, el resultado de 35 de 36, los dos bugs de cli-bench 0.9.1 y los siete fallos del arnés. El código de cada tarea está publicado en Kaggle y cli-bench es Apache-2.0.
- Confirmado en el repositorio: el primer resultado medido en cohorte, codex con gpt-5.6-luna, 12 tareas por 3 semillas, CB-HDR 0.592 en la suite 0.9.1.
- No confirmado: que alguien haya replicado estos resultados de forma independiente. Nosotros no corrimos el benchmark.
- No concluyente: la comparación agente contra un intento, que mezcla una corrida contra tres, semillas distintas y máquinas distintas.
Errores comunes al leer o armar un benchmark
- Anotar el fallo como culpa del modelo sin controlar. El autor lo hizo con el XSS y con error_rate. Corrección: antes de publicar un leaderboard, pasá la solución de referencia por el verificador.
- Confiar en los tests que vienen con la tarea. La grilla de Qwen pasó los nueve y estaba mal. Corrección: sumá una comparación aleatoria contra una versión de referencia.
- Tratar una corrida como veredicto. Un solo crash, como el de
statistics.quantiles, se ve como variación recién con tres o más corridas por modelo. - Dar por hecho que tu entorno es el de ejecución. Sin pytest en Kaggle, seis modelos “fallaron” una tarea que habían resuelto. Corrección: probá el verificador donde corren los modelos.
Preguntas Frecuentes
¿Qué es cli-bench y para qué sirve?
cli-bench es un benchmark abierto bajo licencia Apache-2.0 para evaluar agentes de código que trabajan en una terminal. Sirve para comparar arneses (Codex, Claude Code, OpenCode y otros) con el mismo modelo, las mismas tareas y el mismo presupuesto. La suite v0.9.1 tiene 12 tareas con 3 semillas cada una.
¿Cómo se evalúa a un agente de código sin que lo corrija otro modelo?
Con verificadores programáticos: cada tarea trae un script que decide pasa o falla corriendo tests y controles extra. El README de cli-bench aclara que no hay juez LLM en el puntaje primario. Si el agente borra los tests o reescribe los inputs, el sistema lo detecta y la tarea falla.
¿Un modelo rinde mejor con o sin bucle de ejecución de tests?
Depende de la tarea, y estos datos solo cubren una. GPT-5.6 Luna pasó hot-loop 1 de 3 como agente Codex y pasó las seis tareas en un intento, pero con una corrida contra tres, semillas y máquinas distintas. El autor planea una versión con herramienta para correr tests y medir si un reintento ayuda o perjudica.
¿Qué modelos se probaron en el cli-bench de Kaggle?
Seis: gpt-5.6-luna, claude-opus-5-5-default, gemini-3.1-pro-preview, qwen3-coder-480b-a35b-instruct, gpt-oss-120b y gemini-3.7-flash. Este último entró porque Kaggle corre su modelo por defecto al subir una tarea. Cinco sacaron 6 de 6 y Qwen3 Coder 480B sacó 5 de 6.
Conclusión
La noticia no es que cinco de seis modelos aprobaran todo, sino lo que el autor encontró en su propio benchmark: dos tareas mal armadas, un runner sin soporte de fixtures y un parser demasiado estricto. En los dos leaderboards, esos errores explicaron más fallas que los modelos. Si usás un benchmark de agentes de código para decidir herramientas, exigile lo mismo que el autor se exigió: solución de referencia que pase, respuesta vacía que falle y reescritura de tests que falle, en el entorno real.
Y leé los números con pinzas: una corrida por modelo, resultados autoinformados y sin replicación externa. El siguiente paso del autor (tareas más difíciles, tres o más corridas por modelo y una versión con herramienta para correr tests) es lo que puede volver estos datos comparables.
Fuentes
- Kaggle – benchmark cli-bench-one-shot con las seis tareas públicas
- GitHub – repositorio de cli-bench (licencia Apache-2.0, suite v0.9.1)
- dev.to – post del autor sobre el port a Kaggle y los bugs propios
- Kaggle – tarea cb-perf-hot-loop