En pocas palabras: Ollama permite hostear LLMs como Llama 3 en tu propia infraestructura sin privilegios de root, instalándolo en Linux con un solo comando curl. El modelo pesa 4,7 GB y expone una API REST en localhost:11434, manteniendo los datos dentro de tu red.
Ollama te deja correr modelos como Llama 3 en tu propia máquina, sin mandar una sola línea de código a los servidores de OpenAI o Anthropic. La instalación en Linux no pide permisos de root, el modelo llama3 pesa unos 4,7 GB y la API queda escuchando en localhost:11434 lista para usar.
LLMs locales con Ollama significa ejecutar modelos de lenguaje grande dentro de tu propia infraestructura en vez de consumirlos vía API de terceros. Ollama es una herramienta open source que descarga, convierte y sirve modelos como Llama 3, Phi-3 o Gemma a través de una API REST; la documentación oficial confirma que el servidor local corre en el puerto 11434. Sirve para prototipar asistentes internos, analizar documentos sensibles o automatizar tareas sin que los datos salgan de tu red.
En este artículo:
- En resumen
- ¿Qué riesgo corrés al mandar datos de tu empresa a una IA en la nube?
- ¿Qué son los LLMs locales con Ollama y para qué sirven?
- ¿Cómo instalar Ollama sin permisos de root en Linux (y qué pasa en Windows y Mac)?
- ¿Cómo descargar y probar un modelo con ollama pull y ollama run?
- ¿Cómo usar la API REST de Ollama en localhost:11434?
- ¿Cuánta RAM y qué hardware necesitás para correr LLMs locales?
- ¿CPU o GPU para Ollama? Cuándo alcanza el procesador y cuándo hace falta tarjeta de video
- ¿Cómo asegurar Ollama con rate-limiting, proxy reverso y TLS?
- ¿Qué significa esto para equipos y empresas en Latinoamérica?
- Errores comunes al self-hostear LLMs con Ollama
- Preguntas Frecuentes
- Conclusión
- Fuentes
En resumen
- Ollama corre en Linux sin privilegios de root: alcanza con
curl -fsSL https://ollama.ai/install.sh | shyollama serve &. - El modelo llama3 pesa unos 4,7 GB al bajarlo con
ollama pull llama3, según la guía técnica analizada. - La API queda expuesta en http://localhost:11434/api/generate sin autenticación nativa, así que nunca la publiques directo a internet.
- Para producción, calculá mínimo 32 GB de RAM; con 8 GB el sistema se queda corto apenas arranca.
- CPU alcanza para batch jobs nocturnos; para chat en tiempo real con latencia baja hace falta GPU con CUDA o ROCm.
¿Qué riesgo corrés al mandar datos de tu empresa a una IA en la nube?
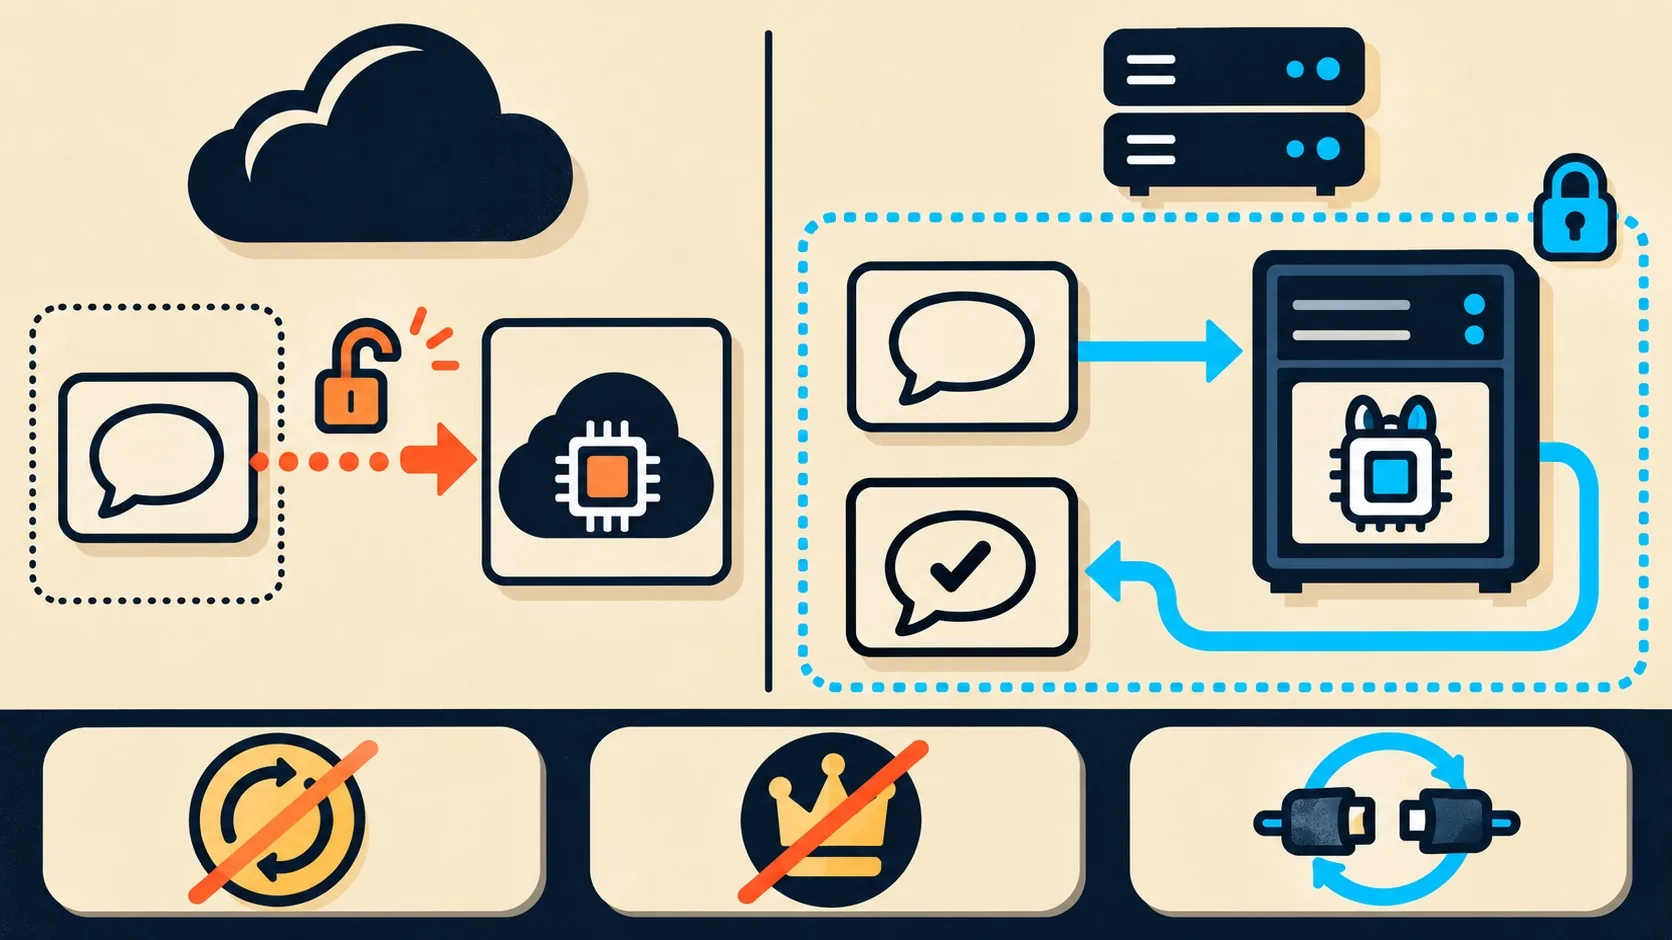
Cada vez que pegás un prompt con código propio o datos de un cliente en ChatGPT o Claude, esa información sale de tu red y entra en la infraestructura de un tercero. Aunque el proveedor firme un acuerdo de nivel de servicio estricto, vos perdés control sobre cómo se procesa, almacena o eventualmente se usa para reentrenar modelos.
Pensalo así: mandás un script interno para que te lo optimicen y, sin darte cuenta, ese fragmento de tu base de datos ya viajó a servidores que no administrás. ¿Firmaste un contrato de confidencialidad con tu proveedor cloud? Puede ser. ¿Eso te devuelve el control real sobre esos datos? No necesariamente.
Ahí entra el self-hosting.
La alternativa es correr el modelo en tu propia máquina o servidor, sin que nada salga de tu red. Eso es justo lo que resuelve Ollama, y es el eje de la guía técnica que estamos usando como base para este artículo.
¿Qué son los LLMs locales con Ollama y para qué sirven?
Ollama es una herramienta open source que te permite bajar, cachear y correr modelos de lenguaje grande como Llama 3, Phi-3 o Gemma directamente en tu hardware. A diferencia de otros frameworks donde manejás manualmente binarios enormes y rutas de archivos, Ollama automatiza todo el proceso de descarga y conversión al formato optimizado que usa internamente. Sobre eso hablamos en nuestra guía completa de IA local.
Para quién sirve esto en concreto: equipos de seguridad que quieren armar análisis automatizados de logs, áreas de soporte que necesitan resumir tickets sin exponer datos de clientes, o cualquier developer que quiera prototipar funciones de IA sin pagar una suscripción mensual. Los LLMs locales con Ollama no reemplazan a GPT-4 o Claude Opus en capacidad bruta, pero para tareas acotadas (resumir, clasificar, generar JSON estructurado) rinden sobradamente.
¿Cómo instalar Ollama sin permisos de root en Linux (y qué pasa en Windows y Mac)?
En Ubuntu o Debian, instalar Ollama no requiere privilegios de administrador ni tocar directorios del sistema. Corriendo curl -fsSL https://ollama.ai/install.sh | sh seguido de ollama serve &, el servicio queda corriendo en tu directorio home, sin modificar /etc ni generar conflictos a nivel de sistema.
Nada de Docker. Nada de excepciones en SELinux.
Para Mac y Windows, Ollama ofrece instaladores gráficos en su sitio oficial: bajás el paquete, lo ejecutás y el servicio arranca solo. La fuente técnica que estamos usando se centra en el caso Linux sin root, que es el escenario más relevante para quien administra servidores propios o VPS.
Si en vez de tu notebook pensás correr esto en un servidor dedicado, la lógica de permisos y firewall es la misma que aplicarías para proteger cualquier infraestructura en la nube, como la que ofrece donweb.com para alojar proyectos propios desde Argentina.
¿Cómo descargar y probar un modelo con ollama pull y ollama run?
Con el comando ollama pull llama3 bajás el modelo completo, un archivo de aproximadamente 4,7 GB según confirma la guía técnica analizada. Una vez descargado, ollama run llama3 abre una sesión interactiva donde podés tirarle un prompt directo, por ejemplo preguntarle cómo reforzar la seguridad de un servidor web, y el modelo responde ahí mismo en tu terminal.
¿Necesitás instalar Python, armar un entorno virtual o configurar dependencias para esta prueba inicial? No. Ollama se encarga de todo el pipeline de carga por vos. Tema relacionado: un agente de IA local gratuito.
¿Cómo usar la API REST de Ollama en localhost:11434?
Ollama expone una API REST en http://localhost:11434 que responde a pedidos HTTP estándar sin necesitar librerías adicionales. Un curl simple a /api/generate con un JSON que incluya model, prompt y stream:false devuelve una respuesta estructurada, lista para integrar en un sistema de tickets interno o un dashboard de monitoreo.
La documentación oficial de Ollama confirma que además existe compatibilidad con el formato de API de OpenAI (endpoint /v1) y con el cliente de Anthropic, algo útil si ya tenés código escrito para esas plataformas y querés migrarlo sin reescribir todo. El repositorio oficial en GitHub detalla parámetros extra como think (para modelos con razonamiento) o format para forzar JSON mode, útiles si necesitás que la respuesta cumpla un esquema específico.
Ojo: cada respuesta trae métricas de rendimiento en nanosegundos, como eval_count y eval_duration, que te sirven para calcular tokens por segundo y medir si tu hardware da abasto.
¿Cuánta RAM y qué hardware necesitás para correr LLMs locales?
Para uso productivo, 32 GB de RAM es el mínimo que recomienda la guía técnica analizada; con 8 GB el sistema llega rápido a su límite apenas cargás un modelo mediano. La clave para correr modelos grandes en hardware de consumo son las versiones quantizadas, como Q4_K_M, que reducen el tamaño sin destruir la calidad de las respuestas.
Podés controlar cuántos hilos de CPU usa Ollama y si suma GPU a la ecuación con parámetros como num_thread y num_gpu, que se definen en el Modelfile o se pasan al inicializar el modelo. Esto importa si corrés Ollama en un servidor que también atiende otros servicios: sin ese control, un solo proceso de inferencia puede comerse toda la capacidad de cómputo disponible.
¿CPU o GPU para Ollama? Cuándo alcanza el procesador y cuándo hace falta tarjeta de video
La CPU alcanza y sobra para trabajos en batch, como resumir una pila de documentos durante la noche sin que nadie esté esperando la respuesta en el momento. Recién cuando necesitás chats en tiempo real con latencia de milisegundos, una GPU con CUDA o ROCm se vuelve obligatoria. Complementá con cómo armar agentes locales con Gemma 4.
¿Tenés una GPU gamer guardada en un cajón? Para esto le sobra.
La decisión práctica pasa por el caso de uso: si tu proyecto es analizar tickets de soporte una vez por día, ahorrate la placa de video. Si estás armando un asistente conversacional que responde en vivo a clientes, ahí sí necesitás invertir en hardware gráfico.
| Aspecto | Ollama local | API en la nube |
|---|---|---|
| Control de datos | Total, nada sale de tu red | Depende del SLA del proveedor |
| Costo recurrente | Sin cuota mensual | Suscripción o pago por token |
| Requisito de hardware | Mínimo 32 GB RAM recomendado | Ninguno, corre en servidores del proveedor |
| Tiempo real con baja latencia | Necesita GPU (CUDA/ROCm) | Generalmente rápida, gestionada por el proveedor |
| Caso de uso ideal | Datos sensibles, batch jobs, prototipos internos | Picos de demanda variables sin infraestructura propia |
¿Cómo asegurar Ollama con rate-limiting, proxy reverso y TLS?
La API de Ollama no trae autenticación nativa cuando corre en modo local, según confirma la documentación oficial; eso significa que cualquiera con acceso a ese puerto puede mandarle pedidos. Nunca expongas el puerto 11434 directo a internet: ponés un proxy reverso como Nginx o Caddy adelante, forzás TLS y sumás rate-limiting o un script de Fail2ban para frenar abusos.
Esto no es opcional. Es el mínimo indispensable.
Subís el modelo, lo probás en tu notebook, funciona perfecto, lo migrás a un servidor para que el equipo lo use, y de repente te das cuenta de que dejaste el puerto abierto sin ningún filtro, cualquier persona en la misma red podría estar mandándole prompts a tu modelo sin que te enteres.
Para un control más fino, la guía técnica propone atar el acceso a certificados de cliente, de forma que solo dispositivos autorizados puedan hablarle a la API.
¿Qué significa esto para equipos y empresas en Latinoamérica?
Para equipos técnicos en Argentina, Chile o México, correr LLMs locales con Ollama tiene un atractivo extra: evitás pagar suscripciones en dólares que se encarecen con cada devaluación. Si tu empresa maneja datos de clientes bajo alguna política interna de residencia de datos, mantener el procesamiento dentro de tu propia infraestructura simplifica bastante esa conversación con el área legal. Para más detalles técnicos, mirá reducir drásticamente los costos de API.
Eso sí: la inversión en hardware (RAM, eventualmente GPU) hay que amortizarla contra lo que gastarías en llamadas a una API. No es gratis de arranque, aunque a mediano plazo compense.
Errores comunes al self-hostear LLMs con Ollama
Los tres errores que más se repiten entre administradores con experiencia son no limitar la tasa de pedidos, ignorar el límite de contexto del modelo y dejar de actualizar las versiones descargadas.
- Falta de rate-limiting: como la API es tan abierta, muchos se olvidan de ponerle límites. Sin un proxy que filtre pedidos, cualquier script mal hecho, o un ataque directo, puede saturar el servicio.
- Ignorar el context window: cada modelo tiene un tope de tokens que puede retener en una sola pasada. Si le tirás un manual entero de una, el modelo descarta la información más vieja. La solución real es cortar el contenido en fragmentos con la técnica RAG.
- No actualizar los modelos: los modelos open source también reciben parches contra jailbreaks y prompt injection. Dejar una versión vieja corriendo durante meses es dejar la puerta abierta a trucos que el modelo nuevo ya bloquea.
Preguntas Frecuentes
¿Qué es Ollama y para qué sirve?
Ollama es una herramienta open source que te permite descargar y correr modelos de lenguaje grande como Llama 3 o Phi-3 en tu propia computadora o servidor. Sirve para prototipar asistentes de IA, analizar documentos internos o automatizar tareas sin mandar datos a una API externa.
¿Ollama es gratis?
Sí, Ollama es gratis y no cobra cuota de suscripción, según detalla la guía técnica analizada. El único costo real es el hardware necesario para correr los modelos: RAM, almacenamiento y, en algunos casos, una GPU.
¿Cómo instalo Ollama sin ser administrador en Linux?
Alcanza con ejecutar curl -fsSL https://ollama.ai/install.sh | sh seguido de ollama serve & desde tu usuario normal. El servicio corre dentro de tu directorio home sin tocar archivos del sistema ni requerir privilegios de root.
¿Cómo protejo la API de Ollama para que no quede abierta a internet?
Nunca expongas el puerto 11434 directo a internet sin protección. Ponés un proxy reverso como Nginx o Caddy adelante, forzás TLS y sumás rate-limiting, por ejemplo con Fail2ban, para filtrar pedidos abusivos.
¿Cuánta RAM necesito para correr un modelo como Llama 3 en Ollama?
Para uso productivo, la guía técnica recomienda un mínimo de 32 GB de RAM. Con 8 GB el sistema se queda corto rápido apenas cargás el modelo, aunque usar versiones quantizadas como Q4_K_M ayuda a correr modelos grandes en hardware más modesto.
Conclusión
Ollama le baja la persiana a una dependencia que muchos equipos ni discuten: mandar cada prompt con datos sensibles a un servidor ajeno. La instalación sin root, el pull de modelos como llama3 en minutos y una API REST simple hacen que correr LLMs locales con Ollama sea una opción real, no un experimento de laboratorio.
Lo que no cambia es la responsabilidad de asegurar bien ese stack: sin rate-limiting, sin TLS y sin actualizar modelos, estás cambiando un riesgo (la nube de un tercero) por otro (tu propio servidor mal configurado). Si tu próximo paso es levantar esto en un VPS en vez de tu notebook, arrancá con un usuario dedicado, un modelo liviano como Phi-3 y un proxy bien configurado antes de pensar en escalar.