Un fundador solo en Seúl armó, junto a su copiloto de IA, un agente que lee 14 páginas oficiales de aceleradoras y fondos y responde con cita textual exacta a cuáles puede aplicar sin hablar inglés ni tener empresa constituida. Corrió el 3 de octubre de 2026 con el modelo local gemma3:4b, y los números (47 hechos extraídos, 39 verificados, 99,8 segundos) salen directo de esa corrida real.
Funding Fit es un agente de inteligencia artificial que lee únicamente páginas oficiales de aceleradoras y fondos (nunca notas de prensa ni blogs) para decirle a un fundador solo, sin empresa constituida y sin inglés fluido, a qué programas puede aplicar. Lo construyó Junyoung Park, fundador en Seúl, usando Sanity Context como base de conocimiento y el modelo local gemma3:4b corriendo en su propia PC.
En este artículo:
- Resumen rápido
- ¿Cómo está armado el agente por dentro?
- ¿Qué tres herramientas usa el agente para buscar la información?
- ¿Cómo verifica el agente que cada dato sea real y no una alucinación?
- ¿Qué aceleradoras quedaron aptas, condicionadas o excluidas en la prueba real?
- ¿Qué resultados numéricos dio el agente en las tres preguntas de prueba?
- ¿Cuáles son los límites de este enfoque?
- Qué está confirmado y qué no
- Errores comunes al armar un agente de elegibilidad así
- Preguntas Frecuentes
- Conclusión
- Fuentes
Resumen rápido
- Funding Fit evaluó 9 aceleradoras y VCs reales usando una base de conocimiento de 14 fuentes oficiales armada en Sanity Context.
- El modelo gemma3:4b corre local vía Ollama: todo queda en la PC del creador, menos la consulta de búsqueda que va a Sanity.
- En la corrida del 3 de octubre de 2026, el agente extrajo 47 hechos y verificó 39 con cita textual en 99,8 segundos para la pregunta sobre aplicar sin empresa ni entrevista en inglés.
- El veredicto final (apply, conditional o excluded) lo calcula el código a partir de hechos verificados, no el modelo de lenguaje.
- Hustle Fund, TheVentures, FuturePlay y Mashup Ventures quedaron sin condición bloqueante; Y Combinator, Founder University, SparkLabs y Betaworks Camp quedaron excluidos.
¿Cómo está armado el agente por dentro?
El corazón de Funding Fit es una knowledge base en Sanity Context armada con 14 fuentes oficiales: un crawl de las páginas de aplicación y FAQ de Y Combinator más 13 archivos Markdown escritos a mano a partir de páginas oficiales de Hustle Fund, Betaworks Camp, TheVentures, Founder University, Afore, D.CAMP, FuturePlay, SparkLabs, Antler Korea, Mashup Ventures, Zoom-In Partners y Kakao Ventures.
Esas fuentes se organizan en 9 entries temáticas: eligibility, korea_programs, global_programs, interviews, program_logistics, program_structure, application_process, investment_terms y comparison. Lo que realmente define el foco del agente es el campo “purpose” de la knowledge base, que Park escribió así: “Lead with eligibility rules: whether a company is required, remote or in-person (and where), interview format and language, check size, how to apply and deadlines. Out of scope: marketing copy, portfolio news.” Esa última frase (out of scope) es la que evita que el agente se vaya por las ramas con notas de portfolio o comunicados de prensa.
Todo el procesamiento del lenguaje corre local con gemma3:4b vía Ollama, un modelo de 4,3 mil millones de parámetros cuantizado (Q4_K_M, 3,3 GB) que entra en una sola GPU. Según detalla el propio desarrollador en el posteo original en dev.to, nada sobre el fundador sale de la PC excepto la query de búsqueda que va a Sanity.
¿Qué tres herramientas usa el agente para buscar la información?
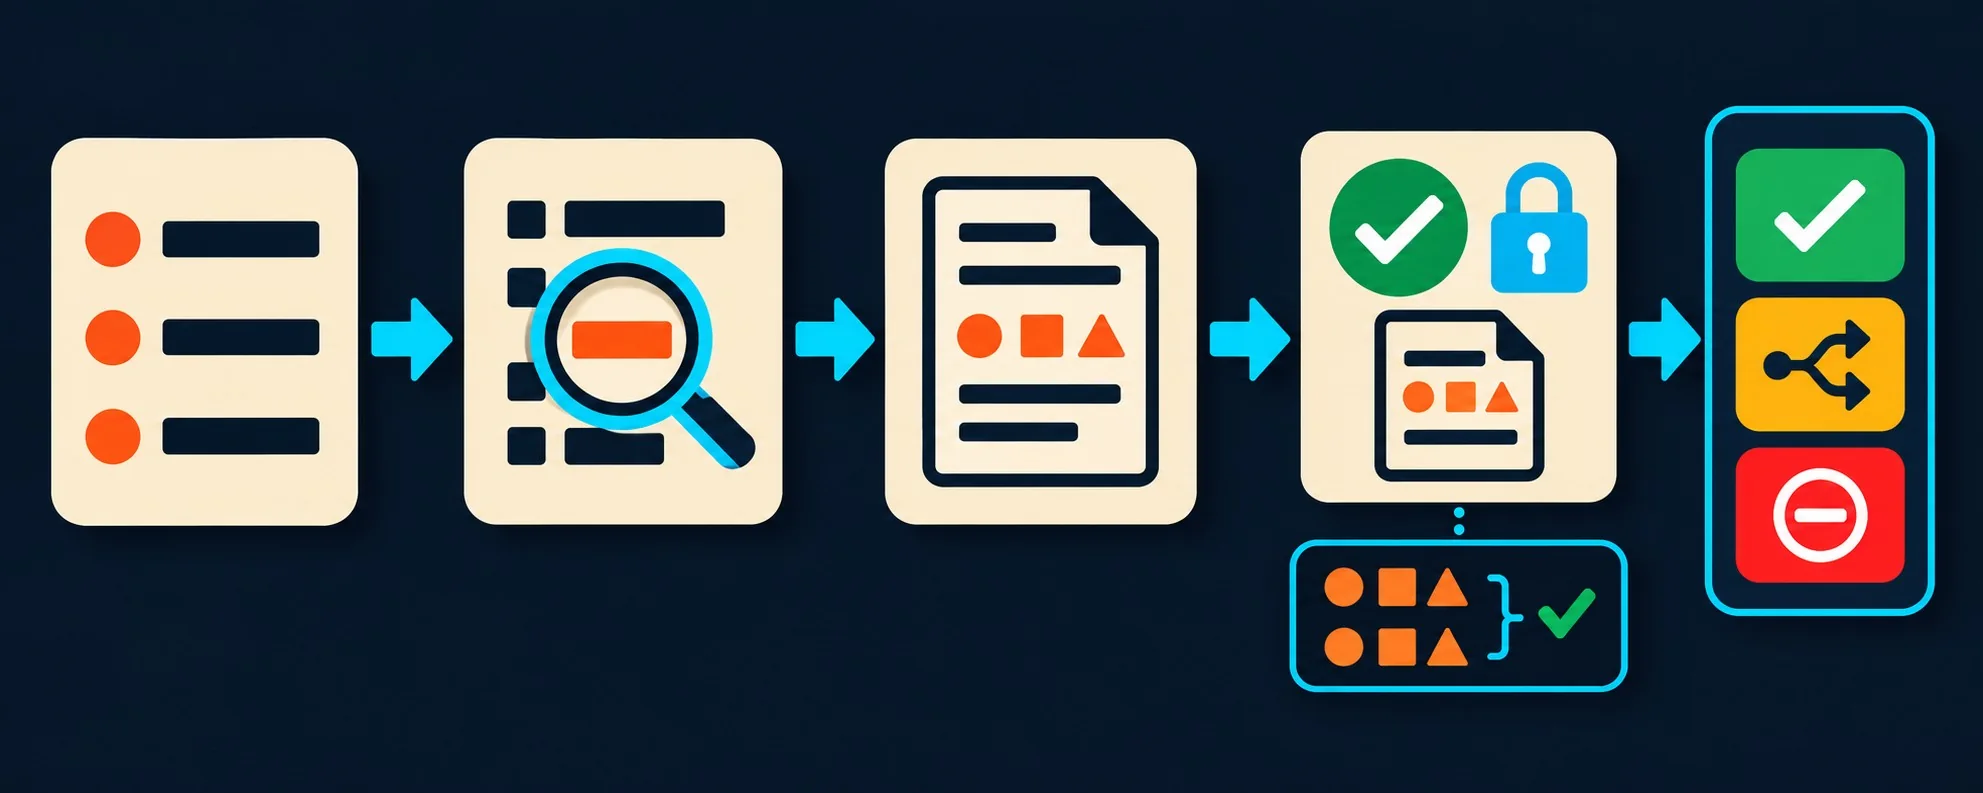
El agente encadena tres llamadas: primero initial_context para listar los paths válidos de la knowledge base, después knowledge_base_search para recall adicional con palabras clave en inglés generadas por el modelo local, y por último knowledge_base_read para traer el contenido completo de cada entry. Cubrimos ese tema en detalle en correr un agente IA local con Ollama.
Una vez que llega el texto crudo, el agente divide cada entry en secciones marcadas con “## Program” y agrupa todo por nombre de programa (los nombres salen únicamente de las entries de perfil, nunca inventados por el modelo). Para cada sección, gemma3:4b extrae 10 campos: empresa, presencial sí/no, ubicación, entrevista por video en inglés, fee, monto de inversión, cómo aplicar, deadline, idioma de aplicación y tiempo hasta la decisión. Cada campo lleva pegada una cita textual verbatim del documento original, no un resumen.
¿Cómo verifica el agente que cada dato sea real y no una alucinación?
El agente valida cada dato con un chequeo de grounding escrito en código, no con otra pasada del modelo. Un valor cuenta como verificado solo si la cita que trajo el modelo aparece literalmente en el texto recuperado y, además, la línea donde aparece tiene sentido para ese campo: por ejemplo, un valor de “empresa requerida” necesita que la línea contenga alguna de las palabras incorporat, company o entity.
¿Y si el modelo dice algo que no cumple esa condición? Se descarta, aunque sea plausible. Eso explica por qué en la corrida real algunos campos quedaron marcados como “근거 부족” (evidencia insuficiente, ignorado) pese a que el texto fuente tocaba el tema de forma indirecta. El veredicto final de cada programa (apply, conditional o excluded) y el resumen que lee el fundador los calcula el código a partir de esos hechos ya verificados, nunca el modelo de lenguaje directamente. Los filtros de cada pregunta también corren en código: palabras como “국내” (doméstico), “한국어” (en coreano) o “지금/상시” (rolling) activan filtros adicionales, y un candidato se descarta solo cuando hay un hecho verificado que lo excluye.
¿Qué aceleradoras quedaron aptas, condicionadas o excluidas en la prueba real?
En la corrida del 3 de octubre de 2026, cuatro programas quedaron sin ninguna condición bloqueante, uno condicional y cuatro excluidos. La tabla siguiente resume el veredicto de cada uno con el motivo exacto que encontró el agente. Te puede servir nuestra cobertura de alojar modelos propios sin depender de terceros.
| Programa | Veredicto | Motivo clave | Dato relevante |
|---|---|---|---|
| Hustle Fund | Candidato | Sin condición bloqueante | Check de $150K, aplicación vía website |
| TheVentures | Candidato | Sin condición bloqueante | VC con sede en Corea, revisión en 1 día hábil |
| FuturePlay | Candidato | Sin condición bloqueante | VC deep tech con sede en Seúl |
| Mashup Ventures | Candidato | Sin condición bloqueante | Hasta ₩500M KRW, decisión en 1-2 meses |
| Antler Korea | Condicional | Residencia full-time en Seúl, 11 semanas, 9 a 18hs | Hasta $260K USD / ₩350M KRW, sin fee |
| Y Combinator | Excluido | Entrevista por video en inglés + batch presencial en San Francisco | Deadline 2 de noviembre, decisión 11 de diciembre |
| Founder University | Excluido | Sesiones en inglés + programa con costo | Check de $25K o $125K |
| SparkLabs | Excluido | Fundadores solos (1 persona) no son elegibles | Ronda ₩100M+ vía CPS o SAFE |
| Betaworks Camp | Excluido | Presencia física obligatoria 12 semanas en Nueva York | Aplicaciones abren diciembre-enero |
Vale aclarar algo importante: “sin condición bloqueante” no significa que esos programas acepten a cualquiera, significa que en las fuentes oficiales analizadas no aparece una regla que descarte directamente al perfil de Park (solo, sin empresa, sin entrevista en inglés). Para TheVentures y FuturePlay, por ejemplo, varios campos quedaron marcados como “sin evidencia” (fee, entrevista en inglés), no como “confirmado que no existe”.
¿Qué resultados numéricos dio el agente en las tres preguntas de prueba?
El agente corrió tres preguntas en coreano el mismo día y los tiempos variaron bastante según cuántos filtros adicionales activaba cada consulta. La pregunta más simple (sin empresa, sin entrevista en inglés) tardó menos de dos minutos; las que agregaban filtro de idioma o de velocidad de respuesta casi se triplicaron.
| Pregunta | Hechos extraídos | Verificados con cita | Tiempo |
|---|---|---|---|
| Sin empresa, sin entrevista en inglés, sin presencia en el exterior | 47 | 39 | 99,8 s |
| VCs coreanos, en coreano, con cómo y cuándo aplicar | 66 | 52 | 222 s |
| Aplicación ahora mismo (rolling) con respuesta rápida | 68 | 53 | 232 s |
La proporción de hechos verificados contra extraídos se mantuvo entre el 78% y el 83% en las tres corridas, según los números que Park publicó. Ojo con esto: son números autorreportados por el propio creador en un solo set de corridas, no un benchmark con metodología publicada ni repetido por terceros.
¿Cuáles son los límites de este enfoque?
Funding Fit resuelve un problema hecho a medida de una sola persona: un fundador solo, sin empresa constituida, que vive en Corea y no hace entrevistas en inglés. Eso es una fortaleza para ese caso puntual y una limitación real para cualquiera que quiera reusarlo tal cual, porque los filtros de pregunta y el perfil que arma el agente están atados a ese contexto específico. Más contexto en los fundamentos de la IA local en 2026.
El modelo elegido también pesa. Gemma3:4b es chico (4,3B parámetros) y corre bien en hardware modesto, pero en el propio registro de la corrida quedan casos donde el modelo propuso un valor (por ejemplo, entrevista en inglés para TheVentures) que el grounding check descartó por falta de evidencia suficiente en la línea citada, aunque el texto fuente tocaba el tema de forma tangencial. ¿Significa que el dato es falso? No necesariamente, significa que el código no encontró la prueba textual exacta que exige, y prefiere decir “no sé” antes que afirmar algo sin respaldo. Es un diseño conservador, pero también deja fuera matices reales.
Tampoco hay auditoría externa de ninguno de estos números. Las 14 fuentes se leyeron una sola vez para construir la knowledge base, así que si alguna aceleradora cambia su política de aplicación después del 3 de octubre de 2026, el agente va a seguir citando la versión vieja hasta que alguien reconstruya el índice.
Qué está confirmado y qué no
- Confirmado: el stack técnico (Sanity Context + gemma3:4b vía Ollama), el project ID real (r0ts6lj0), la lista de 14 fuentes oficiales y los tres sets de números de la corrida del 3 de octubre de 2026.
- Confirmado: el mecanismo de grounding en código y el hecho de que el veredicto final no lo decide el modelo de lenguaje.
- No confirmado: si estos resultados se replican con otro modelo local, otro idioma de origen o un perfil de fundador distinto.
- No confirmado: si las políticas de los 9 programas analizados siguen siendo las mismas después de esta fecha.
Errores comunes al armar un agente de elegibilidad así
- Confundir lo que dice el modelo con lo que está verificado. Si no separás “extraído” de “verificado con cita” como hace el código de Funding Fit, terminás confiando en campos marcados como “evidencia insuficiente” sin darte cuenta.
- No actualizar la knowledge base. Un crawl o un Markdown que se armó una vez queda congelado en esa fecha; Y Combinator, por ejemplo, cambia su FAQ de aplicación con cada ciclo de batch.
- Dejar que el purpose field sea demasiado amplio. Si no excluís explícitamente marketing copy y noticias de portfolio como hizo Park, el agente mezcla reglas de elegibilidad con contenido promocional y el grounding se vuelve más ruidoso.
- Usar un modelo chico para preguntas ambiguas sin revisar el log de grounding. Gemma3:4b funciona bien acá porque el código hace de filtro duro, pero sin ese filtro un modelo de este tamaño comete errores de lectura en textos largos.
Preguntas Frecuentes
¿Cómo funciona el agente Funding Fit creado con Sanity Context?
Funding Fit usa una knowledge base de Sanity Context con 14 fuentes oficiales organizadas en 9 entries temáticas, y encadena tres herramientas (initial_context, knowledge_base_search y knowledge_base_read) para traer el texto crudo de cada programa. El modelo local extrae 10 campos por programa con cita textual, y un chequeo de grounding en código decide qué dato queda verificado antes de calcular el veredicto final.
¿Qué aceleradoras no exigen entrevista en inglés ni empresa constituida?
En la corrida del 3 de octubre de 2026, Hustle Fund, TheVentures, FuturePlay y Mashup Ventures quedaron sin ninguna condición bloqueante en las fuentes analizadas para ese perfil. Eso no confirma que no tengan entrevista en inglés o fee, solo que el agente no encontró evidencia textual de esa exigencia en los documentos oficiales revisados. Complementá con reducir los costos de API.
¿Qué modelo de IA local usa Funding Fit y por qué corre en la PC?
Funding Fit usa gemma3:4b vía Ollama, un modelo de 4,3 mil millones de parámetros cuantizado a 3,3 GB que corre en una sola GPU según su propia ficha en Ollama. Corre local porque es gratis, funciona offline y nada sobre el fundador sale de la PC, salvo la consulta de búsqueda que se manda a Sanity.
¿Puedo aplicar a Y Combinator sin hablar inglés o sin estar en San Francisco?
No, según los datos que citó el propio agente en esta corrida: las fuentes oficiales de YC confirman entrevistas por videoconferencia en inglés entre noviembre y diciembre, y un batch presencial que arranca con tres días de kickoff en San Francisco. Por eso Y Combinator quedó en la categoría “excluido” para este perfil puntual.
¿Cómo evita este agente las alucinaciones al leer páginas oficiales de programas?
El agente aplica un chequeo de grounding en código: un valor solo cuenta como verificado si la cita existe literalmente en el texto recuperado y la línea donde aparece tiene relación directa con ese campo. Si el modelo propone un dato sin ese respaldo textual exacto, el código lo descarta en vez de dejarlo pasar como confirmado.
Conclusión
Lo que cambia con Funding Fit no es la tecnología (gemma3:4b es un modelo chico y conocido, Sanity Context es un producto que ya existía), sino la combinación: un fundador sin conocimientos técnicos armó, con ayuda de un copiloto de IA, un sistema que separa claramente “lo que el modelo propone” de “lo que quedó verificado con cita textual”, y deja que el código, no el lenguaje natural, decida el veredicto final.
Para alguien que esté evaluando construir algo parecido, el punto de partida útil es el grounding check en código, no el modelo. Si vos armás un agente de este tipo, lo primero que tenés que decidir es qué condición exacta hace que un dato cuente como verificado, antes de elegir qué modelo usar. El resto (qué tan chico es el modelo, cuánto tarda cada consulta) importa menos que esa regla de verificación.