En pocas palabras: Sí: un request enviado entre 46 y 3 ms antes de que llama-server entre en modo sleep puede quedar colgado sin respuesta (32 de 32 casos) o crashear el proceso con SIGSEGV (41 de 41 casos), según un testeo del 3 de octubre de 2026 sobre llama.cpp b11368.
Un bug en el modo sleep de llama-server, el servidor de inferencia de llama.cpp, hace que un request enviado entre 46 y 3 milisegundos antes de que el servidor se duerma se pierda en la cola sin respuesta, o crashee el proceso con SIGSEGV. Un testeo publicado el 3 de octubre de 2026 lo reprodujo 32 de 32 veces para el hang y 41 de 41 para el crash.
El modo sleep de llama-server es una función de llama.cpp que descarga el modelo y la KV cache de RAM después de N segundos de inactividad, activada con el flag --sleep-idle-seconds. La documentación oficial dice que cualquier tarea entrante nueva dispara la recarga automática del modelo. Esa promesa se cumple para un request que llega cuando el servidor ya está dormido, pero no para uno que llega en el instante exacto en que se está durmiendo.
En este artículo:
- En 30 segundos
- ¿Qué es el modo sleep de llama-server y qué promete –sleep-idle-seconds?
- ¿Cómo se detectó el bug: el caso reportado en GitHub #29689?
- ¿Qué pasa cuando un request llega entre 46 y 3 ms antes de que el servidor duerma?
- Ejemplo hipotético: cómo se vería este bug en un cron job
- ¿Por qué el bug es tan difícil de detectar en producción?
- ¿Cuál es la causa técnica de la race condition en el código?
- Criterios de decisión: ¿te conviene dejar el sleep mode activado?
- ¿Qué mitigaciones existen mientras no hay fix oficial?
- ¿Qué dice el issue oficial de llama.cpp y hay un fix en camino?
- Errores comunes al configurar sleep mode en llama-server
- Qué está confirmado y qué no sobre este bug
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un request enviado 46 a 34 ms antes de que el servidor duerma queda colgado en la cola sin respuesta, 32 de 32 veces en el testeo.
- Enviado 34 a 3 ms antes, el servidor crashea con SIGSEGV dentro del tokenizer, 41 de 41 veces.
- El bug está documentado en el issue ggml-org/llama.cpp#29689, abierto el 30 de septiembre de 2026, sin fix en ningún release todavía.
- Mandar un completion de 1 token como “warm-up” antes del request real evitó el problema en 123 de 123 intentos.
- Con un prompt de dos palabras casi no hay ventana para pisar el bug: 0 de 93 intentos.
¿Qué es el modo sleep de llama-server y qué promete –sleep-idle-seconds?
--sleep-idle-seconds N le dice a llama-server que descargue el modelo y la KV cache después de N segundos sin tráfico, para liberar RAM en servidores que no reciben pedidos todo el tiempo. La documentación dice textualmente que “cualquier tarea entrante nueva” va a disparar la recarga automática del modelo, sin que el cliente tenga que hacer nada especial.
Eso funciona bien para un request que llega cuando el servidor ya está dormido. El problema es otro: qué pasa con el request que llega mientras el servidor se está durmiendo, en esa fracción de segundo donde todavía no es ni una cosa ni la otra.
¿Cómo se detectó el bug: el caso reportado en GitHub #29689?
El reporte original en el issue #29689 describía algo intermitente: un cliente que manda /health, /props, /tokenize y después POST /completion justo al arrancar el servidor, con --sleep-idle-seconds 1, no recibía respuesta a la petición de completion aproximadamente 1 de cada 8 veces.
El log del servidor no mostraba ningún error. La última línea decía entering sleeping state, que es exactamente lo que diría un servidor sano al quedarse sin tráfico. Diez segundos después, el cliente tiraba la toalla y cancelaba la tarea por timeout.
¿Alguien había visto algo parecido antes? No había reportes previos de esto como crash, porque el proceso que podría loguearlo es el mismo que se muere.
¿Qué pasa cuando un request llega entre 46 y 3 ms antes de que el servidor duerma?
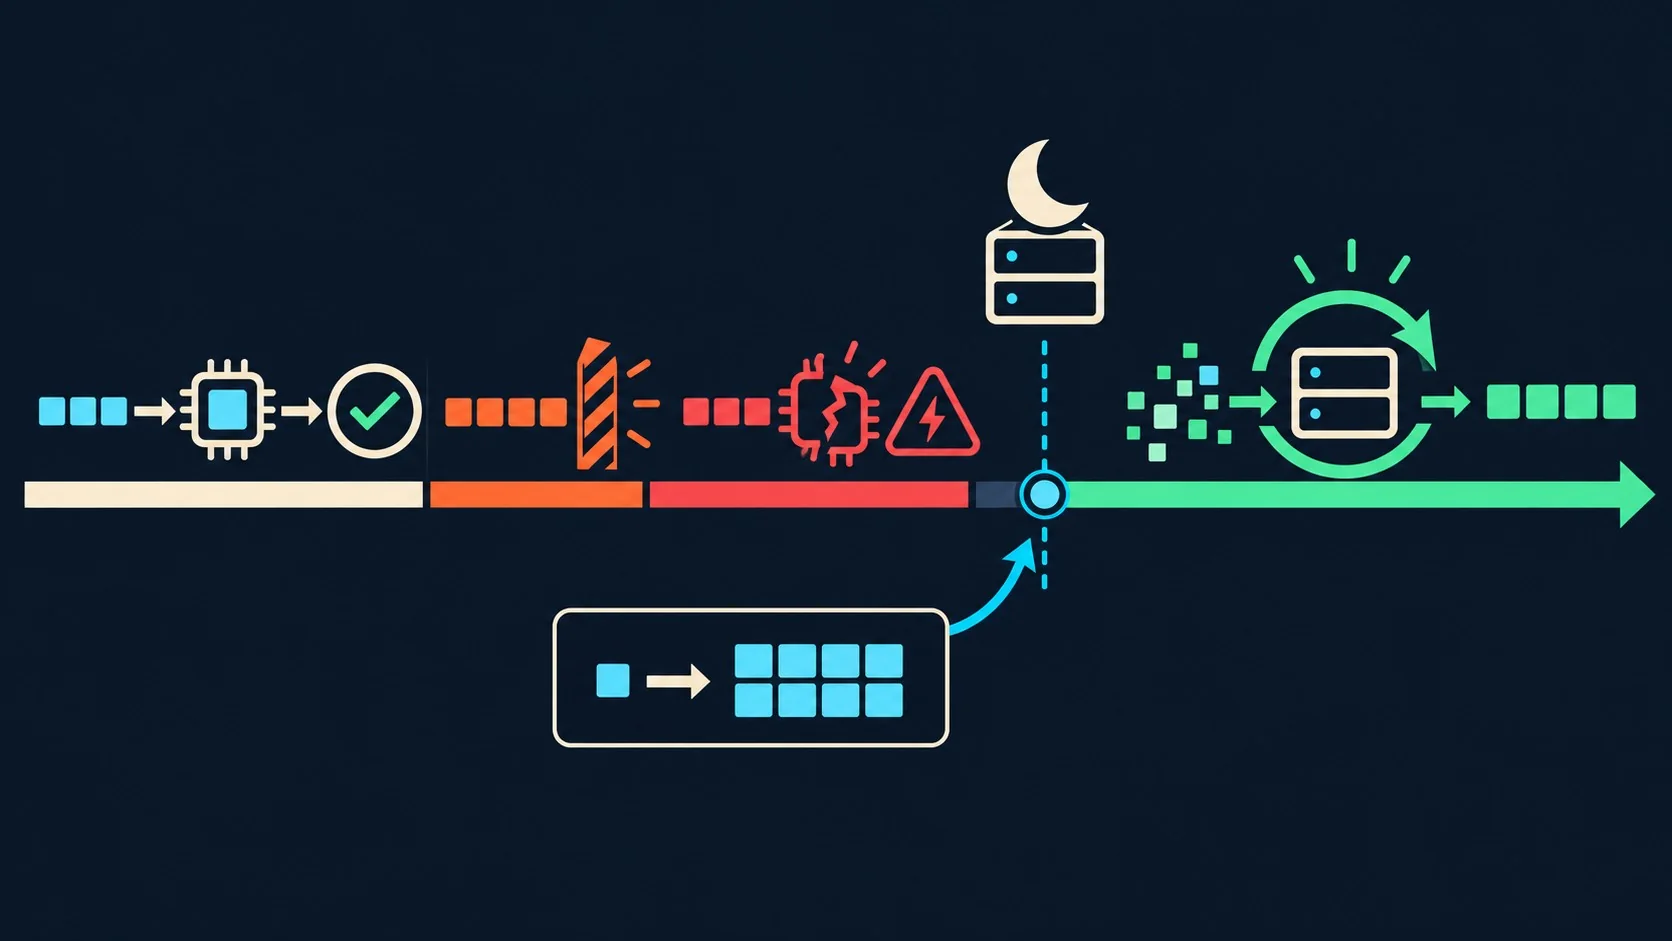
Según el testeo publicado el 3 de octubre de 2026, en una Debian 13 LXC de 6 núcleos corriendo llama.cpp b11368 con Gemma 3 1B Q4_K_M, un prompt de 17.653 tokens enviado entre 46 y 34 ms antes de que el servidor se durmiera se quedaba en la cola sin ninguna respuesta, 32 veces de 32. El mismo prompt enviado entre 34 y 3 ms antes crasheaba el servidor con SIGSEGV, 41 de 41 veces.
Corrido bajo gdb, el hilo que fallaba era un worker HTTP a mitad de tokenizar el prompt, dentro de llama_vocab::text_to_token, llamado desde llm_tokenizer_spm_session::try_add_bigram y common_tokenize. El proceso estaba leyendo un vocabulario que el sleep ya había liberado de memoria.
Con un prompt de dos palabras (“Say OK”), la ventana era tan corta que ninguno de los 93 intentos la pisó. Con una imagen cargada vía --mmproj más decodificación especulativa, el reporte original lo vio 1 de cada 8 veces, porque el preprocesado de imagen ocupa el mismo lugar que la tokenización del prompt.
| Ventana relativa al sleep | Resultado | Frecuencia medida |
|---|---|---|
| Más de 50 ms antes | Respondido normal (HTTP 400 por contexto) | 13 de 13 |
| 46 a 34 ms antes | Hang, sin respuesta, /props dice is_sleeping: true | 32 de 32 |
| 34 a 3 ms antes | Crash SIGSEGV en el tokenizer | 41 de 41 |
| 2 ms antes a 29 ms después | Despierta y responde (~1.3 s de latencia) | 37 de 37 |
Ejemplo hipotético: cómo se vería este bug en un cron job
Nota: el siguiente escenario es hipotético y sirve solo para ilustrar el mecanismo descrito en las fuentes. No es un caso reportado ni un dato medido.
Imaginemos un servidor llama-server configurado con --sleep-idle-seconds 60 para atender un único proceso automatizado: un cron job que cada 15 minutos manda un prompt largo (por ejemplo, un resumen de logs del día) y espera la respuesta para seguir con el siguiente paso de un pipeline. Durante 14 de esos 15 minutos el servidor está dormido, así que la mayoría de las veces el request llega con el servidor ya dormido y lo despierta sin drama, con el costo de latencia de recarga que describen las fuentes.
Pero si, por la razón que sea (una pequeña variación en el scheduler, una demora de red, un reintento previo que corrió un poco tarde), ese mismo request cae justo en la ventana de 46 a 3 ms antes de que se cumpla el minuto de inactividad, según el mecanismo descrito arriba el resultado sería uno de dos: el pipeline se queda esperando una respuesta que nunca llega (si tokenizar el prompt tarda lo suficiente como para caer en el tramo del hang), o el proceso del servidor muere y el cron job recibe una conexión cerrada. En ambos casos, quien monitorea el pipeline vería un timeout o un error de conexión sin ninguna pista en los logs de por qué pasó, porque -según lo medido en el testeo- ni el hang ni el crash dejan rastro distinguible de una falla puntual de red.
Este ejemplo no prueba que el bug vaya a ocurrir con esa frecuencia en un cron real: la probabilidad depende del tamaño del prompt y de cuánto tarda la tokenización en esa máquina en particular, dos variables que no están cuantificadas para un caso genérico. Sirve para mostrar por qué el patrón “un solo cliente, un request por período de inactividad” -el mismo que describen las fuentes para cron jobs, automatizaciones de hogar y turnos de agentes- es justamente el que no tiene una segunda oportunidad de despertar al servidor si el primer request se pierde.
¿Por qué el bug es tan difícil de detectar en producción?
Porque no deja ningún rastro distinto al de un servidor funcionando bien. El hang ocurre en unas pocas decenas de milisegundos de cada período de inactividad, así que la mayoría de los requests nunca lo pisan, y cuando uno lo pisa parece un timeout cualquiera.
El log termina en “entering sleeping state”, que es lo que debería decir un servidor sano al quedarse sin tráfico. /props reporta is_sleeping: true de forma correcta. Nada grita que hay un request perdido en la cola.
El crash es todavía más silencioso: el proceso muere antes de poder escribir nada en su propio log. Si hay un supervisor (systemd, por ejemplo) que reinicia el proceso, la caída pasa por un bache cualquiera, sin que nadie lo note.
¿Cuál es la causa técnica de la race condition en el código?
La causa es que el chequeo de “¿estoy despierto?” ocurre antes de tokenizar, pero el envío a la cola ocurre después, y nada impide que el servidor se duerma en el medio. Cada handler de completion construye su objeto de respuesta en tools/server/server-context.cpp, y ese constructor es el único chequeo de despertar: si el servidor está despierto, sigue de largo sin esperar nada.
Mientras tanto, el loop principal de la cola, en tools/server/server-queue.cpp, al encontrar la cola vacía y el timer vencido, loguea “entering sleeping state”, pone sleeping = true, descarga el modelo (vocabulario incluido) y se queda esperando a que llegue un nuevo request con el lock de la cola tomado.
Ahí se abren dos caminos, según dónde cae el sleep. Si cae durante la tokenización, el handler sigue leyendo un vocabulario que ya no existe, y eso es el SIGSEGV en text_to_token. Si cae después de tokenizar pero antes de encolar la tarea, el request queda en la cola, pero el loop solo despierta cuando otro request activa la bandera de despertar, así que ese primer request espera indefinidamente hasta que llegue un segundo.
La ventana es el tiempo entre el chequeo y el encolado, que es básicamente el tiempo de tokenización. En la CPU usada para el testeo, tokenizar 17.653 tokens tardó unos 45 ms, y el tramo peligroso midió entre 46 y 3 ms antes del sleep. Esa ventana crece con el largo del prompt y con el preprocesado de imágenes cuando hay un --mmproj cargado.
Criterios de decisión: ¿te conviene dejar el sleep mode activado?
A partir de los datos del testeo y del issue, se pueden armar algunos criterios concretos para decidir si vale la pena correr el riesgo de esta race condition o directamente apagar el sleep:
- ¿Cuántos clientes distintos le pegan al servidor? Si son varios clientes concurrentes, es mucho más probable que algún otro request llegue mientras el servidor está dormido y lo despierte por el camino normal, lo que reduce (sin eliminar) la chance de que un request quede solo en la ventana peligrosa. Con un solo cliente que manda un request aislado tras cada período de inactividad -el escenario del ejemplo del cron job- no hay ningún otro request que pueda rescatar al primero.
- ¿Qué tan largos son los prompts o hay imágenes de por medio? Según el testeo, con un prompt de dos palabras la ventana fue de 0 en 93 intentos; con 17.653 tokens, la ventana midió entre 46 y 3 ms y se pisó en el 100% de los envíos ubicados ahí. El riesgo real depende del tiempo de tokenización en tu propio hardware y con tus propios prompts, no de un número fijo.
- ¿Qué tan crítico es no perder ese request? Si una respuesta perdida o un crash puntual se puede tolerar (porque hay reintento automático o el proceso no es crítico), el riesgo medido puede ser aceptable. Si el request dispara una acción que no se puede repetir sola, el costo de perderlo sin aviso pesa más que el ahorro de RAM del sleep.
- ¿Podés agregar un warm-up antes de cada request real? Si tu cliente puede mandar un completion de un par de tokens inmediatamente antes del request real, la mitigación medida (123 de 123 sin fallas) cubre el caso más común sin tener que renunciar al ahorro de memoria del sleep.
¿Qué mitigaciones existen mientras no hay fix oficial?
Hoy no hay ningún release de llama.cpp con un fix para esta race específica, pero hay opciones medidas o de pura configuración que reducen el riesgo.
- Mandá un completion de 1 token antes del request real. Un prompt de dos o tres tokens casi no tiene ventana para pisar el bug (0 de 93 en el testeo) y, al encolarse, resetea el timer de inactividad, así que el request real que viene detrás tiene todo el período de idle de margen. En la práctica son dos curls seguidos: uno con
"prompt":"hi","n_predict":1y el real justo después. - No confíes en /health ni /props como warm-up. El propio README aclara que esos endpoints no resetean el idle timer, así que no sirven para “despertar” al servidor antes de mandar el request de verdad.
- Dale timeout y retry al cliente. No evita el hang, pero lo convierte en una respuesta lenta en vez de una perdida. El retry también despierta al servidor y libera el request que quedó atascado.
- Configurá Restart=on-failure en systemd. Si el servidor crashea, al menos se reinicia solo. El request que disparó el crash se pierde igual, pero el servicio sigue funcionando.
- Dejá el sleep mode apagado (el default, -1). Si tu servidor recibe prompts largos o imágenes de un solo cliente, apagar el sleep directamente evita toda la ventana de riesgo.
Si corrés tu propio servidor de inferencia en un VPS, sea en donweb.com o en cualquier otro proveedor de infraestructura, esta race condition te afecta igual: el bug vive en el código de llama.cpp, no en el hosting.
¿Qué dice el issue oficial de llama.cpp y hay un fix en camino?
El issue #29689, abierto el 30 de septiembre de 2026, sigue abierto a la fecha de esta nota, sin ningún release que incluya una solución. El issue propone dos caminos.
El primero es despertar al servidor también cuando la cola no está vacía, no solo cuando llega un request nuevo. Esa solución cubriría el hang, pero no el crash, porque el crash pasa antes de que haya algo encolado. El segundo camino es contar los requests que están “en tránsito” entre el chequeo de despertar y el encolado, y no dormir mientras ese contador sea mayor a cero. Esa opción cubriría los dos problemas, pero todavía no está implementada.
Ojo con no confundir este bug con uno relacionado que sí tiene fix: el issue #29188, sobre un SIGSEGV en las rutas de conteo de tokens cuando el request llega con el servidor dormido, se cerró con el PR #29309, mergeado el 23 de septiembre de 2026 por ngxson. Ese fix arregla el crash en los endpoints de conteo de tokens, no la race de completion que describe el issue #29689.
Errores comunes al configurar sleep mode en llama-server
- Usar /health o /props como warm-up. Ninguno de los dos resetea el idle timer, así que no evitan nada.
- Poner –sleep-idle-seconds muy bajo con prompts largos. Cuanto más corto el idle, más seguido se repite la ventana peligrosa en cada ciclo de actividad.
- No tener Restart=on-failure en systemd. Un crash sin reinicio automático deja el servicio caído hasta que alguien lo note a mano.
- Asumir que un solo request por período de inactividad es seguro. Es justo el patrón de cron jobs, automatizaciones de hogar y turnos de agentes, el escenario donde el request queda perdido sin segunda oportunidad de despertar al servidor.
Qué está confirmado y qué no sobre este bug
Confirmado: el hang y el crash se reprodujeron de forma sistemática en llama.cpp b11368 con Gemma 3 1B, la causa está identificada en el código (wait_until_no_sleep() en server-context.cpp corre antes de tokenizar, y el sleep en server-queue.cpp puede caer en el medio con el lock de la cola tomado), y el warm-up de 1 token funcionó 123 de 123 veces en el testeo.
Pendiente: no hay release de llama.cpp con un fix para la race de #29689. Las dos soluciones propuestas en el issue (despertar si la cola no está vacía, o contar requests en tránsito) todavía no están implementadas. Tampoco está confirmado si el bug afecta por igual a otras arquitecturas de modelo más allá de Gemma 3, aunque el mecanismo del código no depende del modelo.
Preguntas Frecuentes
¿Qué es el modo sleep de llama-server?
Es una función de llama.cpp activada con --sleep-idle-seconds N que descarga el modelo y la KV cache de RAM después de N segundos sin tráfico. La documentación oficial promete que cualquier tarea nueva dispara la recarga automática, aunque esa promesa no se cumple para requests que llegan en el instante exacto en que el servidor se está durmiendo.
¿Por qué llama-server se cuelga o crashea con sleep-idle-seconds?
Porque el chequeo de “servidor despierto” ocurre antes de tokenizar el prompt, y el encolado de la tarea ocurre después, dejando una ventana donde el servidor se puede dormir en el medio. Si el sleep cae durante la tokenización, crashea con SIGSEGV; si cae justo después, el request queda colgado en la cola sin respuesta.
¿Cómo se soluciona el bug de sleep mode en llama.cpp?
Por ahora no hay un fix oficial para esta race específica, documentada en el issue #29689. La mitigación medida que funcionó en 123 de 123 intentos es mandar un completion de 1 token como warm-up justo antes del request real, lo que resetea el idle timer y le da margen de sobra al request de verdad.
¿Qué versión de llama.cpp tiene este bug?
El testeo que reprodujo el hang y el crash de forma sistemática usó la release b11368 de llama.cpp, con el modelo Gemma 3 1B Q4_K_M. El bug está en la lógica del loop de la cola y del chequeo de despertar, código que sigue presente en versiones posteriores mientras no se mergee ninguna de las dos soluciones propuestas en el issue.
¿Cómo evitar perder requests cuando el servidor está entrando en sleep?
Mandá un request chico (un completion de un par de tokens) inmediatamente antes del request real para resetear el idle timer. Como alternativa o complemento, configurá timeout más retry del lado del cliente y Restart=on-failure en systemd, o directamente dejá el sleep mode apagado si tu servidor recibe prompts largos o imágenes de un solo cliente.
Conclusión
El modo sleep de llama-server sigue siendo útil para ahorrar RAM en servidores con tráfico intermitente, pero la ventana entre el chequeo de despertar y el encolado de la tarea es real, medible y hoy no tiene fix. Si tu setup manda un request por vez después de períodos de inactividad (cron, automatizaciones, agentes), el riesgo de perder esa petición o de crashear el proceso no es teórico.
Lo accionable es simple: mientras no salga un release con alguna de las dos soluciones del issue #29689, mandá un request chico de warm-up antes de cada petición real, o apagá el sleep en los servidores donde no te podés dar el lujo de perder un request. Y si usás systemd, revisá que Restart=on-failure esté puesto, porque un crash sin reinicio automático se puede confundir fácil con un servicio caído por otra causa.