
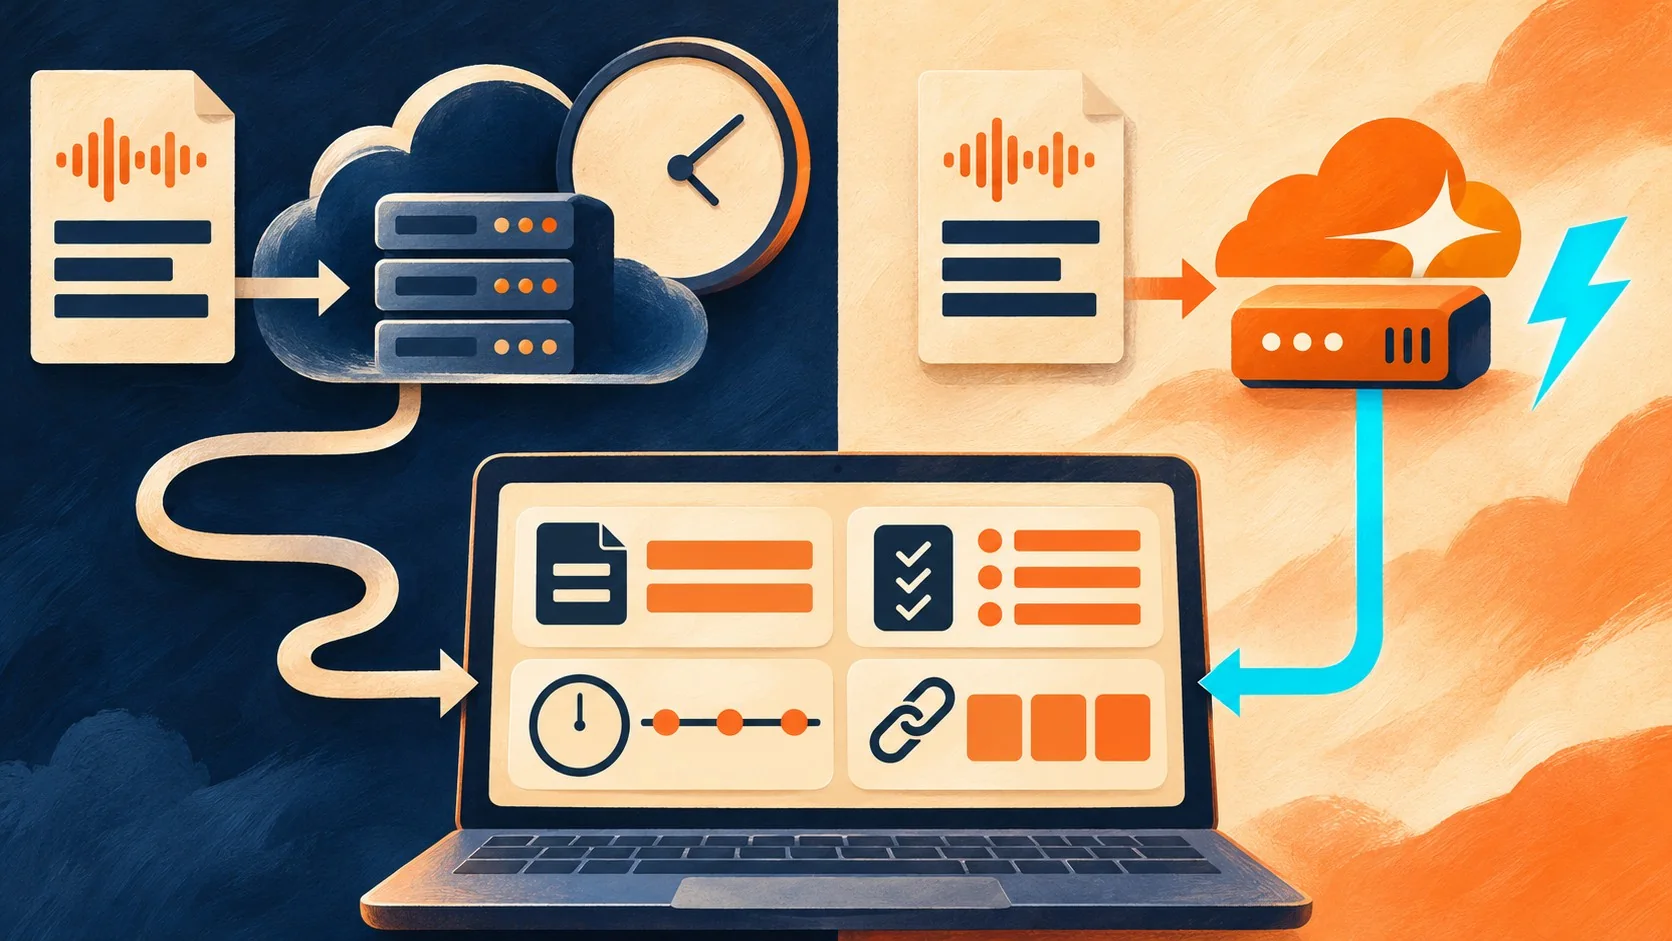
En pocas palabras: Un desarrollador migró su pipeline de show notes de podcasts desde APIs centralizadas hacia Cloudflare Workers AI, usando el modelo Llama 3 8B Instruct para generar resúmenes, timestamps y recursos mencionados sin limpieza manual, con latencia percibida casi instantánea gracias a la inferencia en el edge.
El cambio de fondo fue de arquitectura, no de modelo: dejó de depender de un servidor central único y pasó a correr la inferencia en el edge. Lo cuenta en su publicación en Dev.to, donde describe cómo quedaron las show notes estructuradas sin necesitar retoques manuales después.
La IA en el edge es un modelo de procesamiento donde la inferencia corre en servidores distribuidos geográficamente cerca del usuario, en vez de en un data center central único. Cloudflare Workers AI es la plataforma que permite ejecutar modelos como Llama 3 8B Instruct sobre esa infraestructura distribuida, reduciendo la latencia de las respuestas.
En este artículo:
- En 30 segundos
- ¿Cuál es el verdadero cuello de botella en la posproducción de podcasts?
- IA en el edge vs IA centralizada en la nube: ¿qué arquitectura rinde mejor?
- ¿Cuándo conviene migrar a un esquema de edge AI y cuándo no vale la pena?
- ¿Cómo funciona un pipeline de Cloudflare Workers con Llama 3 para generar show notes?
- ¿Por qué la ingeniería de prompts estructurada reduce el clickbait y las alucinaciones?
- ¿Qué resultados prácticos dio migrar a un pipeline de IA en el edge?
- ¿Cuáles son las limitaciones y los próximos pasos de este enfoque?
- Errores comunes al armar un pipeline de IA para podcasts
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El autor cuenta que dedicaba el 80% de su tiempo a tareas administrativas de posproducción y solo el 20% a contenido real.
- Pasó de APIs centralizadas a Cloudflare Workers AI con el modelo @cf/meta/llama-3-8b-instruct para generar show notes.
- El system prompt impone una estructura fija en markdown: resumen, puntos clave, timestamps y recursos mencionados.
- El modelo de 8B parámetros estimó timestamps coherentes sin tener datos reales de audio, solo a partir del flujo temático del texto.
- Como próximo paso, plantea fine-tunear modelos chicos por nicho (true-crime vs. B2B SaaS) para mejorar la calidad inicial.
¿Cuál es el verdadero cuello de botella en la posproducción de podcasts?
El cuello de botella real no es el tiempo que insume escribir, es el cambio de mindset. Durante la grabación estás en un estado creativo y conversacional; al sentarte a publicar necesitás pasar a uno analítico, obsesionado con el SEO. Ese salto cuesta más energía que la tarea en sí misma.
Ejemplo hipotético para entender el problema (no es el caso descrito en la fuente, sirve para ilustrar el escenario): imaginá que grabaste una entrevista de dos horas con un invitado. Después tenés que armar un título que no suene a clickbait, estructurar las show notes, escribir una descripción que rankee en buscadores y decidir qué recursos mencionar de todo lo que se habló. Son al menos cuatro tareas analíticas distintas apenas termina la parte creativa del trabajo.
El autor del posteo original dice haber llegado a ese punto: terminaba invirtiendo el 80% de su tiempo en esa admin y apenas el 20% en producir contenido. Probó herramientas genéricas de IA para escritura y no le funcionaron, porque tratan la transcripción como un bloque de texto cualquiera, sin reconocer estructuras propias de un podcast como timestamps o menciones de invitados. Además eran lentas.
El costo de ignorar este cuello de botella es conocido: calendarios de publicación inconsistentes, mala capacidad de descubrimiento en buscadores y, en el peor caso, abandonar el podcast directamente. Si te interesa entender mejor la familia de modelos detrás de este pipeline, tenemos una nota aparte sobre Llama y los modelos de Meta.
IA en el edge vs IA centralizada en la nube: ¿qué arquitectura rinde mejor?
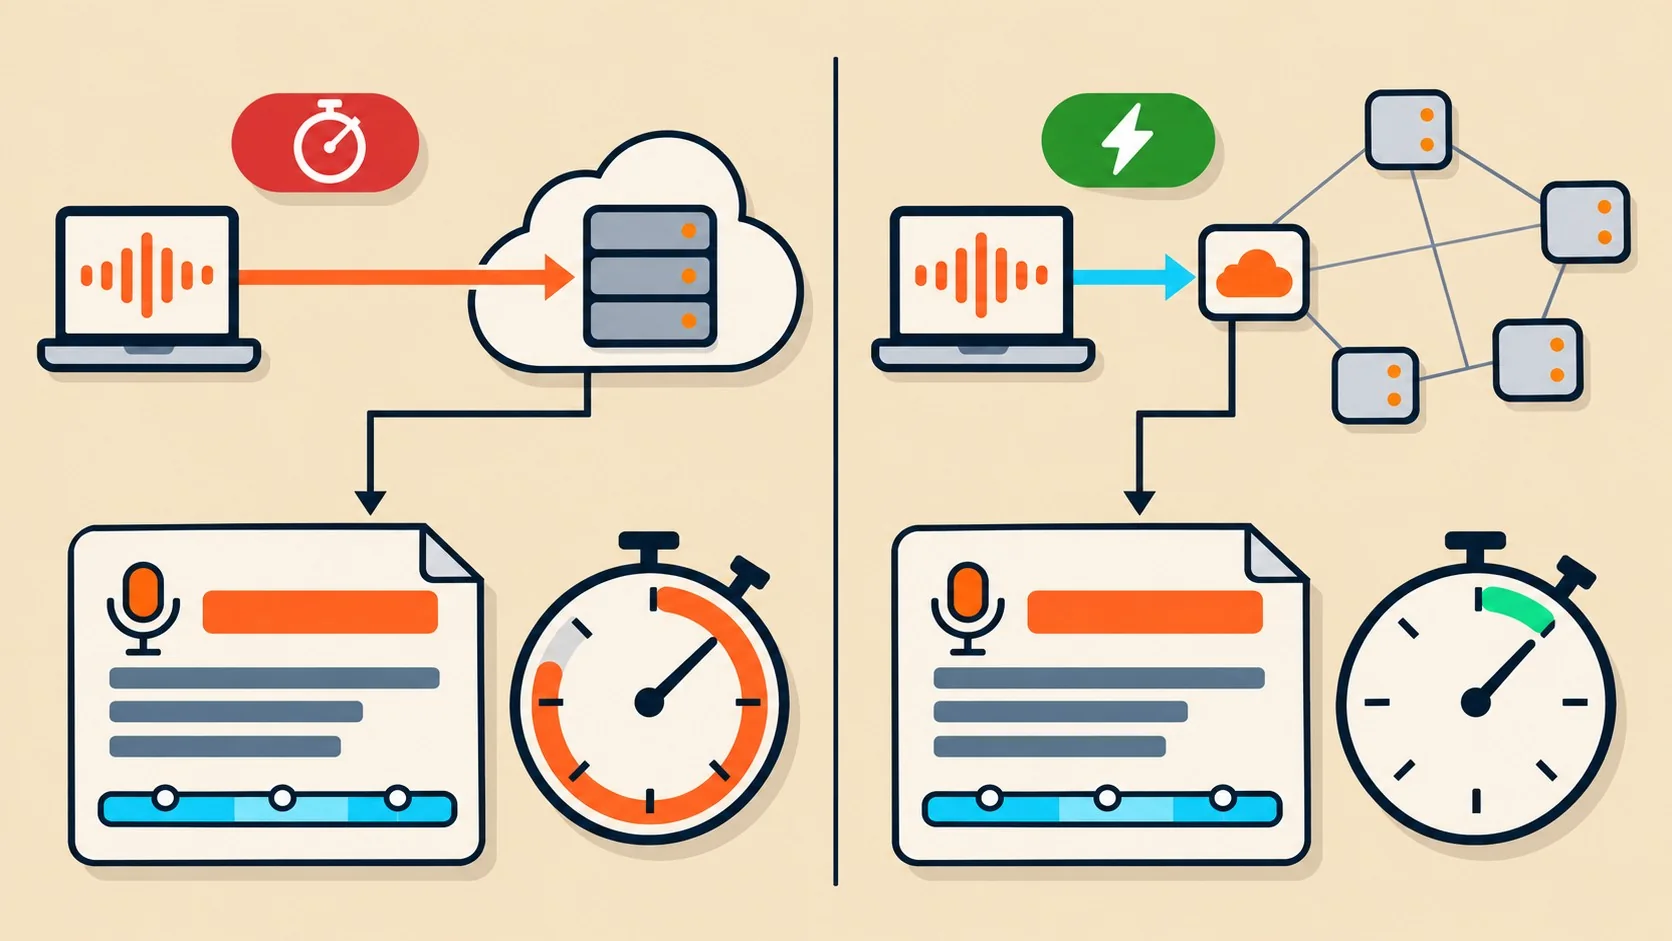
La IA en el edge gana en velocidad percibida porque procesa más cerca geográficamente del usuario. La IA centralizada en la nube es más simple de implementar, pero cada request viaja hasta un servidor central único, y ahí es donde aparece la latencia. Fue justamente esa diferencia de latencia, notoria con transcripciones largas bajo el esquema centralizado, la que llevó al autor a migrar su pipeline hacia el edge.
La mayoría de las herramientas indie para creadores de contenido usan APIs centralizadas: mandás el request, un servidor lo procesa, te devuelve la respuesta. Es fácil de montar, pero con transcripciones largas la latencia se nota, y quedás atado al uptime de la región central de un único proveedor.
Cloudflare Workers permite correr la inferencia en el edge en vez de depender de ese servidor único. La contrapartida: hay que manejar con más cuidado las context windows y las limitaciones del modelo elegido. El autor sostiene que, en su caso, la ganancia en performance compensó ese esfuerzo extra.
| Aspecto | IA centralizada en la nube | IA en el edge (Cloudflare Workers) |
|---|---|---|
| Latencia | Notable en transcripciones largas | Procesamiento geográficamente cercano, velocidad percibida casi instantánea |
| Implementación | Simple de configurar | Requiere manejar context windows con más cuidado |
| Dependencia | Uptime de un servidor central único | Infraestructura distribuida |
| Contexto del dominio | Trata el transcript como texto genérico | Se estructura vía system prompt para formato podcast |
¿Cuándo conviene migrar a un esquema de edge AI y cuándo no vale la pena?
No todo flujo de trabajo justifica el salto a edge AI. Antes de replicar este pipeline, conviene chequear algunos criterios concretos, derivados de los propios trade-offs que describe el autor:
- Volumen de episodios por semana: si publicás con poca frecuencia, la diferencia de latencia entre un esquema centralizado y uno en el edge probablemente no se note tanto en tu rutina. El beneficio crece con la frecuencia de publicación.
- Longitud de las transcripciones: la fuente señala que la latencia de las APIs centralizadas se nota especialmente en transcripciones largas. Si tus episodios son cortos, el problema que este pipeline resuelve puede no ser tan grave en tu caso.
- Capacidad técnica disponible: gestionar context windows y límites del modelo con cuidado, como exige el edge AI, requiere más manejo técnico que simplemente llamar a una API centralizada. Si trabajás solo y sin tiempo para eso, el ahorro en velocidad puede no compensar la curva de aprendizaje.
- Nicho del podcast: el propio autor admite que un modelo genérico de 8B no da el mismo tono para un true-crime que para una entrevista B2B. Si tu contenido tiene un tono muy específico, vas a necesitar ajustar el system prompt bastante más de lo que describe el posteo original.
¿Cómo funciona un pipeline de Cloudflare Workers con Llama 3 para generar show notes?
El pipeline recibe una transcripción vía POST, la pasa al modelo @cf/meta/llama-3-8b-instruct dentro de un Worker, y devuelve un JSON con show notes estructuradas en markdown. Según el catálogo de Workers AI consultado en noviembre 2026, Llama 3 8B Instruct figura entre los modelos alojados oficialmente por Cloudflare.
La clave no está en el modelo en sí, está en el system prompt. En vez de tirarle la transcripción cruda a un prompt genérico tipo “resumí esto”, el autor define una estructura fija que el modelo tiene que respetar:
- Episode Summary: un resumen de 2 a 3 oraciones que condensa el episodio.
- Key Takeaways: entre 5 y 7 puntos clave en formato bullet.
- Timestamps: estimados a partir de la progresión de la conversación, sin datos de audio reales.
- Resources Mentioned: recursos o links que se mencionaron durante la charla.
El Worker llama a env.AI.run() con ese modelo, pasa el system prompt con la estructura markdown y un límite de 800 tokens de salida. Forzar ese formato es lo que convierte una transcripción conversacional, naturalmente desordenada, en algo publicable sin trabajo manual extra. Si querés comparar esto con correr modelos por tu cuenta, tenemos una guía sobre cómo correr LLMs locales de forma segura.
¿Por qué la ingeniería de prompts estructurada reduce el clickbait y las alucinaciones?
Pedirle al modelo “un buen título” sin más produce resultados erráticos. Imponer reglas concretas —límite de palabras, un gap de curiosidad calculado, un tono determinado— reduce los outputs clickbait o directamente alucinados, de acuerdo con la comparación que hace el autor entre un prompt naive y uno estructurado.
Lo mismo aplica al generador de títulos y al redactor de descripciones de episodios. La diferencia entre ambos enfoques no es cosmética: es la diferencia entre un título que funciona para SEO real y uno que suena a relleno automático, sin sustancia pero con mucho signo de exclamación.
¿Qué resultados prácticos dio migrar a un pipeline de IA en el edge?
Los resultados más sólidos, según relata el autor, fueron la velocidad percibida casi instantánea y show notes que no necesitaron limpieza manual posterior. También reporta que las sugerencias de keywords SEO se integraron de forma natural en el redactor de descripciones.
Lo que más lo sorprendió fue que el modelo de 8B parámetros manejara bien la estimación de timestamps incluso sin datos reales de timing de audio. El mecanismo: infiere el flujo cronológico de la conversación y ubica marcadores en los puntos donde detecta cambios de tema.
En la práctica, el flujo queda así: subís la transcripción, el Worker la procesa, el modelo devuelve la estructura completa en markdown, y te ahorrás la parte más tediosa del proceso, la que te saca del estado de flujo creativo apenas terminás de grabar. Esto conecta con lo que desarrollamos en nuestra guía completa de IA local.
¿Cuáles son las limitaciones y los próximos pasos de este enfoque?
La limitación principal es que la IA en el edge exige gestionar context windows y restricciones del modelo con más cuidado que en un esquema centralizado tradicional. La ganancia en velocidad no sale gratis.
Como próximo paso, el autor plantea explorar el fine-tuning de modelos más chicos y especializados por nicho. Un podcast de true-crime necesita un tono de título muy distinto al de una entrevista B2B SaaS, y enrutar cada caso a un modelo específico podría mejorar la calidad del output inicial sin depender tanto del ajuste manual posterior.
Algo que no está en la fuente pero conviene tener presente: estos resultados son la experiencia de un solo desarrollador con su propio pipeline, no un benchmark independiente ni un paper con metodología publicada. Antes de adoptar un enfoque similar, conviene medir con tu propio caso de uso, sobre todo si trabajás con transcripciones en español o con formatos de episodio distintos a los que describe el posteo original.
Errores comunes al armar un pipeline de IA para podcasts
- Usar prompts genéricos sin estructura: pedirle al modelo “resumí esto” sin definir formato de salida produce texto desordenado que igual vas a tener que reescribir a mano.
- Ignorar el context window del modelo elegido: en edge AI, mandar transcripciones completas sin trocearlas puede truncar la respuesta o degradar la calidad del output.
- Asumir que el mismo prompt funciona para cualquier nicho: el tono que funciona para un podcast de tecnología no sirve igual para uno de true-crime o de entrevistas corporativas.
- No validar los timestamps generados: el modelo los infiere por progresión temática, no por audio real, así que conviene revisarlos antes de publicar.
Preguntas Frecuentes
¿Qué es la IA en el edge?
Es un esquema de procesamiento donde la inferencia del modelo corre en infraestructura distribuida geográficamente, cerca del usuario, en vez de en un data center central único. Cloudflare Workers AI es un ejemplo de plataforma que permite esto.
¿Qué modelo usó el autor para generar show notes?
Usó @cf/meta/llama-3-8b-instruct, la versión de 8 mil millones de parámetros de Llama 3 de Meta, alojada en Cloudflare Workers AI. Lo invoca con env.AI.run() dentro de un Worker, pasándole un system prompt que fuerza una estructura markdown específica. Si buscás alternativas para correr algo similar de forma local, mirá esta nota sobre un agente de IA local y gratuito.
¿Cómo se diferencia la IA en el edge de la IA en la nube centralizada?
La IA en la nube centralizada enruta cada request a un servidor central único, lo que genera latencia notable en transcripciones largas. La IA en el edge procesa geográficamente más cerca del usuario, lo que reduce esa latencia, a cambio de exigir un manejo más cuidadoso de los límites de contexto del modelo.
¿Por qué el modelo pudo estimar timestamps sin datos de audio?
El modelo de 8B parámetros infiere la progresión cronológica de la conversación a partir de los cambios de tema en el texto de la transcripción, sin necesitar metadata real de timing del archivo de audio. Es el resultado que más sorprendió al autor de todo el pipeline.
¿Sirve este enfoque para podcasts en español?
La fuente no prueba el pipeline en español ni reporta datos sobre otros idiomas, así que no hay evidencia confirmada sobre ese desempeño. Antes de adoptarlo, conviene testear primero con tus propias transcripciones en lugar de asumir resultados equivalentes a los reportados en inglés.
Conclusión
Lo que cambió acá no es el modelo —Llama 3 8B ya existía—, es la arquitectura: mover la inferencia al edge con Cloudflare Workers resolvió un problema de latencia y mantuvo al creador en su estado de flujo durante la posproducción. El dato que vale la pena quedarse es el system prompt estructurado en markdown; esa técnica es reproducible en cualquier pipeline propio, con cualquier modelo, no solo con Llama 3.
Si necesitás hosting para alojar tu sitio de podcast con las show notes generadas, en donweb.com tenés opciones de hosting y dominios para Argentina y Latinoamérica.
Lo que no está probado todavía es el desempeño de este pipeline en español ni con nichos muy distintos entre sí. Antes de migrar tu propio flujo, medí primero con tus transcripciones reales.