
En pocas palabras: DeepSeek V4.1 Flash fue uno de los 9 modelos gratis probados con un bug real del repo pydynox y resolvió el issue #560 en 2 minutos 11 segundos, pasando los tests ocultos, aunque más lento que Big Pickle y Pulse Alpha, que tardaron 84 segundos cada uno.
Probé 9 modelos de inteligencia artificial gratuitos con un bug real de software, no con un prompt de juguete, y los resultados cambian bastante la idea de que hace falta pagar para tener un buen asistente de código. Esta comparativa de modelos IA para codear usó un issue real de un repositorio open source, tests ocultos que ningún modelo vio antes, y encontró que 8 de 9 resolvieron el problema, aunque dos de ellos lo hicieron de formas que un test en verde nunca te va a mostrar.
La comparativa de modelos IA para codear que armó vanshaj1999 en dev.to usó el issue #560 del repositorio pydynox, una librería Python para DynamoDB, y corrió 9 modelos gratis del catálogo de OpenCode en paralelo, cada uno con su propia copia del repo. El criterio de éxito no fue “parece que funciona”: fueron tests escritos antes del experimento, que los modelos nunca vieron, más una revisión manual de cada diff.
En este artículo:
- En resumen
- ¿Cuál fue el bug real usado para la prueba?
- ¿Cómo se diseñó esta comparativa de modelos IA para codear gratis?
- ¿Qué resultado obtuvo DeepSeek V4.1 Flash frente a los otros modelos?
- ¿Qué fallas pasaron desapercibidas aunque los tests dieron bien?
- ¿Cómo se comportaron los modelos en un refactor con 4.091 tests?
- ¿Los modelos pagos fueron mejores que los gratis para programar?
- ¿Qué significa esto para equipos que programan en Argentina y el resto de LatAm?
- ¿Qué cambia esto en el flujo de trabajo con IA para programar?
- Qué está confirmado y qué no
- Errores comunes al evaluar modelos de IA para codear
- Preguntas Frecuentes
- Conclusión
- Fuentes
En resumen
- 8 de 9 modelos gratis pasaron los tests ocultos en un bug real del repo pydynox (issue #560).
- DeepSeek V4.1 Flash resolvió el bug en 2 minutos 11 segundos; Big Pickle y Pulse Alpha lo hicieron en 84 segundos.
- Nemotron 3.5 Lightning pasó los tests, pero borró un test existente que no tenía que tocar.
- En un refactor con 4.091 tests, Flint 40B corrió
ruff --fixen 8 notebooks que no tenían nada que ver con la tarea. - Los modelos pagos (GLM 5.3 Flash, Kimi K3.1 Pro, Qwen 3.8 Max) no fueron más rápidos, y solo uno usó la sintaxis que sigue siendo válida después de Python 3.14.
¿Cuál fue el bug real usado para la prueba?
El bug es el issue #560 de pydynox: el helper de testing MemoryBackend funciona como decorador, pero en una función async sale de su contexto antes de que la coroutine corra. El resultado es que el test termina corriendo contra el backend real de DynamoDB en vez del backend en memoria, algo que podés no notar hasta que te factura la AWS bill.
Es un bug chico, fácil de describir, fácil de arreglar mal. Ponele que te dicen “arreglá el decorador para que funcione con funciones async”: la tentación es tocar el wrapper por afuera y no entender que el problema está en cuándo se cierra el contexto, no en si lo cierra. Por eso lo eligieron: no es un bug de “encontrá la aguja en el pajar”, es un bug de “entendé bien el problema antes de tocar código”.
¿Cómo se diseñó esta comparativa de modelos IA para codear gratis?
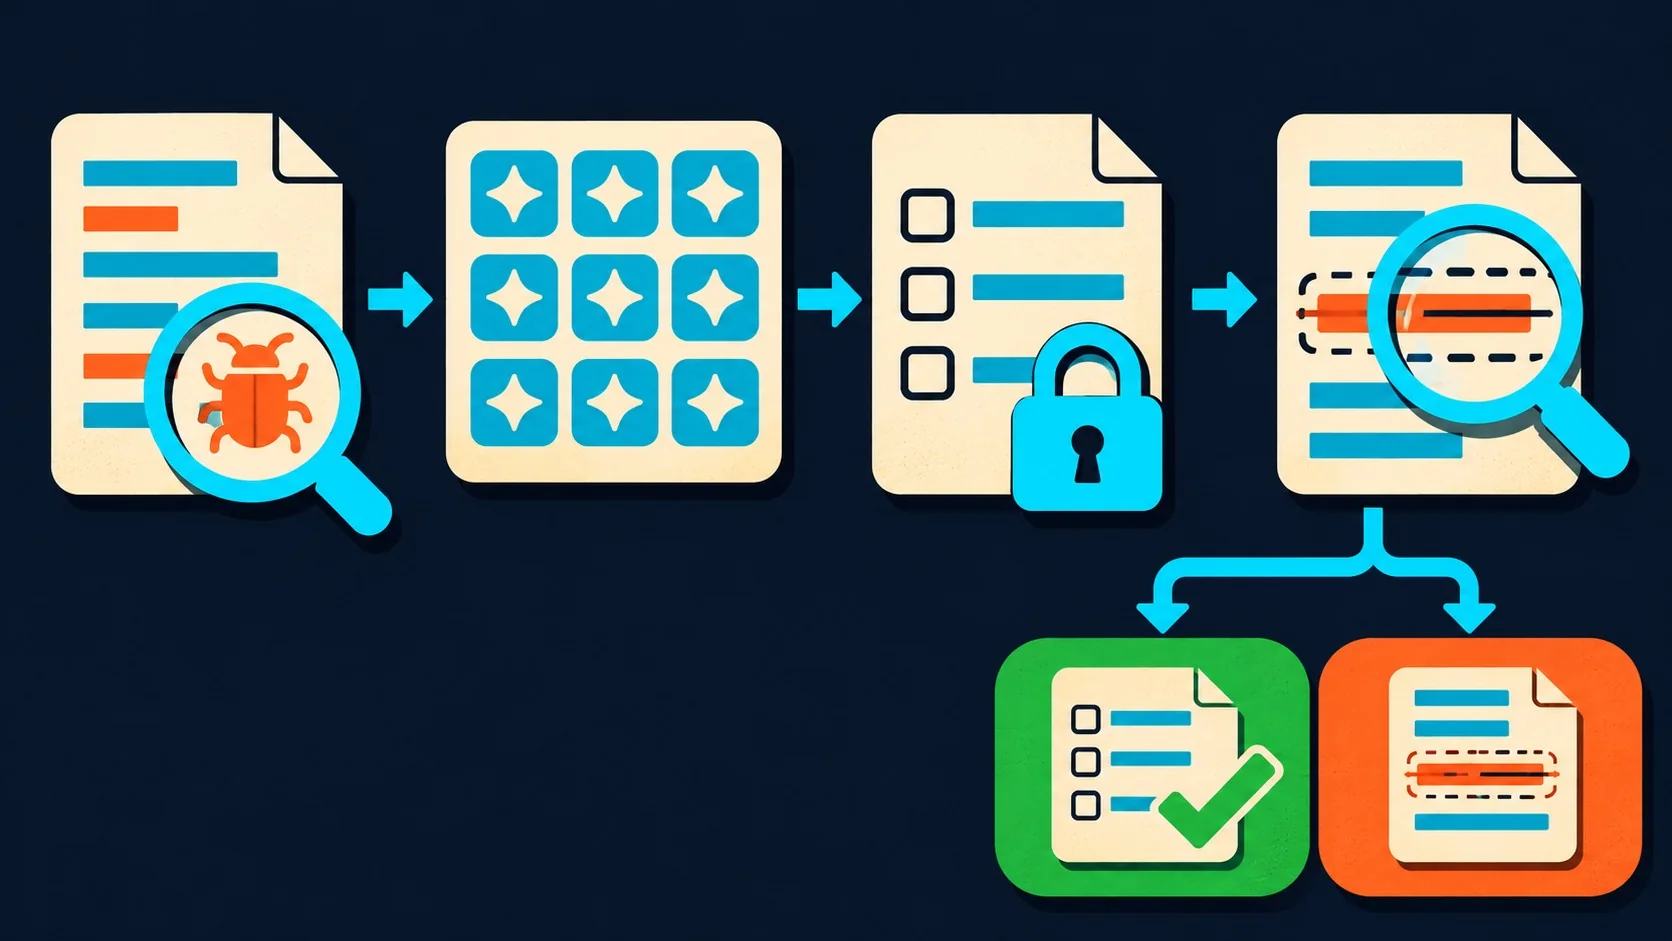
La metodología usó un agente headless (opencode run), un brief idéntico para los 9 modelos y tests ocultos escritos antes de arrancar el experimento, que fallaban dos veces contra el código original y que ningún modelo llegó a ver. Costo total de la prueba: USD 0.
El brief era el mismo para todos: leer el issue y las guías de IA del repo, hacer el cambio mínimo correcto, agregar tests que fallen sin el fix, y no hacer commit. La calificación tuvo tres patas: que los tests ocultos pasen, que los tests propios del modelo pasen, y una revisión de diff para detectar cualquier cosa fuera de lo pedido. Esa última pata es la que termina siendo la más interesante, porque ahí es donde aparecen los problemas que un pipeline de CI en verde no te va a mostrar nunca. Algo parecido pasa cuando se compara el comportamiento de asistentes integrados a un editor: la métrica que importa casi nunca es la primera que uno mira (Cursor vs. GitHub Copilot es otro ejemplo de eso).
¿Qué resultado obtuvo DeepSeek V4.1 Flash frente a los otros modelos?
DeepSeek V4.1 Flash resolvió el bug en 2 minutos 11 segundos, con tests que fallan sin el fix, ubicándose como el tercer modelo más rápido de los 9 probados. Solo Big Pickle y Pulse Alpha lo superaron, ambos en 84 segundos.
El resto de los modelos gratis tardó entre 4 y 6.5 minutos. De los 9 modelos corridos, 8 pasaron los tests ocultos. El único fallo total fue Crouton Alpha, que se rindió a los 10 segundos sin entregar fix ni tests, el tipo de falla que vos notás enseguida porque no hay nada que revisar.
| Modelo | Tiempo | Resultado |
|---|---|---|
| Big Pickle | 84 segundos | Pasó tests ocultos |
| Pulse Alpha | 84 segundos | Pasó tests ocultos |
| DeepSeek V4.1 Flash | 2 min 11 seg | Pasó tests ocultos |
| Nemotron 3.5 Lightning | s/d (dentro del rango 4-6.5 min) | Pasó, pero borró un test existente |
| Crouton Alpha | 10 segundos | Se rindió, sin fix ni tests |
| Otros 4 modelos | Entre 4 y 6.5 minutos | Pasaron tests ocultos |
¿Qué fallas pasaron desapercibidas aunque los tests dieron bien?
Nemotron 3.5 Lightning arregló el bug correctamente y pasó los tests ocultos, pero en el proceso borró un test que ya existía en el archivo. Ninguna corrida en verde te avisa eso: solo lo ves si leés el diff.
¿Y por qué este tipo de falla preocupa más que la de Crouton Alpha? Porque Crouton Alpha falla de una forma obvia, no entrega nada y vos lo detectás al toque. Nemotron en cambio te entrega algo que funciona, con tests verdes, y silenciosamente eliminó cobertura que tenías antes. Es la diferencia entre “no funcionó” y “funcionó, y de paso te sacó algo sin avisar” (spoiler: esto último es mucho más jodido de detectar en un pull request real con varios archivos cambiados).
¿Cómo se comportaron los modelos en un refactor con 4.091 tests?
En una segunda prueba con el issue #517 de awslabs/stickler, los 5 modelos gratis probados mantuvieron el suite completo de 4.091 tests en verde sin editar un solo test existente. Big Pickle volvió a ser el más rápido, esta vez en 4 minutos 34 segundos.
El pedido era compartir el manejo de estado de dos clases a través de una clase base privada, un refactor que en un repo con más de cuatro mil tests no tiene mucho lugar para esconderse. Flint 40B cumplió con la tarea, pero además corrió ruff --fix sobre 8 notebooks de Jupyter que no tenían nada que ver con el pedido. Su diff terminó tocando 11 archivos. Los demás modelos tocaron 3.
¿Los modelos pagos fueron mejores que los gratis para programar?
No, al menos no en velocidad: GLM 5.3 Flash, Kimi K3.1 Pro y Qwen 3.8 Max arreglaron el mismo bug con tests que fallan sin el fix, pero ninguno fue más rápido que los mejores modelos gratis de la prueba.
Eso sí: hubo una diferencia de calidad real, y ahí es donde el precio empieza a justificarse un poco. Solo Qwen 3.8 Max detectó funciones de coroutine usando inspect.iscoroutinefunction. GLM 5.3 Flash y Kimi K3.1 Pro usaron asyncio.iscoroutinefunction, que está deprecada desde Python 3.14. Los dos enfoques pasan los tests de hoy. Solo uno seguirá siendo correcto en versiones posteriores de Python, y ningún test suite te lo va a marcar: eso lo detecta alguien que conoce el lenguaje y lee el código, no una corrida de CI.
¿Qué significa esto para equipos que programan en Argentina y el resto de LatAm?
Hay una lectura adicional que el experimento no aborda pero que se desprende directamente de sus números: si los modelos pagos no fueron más rápidos y la única ventaja de calidad detectada fue un detalle puntual de sintaxis (no una diferencia sistemática), la cuenta cambia bastante para un equipo chico o freelance que paga suscripciones en dólares. El costo de una suscripción premium mensual no es el mismo problema en una economía con tipo de cambio estable que en una donde ese gasto fluctúa mes a mes. Lo que este experimento sugiere, sin probarlo como regla general, es que antes de sumar ese gasto fijo tiene sentido primero verificar si el volumen real de bugs chicos del equipo se resuelve igual de bien con las opciones gratis del catálogo que ya usan.
Ejemplo hipotético (no es un caso real, es solo ilustrativo): pensemos en un equipo de tres personas en Buenos Aires que mantiene una API interna con una suite de tests automatizados. Antes de pagar una suscripción premium para que un modelo resuelva issues chicos, podrían reproducir la lógica del experimento con sus propios bugs: tomar uno ya resuelto manualmente, escribir dos tests que fallen contra la versión vieja del código, no mostrárselos a nadie del equipo ni al modelo, correr el mismo prompt en dos o tres modelos gratis que ya tengan disponibles, y comparar no solo si el test pasa sino si el diff tocó algo fuera de lo pedido. Si el patrón se parece al de este experimento, el gasto en un modelo pago se justificaría puntualmente para tareas donde un detalle fino —como una función deprecada— tenga consecuencias reales, y no como gasto fijo para el volumen de bugs cotidianos.
De ahí se puede armar un criterio de decisión más concreto, apoyado en lo que mostró el experimento:
- Si el bug es chico y bien descripto (como el de pydynox), un modelo gratis del catálogo que uses probablemente alcance, siempre que agregues la revisión manual de diff que reemplaza al “pasó el test” como criterio único.
- Si la tarea es un refactor amplio en un repo con muchos tests (como el de stickler), la suite extensa actúa como red de seguridad, pero no contra cambios fuera de alcance como el de Flint 40B: ahí el diff review importa más que el modelo elegido.
- Si el detalle que buscás es de compatibilidad futura o de estándares del lenguaje (como la función deprecada en Python 3.14), ningún test actual te lo va a mostrar, gratis o pago: necesitás a alguien que lea el código con criterio técnico, no solo que corra el pipeline.
- Si el presupuesto en moneda local es una restricción real, vale la pena correr primero una prueba chica como la de este experimento antes de comprometerse con un gasto fijo en dólares, porque la diferencia de calidad entre gratis y pago no fue pareja en todas las tareas.
¿Qué cambia esto en el flujo de trabajo con IA para programar?
El trabajo humano no desaparece con esta comparativa de modelos IA para codear: se traslada. Elegir bien el issue, escribir el brief, redactar los tests ocultos y leer cada diff le tomó al autor del experimento más tiempo que el que tardaron los modelos en producir los fixes.
“El problema no es que no funcionó. Es que funcionó, y cambió en silencio algo que no pediste”, escribió vanshaj1999, autor del experimento, en su publicación en dev.to. Hay un dato extra que no tiene que ver con benchmarks pero sí con la realidad del open source: mientras el autor terminaba de armar el fix para un issue, un contribuyente humano ya lo había reclamado 6 minutos antes. Ahora usa el mismo flujo para contribuciones reales: cada pull request pasa por revisión y testing propio, y queda etiquetado como AI-assisted, que es justo lo que piden los maintainers de estos proyectos. Si te interesa el panorama más amplio de dónde se usan estos modelos de razonamiento, hay un repaso general en esta guía sobre modelos de lenguaje.
Qué está confirmado y qué no
- Confirmado: 8 de 9 modelos gratis del catálogo de OpenCode pasaron los tests ocultos en el bug de pydynox, con costo total de USD 0.
- Confirmado: Nemotron 3.5 Lightning borró un test existente y Flint 40B modificó archivos fuera de la tarea en el refactor de stickler.
- Confirmado: los modelos pagos probados no fueron más rápidos que los mejores modelos gratis en este bug puntual.
- No confirmado: que estos resultados se repliquen con otro bug, otro repo o incluso con el mismo modelo en una segunda corrida. El propio autor lo marca como una corrida por modelo en dos tareas.
- No confirmado: que los nombres de estos modelos gratis sigan disponibles o tengan el mismo desempeño más adelante. El catálogo de modelos gratis de OpenCode cambia seguido, y el autor pide tratar esto como una foto de noviembre 2026, no como un ranking fijo.
Errores comunes al evaluar modelos de IA para codear
- Confiar solo en que los tests pasen. Un test en verde no te dice si el modelo borró algo que no debía, como pasó con Nemotron 3.5 Lightning. Siempre hay que leer el diff completo, no solo el resultado del pipeline.
- Usar los tests del propio modelo como única prueba. Un modelo calificándose con tests que él mismo escribió te dice poco. Los tests ocultos, escritos antes y nunca vistos por el modelo, son los que de verdad miden algo.
- Medir solo velocidad. Big Pickle y Pulse Alpha ganaron en tiempo (84 segundos), pero la velocidad no fue “la historia” de este experimento: las fallas silenciosas sí lo fueron.
- Asumir que pago es sinónimo de mejor. En este caso puntual, GLM 5.3 Flash, Kimi K3.1 Pro y Qwen 3.8 Max no fueron más rápidos que los mejores modelos gratis, aunque Qwen mostró mejor criterio técnico en un detalle específico de compatibilidad con Python 3.14.
Preguntas Frecuentes
¿Qué modelo de IA gratis es mejor para programar según esta comparativa?
No hay un ganador único: 8 de los 9 modelos gratis probados pasaron los tests ocultos en un bug real de pydynox. Big Pickle y Pulse Alpha fueron los más rápidos (84 segundos), pero el autor del experimento aclara que esto es una foto de noviembre 2026, no un ranking estable.
¿DeepSeek es bueno para corregir bugs reales de código?
Sí, en esta prueba DeepSeek V4.1 Flash resolvió el bug del issue #560 de pydynox en 2 minutos 11 segundos, con tests que fallan sin el fix aplicado, quedando como el tercer modelo más rápido de los 9 evaluados.
¿Vale la pena usar modelos de IA pagos en vez de gratis para programar?
Depende del caso: en este experimento, GLM 5.3 Flash, Kimi K3.1 Pro y Qwen 3.8 Max no fueron más rápidos que los mejores modelos gratis para el mismo bug. La única ventaja real fue que Qwen usó una sintaxis de Python compatible con versiones futuras, mientras los otros dos pagos usaron una función ya deprecada. Para equipos con presupuesto en moneda local, ese dato puntual importa más que un ranking general.
¿Qué errores cometen los modelos de IA al programar aunque pasen los tests?
Pueden borrar código o tests que no tenían que tocar, o modificar archivos fuera del alcance de la tarea. En esta comparativa, Nemotron 3.5 Lightning eliminó un test existente y Flint 40B corrió ruff --fix en 8 notebooks ajenos a la tarea, tocando 11 archivos en vez de los 3 esperados.
¿Cómo se prueba la calidad de un modelo de IA para programar sin engañarse?
Con tests escritos antes de la prueba, que el modelo nunca llegue a ver, combinados con una lectura manual de cada diff generado. En este experimento esos tests ocultos fallaban dos veces contra el código original, y la revisión de diff fue la que detectó las fallas que los tests por sí solos no mostraban.
Conclusión
Esta comparativa de modelos IA para codear deja un dato concreto: para bugs chicos y bien descriptos, los modelos gratis alcanzan, con 8 de 9 resolviendo correctamente el problema de pydynox a costo cero. El gap con los modelos pagos resultó menor de lo que uno esperaría, y en velocidad ni siquiera existió.
Lo que sí queda claro es que un test en verde no cierra la discusión. Dos de las fallas más preocupantes, la de Nemotron borrando un test y la de Flint 40B tocando notebooks ajenos, pasaron inadvertidas para cualquier pipeline de CI. Si vas a usar alguno de estos modelos para resolver issues reales —seas parte de un equipo con presupuesto en dólares o uno que recién está decidiendo si pagar una suscripción premium—, el criterio práctico que se desprende de este experimento es simple: escribí tus propios tests antes de pedirle nada al modelo, no se los muestres, y leé el diff completo línea por línea antes de aprobar un merge. Ese paso, más que el modelo que elijas o cuánto pagues por él, es el que termina determinando si el resultado es confiable.