Claude Code terminó de editar y la única pregunta que queda es si el CI pasa. Pushear una rama para averiguarlo cuesta un commit, una corrida de workflow y varios minutos de reloj antes de la primera línea de salida; si el resultado es rojo, hay que repetir el ciclo entero. La nota que Kaveh Alemi publicó en dev.to el 15 de noviembre de 2026 reúne tres caminos para acortar ese bucle y su detalle más útil es que no son intercambiables: cada uno responde una pregunta distinta sobre el workflow, el código o la máquina donde corre el código. Los comandos y la corrida registrada que cita ese texto son del 20 de septiembre de 2026, y conviene leerlos con esa fecha en mente.
En este artículo:
- ¿Qué significa correr el CI desde Claude Code?
- ¿Cómo disparo el workflow real sin pushear una rama nueva?
- ¿Se puede probar un workflow de GitHub Actions en local antes de subirlo?
- ¿Cómo hacer que el agente arregle los tests antes de abrir el pull request?
- ¿Cómo hacer que Claude Code corra dentro de GitHub Actions?
- ¿Por qué no se disparan los workflows en los commits que pushea Claude?
- Qué log conviene pasarle a Claude cuando el job falla
- Qué ruta elegir según la duda
- Cómo verificarlo antes de adoptarlo
- Fuentes
¿Qué significa correr el CI desde Claude Code?
Correr el CI desde Claude Code es hacer que el agente, dentro de su propia sesión, obtenga un veredicto de integración continua —pasó o falló, con código de salida— y lo use para decidir el paso siguiente, en lugar de esperar que una persona abra la pestaña de Actions. El punto central es el formato del resultado: un agente puede ramificar sobre un número, no sobre un párrafo de log. Por eso las tres rutas que siguen intentan convertir una corrida remota en un comando en primer plano con exit code.
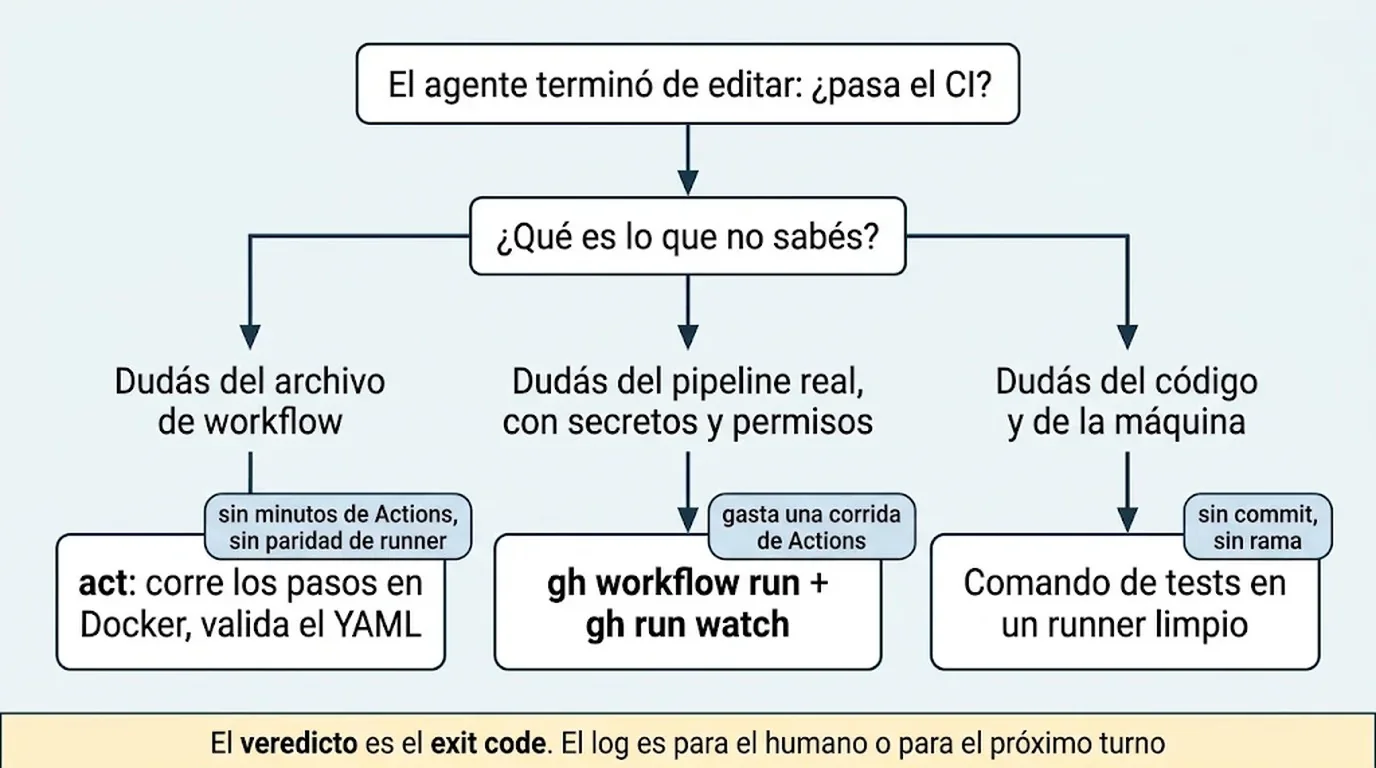
La distinción práctica es qué se pone a prueba. Si la duda es el archivo de workflow, se ejecuta el workflow real. Si la duda es si el YAML está bien armado, se reproduce en local. Si la duda es si los tests pasan en un Linux limpio, se corre el comando de test y nada más.
¿Cómo disparo el workflow real sin pushear una rama nueva?
La ruta 1 usa el GitHub CLI para disparar el workflow verdadero y esperar su desenlace en primer plano. Ninguna de las tres rutas crea una rama nueva, pero solo la tercera prueba el código sin commitear: gh workflow run dispara sobre una referencia que ya existe en el remoto, así que sirve para validar el pipeline con secretos y permisos reales, no para anticipar el veredicto de la edición que está en el working tree. Más contexto en controlá tus sesiones de Claude Code a distancia.
El requisito previo es que el workflow declare on: workflow_dispatch; sin ese disparador, GitHub rechaza la orden. El identificador de la corrida no vuelve de forma confiable en la llamada de dispatch, así que hay que buscarlo después:
gh workflow run ci.yml --ref "$(git branch --show-current)"
sleep 3
run_id=$(gh run list --workflow ci.yml --branch "$(git branch --show-current)" \
 --limit 1 --json databaseId --jq '.[0].databaseId')
gh run watch "$run_id" --exit-status --compact
gh run view "$run_id" --log-failed
La parte frágil es la búsqueda del identificador: un dispatch tarda un momento en aparecer en el listado y una consulta inmediata puede devolver la corrida anterior. Filtrar por rama ayuda, pero no alcanza; hay que verificar que la corrida observada sea la que se acaba de iniciar. gh run watch --exit-status bloquea hasta el final y devuelve un código distinto de cero si falló, que es exactamente la señal que el agente necesita.
El texto de origen recomienda pedir solo el log del paso fallido con --log-failed. Un log completo de Actions son decenas de miles de líneas y la mayor parte es ruido de preparación que el agente va a leer como contexto sobre el que debe razonar. Los flags citados fueron verificados contra la ayuda de gh versión 2.89.0, según el relevamiento del 20 de septiembre de 2026.
¿Se puede probar un workflow de GitHub Actions en local antes de subirlo?
Sí, con act, que lee los archivos de workflow y ejecuta cada paso en un contenedor Docker de tu máquina. Es el camino más rápido para validar la forma del YAML: si la matriz expande como se esperaba, si una expresión evalúa, si el orden de pasos y las condiciones if hacen lo que uno cree. Necesita Docker corriendo, porque así ejecuta cada paso. Complementá con instalá el skill ELI5 en dos comandos.
act -l
act -j test
act pull_request -W .github/workflows/ci.yml
Lo que no da es el runner hospedado de GitHub. La documentación de act lo dice sin vueltas: sus imágenes por defecto no contienen todas las herramientas que GitHub ofrece en sus runners y muchas cosas pueden funcionar mal o directamente no funcionar. Un job verde en act puede fallar en ubuntu-latest porque el toolchain preinstalado, el disco y el techo de memoria son distintos; y un job que falla en act a veces solo extraña una herramienta que la imagen real sí trae. Conclusión: un verde en act es evidencia sobre el archivo de workflow, no sobre tu código ni sobre el entorno.
¿Cómo hacer que el agente arregle los tests antes de abrir el pull request?
La ruta 3 corre el comando de test en una máquina Linux limpia, con dependencias recién instaladas, sin pasar por la capa del workflow. La idea es simple: la mayoría de las veces el agente no quiere saber si el YAML parsea, quiere saber si la suite pasa en un entorno parecido al de CI, que es justo lo que difiere de la laptop y lo que rompe. Un agente que corre la suite sobre su working tree encuentra la falla en el bucle donde todavía puede corregirla en silencio, y el pull request que abre después ya pasó por una máquina limpia.
latchkey run 'npm ci && npm test'
verdict=$? # el exit status del CLI es el veredicto
El ejemplo pertenece a Latchkey, la herramienta del propio autor de la nota, un dato de contexto que conviene tener presente: empaqueta el working tree, lo envía a un runner fresco, ejecuta una línea de bash y devuelve el log junto con el resultado del job. Ahí hay dos trampas concretas. Una pipe reemplaza el código de salida del CLI por el del parser, y el campo exit_code del evento complete lee un job cancelado o vencido como si fuera un test normal, así que el veredicto es el estado de salida del proceso y no el JSON.
latchkey run --output json 'npm test' > events.ndjson
verdict=$?
jq -r 'select(.event == "complete") | "\(.state) \(.exit_code)"' < events.ndjson
La corrida registrada que acompaña la nota es del 20 de septiembre de 2026, sobre un runner latchkey-small con Linux 6.17.0-1019-aws y Node v20.20.2: dos tests, dos en verde, cero fallas, código de salida 0. La tarifa publicada en latchkey.dev/pricing, leída también el 20 de septiembre de 2026, era de 0,0025 dólares por minuto, facturado por minuto redondeado hacia arriba por job. Son datos del proveedor en esa fecha, no un precio vigente hoy. Lo explicamos a fondo en trabajar con codebases grandes en Claude Code.
¿Cómo hacer que Claude Code corra dentro de GitHub Actions?
La dirección inversa es claude-code-action: en lugar de que el agente maneje el CI desde afuera, el agente corre dentro de un job de Actions, sobre un runner, disparado por un evento de GitHub. Según la documentación de Anthropic, la acción detecta el modo de ejecución a partir del contexto del workflow. Sin el input prompt espera la frase de activación —@claude por defecto— en un comentario de issue o de pull request. Con prompt corre automática ante cualquier evento, incluido schedule.
Lo que no es boilerplate en el workflow mínimo son los permisos: id-token: write para la autenticación por GitHub App, actions: read para que Claude pueda leer los resultados de CI en el pull request, y una condición if con contains(github.event.comment.body, '@claude') para no levantar un runner en cada comentario. La instalación rápida se hace desde la terminal con /install-github-app, y requiere ser administrador del repositorio; está pensada para usuarios de la API directa de Anthropic, y para Bedrock, Vertex AI o Microsoft Foundry hay una guía aparte. La acción se ejecuta entera en tu propio runner, con las llamadas al modelo yendo al proveedor que elijas.
¿Por qué no se disparan los workflows en los commits que pushea Claude?
Porque GitHub no dispara workflows sobre commits hechos con el GITHUB_TOKEN por defecto, y los pull_request quedan esperando aprobación. Si le pasás ese token a la acción, los workflows de push no corren en los commits de Claude. La sección de troubleshooting de la documentación de Anthropic nombra el caso; la salida es dejar que la acción se autentique como la GitHub App de Claude, quitando github_token del paso, o pasar un token de app propio. Más sobre esto en las fallas XSS en ACF Extended.
Qué log conviene pasarle a Claude cuando el job falla
Primero el veredicto, después el log del paso fallido, el resto nunca. Un agente que lee salida de CI gasta contexto en ella, así que hay que darle lo mínimo que responda la pregunta: gh run view --log-failed para una corrida de GitHub, o el evento complete del stream NDJSON cuando se usa un runner propio. El log completo queda para el humano o para el turno siguiente, y solo si el número no es cero. Cubrimos ese tema en detalle en nuestra guía completa sobre Claude.
Hay una clase de falla que merece tratamiento aparte: la que no tiene nada que ver con el código. Un timeout del registry, un disco lleno o un kill por falta de memoria son hechos de la máquina, y dárselos a un agente lo invita a editar código que nunca estuvo mal. El caso típico es el exit code 137, que en GitHub Actions es SIGKILL y casi siempre el out-of-memory killer, no un test roto.
Un aporte complementario viene de la guía de agentes programados de Agentastic, publicada el 15 de octubre de 2026: antes de elegir el error hay que elegir la corrida. Conviene listar las últimas corridas del workflow exacto con gh run list --workflow ci.yml --branch main --limit 5 --json databaseId,attempt,headSha,status,conclusion,createdAt,url y no arrancar por --status failure sin comprobar antes si un commit posterior ya lo resolvió. Después, gh run view RUN_ID --attempt N --log-failed acota el intento correcto. La misma guía recuerda dos precauciones que aplican acá: los logs pueden traer rutas privadas o credenciales expuestas por accidente, y su contenido es entrada no confiable —un script de dependencia puede imprimir instrucciones, pero esas instrucciones no adquieren autoridad sobre la tarea—.
Qué ruta elegir según la duda
| Qué no tenés claro | Ruta | Qué cuesta |
|---|---|---|
| El archivo de workflow: disparadores, matriz, expresiones, orden de pasos | act | Docker en tu máquina, sin minutos de Actions, sin paridad con el runner real |
| El pipeline real de punta a punta, con secretos y permisos | gh workflow run más gh run watch | Una corrida de workflow y sus minutos de Actions |
| El código y la máquina: ¿la suite pasa en Linux limpio? | Comando de test en un runner fresco | Minutos de runner, sin commit |
Correr las tres en cada edición es la forma más efectiva de convertir un bucle rápido en uno lento. La elección se hace por descarte: identificá qué es lo que no sabés y usá la ruta que responde esa pregunta.
Cómo verificarlo antes de adoptarlo
Como criterio editorial, y sin atribuirlo a las fuentes: elegí un workflow cuyo fallo ya entiendas y hacé el ejercicio completo una vez. Dispará con gh workflow run, guardá el run_id y comprobá que el headSha de esa corrida coincida con el git rev-parse HEAD de tu checkout; si no coinciden, la corrida que miraste no es la tuya y cualquier conclusión posterior queda invalidada. Después corré el mismo comando de test en un entorno limpio y compará los dos veredictos. Si discrepan, la diferencia te dice si el problema es de código o de entorno, que es la información que ninguna de las dos rutas da por separado. Este ejercicio no está reportado como prueba en las fuentes citadas: es una propuesta de verificación para que quien adopte el flujo tenga una referencia propia antes de delegarle decisiones al agente.
Lo que las fuentes no permiten concluir es más importante que lo que sí permiten: no hay evidencia de que una ruta sea más rápida que otra en todos los repositorios, ni mediciones comparables de tiempo total, ni una corrida hospedada de reparación ejecutada de punta a punta en el caso de los agentes programados. Lo que sí está documentado son los comandos, los requisitos —workflow_dispatch en el workflow, Docker para act, permisos para la acción— y los modos de falla que conviene conocer antes de cablear cualquiera de los tres caminos.
Fuentes
- How to run CI from Claude Code, Kaveh Alemi, dev.to, 15 de noviembre de 2026.
- Run CI From Claude Code: Three Honest Routes That Work, Latchkey, 20 de septiembre de 2026.
- anthropics/claude-code-action, repositorio en GitHub.
- Scheduled Coding Agents: Diagnose and Fix CI Failures, Agentastic.dev, 15 de octubre de 2026.