En pocas palabras: GPT-5 quedó segundo en el benchmark legal LEXam, con 62.65 puntos, por detrás de Darwin-180B-RSI de VIDRAFT (68.94), que nunca entrenó con datos legales. Así lo reportó AI타임스 el 1 de octubre de 2026, según resultados certificados por Hugging Face.
VIDRAFT, una startup coreana de IA, logró que su modelo Darwin-180B-RSI quede primero en los benchmarks legales LEXam y LEXam-hard, certificados por Hugging Face, sin haber entrenado ni una sola vez con datos legales. El modelo saca 68.94 puntos en LEXam, por encima de GPT-5 (62.65) y Claude 4.5 Sonnet (58.01), según reportó AI타임스 el 1 de octubre de 2026.
Darwin-180B-RSI es un modelo de razonamiento de 180.000 millones de parámetros desarrollado por VIDRAFT, que combina checkpoints de modelos ya entrenados en vez de entrenar desde cero, y que después pasa por un proceso de auto-mejora recursiva (de ahí el sufijo RSI) basado exclusivamente en problemas de matemática y ciencia. El resultado llamativo: ese entrenamiento, que nunca tocó un texto legal, le alcanzó para liderar los rankings de razonamiento jurídico.
En este artículo:
- En 30 segundos
- ¿Qué es Darwin-180B-RSI y quién está detrás del modelo?
- ¿Qué significa RSI (Recursive Self-Improvement) en este modelo?
- ¿Cómo logró superar a GPT-5 y Claude 4.5 Sonnet sin entrenar con datos legales?
- ¿Qué son los benchmarks LEXam y LEXam-hard, y qué resultados obtuvo Darwin-180B-RSI?
- ¿Qué papel juega Zero-Token Confidence (ZTC) en la eficiencia del modelo?
- ¿Qué tan verificado está este resultado y qué limitaciones tiene?
- Errores comunes al interpretar este tipo de benchmarks
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Darwin-180B-RSI de VIDRAFT saca 68.94 en LEXam, superando a GPT-5 (62.65), Claude 4.5 Sonnet (58.01) y DeepSeek-R1 (52.41).
- En LEXam-hard logra 45.72, contra 40.82 de Inkling (Thinking Machines), el anterior puntero.
- El modelo nunca entrenó con datos legales: todo el proceso de auto-mejora usó problemas de matemática y ciencia.
- Solo se modificó el 0.02% de los parámetros durante la fase de Recursive Self-Improvement.
- VIDRAFT ya tiene el #1 en 7 de 47 categorías de leaderboards certificados por Hugging Face, por delante de Zhipu AI, DeepSeek, Xiaomi y Moonshot AI.
¿Qué es Darwin-180B-RSI y quién está detrás del modelo?
Darwin-180B-RSI es un modelo de razonamiento de 180B parámetros creado por VIDRAFT (비드래프트), una startup coreana de IA. Su arquitectura base, la familia Darwin, no se entrena desde cero sino que fusiona y combina las fortalezas de modelos pre-entrenados existentes, un enfoque pensado para bajar el costo de cómputo que normalmente implica un pre-entrenamiento a gran escala.
El sufijo -RSI marca la diferencia. Designa a las variantes que, además de la arquitectura Darwin, pasaron por el procedimiento de Recursive Self-Improvement de VIDRAFT. Ahí está la clave de todo este caso.
Ponele que tenés un modelo que fusiona capacidades de otros en vez de arrancar de cero: la lógica es más cercana a ensamblar piezas que ya funcionan que a construir un motor nuevo desde cero. Esa decisión de diseño es la que después le permite a VIDRAFT invertir recursos en el loop de auto-mejora en lugar de gastarlos en pre-entrenamiento masivo.
¿Qué significa RSI (Recursive Self-Improvement) en este modelo?
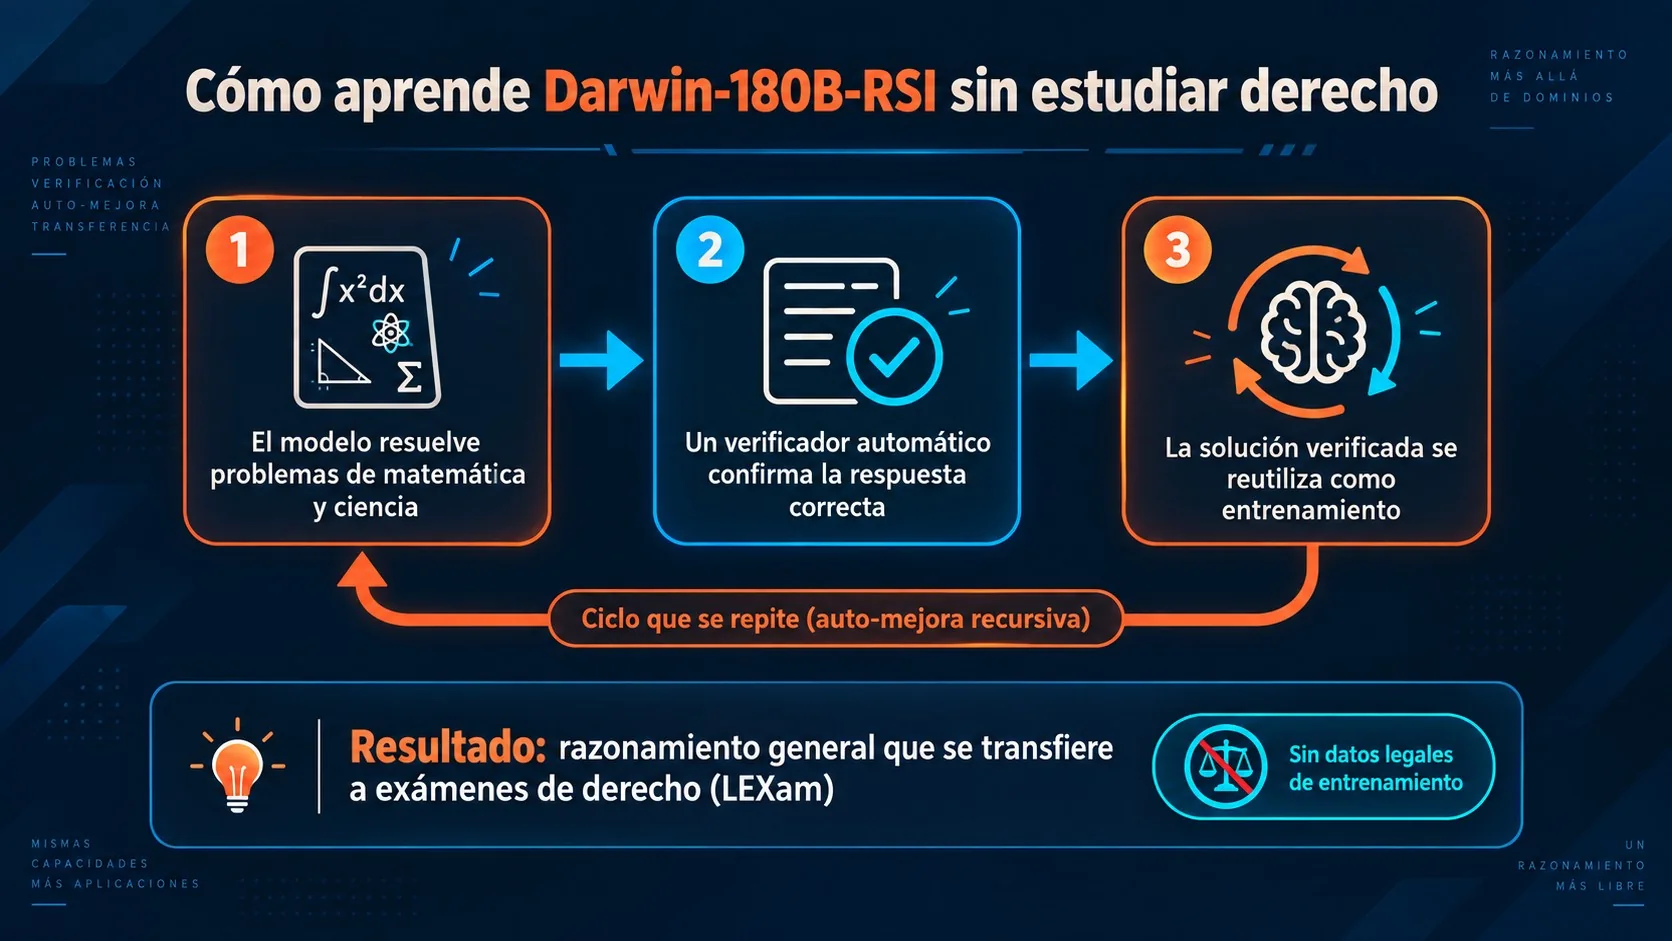
RSI es el nombre que le da VIDRAFT a un loop de entrenamiento auto-supervisado donde el modelo resuelve problemas, un verificador automático chequea si la solución es correcta, y solo las respuestas validadas se usan como señal para seguir entrenando. Nada de anotaciones humanas de cadena de razonamiento: el propio sistema genera y filtra su material de estudio. Relacionado: cómo le fue a GPT-5.6 Sol en benchmarks.
El dato que sorprende es de dónde salen esos problemas: matemática y ciencia, nada de derecho. El modelo intenta resolver, un verificador confirma si acertó, esa solución correcta vuelve como señal de entrenamiento, y el ciclo se repite una y otra vez, refinando la capacidad de razonamiento sin que ningún humano etiquete nada a mano.
¿Y por qué eso termina ayudando en exámenes de derecho? La apuesta de VIDRAFT es que la capacidad general de razonamiento, no el conocimiento específico de un dominio, es lo que transfiere al desempeño legal. Razonar en derecho implica aplicar reglas a hechos y sacar conclusiones, una estructura que se parece bastante al razonamiento matemático riguroso.
¿Cómo logró superar a GPT-5 y Claude 4.5 Sonnet sin entrenar con datos legales?
Darwin-180B-RSI superó a GPT-5 y Claude 4.5 Sonnet en LEXam modificando apenas el 0.02% de sus parámetros durante la fase de auto-mejora, usando únicamente problemas de matemática y ciencia como material de entrenamiento. El supuesto de fondo, según reporta el reporte de AI타임스, es que el razonamiento deductivo generalizable se traslada bien a formatos de examen legal.
Acá viene lo interesante del tamaño: con 180B parámetros, Darwin-180B-RSI le gana a DeepSeek-R1, que tiene 685B parámetros, casi cuatro veces más. La cantidad de parámetros, claramente, no es el factor que decide esta carrera.
Esto no significa que el modelo “entienda” leyes en el sentido humano del término (esa palabra, tomala con pinzas). Lo que sugiere el resultado es que LEXam mide una habilidad de razonamiento estructurado, aplicar reglas a hechos para llegar a una conclusión, más que memorización de jurisprudencia o doctrina. Sobre eso hablamos en comparativa de benchmarks entre los modelos líderes.
¿Qué son los benchmarks LEXam y LEXam-hard, y qué resultados obtuvo Darwin-180B-RSI?
LEXam y LEXam-hard son benchmarks de razonamiento legal certificados por Hugging Face, desarrollados por ETH Zúrich y colaboradores, basados en exámenes reales de facultades de derecho. LEXam evalúa con preguntas de opción múltiple y LEXam-hard con respuestas abiertas tipo ensayo, ambos diseñados para medir la aplicación de estatutos a casos concretos y no la memorización de textos legales.
Los números hablan por sí solos en la tabla de LEXam:
| Modelo | Puntaje LEXam |
|---|---|
| Darwin-180B-RSI | 68.94 |
| GPT-5 | 62.65 |
| Claude 4.5 Sonnet | 58.01 |
| DeepSeek-R1 | 52.41 |
| Qwen-235B-Thinking | 48.19 |
| gpt-oss-120b | 47.71 |
En LEXam-hard, el formato más exigente porque pide respuestas abiertas estilo ensayo, Darwin-180B-RSI saca 45.72 contra 40.82 de Inkling (Thinking Machines), el modelo que tenía el primer puesto antes de esta actualización.
| Modelo | Puntaje LEXam-hard |
|---|---|
| Darwin-180B-RSI | 45.72 |
| Inkling (Thinking Machines) | 40.82 |
El tema es que LEXam no es un benchmark cualquiera armado por un paper sin trayectoria. Está construido sobre exámenes reales de universidades de derecho, lo que lo convierte en un proxy razonable de la capacidad de razonamiento jurídico práctico, no de la habilidad de repetir definiciones de memoria.
¿Qué papel juega Zero-Token Confidence (ZTC) en la eficiencia del modelo?
Zero-Token Confidence (ZTC) es la técnica de VIDRAFT para estimar la confianza interna del modelo en una respuesta sin gastar tokens extra de inferencia, y contribuyó a una reducción del 11% en la longitud promedio de la cadena de razonamiento respecto al modelo padre, sin que la precisión bajara. Te puede servir nuestra cobertura de guía de herramientas de desarrollo con IA.
Menos tokens por respuesta, misma exactitud. Eso se traduce directo en menor costo de inferencia, algo que le importa a cualquiera que piense en desplegar estos modelos a escala, porque cada token de razonamiento interno que el sistema no necesita generar es plata que no se gasta en cómputo.
ZTC se usa adentro del loop de auto-mejora: ayuda al modelo a calibrar qué tan confiable es su propia respuesta antes de aceptarla como señal de entrenamiento válida. Es una pieza chica del sistema, pero con impacto directo en el costo operativo del modelo final.
¿Qué tan verificado está este resultado y qué limitaciones tiene?
El reporte original salió de AI타임스 el 1 de octubre de 2026, y según ese artículo el modelo y las condiciones de evaluación están publicados en Hugging Face para que cualquiera los verifique de forma independiente. VIDRAFT ya acumula el primer puesto en 7 de las 47 categorías de leaderboards certificados por Hugging Face, en matemática, ciencia, conocimiento general, razonamiento visual y ahora razonamiento legal, por delante de Zhipu AI (4 categorías), DeepSeek, Xiaomi y Moonshot AI (3 cada una).
¿Alguien afuera de VIDRAFT confirmó estos números de forma independiente? Todavía no, al menos no según lo que figura en el reporte disponible. Que el modelo esté publicado en Hugging Face es una condición necesaria para la verificación, pero no es lo mismo que una auditoría externa ya realizada. Tema relacionado: integración de agentes de IA en Jira.
Ahora bien, hay vacíos concretos que conviene marcar. No hay repositorio público en GitHub, no hay API confirmada y no está claro si los pesos del modelo están disponibles para descarga directa al momento de escribir esto. Si estás evaluando este modelo para un caso de uso real en legal tech o sector público, el criterio práctico es simple: antes de tomar cualquier decisión, confirmá en el perfil oficial de VIDRAFT en Hugging Face si el checkpoint completo está descargable y si las condiciones de evaluación (dataset, prompts, metodología de scoring) están documentadas con el detalle suficiente para reproducir el resultado en tu propio entorno. Un leaderboard sin reproducibilidad abierta es un dato interesante, no una garantía de producción.
El propio CEO de VIDRAFT, Minsik Kim, apunta los verticales objetivo: servicios legales, administración pública y servicios financieros, dominios donde el juicio auditable bajo incertidumbre pesa mucho. Son sectores donde, si alguna vez tuviste que justificar una decisión frente a un regulador, sabés que la trazabilidad del razonamiento importa tanto como el resultado final.
Errores comunes al interpretar este tipo de benchmarks
- Confundir benchmark con capacidad legal real. Que un modelo gane LEXam no significa que pueda reemplazar el criterio de un abogado en un caso complejo con hechos ambiguos; el benchmark mide razonamiento sobre exámenes estructurados, no litigio real.
- Asumir que más parámetros ganan. Darwin-180B-RSI, con 180B parámetros, supera a DeepSeek-R1 (685B). El tamaño del modelo dejó de ser el predictor confiable que era hace un par de años.
- Tomar el leaderboard como verificación independiente. Publicar en Hugging Face habilita la verificación, pero no equivale a que un tercero ya haya reproducido los números de forma externa.
- Ignorar el costo de inferencia al comparar modelos. Un modelo con mejor puntaje pero cadenas de razonamiento más largas puede terminar costando más por consulta que uno con ZTC o técnicas similares.
Preguntas Frecuentes
¿Qué es Darwin-180B-RSI y quién lo creó?
Darwin-180B-RSI es un modelo de razonamiento de 180.000 millones de parámetros desarrollado por VIDRAFT, una startup coreana de IA. Combina checkpoints de modelos pre-entrenados y suma un proceso de auto-mejora recursiva (RSI) entrenado con problemas de matemática y ciencia.
¿Cómo puede una IA ganar un benchmark legal sin haber estudiado leyes?
Porque el benchmark mide razonamiento estructurado (aplicar reglas a hechos y sacar conclusiones), no memorización de texto legal. Ese tipo de razonamiento se entrena con problemas de matemática y ciencia y, según los resultados reportados, transfiere al formato de examen jurídico.
¿Qué es el benchmark LEXam y quién lo desarrolló?
LEXam es un benchmark de razonamiento legal certificado por Hugging Face, desarrollado por ETH Zúrich y colaboradores, basado en exámenes reales de facultades de derecho. Evalúa la aplicación de estatutos a escenarios fácticos, con una versión de opción múltiple (LEXam) y otra de respuesta abierta tipo ensayo (LEXam-hard).
¿Qué es Recursive Self-Improvement (RSI) en IA?
RSI es un loop de entrenamiento auto-supervisado donde el modelo resuelve problemas, un verificador automático valida las respuestas correctas, y esas soluciones se usan como señal de entrenamiento para repetir el ciclo. No requiere anotaciones humanas de razonamiento paso a paso.
¿Darwin-180B-RSI es mejor que GPT-5 y Claude en todo?
No hay evidencia de eso. Los resultados reportados muestran a Darwin-180B-RSI por delante en LEXam y LEXam-hard específicamente, con 68.94 contra 62.65 de GPT-5 y 58.01 de Claude 4.5 Sonnet, pero eso no implica superioridad en otras tareas generales de lenguaje o código.
Conclusión
Lo que cambia acá no es tanto el puntaje puntual, es la confirmación de que el razonamiento entrenado en dominios como matemática y ciencia puede transferirse a tareas legales sin pasar por un solo documento jurídico. Si trabajás en legal tech o evaluás modelos para aplicaciones de alto riesgo, el dato concreto para seguir de cerca es si VIDRAFT libera pesos descargables y documentación de evaluación reproducible, porque sin eso el liderazgo en el leaderboard sigue siendo una afirmación verificable en principio, pero todavía no verificada de forma independiente. Por ahora, lo prudente es tratar estos números como un punto de partida para pruebas propias, no como un veredicto cerrado.