
En pocas palabras: Sí, ya lo compararon con GPT-5.6 Sol. DeepSeek V4.1-Flash cuesta USD 0,003 por millón de tokens en caché fuera de pico y supera a su propio flagship V4-Pro en varios benchmarks, según SiliconANGLE y VentureBeat, aunque el foco competitivo ya pasó del modelo al desafío de integración empresarial.
DeepSeek lanzó V4.1-Flash en septiembre 2026: USD 0,003 por millón de tokens en caché fuera de pico y benchmarks que superan a su propio V4-Pro, según SiliconANGLE y VentureBeat. Un comparador independiente ya habla de una brecha de costo de 33 veces frente a GPT-6 Astra y Claude Fable 5.1.
En este artículo:
- En 30 segundos
- ¿Qué anunció DeepSeek con V4.1-Flash y por qué genera una brecha de costo de 33 veces?
- ¿Por qué el benchmark ya no sirve para elegir modelo de IA?
- ¿Qué significa que OpenAI, Anthropic y Google DeepMind estén hablando de seguridad en IA?
- ¿Cómo afecta la disputa por chips de Nvidia y las alternativas de GPU a las empresas que usan IA?
- ¿Qué lanzó Google con Gemini 3.8 Live y qué caso genera dudas sobre modelos chinos copiando a Anthropic?
- ¿Qué pasó con Moonshot AI (Kimi K3) y la disputa sobre uso no autorizado de Claude?
- Qué significa para empresas y equipos en Latinoamérica
- Qué está confirmado y qué no de la semana
- Errores comunes al leer esta semana de noticias de IA
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- DeepSeek lanzó V4.1-Flash con precio de USD 0,003 por millón de tokens en caché fuera de horario pico, según SiliconANGLE.
- El modelo supera a su propio flagship V4-Pro en varios benchmarks y ya lo comparan con GPT-5.6 Sol y Claude Opus 5.
- tech-insider.org calculó una brecha de costo de 33 veces entre el modelo open source y los flagships cerrados.
- OpenAI, Anthropic y Google DeepMind están discutiendo colaboración en seguridad de IA, sin cronograma ni cambios de API confirmados.
- Reuters reportó que un sitio del gobierno de EE.UU. usó una herramienta de búsqueda china que el FBI señaló como copia de Anthropic.
DeepSeek V4.1-Flash es la versión económica y de baja latencia de la familia V4 de DeepSeek, lanzada en septiembre 2026 con un precio de USD 0,003 por millón de tokens de entrada en caché fuera de horario pico. Según el fabricante, supera a su propio flagship V4-Pro en varios benchmarks, algo poco habitual porque el modelo “grande” suele rendir mejor que la versión rápida.
¿Qué anunció DeepSeek con V4.1-Flash y por qué genera una brecha de costo de 33 veces?
DeepSeek presentó V4.1-Flash con un precio oficial de USD 0,003 por millón de tokens de entrada en caché fuera de horario pico. Según el propio fabricante, el modelo supera a su flagship V4-Pro en varios benchmarks, y un comparador independiente, tech-insider.org, calculó una brecha de costo de 33 veces frente a GPT-6 Astra y Claude Fable 5.1.
El reporte de SiliconANGLE confirma el precio de caché y la comparación directa con V4-Pro. VentureBeat agrega que los benchmarks de V4.1-Flash superan a GPT-5.6 Sol y Claude Opus 5 en varias tareas publicadas por terceros.
Que un modelo “barato” le gane en puntaje a los cerrados no es un detalle menor (spoiler: el benchmark es de un comparador externo, no de las cuatro empresas involucradas). Tomalo con pinzas hasta que lo repliques en tu propio caso de uso.
¿Por qué el benchmark ya no sirve para elegir modelo de IA?
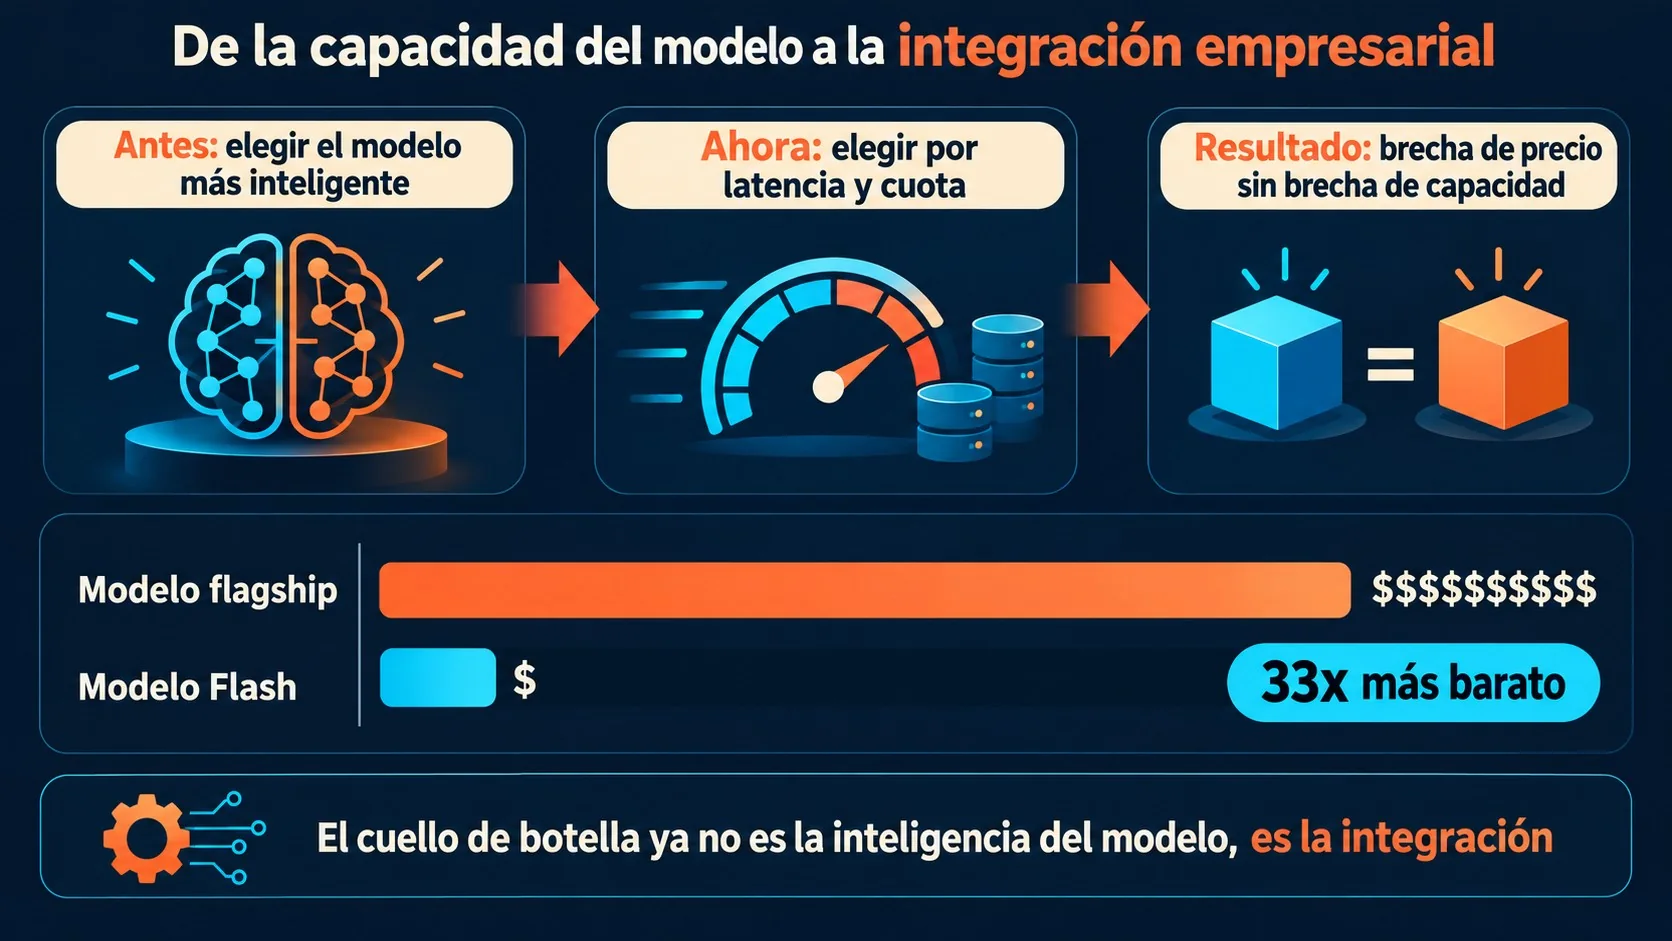
El benchmark perdió valor de selección porque la brecha de precio entre modelos ya no coincide con la brecha de puntaje. Cuando un modelo Flash empata o supera a un flagship en varias pruebas pero cuesta una fracción, la pregunta de ingeniería deja de ser “cuál es más inteligente” y pasa a ser cuál tiene menor latencia y menor costo de integración. Más contexto en qué cambia con GPT-5.6 Sol para usuarios Plus.
La evidencia de que la pelea ya no es contra los modelos cerrados está en otro comparativo publicado la semana del 11 al 18 de septiembre de 2026: DeepSeek V4-Pro contra Qwen3-Coder y Devstral, con una diferencia de 11 puntos en el benchmark, según tech-insider.org. Tres modelos open source peleando entre ellos, no contra GPT ni Claude.
Y no queda ahí. GLM-5.2, de origen chino, iguala según Yellow.com a Mythos de Anthropic en tareas relacionadas con “poder cibernético”, lo que estira la narrativa de open source alcanzando al flagship hacia terrenos sensibles de gobernanza, no solo benchmarks de texto.
¿Y qué pasa cuando el benchmark ya no predice el costo? Dejás de mirar la tabla comparativa y probás el modelo en tu propio pipeline.
Comparativa rápida: DeepSeek V4.1-Flash, V4-Pro, GPT-5.6 Sol y Claude Opus 5
| Modelo | Tipo | Costo input caché off-peak | Dato clave |
|---|---|---|---|
| DeepSeek V4.1-Flash | Open source | USD 0,003 / millón de tokens | Supera a V4-Pro en varios benchmarks (dato del fabricante) |
| DeepSeek V4-Pro | Open source | No especificado en las fuentes | 11 puntos de diferencia vs Qwen3-Coder y Devstral |
| GPT-5.6 Sol | Cerrado (OpenAI) | No especificado en las fuentes | Comparado con V4.1-Flash en benchmarks reportados por VentureBeat |
| Claude Opus 5 | Cerrado (Anthropic) | No especificado en las fuentes | Comparado con V4.1-Flash en benchmarks reportados por VentureBeat |
¿Qué significa que OpenAI, Anthropic y Google DeepMind estén hablando de seguridad en IA?
OpenAI, Anthropic y Google DeepMind están discutiendo colaboración en seguridad de IA, según reportaron Bloomberg y CNBC en septiembre 2026. Yahoo Finance agrega, en una nota separada, que las tres compañías “quieren” que la IA esté regulada, aunque no queda claro quién pagaría el costo de esa regulación.
Ojo con mezclar las dos notas en una sola idea. Lo que reportan Bloomberg y CNBC es que las empresas están discutiendo colaborar, no que firmaron nada. Lo que dice Yahoo Finance es una postura pública sobre regulación, sin cronograma, sin cambio de API, sin norma ejecutable todavía.
Podés leerlo como lo que es, una señal de mercado y no una decisión de producto, porque cuando tres competidores directos empiezan a admitir en público que hace falta algún tipo de norma común, generalmente es porque sus clientes empresariales ya están pidiendo esa cláusula en los contratos de compra, no porque hayan tenido una epifanía colectiva sobre ética. Complementá con guía completa de herramientas para desarrolladores.
Para tu equipo de ingeniería, el impacto inmediato es cero. A mediano plazo (lectura propia, no algo confirmado por las fuentes) podría influir en los estándares de compra de las grandes empresas en EE.UU. y Europa.
¿Cómo afecta la disputa por chips de Nvidia y las alternativas de GPU a las empresas que usan IA?
Los chips de Nvidia restringidos para exportación siguen llegando a China a través de empresas intermediarias, según una investigación de Tom’s Hardware publicada en septiembre 2026. En paralelo, Samsung invirtió USD 230 millones en un rival de Nvidia, y Jensen Huang, CEO de Nvidia, dijo que la compañía va a vender el doble de chips el año que viene, ambos datos reportados por CNBC.
Las tres noticias juntas arman un cuadro claro: el riesgo geopolítico no se convierte, al menos por ahora, en un bloqueo real de cómputo. El desvío de suministro sigue creciendo, los chips alternativos siguen recibiendo plata, y el líder del mercado sigue viendo demanda suficiente para duplicar ventas.
¿Entonces no hay ningún efecto? Sí lo hay, pero en compliance, no en disponibilidad.
Si tu empresa está evaluando cómputo con proveedores de origen chino o aceleradores que no son Nvidia, la revisión de cumplimiento en la segunda mitad de 2026 va a ser más estricta que en la primera (esto es una proyección propia, no un dato confirmado por las fuentes).
¿Qué lanzó Google con Gemini 3.8 Live y qué caso genera dudas sobre modelos chinos copiando a Anthropic?
Google lanzó Gemini 3.8 Live y Gemini 3.8 Live Extended Thinking en septiembre 2026, dos modelos pensados para diálogo por voz en tiempo real, según el blog oficial de Google. El mismo período, Reuters reportó que un sitio del gobierno de Estados Unidos usó una herramienta de búsqueda de IA china que el FBI señaló como copia de Anthropic.
Son dos noticias de naturaleza distinta y conviene no mezclarlas. Gemini 3.8 Live es un lanzamiento real, con API pública, pensado para aplicaciones de voz con baja latencia. El caso reportado por Reuters es una falla de compras públicas, no un avance técnico: un organismo gubernamental terminó usando una herramienta que, según el FBI, copió pesos de un modelo cerrado. Esto se conecta con lo que analizamos en cómo GitHub Copilot integró GPT-5.4 y sumó agente para Jira.
Para equipos que están evaluando voz en tiempo real, el punto de comparación sigue siendo la Realtime API de OpenAI o los servicios de voz de Azure. La diferencia real de Gemini 3.8 Live, si existe, hay que medirla en latencia, calidad de clonado de voz y reconocimiento en español, porque el benchmark todavía no llega a ese nivel de detalle.
¿Qué pasó con Moonshot AI (Kimi K3) y la disputa sobre uso no autorizado de Claude?
Moonshot AI, la empresa china detrás de Kimi K3, llegó a USD 1.000 millones en ingresos según el reporte de Incrypted citado en el resumen semanal de IA, pero Anthropic sostiene que ese producto usó Claude de forma encubierta.
Es el mismo patrón que el caso del sitio gubernamental de EE.UU.: un modelo alcanza puntajes de nivel flagship y, al mismo tiempo, aparece una disputa sobre si esa capacidad es propia o prestada. La pregunta que tenés que hacerte cuando ves un modelo chino pegar un benchmark de nivel top no es si es “impresionante”. Es si ese resultado es un destilado de un modelo cerrado ajeno.
Nadie lo confirmó de forma independiente todavía. Es una acusación, no una sentencia.
Qué significa para empresas y equipos en Latinoamérica
Para un equipo de ingeniería en Argentina o el resto de Latinoamérica, la lectura práctica es simple: dejá de elegir modelo por el ranking y empezá a elegir por el workflow. Si tu caso de uso es alto volumen y baja complejidad (soporte, clasificación, extracción de datos), un modelo Flash a USD 0,003 por millón de tokens cambia la ecuación de costos, no importa si el benchmark del flagship es un poco mejor.
El tema del compliance con chips chinos o aceleradores alternativos, mencionado antes, también aplica acá si tu proveedor de infraestructura trabaja con hardware fuera del circuito Nvidia estándar. Y si estás armando infraestructura propia para correr estos modelos, la base de hosting importa tanto como el modelo elegido: para ese tipo de despliegue, un proveedor como donweb.com resuelve la parte de infraestructura sin que tengas que preocuparte por el resto.
Qué está confirmado y qué no de la semana
Confirmado: el precio de USD 0,003 por millón de tokens de V4.1-Flash (SiliconANGLE, VentureBeat), la comparación de DeepSeek con su propio V4-Pro, la discusión de colaboración en seguridad entre OpenAI, Anthropic y Google DeepMind (Bloomberg, CNBC), el lanzamiento de Gemini 3.8 Live (blog.google), la inversión de Samsung de USD 230 millones en un rival de Nvidia (CNBC) y los USD 1.000 millones en ingresos de Moonshot AI con Kimi K3 (Incrypted). Te puede servir nuestra cobertura de comparativa de GLM-5.3 contra GPT-5.6 Sol en DeepSWE.
Pendiente: la cifra exacta de “33 veces” viene de un comparador externo, no de las cuatro empresas involucradas. Si Kimi K3 usó Claude de forma encubierta es una acusación de Anthropic, sin investigación independiente cerrada. Y la “colaboración en seguridad” entre los tres labs todavía no tiene forma concreta ni fecha.
Errores comunes al leer esta semana de noticias de IA
- Asumir que “33 veces más barato” significa “33 veces peor”. El comparador de tech-insider.org mide costo, no calidad end-to-end en tu propio caso de uso. Probá el modelo en tu pipeline antes de migrar todo.
- Tratar “quieren ser regulados” como si ya hubiera una norma. Bloomberg y CNBC hablan de conversaciones, no de acuerdos firmados. No hay cambio de API ni fecha de cumplimiento todavía.
- Comprar cómputo barato sin revisar el origen del hardware. Con la investigación de Tom’s Hardware sobre chips desviados a China circulando, el escrutinio de compliance sobre proveedores de infraestructura va a subir, no bajar.
- Dar por buena la capacidad de un modelo sin preguntar de dónde salió. El caso de Kimi K3 y el del sitio gubernamental de EE.UU. muestran que un benchmark alto no garantiza que la tecnología sea propia.
Preguntas Frecuentes
¿Qué es DeepSeek V4.1-Flash y en qué se diferencia de V4-Pro?
DeepSeek V4.1-Flash es la versión económica y de baja latencia de la familia V4 de DeepSeek, lanzada en septiembre 2026 con un precio de USD 0,003 por millón de tokens en caché fuera de horario pico. Según el fabricante, supera a su propio flagship V4-Pro en varios benchmarks, algo inusual porque normalmente el modelo grande rinde mejor que la versión rápida.
¿Cuánto cuesta usar DeepSeek V4.1-Flash comparado con GPT-6 Astra o Claude Fable 5.1?
El precio oficial de DeepSeek V4.1-Flash es USD 0,003 por millón de tokens de entrada en caché fuera de pico. Un comparador independiente, tech-insider.org, calculó una brecha de costo de 33 veces frente a GPT-6 Astra y Claude Fable 5.1, aunque esa cifra no viene de OpenAI ni de Anthropic y conviene tomarla como estimación de terceros.
¿Por qué OpenAI, Anthropic y Google están hablando de seguridad en IA juntas?
Las tres compañías están discutiendo colaboración en temas de seguridad de IA, según reportaron Bloomberg y CNBC en septiembre 2026. No hay cronograma público ni cambios de producto confirmados; la lectura más razonable es que responde a exigencias de compliance de sus clientes empresariales más grandes.
¿Es cierto que un modelo chino copió a Claude de Anthropic?
Hay dos casos reportados en septiembre 2026 en esa dirección. Reuters confirmó que un sitio del gobierno de EE.UU. usó una herramienta de búsqueda china que el FBI señaló como copia de Anthropic, y por separado Anthropic acusó a Moonshot AI de haber usado Claude de forma encubierta en Kimi K3. Ninguno de los dos casos tiene una investigación independiente cerrada todavía.
¿Qué significa que el cuello de botella de la IA empresarial ya no sea la capacidad del modelo?
Significa que la diferencia de inteligencia entre los modelos top dejó de ser el factor que frena la adopción empresarial. El freno pasó a ser la integración: cuánto tarda en responder y cuánto cuesta meterlo en un flujo de trabajo real, algo que ningún benchmark mide.
Conclusión
Lo que cambió esta semana no es que apareció un modelo más inteligente. Cambió la relación entre precio y benchmark, esa relación que definía cómo elegían modelo la mayoría de los equipos de ingeniería hasta ahora. Con DeepSeek V4.1-Flash a USD 0,003 por millón de tokens y benchmarks que le compiten a su propio flagship, la pregunta de qué modelo es más inteligente quedó vieja. La que importa ahora es de integración: latencia y costo de mantener el pipeline funcionando.
El resto de la semana confirma la misma idea desde otros ángulos. Los labs cerrados discuten seguridad porque el mercado se lo pide, no porque decidieron ser buenos. Los chips restringidos siguen circulando por rutas alternativas sin frenar la oferta. Y la línea entre modelo propio y modelo destilado de otro se sigue borrando, con Kimi K3 y el caso del sitio gubernamental de EE.UU. como los dos ejemplos más concretos. Si tu equipo todavía elige proveedor de IA mirando solo el ranking de benchmarks, este es el momento de cambiar el criterio.
Fuentes
- Resumen semanal de IA 11-18 de septiembre 2026 (dev.to)
- SiliconANGLE – cobertura del lanzamiento de DeepSeek V4.1-Flash
- Bloomberg – colaboración de OpenAI, Anthropic y Google en seguridad de IA
- Tom’s Hardware – investigación sobre chips de Nvidia desviados a China
- Blog oficial de Google – lanzamiento de Gemini 3.8 Live