
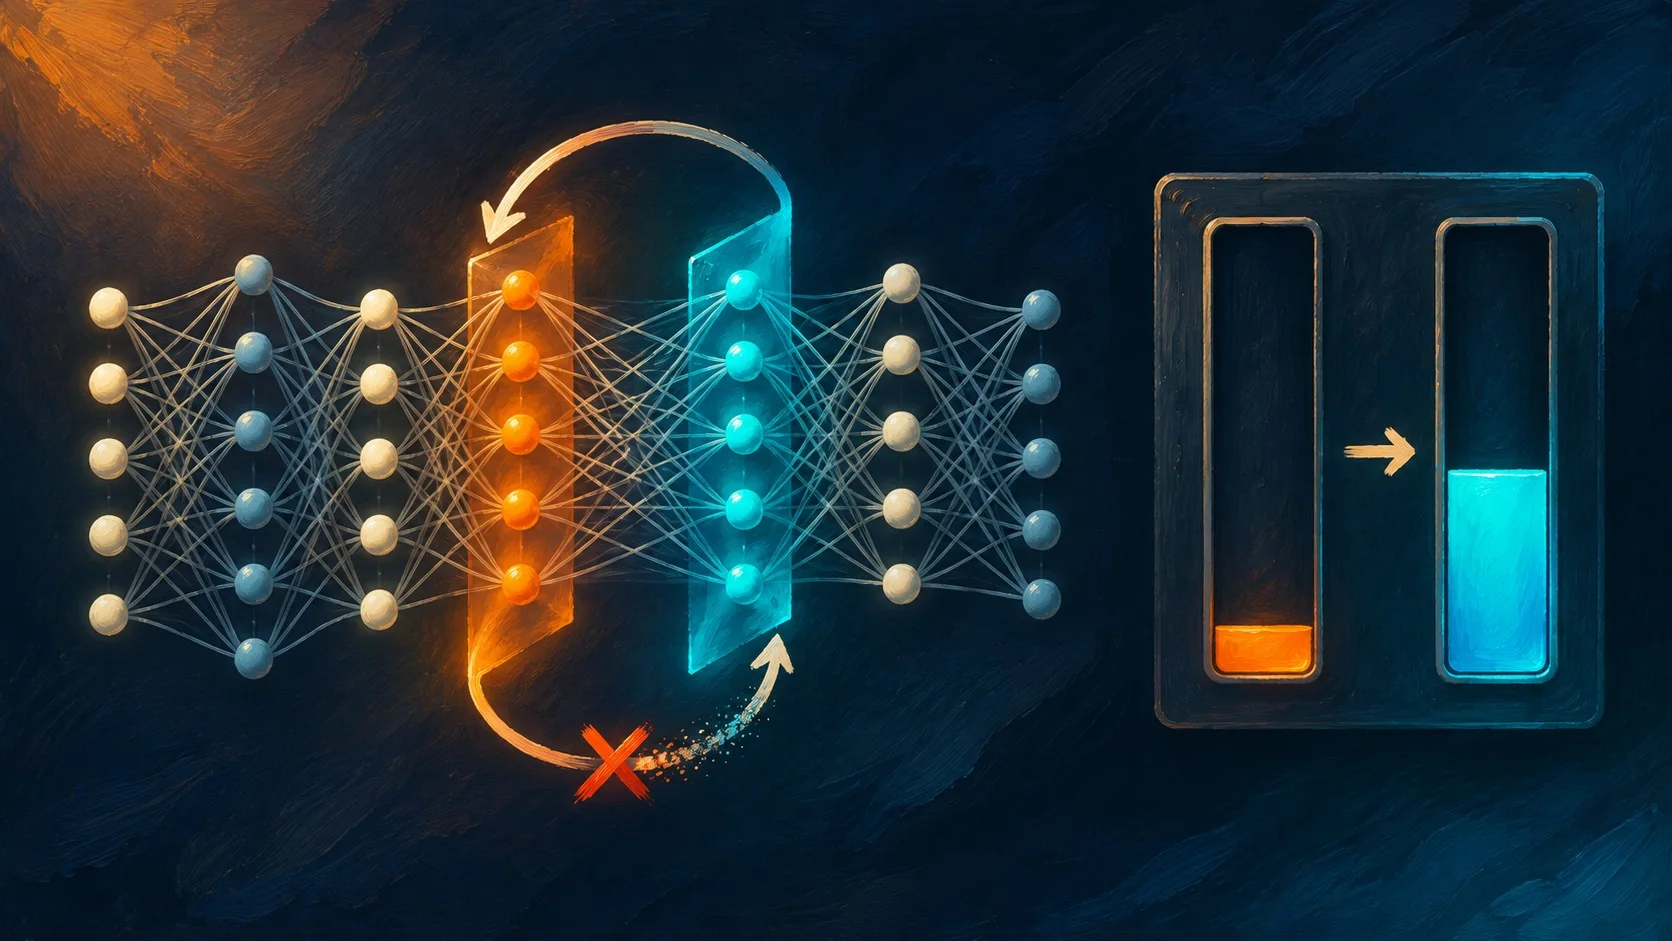
En pocas palabras: El 2 de noviembre de 2026, investigadores del MIT CSAIL lograron que GPT-6 Astra editara solo 131.072 pesos (0.016%) de Qwen3.5-0.8B, sin entrenamiento, eliminando un bucle de razonamiento en las capas 15 y 19. El puntaje en MATH-500 subió de 7.9% a 48.1%.
GPT-6 Astra corrigió a Qwen3.5-0.8B editando apenas 131.072 pesos, el 0.016% del modelo, sin entrenamiento ni gradiente descendente. El 2 de noviembre de 2026, investigadores del MIT CSAIL mostraron que el puntaje en MATH-500 subió de 7.9% a 48.1% tras borrar un bucle de razonamiento en las capas 15 y 19.
La edición de pesos IA sin entrenamiento (weight-space programming) es una técnica en la que un modelo de lenguaje general lee y modifica directamente los parámetros de otra red neuronal, sin gradiente descendente ni bucles de entrenamiento, guiado solo por un objetivo en lenguaje natural. El término aparece en el paper Sparks of Weight-Space Programming, de Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab (MIT CSAIL, 2 de noviembre de 2026).
En este artículo:
- En 30 segundos
- ¿Qué es la programación en el espacio de pesos (weight-space programming)?
- ¿Por qué Qwen3.5-0.8B fallaba en matemática antes de la edición?
- ¿Cómo encontró y corrigió GPT-6 Astra el error en los pesos?
- ¿Qué resultados muestran las pruebas de MATH-500, GSM8K e IFEval?
- ¿Qué límites tiene esta técnica de edición de pesos?
- ¿Cómo se puede comprobar el modelo editado de Qwen3.5-0.8B?
- ¿Qué implica este experimento para el futuro de los modelos pequeños de IA?
- Qué está confirmado y qué no
- Errores comunes al interpretar este experimento
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- GPT-6 Astra editó 131.072 pesos de Qwen3.5-0.8B (0.016% del modelo) sin entrenamiento, con un presupuesto de hasta 50 forward passes.
- MATH-500 pasó de 7.9% a 48.1%, GSM8K de 13.8% a 67.1% e IFEval de 21.0% a 62.3%.
- El problema real era un bucle de pensamiento: 93.0% de las respuestas de la base agotaban el límite de 32.768 tokens.
- El modelo editado está publicado en Hugging Face como RikiyaT/Qwen3.5-0.8B-weight-space-programming, con hashes sha256 verificables.
- En un control con Gemma 3 270M, la misma técnica solo movió el MATH-500 de 6.8% a 7.7%.
¿Qué es la programación en el espacio de pesos (weight-space programming)?
La programación en el espacio de pesos es un método donde un LLM de propósito general edita directamente los pesos de otra red neuronal, sin entrenamiento, guiado por un objetivo en lenguaje llano. El concepto lo acuñaron Takehi, Teoh, Zhang y Khattab en el paper Sparks of Weight-Space Programming, publicado por el MIT CSAIL.
En vez de entrenar con gradiente descendente, el modelo razona sobre qué calcula cada parte de la red y cambia los números a mano, como quien edita código fuente. Los propios autores llaman a sus resultados “muy iniciales” y aclaran que varios salieron de una sola corrida o de unas pocas.
¿Suena raro? Un poco. Pero funcionó, al menos en este caso puntual.
El paper describe ocho experimentos distintos. El que generó más ruido es el 8, donde Astra lee los pesos de Qwen3.5-0.8B, encuentra un error concreto y lo corrige sin tocar nada más.
¿Por qué Qwen3.5-0.8B fallaba en matemática antes de la edición?
Qwen3.5-0.8B fallaba porque quedaba atrapado en bucles de razonamiento que nunca llegaban a una respuesta: 85 de las primeras 96 contestaciones de práctica agotaban el límite de 32.768 tokens sin resolver el problema. La propia model card de Qwen ya advertía que el modelo es propenso a este tipo de bucle de pensamiento. Si te interesa cómo funcionan estos modelos de razonamiento por dentro, hay un repaso más general en esta guía sobre cómo funciona ChatGPT.
Ejemplo hipotético (no documentado en el paper, solo para ilustrar el mecanismo): imaginá que le pedís a la versión base de Qwen3.5-0.8B que resuelva una ecuación simple. El modelo arranca bien, encara el razonamiento paso a paso, pero en algún punto empieza a repetir el mismo argumento con otras palabras, lo reformula, lo vuelve a intentar, y así sigue hasta quedarse sin tokens, sin llegar nunca al \boxed{} final. Esa es, en esencia, la falla que el paper mide con el dato del 93% de respuestas que chocan contra el tope.
Con la base, el MATH-500 daba 7.9%, el GSM8K 13.8% y el IFEval 21.0%. El 93.0% de las respuestas en MATH-500 chocaban contra el tope de tokens. No era un problema de conocimiento matemático: era un modelo que no terminaba de pensar.
¿Cómo encontró y corrigió GPT-6 Astra el error en los pesos?
Astra trabajó en una sesión de Python sin GPU, con los pesos crudos de Qwen3.5-0.8B cargados y un presupuesto de 10, 25 o 50 forward passes sobre problemas de práctica de GSM8K (7.469 preguntas) y MATH (7.275 preguntas), sin ver nunca el set de test.
Astra rastreó el bucle hasta una sola dirección que escribían las MLP de las capas 15 y 19, y la restó de 64 columnas de salida de down_proj en cada capa. Eso tocó 131.072 pesos sobre los 800 millones del modelo, el 0.016% del total. Vale la aclaración: no es una poda ni un ajuste fino disimulado, es restar un vector de dos matrices puntuales. Quien quiera repasar qué es un GPT en términos generales antes de seguir con los detalles de capas y MLP puede revisar esta introducción a los modelos GPT.
Según la tarjeta del modelo en Hugging Face, los únicos tensores que cambian respecto al checkpoint base Qwen/Qwen3.5-0.8B son esos dos down_proj, y cada uno está verificado con sha256 contra el checkpoint evaluado en el paper.
Nada de reentrenar. Solo restar un vector, dos veces.
¿Qué resultados muestran las pruebas de MATH-500, GSM8K e IFEval?
Con 50 forward passes, MATH-500 subió de 7.9% a 48.1%, GSM8K de 13.8% a 67.1% e IFEval de 21.0% a 62.3%, mientras el porcentaje de respuestas que agotaban el límite de tokens cayó de 93.0% a 33.1%, según el paper del MIT CSAIL.
| Versión | MATH-500 | GSM8K | IFEval | Tope de tokens |
|---|---|---|---|---|
| Base | 7.9% | 13.8% | 21.0% | 93.0% |
| Editado, 10 forward passes | 12.3% | 25.7% | 49.0% | 87.2% |
| Editado, 25 forward passes | 14.1% | 25.1% | 39.9% | 86.4% |
| Editado, 50 forward passes | 48.1% | 67.1% | 62.3% | 33.1% |
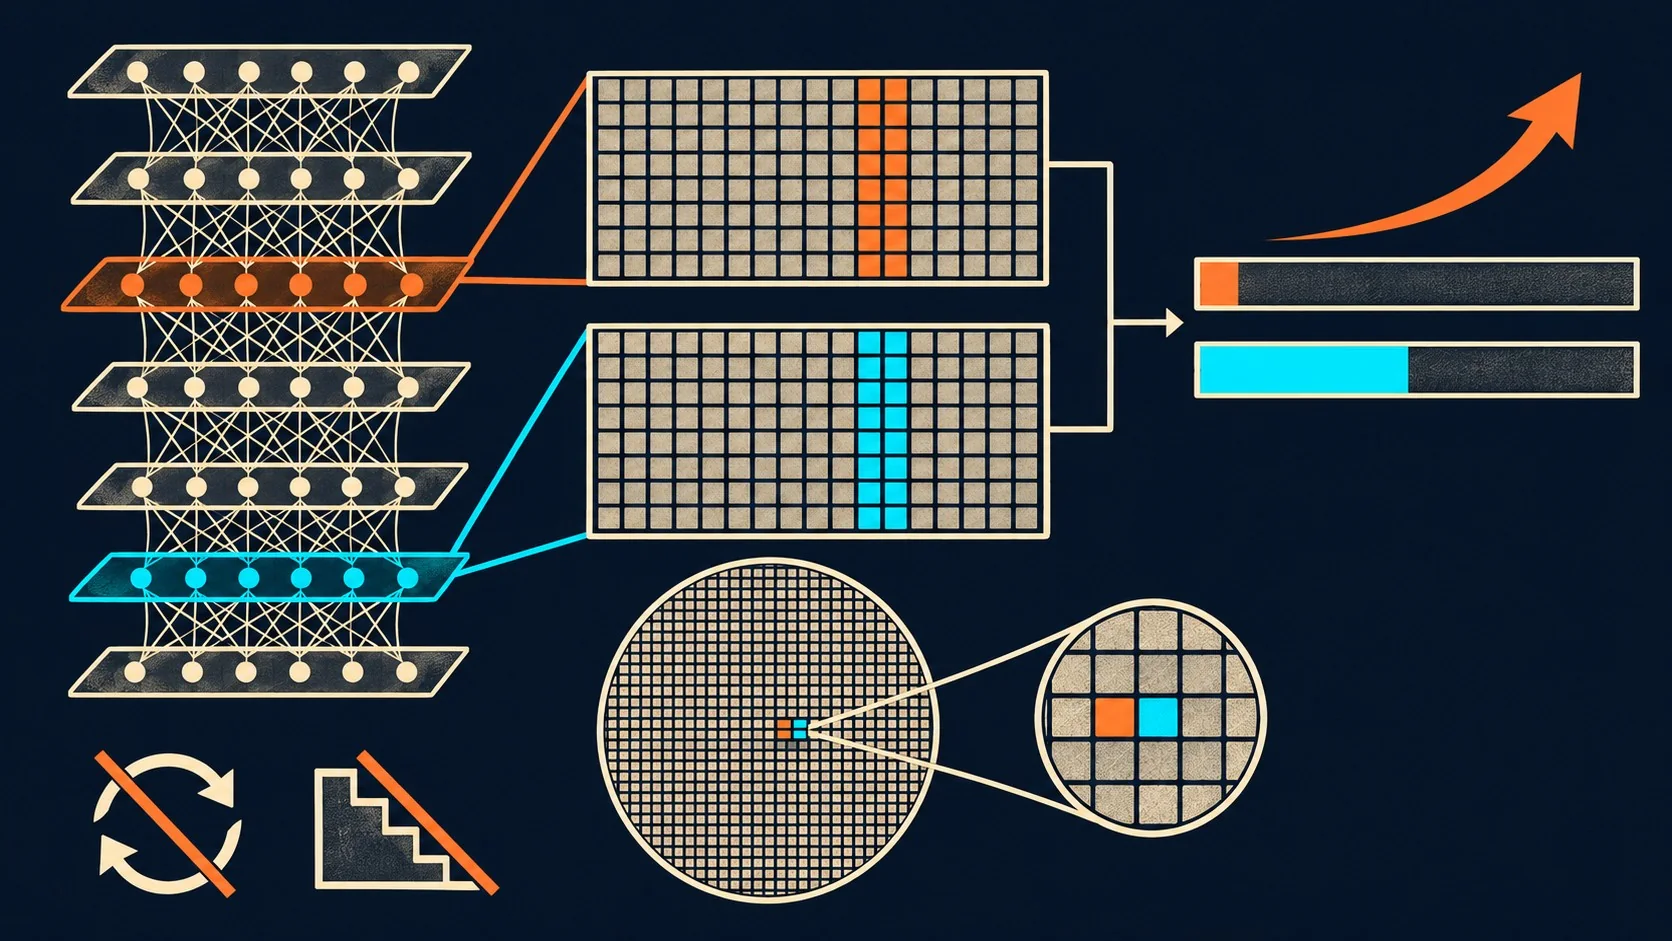
El presupuesto importó. Con 10 o 25 forward passes el bucle casi no se resolvía, y hizo falta llegar a 50 pasadas para que el salto fuera real. Esto sugiere algo que el paper no subraya pero que se desprende de los propios números: la ganancia no fue lineal con el presupuesto, apareció recién en el tercer tramo.
Ahsen Khaliq, de Hugging Face, reconstruyó el checkpoint desde los logs y corrió el MATH-500 completo (500 problemas, 4 muestras cada uno). El resultado fue 51.0%, con 31.6% de respuestas tocando el límite, contra un 5.0% en una prueba de humo de 25 preguntas con la base, según se detalla en la tarjeta del modelo editado.
¿Qué límites tiene esta técnica de edición de pesos?
La técnica no agrega matemática nueva, solo destraba la que el modelo ya tenía. Los autores probaron el mismo método en Gemma 3 270M, un modelo que casi no sufre bucles (8.5% de respuestas tocaba el tope, contra 93% en Qwen), y el mejor editado apenas movió el MATH-500 de 6.8% a 7.7% con 25 forward passes.
Gemma se equivocaba por errores de cálculo comunes, no por quedarse trabado. No había un solo “interruptor” que apagar. La conclusión de los propios investigadores es directa: el edit puede sacar un obstáculo que tapaba una habilidad, pero no puede inventar una habilidad que el modelo no tiene.
¿Esto es el fin del entrenamiento tradicional? No. Es encontrar una falla puntual, localizada en dos capas, y sacarla.
¿Cómo se puede comprobar el modelo editado de Qwen3.5-0.8B?
El modelo editado está disponible en Hugging Face como RikiyaT/Qwen3.5-0.8B-weight-space-programming, bajo licencia Apache 2.0, con los hashes sha256 de los dos tensores modificados publicados en la tarjeta del modelo.
- Probá la demo sin código: el Space
akhaliq/weight-space-programming-demodeja ingresar un problema y ver la respuesta de la base y la editada lado a lado. - Levantá los dos checkpoints con vLLM:
vllm serve Qwen/Qwen3.5-0.8Ben un puerto yvllm serve RikiyaT/Qwen3.5-0.8B-weight-space-programmingen otro, ambos con--max-model-len 34816. - Usá los parámetros de muestreo del paper: temperatura 0.6, top_p 0.95, top_k 20, presence_penalty 1.5 y hasta 32.768 tokens, con
enable_thinkingactivado. - Mirá el
finish_reason: si vuelvelengthen vez destop, esa respuesta entró en bucle.
Más allá de replicar el experimento, sirve tener un criterio propio para no quedarse solo con el titular del 48.1%. Tres preguntas razonables antes de confiar en un reporte de este tipo:
- ¿Separa accuracy de tasa de corte por tope de tokens? Si un informe solo muestra el puntaje final, no hay forma de saber si la mejora vino de razonar mejor o de simplemente dejar de trabarse, que es justo lo que pasó aquí.
- ¿Hay un experimento de control que muestre dónde la técnica no funciona? El propio paper incluye el caso de Gemma 3 270M, donde la edición casi no movió la aguja. Un reporte sin ningún control negativo es más difícil de evaluar.
- ¿El checkpoint se publica con alguna forma de verificación? Acá los tensores modificados tienen hash sha256 público, lo que permite confirmar que el modelo que se está probando es el mismo que se evaluó, y no otra versión.
¿Qué implica este experimento para el futuro de los modelos pequeños de IA?
Para equipos que liberan modelos chicos, la lectura práctica es medir el finish_reason además del accuracy, porque un puntaje bajo puede estar escondiendo un modelo que simplemente no termina de responder, como pasaba con el 93.0% de Qwen3.5-0.8B tocando el tope.
Buscar fallas de causa única localizadas en pocas capas parece un camino más barato que reentrenar, al menos para este tipo de problema puntual. El experimento de control con Gemma 3 270M deja claro que esto no reemplaza el entrenamiento: funciona cuando hay un obstáculo concreto para remover, no cuando falta capacidad.
Qué está confirmado y qué no
Confirmado: las cifras del paper del MIT CSAIL, la reproducción independiente de Ahsen Khaliq con el checkpoint rebuilt (51.0% en MATH-500 completo) y la publicación del modelo editado con hashes verificables en Hugging Face.
No confirmado: si la técnica escala a modelos de varios miles de millones de parámetros, si funciona fuera de matemática e instrucción, y cuánto cómputo humano o de Astra tomó todo el proceso de diagnóstico. Los autores no detallan ese costo total y califican todo el trabajo como “muy inicial”.
Errores comunes al interpretar este experimento
- Confundirlo con fine-tuning disfrazado: no hubo gradiente descendente ni bucle de entrenamiento en ningún momento, Astra restó un vector dos veces y nada más.
- Asumir que funciona en cualquier modelo: en Gemma 3 270M, que no tenía el mismo bucle, el mejor editado apenas movió el MATH-500 un punto.
- Mirar solo el número final de MATH-500: la mejora real está en que el modelo dejó de agotar tokens sin responder, no en que aprendió matemática nueva.
- Tratar el experimento 8 como todo el paper: hay ocho experimentos, varios en redes mucho más chicas como políticas de juego o modelos de difusión.
Preguntas Frecuentes
¿Qué es la programación en el espacio de pesos (weight-space programming)?
Es una técnica donde un LLM general lee y edita directamente los pesos de otra red neuronal, sin gradiente descendente ni entrenamiento, guiado por un objetivo en lenguaje natural. El término lo definieron Takehi, Teoh, Zhang y Khattab en el paper del MIT CSAIL publicado el 2 de noviembre de 2026.
¿Cómo editó GPT-6 Astra los pesos de Qwen3.5-0.8B?
Astra trabajó en una sesión de Python sin GPU, rastreó un bucle de razonamiento hasta una dirección escrita por las MLP de las capas 15 y 19, y restó esa dirección de 64 columnas de salida de down_proj en cada una de esas dos capas.
¿Cuántos pesos cambió GPT-6 Astra para mejorar a Qwen3.5-0.8B?
Cambió 131.072 pesos, el 0.016% de los 800 millones de parámetros del modelo. Solo dos tensores difieren del checkpoint base, ambos verificados con hash sha256 en la tarjeta del modelo de Hugging Face.
¿Se puede probar el modelo editado de Qwen3.5-0.8B?
Sí, está publicado en Hugging Face como RikiyaT/Qwen3.5-0.8B-weight-space-programming bajo Apache 2.0, con una demo pública donde se ingresan problemas y se comparan las respuestas de la base y la editada en vivo.
¿Funciona esta técnica de edición de pesos en cualquier modelo de IA?
No necesariamente. En el experimento de control con Gemma 3 270M, que casi no sufría bucles de razonamiento, la misma edición solo movió el MATH-500 de 6.8% a 7.7%, lo que muestra que la técnica destraba fallas puntuales existentes, no agrega capacidades nuevas.
Conclusión
Lo que publicó el MIT CSAIL el 2 de noviembre de 2026 no es un modelo nuevo ni un método de entrenamiento mejor. Es un diagnóstico puntual (un bucle en dos capas de Qwen3.5-0.8B) y una corrección quirúrgica de 131.072 pesos que lo levantó de 7.9% a 48.1% en MATH-500 sin tocar el resto del modelo.
Para quien libera modelos chicos, la lección aplicable hoy es simple: medí la tasa de respuestas que agotan el límite de tokens, no solo el accuracy final, y si vas a confiar en un reporte de mejora, pedí el checkpoint editado con hashes verificables como hizo este equipo. El resto, si esto escala a modelos grandes o a otros dominios, sigue abierto.
Fuentes
- Sparks of Weight-Space Programming – paper original de Takehi, Teoh, Zhang y Khattab, MIT CSAIL (2 de noviembre de 2026)
- RikiyaT/Qwen3.5-0.8B-weight-space-programming – modelo editado, tarjeta con hashes sha256 y reproducción independiente en Hugging Face
- Cómo GPT-6 Astra corrigió a Qwen3.5-0.8B editando el 0.016% de sus pesos – análisis técnico y guía de reproducción