
En pocas palabras: Google DeepMind lanzó el 6 de octubre de 2026 EmbeddingGemma 2, un modelo abierto de 740 millones de parámetros que unifica texto, código, imágenes, video y audio en un espacio vectorial compartido de 768 dimensiones, disponible bajo licencia Apache 2.0 en Hugging Face.
Google DeepMind lanzó hoy EmbeddingGemma 2, un modelo de embeddings multimodales de 740 millones de parámetros que mapea texto, código, imágenes, video y audio en un mismo espacio vectorial de 768 dimensiones, bajo licencia Apache 2.0. El anuncio oficial de Google lo presenta como el modelo más capaz de su tamaño para embeddings multimodales on-device.
En este artículo:
- En 30 segundos
- ¿Qué es un embedding multimodal y qué resuelve EmbeddingGemma 2?
- ¿Qué especificaciones técnicas tiene EmbeddingGemma 2?
- ¿Cuánta RAM necesita y en qué dispositivos corre on-device?
- ¿Cómo mejora EmbeddingGemma 2 respecto a EmbeddingGemma 1?
- ¿Dónde se descarga EmbeddingGemma 2 y qué herramientas lo soportan?
- ¿Qué implica la licencia Apache 2.0 para desarrolladores?
- Qué significa para equipos en Latinoamérica
- Errores comunes al implementar EmbeddingGemma 2
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
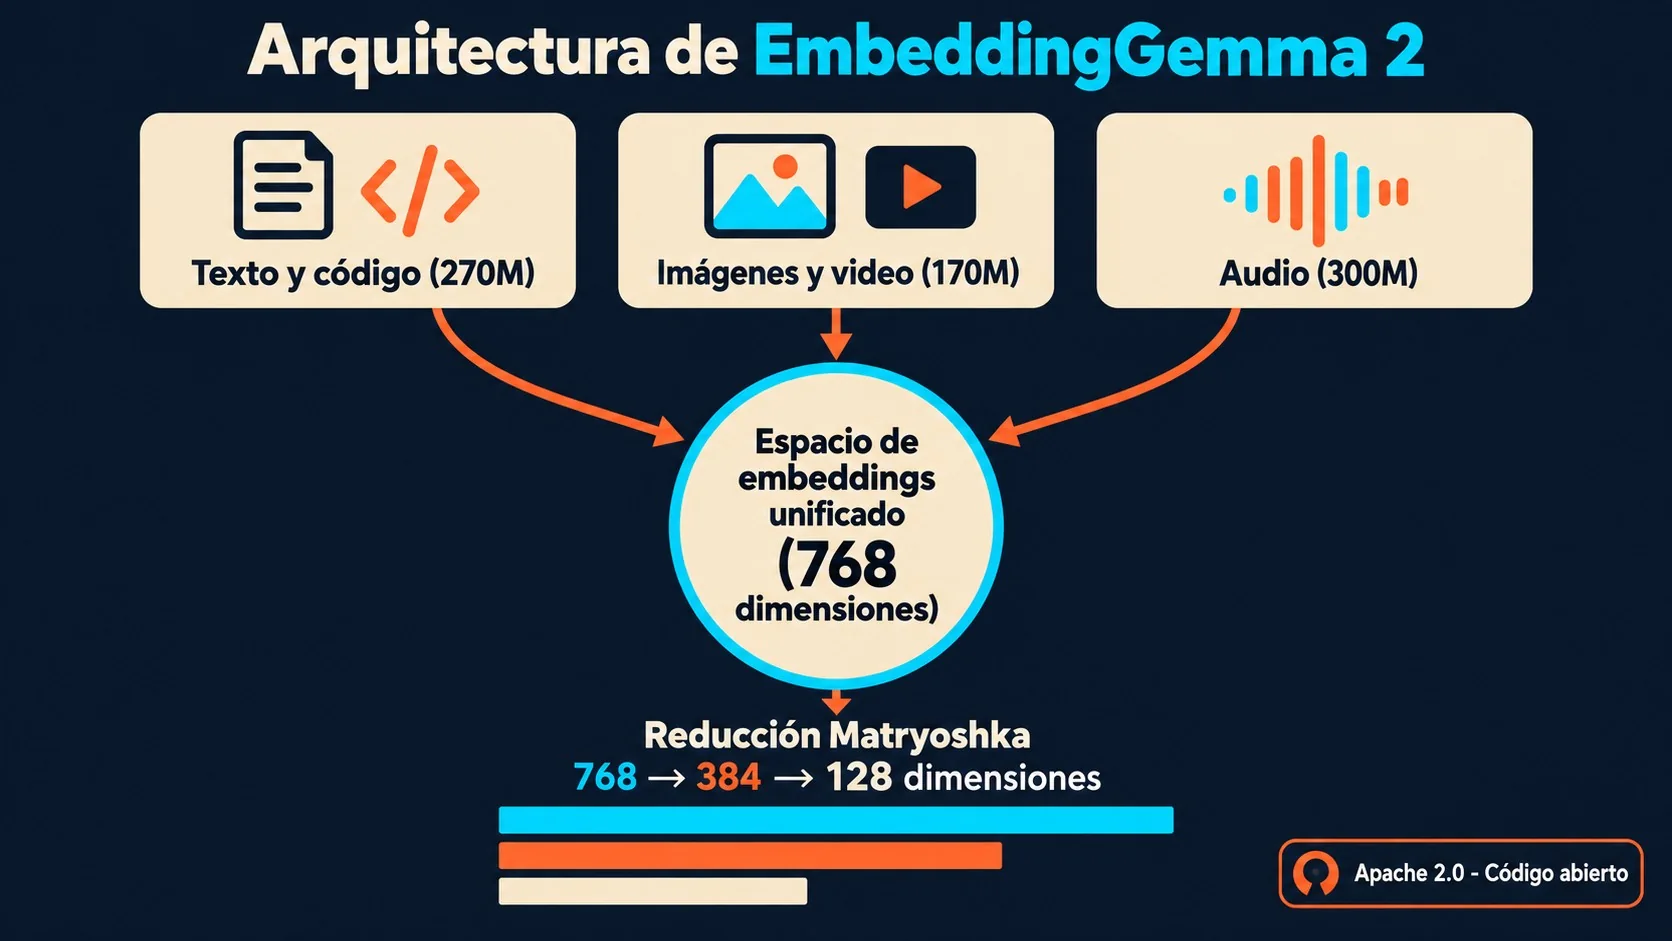
- EmbeddingGemma 2 tiene 740M de parámetros totales: 270M de texto, 170M de visión y 300M de audio, modulares e independientes.
- Mapea texto, código, imágenes, video y audio en un espacio compartido de 768 dimensiones, con Matryoshka Representation Learning para truncar a 512, 256 o 128d.
- En MTEB Code pasó de 68.76 a 78.68 puntos frente a EmbeddingGemma 1, una mejora cercana al 14%.
- Corre on-device con apenas ~191MB de RAM activa en modo solo texto y ~567MB en modo multimodal completo en un Google Pixel 11 Pro.
- Se descarga gratis en Hugging Face bajo Apache 2.0, con soporte en sentence-transformers, vLLM, SGLang, MLX, Ollama, LM Studio y LiteRT.
EmbeddingGemma 2 es un modelo abierto de embeddings desarrollado por Google DeepMind, construido sobre la arquitectura de Gemma 4, que convierte texto, código, imágenes, clips de video y grabaciones de audio en vectores numéricos comparables dentro de un mismo espacio de 768 dimensiones. Está pensado para correr localmente en celulares y laptops, sin depender de una API en la nube para calcular búsquedas semánticas.
¿Qué es un embedding multimodal y qué resuelve EmbeddingGemma 2?
Un embedding multimodal es un vector numérico que representa el significado de un contenido, sea texto, imagen, audio o video, de forma que dos cosas semánticamente parecidas queden cerca en ese espacio matemático aunque vengan de formatos distintos. EmbeddingGemma 2 resuelve el problema de tener que encadenar varios modelos (uno para describir imágenes, otro para transcribir audio, otro para embeber texto) con una sola pasada que proyecta las cinco modalidades al mismo espacio vectorial de 768 dimensiones.
Ponele que tenés una app de fotos y querés que el usuario busque “perro corriendo en la playa al atardecer” y le aparezcan tanto fotos como videos que calcen con esa descripción, aunque nadie le haya puesto ese texto como título. Antes, para armar algo así en el teléfono, tenías que correr un modelo de captioning, después un modelo de speech-to-text si había audio, y recién ahí un modelo de embeddings de texto para comparar todo. Cada salto agrega latencia, consume batería y multiplica el espacio en disco que ocupan los modelos.
Con EmbeddingGemma 2 esa cadena se corta. El modelo toma la imagen o el video directamente y devuelve un vector de 768 dimensiones que ya es comparable contra el vector de la query de texto, sin pasos intermedios. Según el equipo de Google AI Edge, esto “reduce la latencia y el overhead de memoria de encadenar modelos separados de captioning, speech-to-text y embeddings de texto”.
¿Qué especificaciones técnicas tiene EmbeddingGemma 2?
EmbeddingGemma 2 tiene 740 millones de parámetros totales, divididos en un backbone de texto de 270M (130M de transformer más 140M de embedder) y dos encoders modulares opcionales: visión de 170M y audio de 300M, según el model card oficial de Google AI.
La arquitectura interna tiene 24 capas, dimensión de modelo de 512, dimensión oculta de 2048, una ventana deslizante (sliding window) de 1024 tokens y un vocabulario de 262.144 tokens. Usa atención GQA/MQA con 4 heads y 2/1 KV-heads en proporción local a global de 5:1. La ventana de contexto total es de 8.192 tokens compartidos entre todas las modalidades, lo que alcanza para procesar minutos enteros de audio o video en una sola llamada. Relacionado: todo lo que necesitás saber sobre Google.
Cada modalidad consume ese presupuesto de tokens a una tasa fija. Así se reparte:
- Texto: 1 token por subpalabra, hasta 8.192 tokens en total.
- Imagen: 280 tokens por imagen con el presupuesto por defecto, lo que permite hasta ~29 imágenes en una sola entrada.
- Video: 140 tokens por frame, hasta ~58 frames (muestreados a 1 frame por segundo por defecto).
- Audio: 25 tokens por segundo, hasta ~327 segundos (poco más de 5 minutos) de audio mono a 16 kHz.
Lo interesante es que con Matryoshka Representation Learning (MRL) el vector nativo de 768 dimensiones se puede truncar a 512, 256 o 128 dimensiones y renormalizar, lo que según el model card permite “una reducción de hasta 6x en costos de almacenamiento de vectores con impacto mínimo en la calidad”. Eso sí: hay que acordarse de renormalizar el vector después de truncarlo, porque recortar un vector unitario no preserva esa propiedad, y si te olvidás el buscador sigue devolviendo resultados plausibles pero degradados, sin tirar ningún error.
¿Cuánta RAM necesita y en qué dispositivos corre on-device?
EmbeddingGemma 2 necesita apenas ~191MB de RAM activa para los pesos cuantizados en modo solo texto, y ~567MB para la versión multimodal completa corriendo en un Google Pixel 11 Pro, según cifras publicadas en el blog de desarrolladores de Google.
Esa huella modular es la gracia del diseño. Vos cargás solo los encoders que tu app necesita: texto solo en 270M de parámetros, texto más imagen en 440M, texto más audio en 570M, o el paquete completo en 740M. Si arrancás con un índice de solo texto y después querés sumar fotos, no hace falta recalcular nada de lo que ya tenías embebido, simplemente cargás el encoder de visión y seguís sumando vectores al mismo espacio compartido.
¿Y qué tan rápido corre esto en hardware real? En una MacBook M5 Pro con GPU, el embedding visual tarda apenas 37.3 milisegundos por imagen, lo que equivale a 26.9 imágenes por segundo, según mediciones de Google AI Edge. Eso es lo que hace posible la búsqueda “search-as-you-type” en la app Google AI Edge Gallery, donde escribís “Katze” (gato en alemán) y la grilla de fotos se actualiza en vivo con cada letra que tipeás. Para llegar a esos números, Google aplicó Quantization-Aware Training (QAT) que comprime los pesos a INT4 e INT8, además de escalado adaptativo de input y output según el tamaño del texto o imagen que entra.
¿Cómo mejora EmbeddingGemma 2 respecto a EmbeddingGemma 1?
EmbeddingGemma 2 saca 78.68 puntos en MTEB Code (NDCG@10) contra 68.76 de EmbeddingGemma 1, una mejora de casi 10 puntos que el model card oficial redondea en “~14% de mejora en tareas de código respecto a su predecesor”. En MTEB multilingüe (v2) la mejora es más chica pero consistente: 61.36 contra 61.15. Sobre eso hablamos en cómo prepararse para los AI Overviews de Google.
Para contexto: EmbeddingGemma 1 fue el primer modelo de embeddings compacto de Google pensado para dispositivos, pero solo cubría texto. No tenía soporte nativo para imágenes, video ni audio, así que cualquier comparación directa en esas modalidades es imposible porque simplemente no existían esos benchmarks para la primera versión (de ahí los guiones en la tabla de abajo).
Acá va la comparación completa con los números que publicó Google en el model card de EmbeddingGemma 2:
| Benchmark | EmbeddingGemma 1 | EmbeddingGemma 2 |
|---|---|---|
| MTEB multilingüe v2 (Mean Task) | 61.15 | 61.36 |
| MTEB Code v1 (NDCG@10) | 68.76 | 78.68 |
| MIEB lite – imágenes (Mean TaskType) | No disponible | 64.64 |
| MMEB v2 – imágenes (Hit@1) | No disponible | 57.28 |
| MMEB v2 – video (Hit@1) | No disponible | 50.67 |
| MSEB Retrieval – audio (MRR@10) | No disponible | 69.54 |
| Parámetros totales | No especificado en esta fuente | 740M |
| Modalidades soportadas | Texto | Texto, código, imagen, video, audio |
El dato que más me llama la atención es el salto en código. Si alguna vez armaste un buscador semántico sobre un repositorio propio, sabés que los embeddings genéricos de texto suelen patinar con sintaxis de programación, porque confunden estructura con prosa. Que Google haya empujado específicamente ese número sugiere que están apuntando directo a casos de búsqueda de código agéntica, algo que confirma el developer guide oficial con un ejemplo donde embeben el repositorio completo de Hugging Face Transformers usando solo el setup de texto de 270M.
¿Dónde se descarga EmbeddingGemma 2 y qué herramientas lo soportan?
EmbeddingGemma 2 está disponible para descarga gratuita en Hugging Face desde hoy, 6 de octubre de 2026, bajo licencia Apache 2.0, según confirma el developer guide de Google. También hay un repositorio en GitHub con ejemplos de implementación.
Para correrlo, Google documenta soporte oficial en estas herramientas:
- sentence-transformers (v6.1.0 o posterior): la vía más directa, con soporte nativo para texto, imagen, audio y video con una sola línea de instalación (
pip install -U sentence-transformers[image,audio,video] transformers). - vLLM y SGLang: para servir el modelo en producción con throughput alto.
- MLX: para correrlo nativo en Apple Silicon.
- Ollama y LM Studio: para probarlo rápido en local sin escribir código.
- LiteRT: el motor que usan ML Kit, MediaPipe Tasks, Google AI Edge Gallery y Foresight, con un único archivo
.litertlmque corre tanto en CPU como en GPU en todas las plataformas soportadas.
Google también anunció que en las próximas semanas va a integrar el modelo en ML Kit para Android con aceleración por NPU cuando el hardware lo soporte, según el mismo blog post. Si tu plan es montar el backend de búsqueda semántica del lado del servidor en vez de on-device (por ejemplo para indexar catálogos grandes de e-commerce), vas a necesitar un servidor o VPS con suficiente memoria para la base vectorial y el modelo cargado, ahí entra en juego elegir bien el hosting; para equipos en Argentina y la región, donweb.com ofrece instancias cloud que aguantan ese tipo de carga sin complicarte con infraestructura propia.
¿Qué implica la licencia Apache 2.0 para desarrolladores?
Apache 2.0 es una licencia de código abierto permisiva que te deja usar, modificar y distribuir EmbeddingGemma 2 en productos comerciales sin pagar regalías ni pedir permiso a Google. También te permite modificar los pesos del modelo (fine-tuning) y redistribuir esa versión modificada, siempre que mantengas el aviso de copyright original.
En la práctica, esto significa que un equipo chico puede meter búsqueda semántica multimodal en su app sin pagar por tokens de una API externa cada vez que un usuario hace una búsqueda. ¿La diferencia con depender de un servicio en la nube tipo OpenAI embeddings o Cohere? Que corrés todo local, no mandás los datos del usuario a ningún servidor externo, y no te llega una factura mensual que escala con el tráfico. El costo pasa a ser el de fine-tunear o adaptar el modelo (si hace falta), para lo cual Google recomienda Unsloth como vía rápida de experimentación.
Ojo con esto: Apache 2.0 no te obliga a abrir tu propio código ni tus pesos fine-tuneados, a diferencia de licencias copyleft como GPL. Es la razón por la que la mayoría de los modelos abiertos serios de los últimos años (Llama, Gemma, Mistral) eligieron variantes permisivas parecidas, para que las empresas no tengan miedo legal de meterlos en producto comercial. Esto se conecta con lo que analizamos en el nuevo IDE con IA de Google.
Qué significa para equipos en Latinoamérica
Para un equipo de desarrollo en Argentina, Chile o México, EmbeddingGemma 2 resuelve un problema puntual: hacer búsqueda semántica sin pagar en dólares por cada consulta a una API en la nube, que con el tipo de cambio actual se vuelve una línea de gasto que duele. Subís el modelo a tu infraestructura, lo probás en local, funciona bárbaro, lo mandás a producción apuntando a tu catálogo de productos o tu base de documentos internos, y el costo marginal por búsqueda pasa a ser prácticamente cero porque ya no dependés de tokens facturados por terceros.
El caso de uso más directo: e-commerce con catálogos grandes de fotos de producto, donde el buscador “no encuentra lo que busco” es la queja número uno de soporte. Con EmbeddingGemma 2 corriendo del lado del servidor (o directamente en la app del usuario), la búsqueda por foto o por descripción natural deja de depender de que alguien haya etiquetado bien cada producto a mano.
Errores comunes al implementar EmbeddingGemma 2
- Usar float16 en vez de bfloat16 o float32: el model card advierte que el rango de activación de EmbeddingGemma 2 excede el rango dinámico de float16, y en esa precisión el modelo devuelve NaN o embeddings silenciosamente degradados en vez de tirar un error. bfloat16 es seguro y reduce memoria igual; usalo si tu hardware lo soporta nativo, y float32 en el resto de los casos (la mayoría de las CPU).
- Comparar vectores de distinta dimensión: una query embebida en 768d no se puede comparar contra un corpus indexado en 128d. Si truncás con MRL, truncá los dos lados por igual y renormalizá ambos.
- Olvidarte del prefijo de instrucción de tarea: EmbeddingGemma 2 se entrenó con prefijos cortos como
task: search result | query:para búsqueda otask: classification | query:para clasificación. Omitirlos no rompe nada, pero sí baja la precisión del ranking sin que te des cuenta. - Cargar los tres encoders cuando solo necesitás uno: si tu app es solo buscador de texto, cargar visión y audio desperdicia memoria sin ninguna ganancia. Usá
config_kwargspara desactivar lo que no usás desde el arranque.
Preguntas Frecuentes
¿Qué es EmbeddingGemma 2?
EmbeddingGemma 2 es un modelo abierto de embeddings multimodales de Google DeepMind, de 740 millones de parámetros, que convierte texto, código, imágenes, video y audio en vectores comparables dentro de un espacio de 768 dimensiones. Está construido sobre la arquitectura de Gemma 4 y pensado para correr on-device. Cobertura relacionada: qué pasó con los precios de Google Cloud.
¿Cuántos parámetros tiene EmbeddingGemma 2?
Tiene 740 millones de parámetros totales en su configuración completa, divididos en 270M para el backbone de texto, 170M para el encoder de visión y 300M para el encoder de audio. Podés cargar menos de esos 740M si no necesitás todas las modalidades, bajando hasta 270M en modo texto solo. Lo explicamos a fondo en la comparativa entre Google y Claude.
¿En qué se diferencia EmbeddingGemma 2 de la primera versión?
La diferencia principal es que EmbeddingGemma 1 solo manejaba texto, mientras que EmbeddingGemma 2 agrega imágenes, video y audio nativamente en el mismo espacio vectorial. En benchmarks de código mejora de 68.76 a 78.68 puntos en MTEB Code, cerca de un 14% más.
¿Dónde se puede descargar EmbeddingGemma 2?
Se descarga gratis en Hugging Face desde el 6 de octubre de 2026, con los pesos publicados bajo licencia Apache 2.0. También hay documentación e instrucciones de instalación en la guía oficial para desarrolladores de Google.
¿EmbeddingGemma 2 es de código abierto y gratis para uso comercial?
Sí, EmbeddingGemma 2 se distribuye bajo licencia Apache 2.0, que permite uso comercial, modificación y redistribución sin pagar regalías a Google. No hay restricción de uso en productos de pago ni límite de consultas, porque el modelo corre en tu propia infraestructura.
Conclusión
EmbeddingGemma 2 cierra una brecha concreta: hasta ahora, meter búsqueda semántica multimodal en una app móvil implicaba encadenar varios modelos chicos o pagarle a una API externa por cada consulta. Con 740M de parámetros modulares, Google deja arriba de la mesa un modelo que corre en un teléfono de gama media con menos de 600MB de RAM y que entiende texto, código, imágenes, video y audio en el mismo espacio vectorial.
¿Vale la pena migrar ya si tenés un pipeline de embeddings funcionando con EmbeddingGemma 1 o con una API externa? Si tu caso de uso incluye imágenes, video o audio, sí, porque la primera versión simplemente no cubría esas modalidades. Si tu caso es texto puro, la mejora es más chica (61.36 contra 61.15 en MTEB multilingüe) salvo que trabajes con código, donde el salto de casi 10 puntos en MTEB Code justifica la migración por sí solo.
Lo que viene a confirmarse en las próximas semanas es la llegada a ML Kit para Android con aceleración por NPU, que va a bajar todavía más la barrera de entrada para apps de producción. Hasta entonces, la vía más rápida para probarlo es bajar los pesos de Hugging Face y correr el quickstart con sentence-transformers.
Fuentes
- Google Developers Blog – Bring multimodal semantic search to the edge with EmbeddingGemma 2
- Google AI for Developers – EmbeddingGemma 2 model card
- Google Developers Blog – EmbeddingGemma 2: The Developer Guide
- Techmeme – Resumen de cobertura del lanzamiento de EmbeddingGemma 2
- Unite.AI – DeepMind Debuts EmbeddingGemma 2, Mapping Five Modalities Into One Space