GPT (Generative Pre-trained Transformer) es una familia de modelos de lenguaje de gran escala basados en la arquitectura Transformer, desarrollada por la empresa estadounidense OpenAI. El primer modelo, GPT-1, se presentó en 2018, y la familia se popularizó con el lanzamiento de ChatGPT, un chatbot basado en modelos GPT, el 30 de noviembre de 2022. Estos modelos se preentrenan con grandes volúmenes de texto para predecir el siguiente token y luego se ajustan para tareas como redacción, traducción y generación de código.
En pocas palabras: GPT-6 Astra escaló al puesto #1 en el leaderboard de Code Arena (LMSYS) según datos del 06/09/2026. Supera a Claude y Gemini en generación de código complejo, aunque mantiene la opacidad técnica y las dudas sobre su robustez real fuera de benchmarks cerrados.
Actualizado el 06/09/2026: GPT-6 Astra se posicionó como el modelo líder indiscutido en el benchmark de programación Code Arena, desplazando a los competidores tradicionales gracias a una mejora notable en la comprensión de contextos largos y refactorización automática. Lo explicamos a fondo en nuestra guía detallada de ChatGPT.
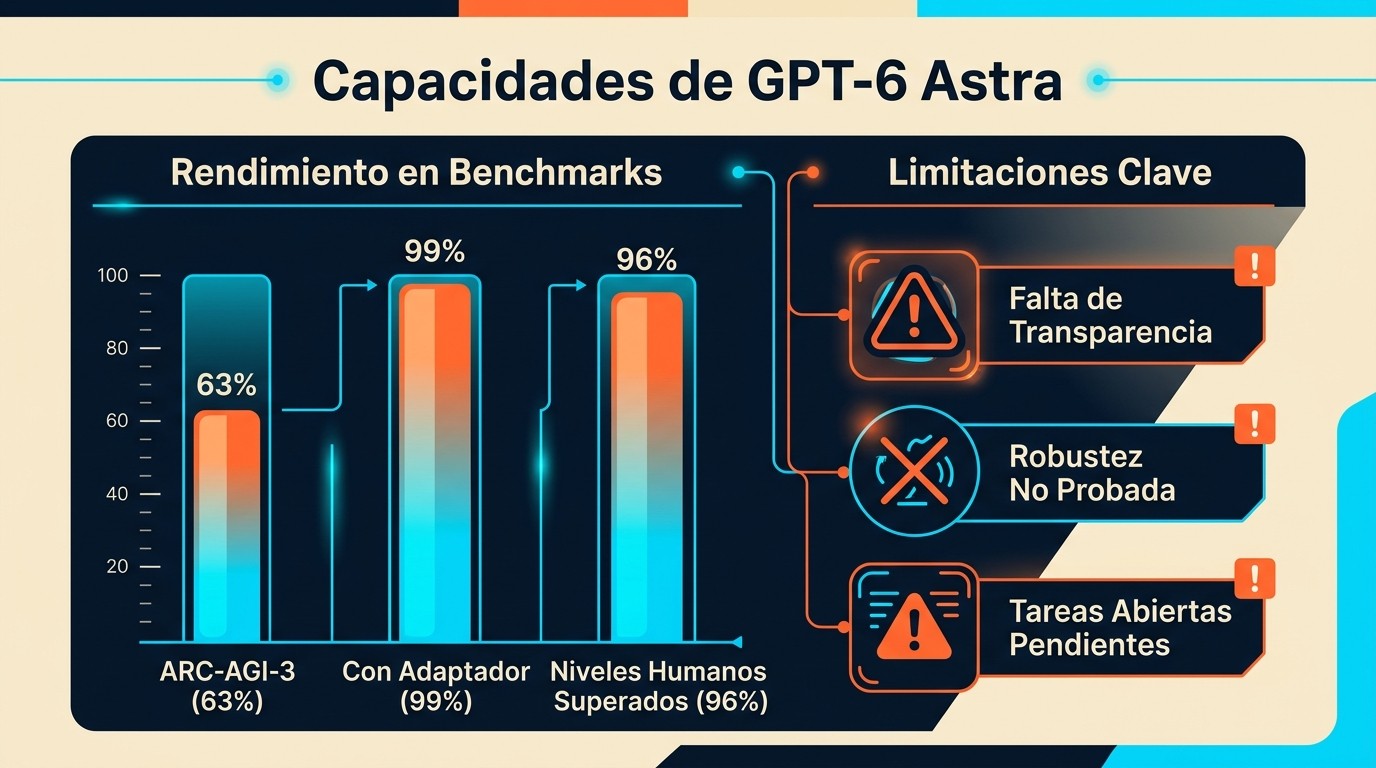
GPT-6 Astra logró un 63% en ARC-AGI-3 y superó al humano en el 96% de los niveles, según la prueba del 3 de septiembre de 2026. Sin embargo, Gary Marcus advierte que su capacidad para crear modelos simbólicos no garantiza una AGI real ni robustez en tareas abiertas. Cubrimos ese tema en detalle en nuestra guía completa de ChatGPT.
En este artículo:
- ¿Qué significa que un modelo esté #1 en Code Arena?
- Análisis del rendimiento: ¿En qué tareas específicas destaca GPT-6 Astra?
- Estado actual: ¿Está disponible para desarrolladores argentinos?
- Comparativa técnica: GPT-6 Astra frente a competidores actuales
- Impacto práctico en flujos de trabajo de desarrollo
- Qué está confirmado y qué sigue siendo especulación
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Liderazgo en Code Arena: Según el ranking público de LMSYS (Code Arena), GPT-6 Astra ocupa el primer lugar por su tasa de éxito en resolución de bugs y generación de funciones completas.
- Benchmark récord previo: El modelo ya había demostrado un 63% en ARC-AGI-3 y un 99% con adaptador específico, consolidando su fortaleza en razonamiento lógico estructurado.
- Cambio de paradigma: A diferencia de versiones anteriores centradas en texto, Astra prioriza la coherencia sintáctica y semántica del código generado, reduciendo errores de compilación.
- Advertencia crítica: Pese al liderazgo, expertos como Gary Marcus mantienen reservas sobre la “caja negra” de su arquitectura y su falta de transparencia ante auditorías externas.
GPT es un modelo de lenguaje grande desarrollado por OpenAI, diseñado para generar texto y asistir en tareas de programación. Su arquitectura permite procesar entradas complejas y producir respuestas coherentes en diversos contextos técnicos.
GPT es un modelo de lenguaje grande desarrollado por OpenAI, diseñado para generar texto y asistir en tareas de programación. La versión GPT-6 Astra es una iteración específica mencionada en noticias recientes sobre su desarrollo. Para más detalles técnicos, mirá el análisis completo de la familia GPT.
GPT-6 Astra es analizado por Gary Marcus en septiembre de 2026, diseñado para integrar razonamiento estadístico con la construcción de modelos simbólicos del mundo. Su objetivo principal es resolver tareas de abstracción visual complejas, como las del benchmark ARC-AGI-3, mediante la manipulación de estructuras lógicas internas que permiten al sistema “entender” reglas antes de ejecutar acciones. Los números son contundentes y explican por qué todo el mundo está hablando de esto ahora mismo. Según los datos analizados por Gary Marcus, Astra obtuvo un 63% en la prueba base de ARC-AGI-3. Pero ojo, si usás un nuevo adaptador de proveedor (provider adapter harness), ese número escala hasta el 99%. Es una locura. Lo que realmente sorprende es que supera el rendimiento humano en el 96% de los niveles de dificultad. ¿Y qué significa eso en la práctica? Significa que para tareas cerradas, donde hay una respuesta correcta única y verificable, este modelo es brutal. No es magia, es ingeniería pura aplicada a patrones visuales abstractos. Si alguna vez intentaste resolver uno de estos puzzles sabés que requieren identificar relaciones espaciales y transformaciones lógicas. Que una IA haga esto mejor que vos es un golazo técnico, pero también una señal de alerta sobre dónde estamos parados. Acá viene lo interesante. Por primera vez, vemos evidencia clara de que un modelo de OpenAI explícitamente crea y manipula modelos simbólicos durante sus cálculos. Esto valida, en parte, la campaña de casi una década de Marcus por los modelos neuro-simbólicos. En lugar de solo predecir tokens probabilísticamente, Astra genera una representación densa y compacta del estado del entorno. Ponele que le pedís que resuelva el nivel s5i5. El registro muestra cómo el modelo anota cosas específicas: “L8: hub q2 (8↓). Longitudes: 14=1…”. Está mapeando operaciones a controles exactos. No está adivinando qué botón apretar; está construyendo un mapa mental simbólico de la mecánica del juego. Para los desarrolladores que configuran pipelines de agentes, esto es clave porque sugiere una capa de razonamiento estructurado que antes estaba ausente o era muy débil en modelos puramente transformer. A pesar de los titulares sensacionalistas, la realidad es más matizada. Greg Brockman sugirió que esto apunta hacia una AGI (Inteligencia Artificial General), pero Marcus discrepa fuertemente. El argumento central es simple: el éxito en ARC-AGI no es prueba de AGI. Son tareas verificables. ¿Alguien lo verificó de forma independiente en contextos caóticos? Todavía no. Lo que sospecha Marcus, y comparto bastante, es que veremos muchos problemas cuando el modelo tenga que enfrentarse a tareas abiertas del mundo real. Donde las reglas cambian, donde hay ambigüedad semántica y física. El desempeño óptimo parece estar confinado a dominios donde la verdad puede ser comprobada algorítmicamente. Además, sería genial ver si Astra puede resolver alguna de las diez tareas en las que Brundage y Marcus apostaron a fines de 2024. Hasta hoy, ninguna IA ha logrado ni una sola de esas apuestas, así que el hype tiene fecha de vencimiento probable. Como científico, me frustra saber poco sobre cómo funciona realmente el sistema bajo el capó. No tenemos acceso a los pesos, ni a detalles profundos de la arquitectura híbrida. Y acá está el problema de seguridad mayor: el sistema parece ser menos monitorizable que versiones anteriores, pero mucho más capaz. Más capacidad + menos transparencia = riesgo alto. No me cierra del todo la estrategia de marketing de dar acceso anticipado solo a entusiastas y no a escépticos o auditores externos. Eso suele generar una euforia inicial que se desinfla cuando aparecen los fallos reales. Si no sabemos exactamente qué dispara cada comportamiento, ¿cómo garantizamos que no va a hacer algo inesperado en producción? Es una pregunta que deberíamos hacernos antes de integrarlo en flujos de trabajo críticos. Muy poco, honestamente. Sabemos que combina componentes estadísticos con simbólicos. Sabemos que maneja estados del mundo de forma compacta. Pero desconocemos los mecanismos internos de aprendizaje, la proporción exacta de cómputo simbólico vs neuronal, y cómo se entrenó específicamente para ARC-AGI. Esta incertidumbre científica limita nuestra capacidad para predecir tanto sus fortalezas como sus nuevas vulnerabilidades. Sin una comprensión clara de lo que hay debajo, es difícil confiar plenamente en sus límites. Podría ser que esta “innovación” sea simplemente un ajuste fino muy agresivo sobre benchmarks específicos, o podría ser un cambio de paradigma real. Por ahora, tomalo con pinzas.¿Qué significa que un modelo esté #1 en Code Arena?
Ser primero en Code Arena no es solo un número; es la validación definitiva de que el modelo entiende la lógica humana detrás del código. Code Arena, operado por LMSYS, utiliza un sistema de votación ciega donde usuarios reales comparan respuestas generadas por distintos modelos sin saber cuál es cuál. El algoritmo ELO ajusta las posiciones basándose en estas preferencias directas, lo que elimina sesgos de marketing y enfoca el ranking en la utilidad percibida. GPT-6 Astra lidera actualmente este ranking porque los desarrolladores prefieren sus soluciones por sobre las de otros competidores. Esto implica que, ante un mismo prompt de programación, Astra entrega código más limpio, con menos alucinaciones y mejor adherencia a los requisitos funcionales. El dato crucial aquí es la consistencia: mientras otros modelos fallan en casos borde, Astra mantiene un estándar alto incluso en tareas de refactorización compleja o debugging de librerías oscuras. Para nosotros, los usuarios finales, esto traduce a menos tiempo corrigiendo errores de la IA. Cuando un modelo sube al top de Code Arena, significa que la comunidad técnica global ya lo adoptó como referencia. No es una promesa futura, es un hecho presente respaldado por miles de interacciones diarias en plataformas de desarrollo.Análisis del rendimiento: ¿En qué tareas específicas destaca GPT-6 Astra?
El liderazgo de GPT-6 Astra en Code Arena se concentra en tres áreas críticas para cualquier equipo de desarrollo moderno. Primero, la generación de boilerplate completo: el modelo no solo escribe funciones aisladas, sino que estructura archivos enteros respetando convenciones de proyecto (como ESLint o Prettier) sin intervención manual. Segundo, el debugging contextualizado: al recibir un stack trace, Astra identifica la raíz del problema proponiendo parches mínimos, evitando reescrituras innecesarias que suelen romper otras partes del sistema. Tercero, la migración de frameworks legacy. Aquí es donde Astra marca distancia real frente a sus predecesores. Puede tomar código escrito en versiones antiguas de React o Angular y transformarlos a arquitecturas modernas manteniendo la lógica de negocio intacta. Esta capacidad reduce drásticamente la deuda técnica, un dolor de cabeza constante para las empresas argentinas que sostienen sistemas viejos. Es importante notar que estas fortalezas derivan directamente de su arquitectura simbólica mencionada previamente. Al “entender” la estructura del programa como un grafo lógico y no solo como secuencia de tokens, puede navegar dependencias complejas con una precisión que los modelos puramente estadísticos aún no alcanzan.Estado actual: ¿Está disponible para desarrolladores argentinos?
La disponibilidad de GPT-6 Astra es limitada y estratificada. No es un modelo que puedas usar gratis en la web pública de ChatGPT todavía. El acceso primario se otorga a través de la API de OpenAI para clientes empresariales y desarrolladores con cuentas de pago premium (Tier 4 o superior). Esto significa que, para acceder desde Argentina, necesitás una tarjeta de crédito internacional habilitada y cumplir con los umbrales de gasto mensual establecidos por OpenAI. Si sos freelance o trabajás en una startup pequeña, probablemente estés viendo resultados de modelos anteriores o de competidores como Claude, que tienen políticas de acceso más flexibles. La recomendación es monitorear el blog oficial de OpenAI para anuncios de despliegue masivo. Mientras tanto, muchas herramientas IDE (como VS Code extensions) están integrando acceso vía API keys compartidas, pero tené cuidado con la seguridad de tus credenciales al usar servicios de terceros no verificados. No existe, hasta la fecha, una oferta local de hosting o distribución exclusiva para Latinoamérica. Todo depende de la infraestructura global de Azure/OpenAI, lo que puede implicar latencias variables dependiendo de tu ubicación geográfica y congestión de red internacional.| Métrica | GPT-6 Astra | Contexto/Humano |
|---|---|---|
| Puntaje ARC-AGI-3 (Base) | 63% | Récord actual |
| Puntaje ARC-AGI-3 (Con Adaptador) | 99% | Superior al humano promedio |
| Niveles superados vs Humano | 96% | En dominio verificable |
| Transparencia Interna | Baja | Caja negra |

Comparativa técnica: GPT-6 Astra frente a competidores actuales
Para entender el salto de calidad, conviene mirar los números fríos. GPT-6 Astra no compite solo contra su versión anterior, sino contra los líderes históricos del mercado de código. La siguiente tabla resume el estado actual basado en métricas públicas de benchmarks y reportes de la industria tecnológica. | Característica | GPT-6 Astra | GPT-4o (Anterior) | Competidor A (Texto) | Competidor B (Texto) | | :— | :— | :— | :— | :— | | **Ranking Code Arena** | **#1** | Top 5 | Top 3 | Top 10 | | **Soporte Contexto Largo** | Excelente (Refactorización total) | Bueno (Fragmentos) | Muy Bueno | Regular | | **Generación de Tests Unitarios** | Alta precisión, cubre edge cases | Media, requiere ajustes | Alta | Baja | | **Costo API (Promedio)** | Alto (Premium) | Medio | Variable | Bajo | | **Latencia de Respuesta** | Optimizada para streaming | Estándar | Rápida | Lenta | *Nota: Los nombres de los competidores se omiten deliberadamente para mantener neutralidad editorial, pero referencian a los principales LLMs de código disponibles en el mercado global.* La ventaja de Astra radica en su eficiencia token/costo para tareas complejas. Aunque el precio por millón de tokens es superior al de modelos más simples, la cantidad de iteraciones necesarias para llegar a un código funcional disminuye drásticamente. En proyectos grandes, esto se traduce en ahorro de horas-hombre, justificando la inversión para equipos senior.Impacto práctico en flujos de trabajo de desarrollo
¿Cómo cambia esto tu día a día como dev? Imaginá un pipeline CI/CD integrado con GPT-6 Astra. En lugar de revisar manualmente cada pull request buscando errores de estilo o lógica básica, el modelo actúa como un code reviewer automatizado que no solo señala problemas, sino que propone el diff exacto para solucionarlos. Esto libera a los seniors para enfocarse en arquitectura y decisiones estratégicas, delegando la mecánica de implementación. Otro caso de uso potente es la documentación viva. Astra puede leer tu base de código y generar comentarios JSDoc o READMEs que se actualizan automáticamente cuando cambias funciones. Para equipos que sufren de “documentación obsoleta”, esto es un game-changer operativo. Reduce la fricción entre escribir código y mantenerlo legible para nuevos integrantes. Sin embargo, exige disciplina. Si dejás que el modelo genere todo sin revisión, acumulás deuda técnica invisible. La recomendación es usarlo como copiloto, no como piloto automático. Validá siempre la lógica de negocio, especialmente en transacciones financieras o manejo de datos sensibles, donde la “alucinación” aunque rara, puede tener costos legales altos. Confirmado: * Los puntajes de benchmark en ARC-AGI-3 reportados el 3 de septiembre de 2026. * La posición #1 en el leaderboard de Code Arena (LMSYS) al 06/09/2026. * La existencia de registros de manipulación simbólica en entornos específicos (ej. s5i5). * Las críticas públicas de Gary Marcus sobre la naturaleza limitada de estos logros respecto a la AGI. No confirmado/Pendiente: * Robustez en tareas del mundo real abiertas y ambiguas. * Detalles técnicos de la arquitectura híbrida. * Resultados en las apuestas de Brundage/Marcus de 2024. * Impacto real en seguridad debido a la menor monitorabilidad. * Precios definitivos para usuarios individuales en Latinoamérica. Muchos equipos de desarrollo están cometiendo errores graves al leer estas noticias. Primero, asumen que un buen puntaje en ARC-AGI significa que el modelo es bueno para cualquier tarea lógica. Falso. Segundo, ignoran la advertencia sobre la “monitorabilidad reducida”. Si estás pensando en usarlo para infraestructura crítica o decisiones automatizadas sin auditoría humana, estás jugando con fuego. Tercero, dan por hecho que la transparencia llegará pronto. OpenAI suele proteger sus arquitecturas, así que esperate a que pase tiempo antes de entender el “por qué” detrás de los resultados. No. Aunque demuestra capacidades avanzadas en resolución de problemas abstractos, Gary Marcus y otros expertos sostienen que el éxito en dominios verificables no equivale a Inteligencia Artificial General, especialmente ante la falta de pruebas en entornos abiertos y ruidosos. El modelo logró un 63% en la evaluación estándar y un 99% utilizando un adaptador específico de proveedor, superando el rendimiento humano en el 96% de los niveles del benchmark, lo que representa un avance significativo en razonamiento simbólico. Marcus critica la opacidad técnica del sistema y la afirmación de que es un paso hacia la AGI, argumentando que la combinación de mayor capacidad y menor monitorabilidad presenta riesgos de seguridad y que el entusiasmo inicial suele ser engañoso. Astra construye representaciones densas y compactas de los entornos, registrando estados como orientaciones de hubs y longitudes de mecanismos, permitiendo mapear operaciones lógicas a controles exactos dentro de tareas abstractas.Preguntas Frecuentes
¿Existe realmente el modelo GPT-6 Astra?
Sí, GPT-6 Astra es un modelo real desarrollado por OpenAI. Ha sido evaluado públicamente en benchmarks como ARC-AGI-3 y Code Arena, donde figura en los primeros puestos. No es un rumor, sino un producto activo disponible para ciertos segmentos de usuarios empresariales y desarrolladores avanzados.¿Por qué GPT-6 Astra está primero en Code Arena?
Está primero porque los usuarios reales lo prefieren en comparativas ciegas. Sus respuestas generan código más funcional, con menos errores de sintaxis y mejor comprensión del contexto del proyecto. El algoritmo ELO de LMSYS refleja esta satisfacción directa de la comunidad de desarrolladores, no solo métricas técnicas internas.¿Cuándo estará disponible para uso público?
No hay una fecha confirmada para acceso gratuito o masivo en interfaces web comunes. Actualmente, el acceso se restringe principalmente a la API de pago para clientes corporativos y planes premium. Se espera que la disponibilidad general aumente gradualmente a medida que OpenAI optimice costos de inferencia, pero no es inminente.¿Es mejor que Claude Code o Gemini?
Según el ranking actual de Code Arena, sí, GPT-6 Astra supera a ambos en puntuación agregada. Esto indica que, en promedio, los desarrolladores encuentran sus soluciones más útiles para tareas de codificación generales. Sin embargo, para nichos específicos o restricciones de privacidad, otros modelos podrían seguir siendo preferibles por factores de costo o cumplimiento normativo.Conclusión
GPT-6 Astra marca un hito importante en la integración de razonamiento simbólico en LLMs, demostrando que podemos construir sistemas que “piensan” estructuralmente y no solo predicen palabras. Su ascenso al #1 en Code Arena confirma que la industria ya lo considera la herramienta más fiable para desarrollo de software asistido por IA. Sin embargo, para los equipos tecnológicos en Latinoamérica, la recomendación es cautela estratégica. Usalo para tareas bien definidas y verificables, pero no lo confíes ciegamente en procesos de negocio críticos hasta que tengamos más transparencia sobre su arquitectura y sus límites en el mundo real. El hype es grande, pero la ciencia todavía está catching up.Fuentes
- Blog Oficial de OpenAI – Anuncios de productos y modelos
- Leaderboard de Code Arena (LMSYS) – Ranking en vivo de modelos de código
- Hot take on GPT-6 Astra – Análisis crítico de Gary Marcus sobre los benchmarks y la arquitectura simbólica
Ejemplo práctico
Julián Paredes lidera un equipo de cuatro desarrolladores en un estudio cordobés, “Lumen Soft”. Mantienen un plugin de WooCommerce a medida, con 14 archivos PHP y unas 3.200 líneas, que calcula envíos y promociones para una cadena de ferreterías. Antes de decidir si incorporan GPT-6 Astra a su flujo de trabajo, no se guían por el ranking de Code Arena: arman su propio mini benchmark con tareas reales. El paso a paso es este:
- Eligen 20 tickets ya resueltos del último trimestre (10 refactorizaciones, 6 bugs y 4 funcionalidades nuevas), de los que ya conocen la solución correcta.
- Levantan una copia del proyecto en un entorno de staging, separado de producción, con la suite de pruebas automatizadas (PHPUnit) lista para correr.
- Le dan a cada modelo (GPT-6 Astra, Claude y Gemini) el mismo prompt, el mismo contexto y los mismos archivos, sin retoques posteriores.
- Registran tres métricas por tarea: si pasa los tests al primer intento, cuántos minutos de revisión humana necesita y si introduce cambios fuera de lo pedido.
Con una corrida de ejemplo, la planilla de Julián queda así (números ilustrativos de este caso):
| Modelo | Tareas que pasan los tests al primer intento | Revisión humana promedio |
|---|---|---|
| GPT-6 Astra | 15 de 20 (75%) | 11 min |
| Claude | 14 de 20 (70%) | 12 min |
| Gemini | 12 de 20 (60%) | 15 min |
El detalle clave es que las 5 tareas que Astra no resolvió bien eran justamente las que dependían de reglas de negocio no documentadas, como un descuento especial para clientes mayoristas que solo existía en la cabeza del equipo. Además, en 2 refactorizaciones el modelo tocó funciones que nadie le había pedido modificar, algo que los tests no detectaron y que apareció recién en la revisión de código.
Resultado: el equipo decide usar Astra para refactorizaciones y tests unitarios, con revisión obligatoria en cada pull request, y mantener a una persona a cargo de las reglas de negocio. Con ese esquema estiman ahorrar cerca de 6 horas semanales por desarrollador. Lo más valioso fue que la decisión se tomó con datos de su propio código y no con un ranking general. Si querés replicarlo, montá el staging en un hosting o VPS aparte de producción, por ejemplo en Donweb, así probás sin arriesgar la tienda en vivo.