Un agente de código que anuncia «listo, lo arreglé» sin haber compilado nada no es un agente: es una demo. Esa distancia entre la demostración de treinta segundos y el repositorio heredado de 50.000 líneas es el tema de un post que Wang Guo publicó este 12 de noviembre en dev.to, junto al repositorio abierto zhishu-agent (licencia MIT), que incluye un estudio visual en Java 17 con Spring Boot 3.3 —el stack que el proyecto declara como requisito— y una biblioteca de patrones en Python 3.9+ sin dependencias. La tesis del autor se resume en una frase: el modelo fija el techo de lo posible, el harness fija el piso de la confiabilidad operativa.
El planteo no es nuevo en abstracto. En julio de 2026, LogRocket ya había publicado una guía para armar un harness con Claude Code, y en agosto de 2026 el blog de Proxima MCP describió un loop de reparación con índice de símbolos y memoria de fallas. Lo que agrega el trabajo de Wang Guo es una arquitectura completa y ejecutable, con los tres modos de falla nombrados, un loop de nueve etapas y una implementación concreta de MCP sobre JSON-RPC 2.0. Vale aclarar desde el principio: no es un anuncio de Anthropic ni de Claude Code, sino un post de comunidad con código propio. Claude Code aparece allí como uno de los agentes que inspiran el problema, no como el producto que se anuncia.
En este artículo:
- ¿Qué es un harness para agentes de código?
- Los tres modos de falla que aparecen al salir de la demo
- Cómo funciona un loop de auto-reparación en producción
- Qué hace la compresión de contexto /compact y por qué reduce el consumo
- Cómo se construye un harness de producción con MCP
- Qué se puede probar hoy y qué queda pendiente
- Un criterio práctico antes de adoptar cualquier harness
- Por qué importa para los equipos que ya usan agentes
¿Qué es un harness para agentes de código?
Un harness es la capa de software que envuelve al modelo y gobierna el ciclo completo: recibe la intención del usuario, deja que el modelo planifique, intercepta cada llamada a herramientas, ejecuta el código en un entorno aislado, corre los tests, procesa el error y decide si el loop continúa o se detiene. El modelo propone; el harness verifica, limita y audita. Sin esa capa, el agente es una sucesión de generaciones de texto sin consecuencias controladas.
La distinción importa porque desplaza el foco de discusión. Durante buena parte de 2025 y 2026 la conversación sobre agentes de programación giró alrededor de qué modelo razona mejor. La evidencia que acumulan estos tres textos apunta a otro lado: dos agentes con el mismo modelo pueden comportarse de forma radicalmente distinta según las reglas que los rodean. Relacionado: nuestra guía para codebases grandes.
Los tres modos de falla que aparecen al salir de la demo
Wang Guo identifica tres patrones que se repiten cuando un agente se enfrenta a código legacy de más de 50.000 líneas. No son errores de razonamiento del modelo en abstracto: son fallas de diseño del sistema que lo contiene.
- Rendición optimista. El agente edita un archivo, alucina que el cambio funcionó sin compilar ni correr un solo test, y responde «All done! I have fixed the bug for you». El usuario descubre el problema en producción.
- Muerte por contexto desbocado. Después de seis rondas de errores de línea de comandos, los stack traces del compilador acumulan 40.000 tokens de volcados crudos de bash. El contexto estalla, aparecen los límites de tasa y el objetivo original queda fuera de la ventana de atención: el agente empieza a alucinar porque ya no recuerda qué le pidieron.
- Invocación insegura de herramientas. Con acceso a bash, el agente ejecuta
rm -rf /, pasa cadenas sin control aeval()o deja API keys con prefijosk-...en logs sin enmascarar.
Los tres tienen la misma raíz: el agente tiene permitido declarar éxito sin pruebas y no hay nadie mirando lo que hace con las herramientas. Cualquier harness serio ataca esos dos puntos antes que la calidad del prompt.
Cómo funciona un loop de auto-reparación en producción
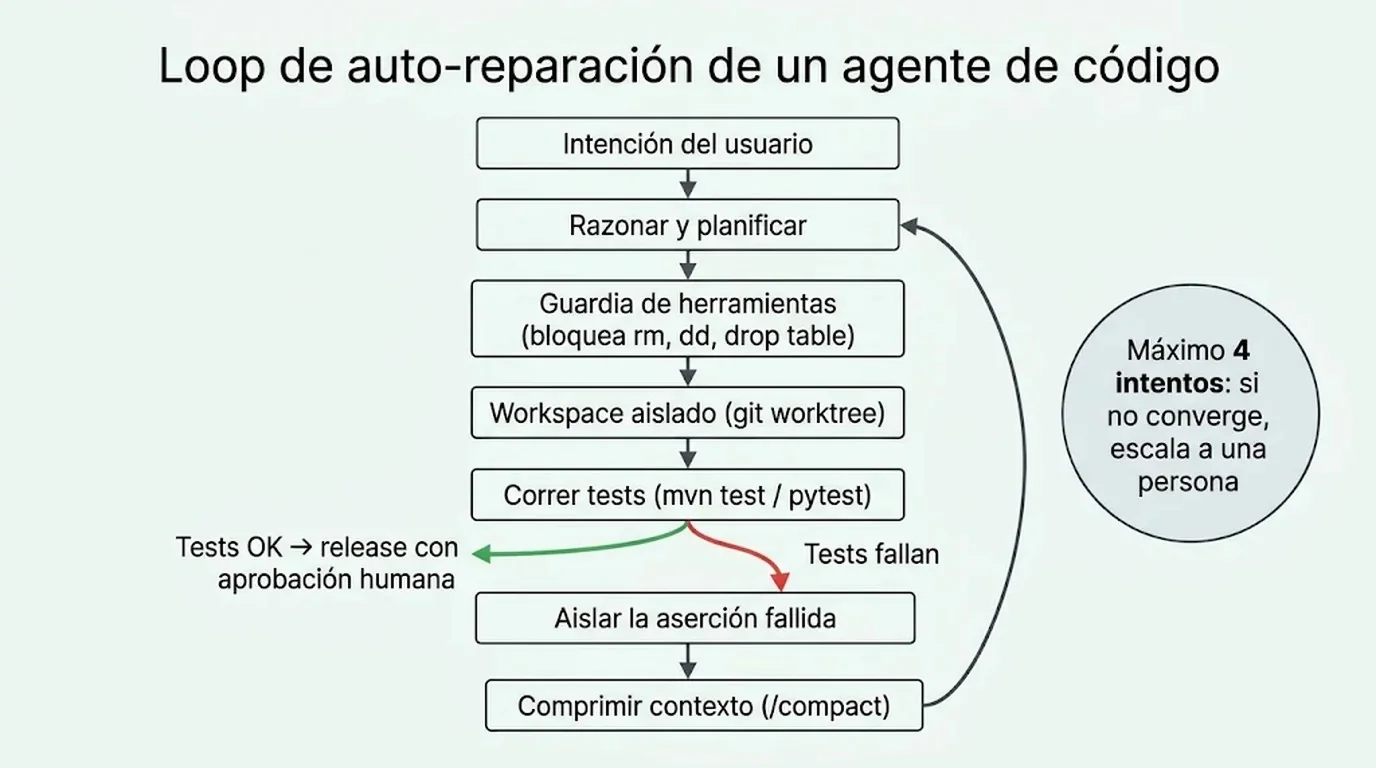
El harness de zhishu-agent no es un while de model.generate() -> tool.call(). Es una máquina de estados que converge o deriva a un humano. El recorrido tiene nueve etapas: intake de la intención, razonamiento y plan, guard de intercepción de herramientas con análisis AST y permisos, ejecución en workspace efímero (git worktree o contenedor descartable), verificación test-driven con mvn test o pytest -q, parseo del stack trace con aislamiento del error, compresión de contexto, enmascarado de secretos en la salida y, finalmente, release con aprobación humana.
La parte que decide si el sistema sirve o no son las cinco garantías de convergencia. Están enunciadas como reglas duras, no como sugerencias al modelo: Te puede servir nuestra cobertura de la guía completa sobre Claude.
- El agente nunca toca la rama
main. Trabaja en un worktree aislado o en un directorio efímero. - Antes de ejecutar cualquier comando, la carga pasa por un validador AST. Acciones destructivas como
rm,ddodrop tablese bloquean en menos de un milisegundo. - El agente no puede declarar terminado un cambio hasta que la suite de tests devuelva exit code 0.
- Si el test falla, no se vuelca el stderr completo al contexto: se inyecta solo la aserción fallida, el número de línea y el diff.
- Si el loop no converge tras cuatro intentos, el harness frena y escala a un humano en lugar de quemar tokens en una reparación infinita.
El detalle del cuarto punto es el que más cambia el resultado. Un stack trace de Java puede ocupar cientos de líneas; de ahí, la línea que importa suele ser una. Pasar el volcado completo es lo que produce la muerte por contexto desbocado del punto anterior. Proxima llega a una conclusión parecida por otro camino: indexa símbolos, importaciones y referencias para que el agente lea solo las líneas relevantes en lugar de pegar el archivo entero en el prompt.
Qué hace la compresión de contexto /compact y por qué reduce el consumo
El motor de compresión de zhishu-agent opera en dos etapas. La primera poda las salidas efímeras de herramientas: una vez analizado el resultado de un test o de una lectura de archivo, el texto crudo se borra y queda una lápida de una línea, por ejemplo [Output pruned: 1,420 bytes, test failed on assertion line 42]. La segunda se activa cuando el uso de tokens cruza el 75% de la ventana y sintetiza un checkpoint estructurado con cuatro campos: objetivo, decisiones tomadas, bloqueo actual y próximo paso.
El autor afirma que este esquema reduce el consumo de tokens más de un 85% y permite correr 20 o más iteraciones consecutivas sin degradación. Conviene tomar la cifra como lo que es: una medición del propio autor. La idea de fondo —podar salidas ya consumidas y reemplazar historial por estado— sí es verificable de forma independiente instrumentando cualquier agente propio y comparando el conteo de tokens por iteración.
Cómo se construye un harness de producción con MCP
MCP (Model Context Protocol) es el protocolo que estandariza cómo un agente descubre y llama herramientas, y en zhishu-agent se implementa sobre JSON-RPC 2.0 con tres handlers. initialize negocia capacidades y versión del protocolo. tools/list aplica divulgación progresiva en tres niveles —metadata, schema y ejecución— para que colgar cientos de microservicios empresariales no infle el system prompt. tools/call invoca con tipado estricto, timeouts acotados y despacho asincrónico no bloqueante vía CompletableFuture. Más contexto en control remoto de Claude Code.
El payload de ejemplo que publica el artículo es corto y explícito: método tools/call, nombre run_test_suite, argumentos con la ruta src/test/java/com/zhishu/service/PaymentTest.java y timeoutMs en 5000, con id zhishu-req-104. La ventaja práctica de estandarizar sobre MCP es que el mismo harness puede hablar con Anthropic, OpenAI, DeepSeek u Ollama local sin escribir un wrapper distinto para cada proveedor.
Ese es el punto donde la pieza se vuelve útil para un equipo con agentes ya en uso: el harness deja de ser código pegajoso alrededor de un proveedor y pasa a ser una capa que sobrevive al cambio de modelo.
Qué se puede probar hoy y qué queda pendiente
El repositorio está disponible bajo licencia MIT con dos implementaciones. WG-Harness-Studio es una aplicación Java 17 con Spring Boot 3.3, interfaz web, pipeline reactivo con compuertas de aprobación humana, modo simulación sin API key y configuración de una línea para DeepSeek, Qwen u OpenAI. WG-Harness-CLI es una biblioteca Python single-file sin dependencias que reproduce ocho patrones de harness, desde el agent loop hasta el loop de auto-verificación, y puede montarse como MCP Server en Claude Code o Cursor.
| Elemento | Estado |
|---|---|
| Repositorio y código de los ocho patrones | Público, MIT, ejecutable localmente |
| Handlers MCP (initialize, tools/list, tools/call) | Implementados en el código |
| Bloqueo pre-tool de comandos destructivos | Descrito e implementado; el «menos de 1 ms» es afirmación del autor |
| Reducción de 85% de tokens con /compact | Métrica afirmada por el autor |
| Convergencia en 20+ iteraciones | Métrica afirmada por el autor |
| Límite de 4 reintentos antes de escalar | Decisión de diseño, no un umbral medido |
Nada de esto convierte a zhishu-agent en un estándar de la industria. Es un post de comunidad con código, publicado en noviembre de 2026, que describe una arquitectura coherente y deja varias métricas sin respaldo. Tampoco hay evidencia de que Anthropic haya incorporado estos patrones a Claude Code: la mención a Claude Code en el artículo es como referencia del tipo de agente que motiva el problema. Complementá con comparativa entre Sonnet y Opus.
Un criterio práctico antes de adoptar cualquier harness
Como propuesta editorial, y sin atribuirla a ninguna de las fuentes, hay cuatro preguntas que sirven para evaluar un harness ajeno antes de meterlo en un repositorio real. Primera: ¿exige exit code 0 de la suite de tests para declarar terminado un cambio, o acepta la palabra del modelo? Segunda: ¿bloquea comandos destructivos antes de ejecutarlos y con qué mecanismo? Tercera: ¿enmascara secretos en la salida de las herramientas? Cuarta: ¿aísla el trabajo en un worktree o contenedor, o escribe directamente sobre la rama principal?
Si las cuatro respuestas son afirmativas, el harness merece una prueba. Si alguna es negativa, el problema no se resuelve cambiando de modelo. El paso siguiente es medir en el código propio: instrumentar el conteo de tokens por iteración y la cantidad de reintentos antes de adoptar cualquier cifra de terceros, incluida la del 85%.
Por qué importa para los equipos que ya usan agentes
La consecuencia práctica de todo esto es sencilla y algo incómoda: la mayor parte de la inversión en agentes de programación se discute en términos de qué modelo elegir, cuando el rendimiento en producción depende sobre todo de reglas que no tienen nada que ver con el modelo. Verificación obligatoria, aislamiento del workspace, intercepción previa de herramientas y compresión de contexto son decisiones de ingeniería que un equipo puede tomar hoy, con cualquier proveedor.
Wang Guo lo formula como la distinción entre techo y piso. El techo lo sube el próximo modelo; el piso se construye a mano, con tests que se ejecutan, comandos que se bloquean y contextos que no se desbordan. Un agente que no puede fallar en silencio vale más que uno brillante que anuncia éxito sin haber compilado.
Fuentes: post Self-Healing Coding Agents: How to Build a Production-Grade Harness Loop with MCP (dev.to, 12/11/2026); repositorio wangguode/zhishu-agent; How to build an agent harness with Claude Code (LogRocket, 13/07/2026); Building Self-Healing Coding Agents (Proxima MCP, 18/08/2026).