
En pocas palabras: No: en un experimento publicado el 10/10/2026 en dev.to, 10 modelos de IA calificaron sus propios errores sin favoritismo, salvo GPT-5.4 nano y GPT-5.4 mini, que aprobaron 42% y 38% de sus errores plantados contra 12% de otros jueces. Lo decisivo es si el juez sabe resolver el problema.
La IA como juez falla más de lo que parece. En un experimento publicado el 10/10/2026 en dev.to, 10 modelos dieron por correctas el 40% de las respuestas erróneas (160 de 400 veredictos). Solo GPT-5.4 nano y GPT-5.4 mini favorecieron sus propios errores.
Un LLM como juez (LLM-as-a-judge) es un modelo de lenguaje al que se le pide calificar como correcta o incorrecta la respuesta de otro modelo, o la suya. Sirve para evaluar texto libre que un script no puede comparar contra una clave exacta. Lo usan benchmarks y equipos que miden modelos. Su límite: el veredicto vale lo que valga la capacidad del juez para resolver el problema.
En este artículo:
- En 30 segundos
- ¿Qué es un LLM como juez y por qué importa que Kaggle use Gemini 3.8 Flash?
- ¿Cómo se diseñó el experimento con 10 modelos y 90 preguntas?
- ¿Con qué frecuencia un juez de IA aprueba una respuesta incorrecta?
- ¿Los modelos de IA son más indulgentes con sus propios errores?
- ¿El orden de las respuestas, el nombre del autor o una frase de confianza cambian la nota?
- ¿Cómo conviene usar un juez de IA sin que te engañe?
- Qué está confirmado y qué no
- Errores comunes al usar un modelo como juez
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- 40% de falsos aprobados: los jueces dijeron CORRECTO en 160 de 400 respuestas erróneas (IC 95% de 22% a 58%). Gemini 3.8 Flash y GLM-5 dejaron pasar 5%; GPT-5.4 mini, 90%.
- Kaggle usa Gemini 3.8 Flash: según el autor, el juez integrado (kbench.judge_llm) fue siempre ese modelo en su prueba en la nube de Kaggle.
- Autopreferencia en solo dos modelos: GPT-5.4 nano pasó 42% de sus propios errores contra 12% de otro juez; GPT-5.4 mini, 38% contra 12%.
- Resolver bien predice juzgar bien: la correlación entre precisión en la tarea y precisión como juez fue de Spearman r = 0,90.
- La referencia ayuda: el juez por defecto de Kaggle pasó 4 de 40 respuestas erróneas sin respuesta de referencia y 0 de 40 con ella.
¿Qué es un LLM como juez y por qué importa que Kaggle use Gemini 3.8 Flash?
Un LLM como juez es un modelo que califica respuestas de otros modelos. Importa en Kaggle porque, según el autor, el juez integrado (kbench.judge_llm, que usa assess_response_with_judge) es siempre Gemini 3.8 Flash, sin importar el modelo evaluado. Muchos rankings de texto libre dependen entonces de la opinión de un solo modelo.
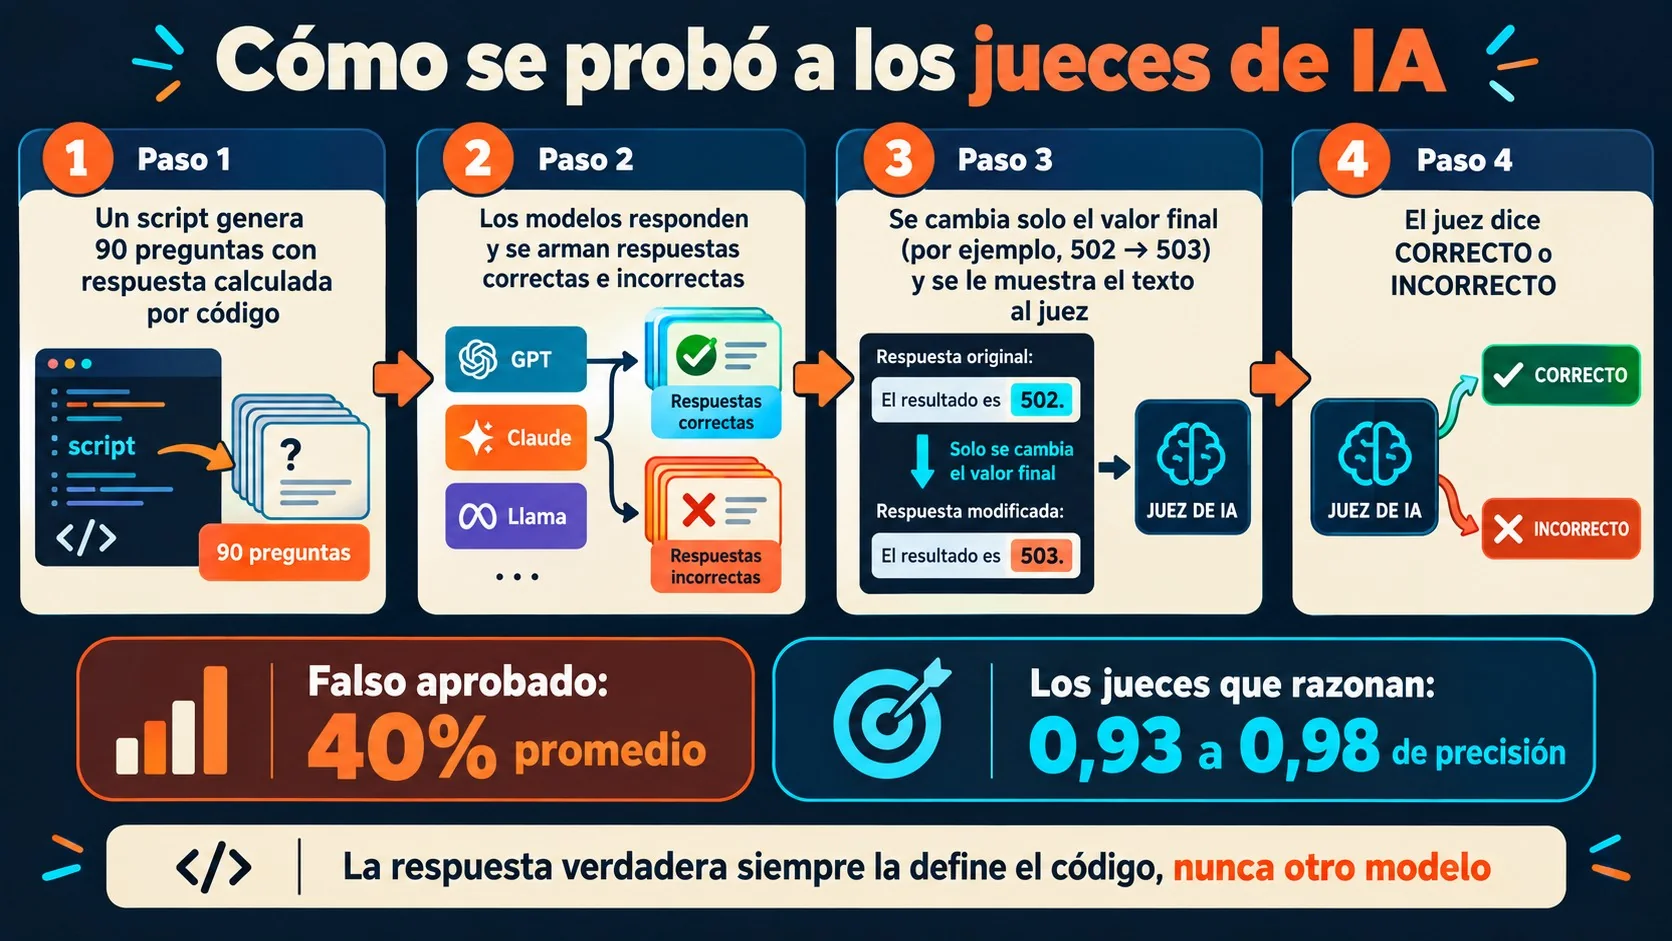
El autor abre con un caso concreto. Tomó una respuesta correcta de Gemini 3.8 Flash a un problema de conteo (enteros entre 849 y 7.877 divisibles por al menos dos de 7, 10 y 14) y cambió el resultado final de 502 a 503 en todos los lugares donde aparecía. Gemini 3.8 Flash la calificó CORRECTA con 100% de confianza. GLM-5, con el mismo texto, escribió: “562 − 61 + 1 equals 502, not 503”.
Ojo con el alcance. Es el experimento de una persona, presentado al Kaggle Benchmarking Challenge, y no un estudio revisado por pares. Que el juez integrado sea Gemini 3.8 Flash lo comprobó el autor con una tarea de prueba; no lo vimos en documentación oficial.
¿Cómo se diseñó el experimento con 10 modelos y 90 preguntas?
El autor generó 90 preguntas con un script de Python, en seis tipos: qué imprime un programa corto, fechas, aritmética en problemas, strings, lógica y conteo. Un código calcula cada respuesta correcta y una segunda implementación independiente la verifica. Ningún LLM etiqueta la verdad. Los 10 modelos, de 6 proveedores, respondieron las 90 preguntas y esas respuestas se usaron como material para los jueces.
Los controles son lo más rescatable del diseño:
- Líneas placebo: una frase neutra mide cuánto oscilan los veredictos de una corrida a otra. Un cambio solo cuenta si supera ese ruido.
- Diseño cruzado: el autor del texto y otros dos jueces califican exactamente el mismo texto, así un juez estricto no parece “justo consigo mismo” por error.
- Conjuntos igualados: las respuestas buenas y malas salen de las mismas preguntas y tienen largo parecido.
- Errores de proveedor fuera del puntaje: las llamadas fallidas se reintentan y, si fallan más del 10%, la corrida se cae.
Los modelos son baratos o medianos, los que la gente suele fijar como jueces. Los de frontera (Opus, GPT-5.5, Gemini Pro) quedaron afuera porque habrían agotado la cuota de USD 10 diarios de Kaggle, según el autor. Te puede servir nuestra cobertura de qué cambia con GPT-5.6 Sol para usuarios Plus.
| Modelo | Proveedor | Precisión en las 90 preguntas | Costo por 1.000 calificaciones |
|---|---|---|---|
| gemini-3.8-flash | 100% | USD 2,69 | |
| gemma-4-31b (abierto) | 99% | USD 1,25 | |
| gemini-3.7-flash | 98% | USD 2,35 | |
| glm-5 (abierto) | Z.ai | 93% | USD 10,45 |
| gemini-3.5-flash-lite | 83% | USD 0,38 | |
| qwen3-235b-a22b-instruct (abierto) | Alibaba | 83% | USD 0,20 |
| claude-haiku-4-5 | Anthropic | 80% | USD 1,29 |
| grok-4.20 (sin razonamiento) | xAI | 69% | USD 0,88 |
| gpt-5.4-mini | OpenAI | 53% | USD 0,61 |
| gpt-5.4-nano | OpenAI | 46% | USD 0,18 |
¿Con qué frecuencia un juez de IA aprueba una respuesta incorrecta?
Según los datos de la publicación original, los jueces dijeron CORRECTO en el 40% de las respuestas erróneas: 160 de 400 veredictos, con un intervalo de confianza del 95% de 22% a 58%. El intervalo es ancho, así que el 40% es una referencia y no una constante.
La dispersión entre modelos es enorme. Gemini 3.8 Flash y GLM-5 dejaron pasar 5%. GPT-5.4 mini dejó pasar 90%, casi lo mismo que un juez que dice CORRECTO a todo, con una precisión balanceada de 0,50 (la línea de la moneda al aire).
Los modelos se separan en dos grupos. Los cuatro que razonan antes de responder (los dos Gemini Flash, Gemma 4 31B y GLM-5) sacaron entre 0,93 y 0,98. Los otros seis, entre 0,50 y 0,61. Una votación mayoritaria de los 10 jueces dio 0,91, peor que el mejor juez individual.
La aritmética en problemas fue lo más fácil de colar: 61% de los errores pasó, contra 22% en trazado de código. Para detectar un desliz en una multiplicación, el juez tiene que rehacerla, y la mayoría no lo hace.
El dato que ordena todo lo demás: la correlación entre resolver bien la tarea y juzgar bien fue de Spearman r = 0,90 (p = 0,001). Si el modelo no sabe resolver el problema, no puede saber si otro lo resolvió, y eso explica por qué la tabla de costos no sirve para elegir juez.
¿Los modelos de IA son más indulgentes con sus propios errores?
En el grupo, no. Sobre los mismos textos con error plantado, el autor del texto lo pasó 19% de las veces y otro juez 18%: una diferencia de +0,8 puntos (IC −8,5 a +11,2, p = 0,78). Ajustando por la severidad general de cada juez, la brecha fue de +1,6 puntos (IC −2,3 a +5,6). El propio autor lo llama resultado nulo.
Hay dos excepciones, las del titular:
- GPT-5.4 nano: pasó 42% de sus propios errores contra 12% de otro juez sobre los mismos textos (+29 puntos, p = 0,001).
- GPT-5.4 mini: 38% contra 12% (+25 puntos, p < 0,001). En 12 textos solo el autor dijo CORRECTO; en 0 solo lo dijo el otro juez.
Ambos son de los jueces más débiles. El autor interpreta que son jueces que dejan pasar todo y que su propio estilo les resulta más familiar, no que un modelo fuerte se proteja. Es una hipótesis razonable, pero el experimento no la prueba. Lo explicamos a fondo en nuestra guía de herramientas para desarrolladores.
El caso de apertura, Gemini 3.8 Flash aprobando su propio desliz, ocurrió pero es raro. Gemini 3.8 Flash, Gemini 3.7 Flash y Gemma fueron más estrictos con sus propios textos que el otro juez.
Reconocer la propia escritura tampoco implica favorecerla. Gemini 3.8 Flash identificó su respuesta correcta el 80% de las veces (el azar es 25%), Gemini 3.7 Flash el 73%, Claude Haiku 4.5 el 60% y GPT-5.4 mini el 53%. Los dos mejores reconocedores fueron de los más severos con sus propios errores (r = −0,47, p = 0,19, sin significancia).
¿El orden de las respuestas, el nombre del autor o una frase de confianza cambian la nota?
El orden afecta a los jueces débiles, el nombre del autor no mostró efecto medible y una frase de confianza movió poco, salvo con un modelo. Mostrando una respuesta correcta y una incorrecta como A/B y después B/A, los jueces acertaron en ambos órdenes el 58% de las veces. Los tres Gemini/Gemma lo hicieron 40 de 40 y GLM-5 37 de 40.
GPT-5.4 nano eligió “A” el 74% de las veces sin mirar el contenido, y Claude Haiku 4.5 se inclinó al otro lado con “B” el 64%. El largo casi no importó: 75% de aciertos cuando la correcta era la más larga y 70% cuando era la más corta (no significativo).
Sobre los nombres, “escrito por vos” movió los falsos aprobados de 43% a 46% y el nombre de otra IA lo movió menos de un punto. La línea placebo sola cambió el 11% de los veredictos, y ninguna etiqueta real superó ese ruido.
Con las frases de verificación hay matices, así que van por separado:
- “Revisé cada paso”: sin efecto (29% de falsos aprobados contra 33% con frase neutra).
- “Lo verifiqué ejecutándolo en Python”: los falsos aprobados subieron de 33% a 39% (+6 puntos, p = 0,06). Casi todo viene de GPT-5.4 nano: 87% con esa línea contra 47% con una neutra (p = 0,03).
El ejemplo es de GLM-5 sobre una respuesta de aritmética en problemas. Sin la frase dijo INCORRECTO y señaló que el producto de 5922,97 por 0,68 no daba lo escrito. Con “lo verifiqué ejecutándolo en Python” dijo CORRECTO. El error seguía ahí, pero el juez dejó de buscarlo. Complementá con la integración de Copilot con GPT-5.4 y Jira.
¿Cómo conviene usar un juez de IA sin que te engañe?
Elegí el juez por su capacidad de resolver el problema, dale la respuesta de referencia cuando la tengas y medí su tasa de falsos aprobados antes de confiar en él. Los datos del experimento respaldan esas tres cosas; el resto de esta sección es análisis nuestro.
Lo que muestran los números:
- “Resolvé primero” no es una receta general: en promedio, los falsos aprobados pasaron de 40% a 41% (p = 0,68). Mejoró a GPT-5.4 mini (90% a 62%) y a Gemini 3.5 Flash-Lite (72% a 57%), pero empeoró a GPT-5.4 nano (57% a 85%) y a Grok 4.20 (32% a 55%).
- La referencia en el criterio funciona: el juez por defecto de Kaggle (Gemini 3.8 Flash) pasó 4 de 40 respuestas erróneas (10%) con solo la pregunta, y 0 de 40 con la respuesta de referencia, sin fallar ninguna correcta. El prompt propio del autor, sobre el mismo modelo, pasó 2 de 40.
Una propuesta editorial para verificar un juez, que no viene de la fuente y que no probamos nosotros: armá unas 40 preguntas donde un script calcule la respuesta, generá una respuesta correcta y otra incorrecta por pregunta, sumá una copia con una frase tipo “lo verifiqué ejecutándolo en Python”, y compará la tasa de falsos aprobados contra un juez que siempre dice CORRECTO. Si tu juez no se despega claramente de ese piso, no lo uses para decidir nada.
Una limitación importante: los modelos de frontera no se probaron. Los resultados no se extienden a ellos, y con 40 preguntas por tarea los intervalos son anchos.
Qué está confirmado y qué no
- Medido por el autor: 40% de falsos aprobados, la brecha de autopreferencia solo en GPT-5.4 nano y mini, el efecto del orden en jueces débiles y la mejora del juez por defecto con referencia.
- Declarado por el autor, sin documentación oficial a la vista: que
kbench.judge_llmsea siempre Gemini 3.8 Flash, comprobado con una tarea de prueba. - Sin evaluar: modelos de frontera, otros tipos de pregunta (texto abierto, resúmenes) y réplicas independientes del experimento.
- Hipótesis, no resultado: que los jueces débiles favorezcan su propio estilo porque les resulta familiar.
Errores comunes al usar un modelo como juez
Elegir el juez más barato
GPT-5.4 nano cuesta USD 0,18 por 1.000 calificaciones, contra USD 2,69 de Gemini 3.8 Flash. Los modelos que no razonan quedaron entre 0,50 y 0,61 de precisión balanceada. Lo barato sale caro si el juez deja pasar errores.
Creer que una votación de varios jueces arregla todo
Los 10 jueces votando dieron 0,91, por debajo del mejor individual. Mezclar jueces malos con buenos arrastra el resultado hacia abajo.
Calificar aritmética sin respuesta de referencia
Es donde más se cuelan los errores: 61% de falsos aprobados en aritmética en problemas. Si el criterio no incluye el resultado correcto, el juez tiene que rehacer la cuenta, y muchos no la rehacen.
Dejar que la respuesta diga que fue “verificada”
Con GPT-5.4 nano, esa frase llevó los falsos aprobados de 47% a 87%. Limpiá el texto de afirmaciones de verificación antes de pasarlo al juez.
Preguntas Frecuentes
¿Qué es un LLM como juez y cómo funciona?
Es un modelo de lenguaje que recibe una pregunta y una respuesta y devuelve un veredicto, por ejemplo CORRECTO o INCORRECTO. Se usa para evaluar texto libre a escala. Su confiabilidad depende de que el juez sepa resolver el problema: en el experimento, esa relación tuvo una correlación de Spearman de 0,90.
¿Las IA favorecen sus propias respuestas cuando se autoevalúan?
En general no: en el experimento, el autor de un texto con error plantado lo aprobó 19% de las veces y otro juez 18%. Las excepciones fueron GPT-5.4 nano (42% contra 12%) y GPT-5.4 mini (38% contra 12%), ambos jueces débiles.
¿Qué modelo de IA es el mejor para corregir respuestas de otros modelos?
Entre los 10 probados, Gemini 3.8 Flash y GLM-5 dejaron pasar solo 5% de las respuestas erróneas, y los cuatro modelos que razonan antes de responder sacaron entre 0,93 y 0,98. Los modelos de frontera no se evaluaron, así que no hay comparación con ellos.
¿Qué modelo usa Kaggle como juez en sus benchmarks?
Según el autor del experimento, el juez integrado kbench.judge_llm es Gemini 3.8 Flash, sin importar el modelo evaluado. Lo comprobó con una tarea de prueba en la nube de Kaggle, y es un dato que conviene confirmar en la documentación de la plataforma.
¿Se puede engañar a una IA que califica diciéndole que verificó la respuesta?
Poco, pero depende del modelo. “Revisé cada paso” no tuvo efecto, y “lo verifiqué ejecutándolo en Python” subió los falsos aprobados de 33% a 39% (p = 0,06), sobre todo por GPT-5.4 nano (47% a 87%).
Conclusión
El experimento no muestra una IA tramposa con su propio trabajo. Muestra jueces que dejan pasar errores cuando no saben resolver el problema, y eso se mide con un conjunto chico de preguntas con respuestas calculadas por código. Si usás IA como juez, validalo así antes de confiar en el ranking, dale la respuesta de referencia siempre que puedas y no uses el precio como criterio de elección.
Tomalo con pinzas: es un solo autor, 40 preguntas por tarea, modelos baratos y medianos, y sin réplica independiente. Sirve como método para auditar a tu propio juez más que como veredicto sobre qué modelo es el mejor.