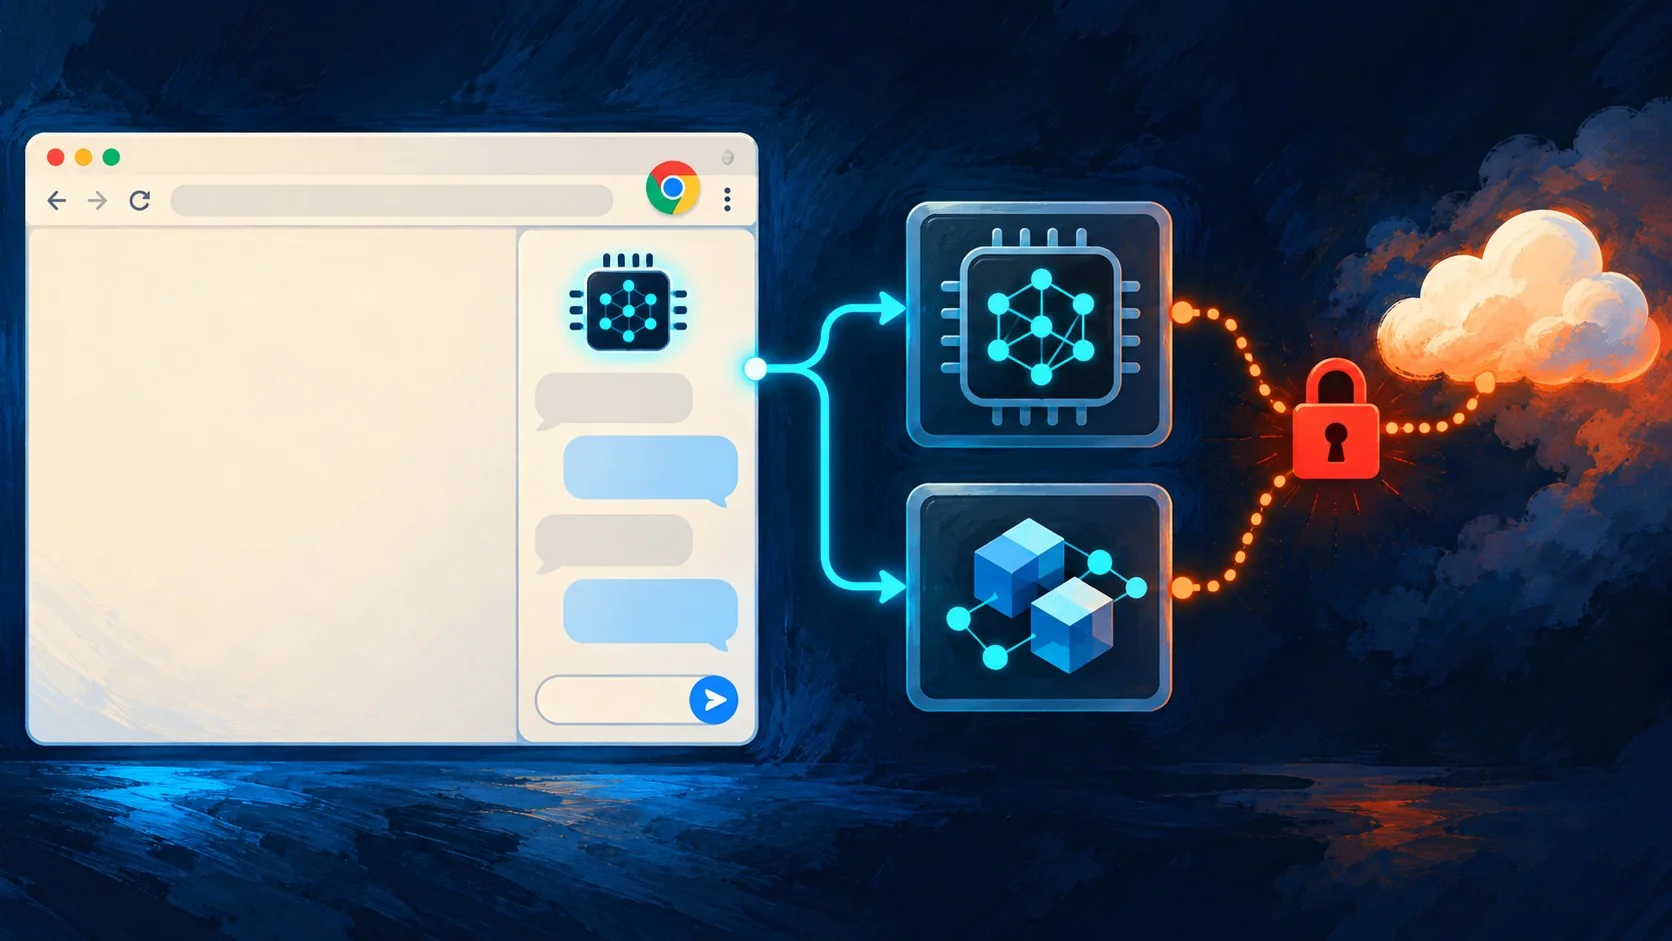
En pocas palabras: Sí, se puede: la extensión AWFlow corre modelos de 1 a 4 mil millones de parámetros localmente dentro de una extensión Manifest V3, sin API key de OpenAI ni enviar la página a ningún servidor, usando WebLLM, transformers.js y TensorFlow.js, según un posteo técnico publicado el 23 de octubre de 2026.
Dannickstark, creador de la extensión de Chrome AWFlow, publicó el 23 de octubre de 2026 un detalle técnico sobre cómo logró correr modelos de lenguaje adentro del navegador con WebLLM, transformers.js y TensorFlow.js, sin mandar la página del usuario a ningún servidor ni pedir una API key de OpenAI, Anthropic o Google.
WebLLM es el runtime de MLC AI (@mlc-ai/web-llm) que ejecuta modelos de chat en el navegador usando WebGPU. Transformers.js es la librería de Hugging Face (@huggingface/transformers) que corre pipelines de tareas, como resumen, clasificación o embeddings, sobre ONNX Runtime. Los dos corren adentro de una extensión Manifest V3, en un Web Worker, sin depender de un servidor externo ni de una clave de API.
En este artículo:
- En resumen
- Qué problema resuelve correr un modelo de IA dentro de la extensión y no en la nube
- Qué runtimes usa la extensión: WebLLM, transformers.js y TensorFlow.js
- Por qué el CSP de Manifest V3 bloquea el runtime WASM de ONNX
- Cómo evitar que la UI se congele: Web Workers y fallback sin WebGPU
- Qué tareas puede resolver bien un modelo chico local y cuáles no
- Tres preguntas para decidir si te conviene este enfoque en tu propia extensión
- Errores comunes al meter un LLM dentro de una extensión de Chrome
- Preguntas Frecuentes
- Conclusión
- Fuentes
En resumen
- AWFlow corre modelos de 1 a 4 mil millones de parámetros localmente, dentro de la extensión, sin API key y sin mandar la página a ningún servidor.
- Usa tres runtimes distintos: WebLLM para chat con WebGPU, transformers.js para tareas puntuales, TensorFlow.js para embeddings clásicos.
- El CSP por defecto de Manifest V3 bloquea el loader WASM de ONNX Runtime si viene de un CDN externo: hay que empaquetarlo adentro de la extensión.
- Dos Web Workers separan la inferencia del hilo principal para que el side panel no se congele mientras carga un modelo de 2 GB.
- Si la máquina no tiene WebGPU, el sistema cae a WASM de forma automática: más lento, pero funciona en cualquier equipo.
Qué problema resuelve correr un modelo de IA dentro de la extensión y no en la nube
AWFlow corre modelos locales para no depender de una API key y para que el texto de la página no salga de la máquina del usuario, según describe el posteo técnico de dannickstark en dev.to. La extensión tiene un nodo que resume, clasifica o extrae datos de un texto con IA, y para ese trabajo puntual un modelo de 1 a 4 mil millones de parámetros alcanza sin problema.
Ponele que necesitás resumir una noticia o sacar cinco campos de un bloque de HTML. No hace falta un modelo de frontera corriendo en un datacenter para eso. El tema es que cuando un paso sí necesita razonamiento profundo, el usuario puede cambiar ese nodo puntual a OpenAI, Anthropic, Google o un Ollama local. Local es el default, no la única opción.
Esto no es un detalle menor. Cambia quién paga la factura y quién ve tus datos.
Ejemplo hipotético (ilustrativo, no es un caso real reportado): imaginá un equipo chico que arma una extensión para resumir tickets de soporte dentro del navegador. Si cada resumen pasa por una API en la nube, el costo escala con el volumen y cada ticket (que puede tener datos de un cliente) sale de la máquina. Con un modelo chico corriendo local, como describe el posteo de dannickstark, ese resumen nunca sale del navegador y no hay factura por token. El trade-off, siguiendo la misma lógica del posteo, es que la primera vez un usuario va a esperar la descarga del modelo (de decenas de MB a un par de GB) antes de ver el primer resultado.
Qué runtimes usa la extensión: WebLLM, transformers.js y TensorFlow.js
AWFlow usa tres runtimes porque ninguna librería sola cubre todos los casos: WebLLM para chat en WebGPU, transformers.js para pipelines de tarea y TensorFlow.js para un puñado de modelos clásicos como embeddings legacy. Además hay un nodo separado para la IA nativa de Chrome cuando el navegador la expone, y una página de “Local Models” que lista qué está instalado y permite bajar o borrar modelos sin que el usuario tenga que saber qué motor corre cada cosa.
| Runtime | Se usa para | Backend | Cuándo lo elegirías |
|---|---|---|---|
| WebLLM (@mlc-ai/web-llm) | LLMs tipo chat, nodo “Web LLM” | WebGPU (WASM si no hay GPU) | Cuando el nodo necesita conversación de varios turnos, no solo una tarea puntual |
| transformers.js (@huggingface/transformers) | Resumen, clasificación, embeddings, speech, chat chico | ONNX Runtime, WebGPU o WASM según la tarea | Cuando la tarea es acotada y repetible (clasificar, extraer campos, resumir) |
| TensorFlow.js | Modelos clásicos, embeddings legacy | No especificado | Solo si ya tenés un modelo TF entrenado que no migraste a ONNX |
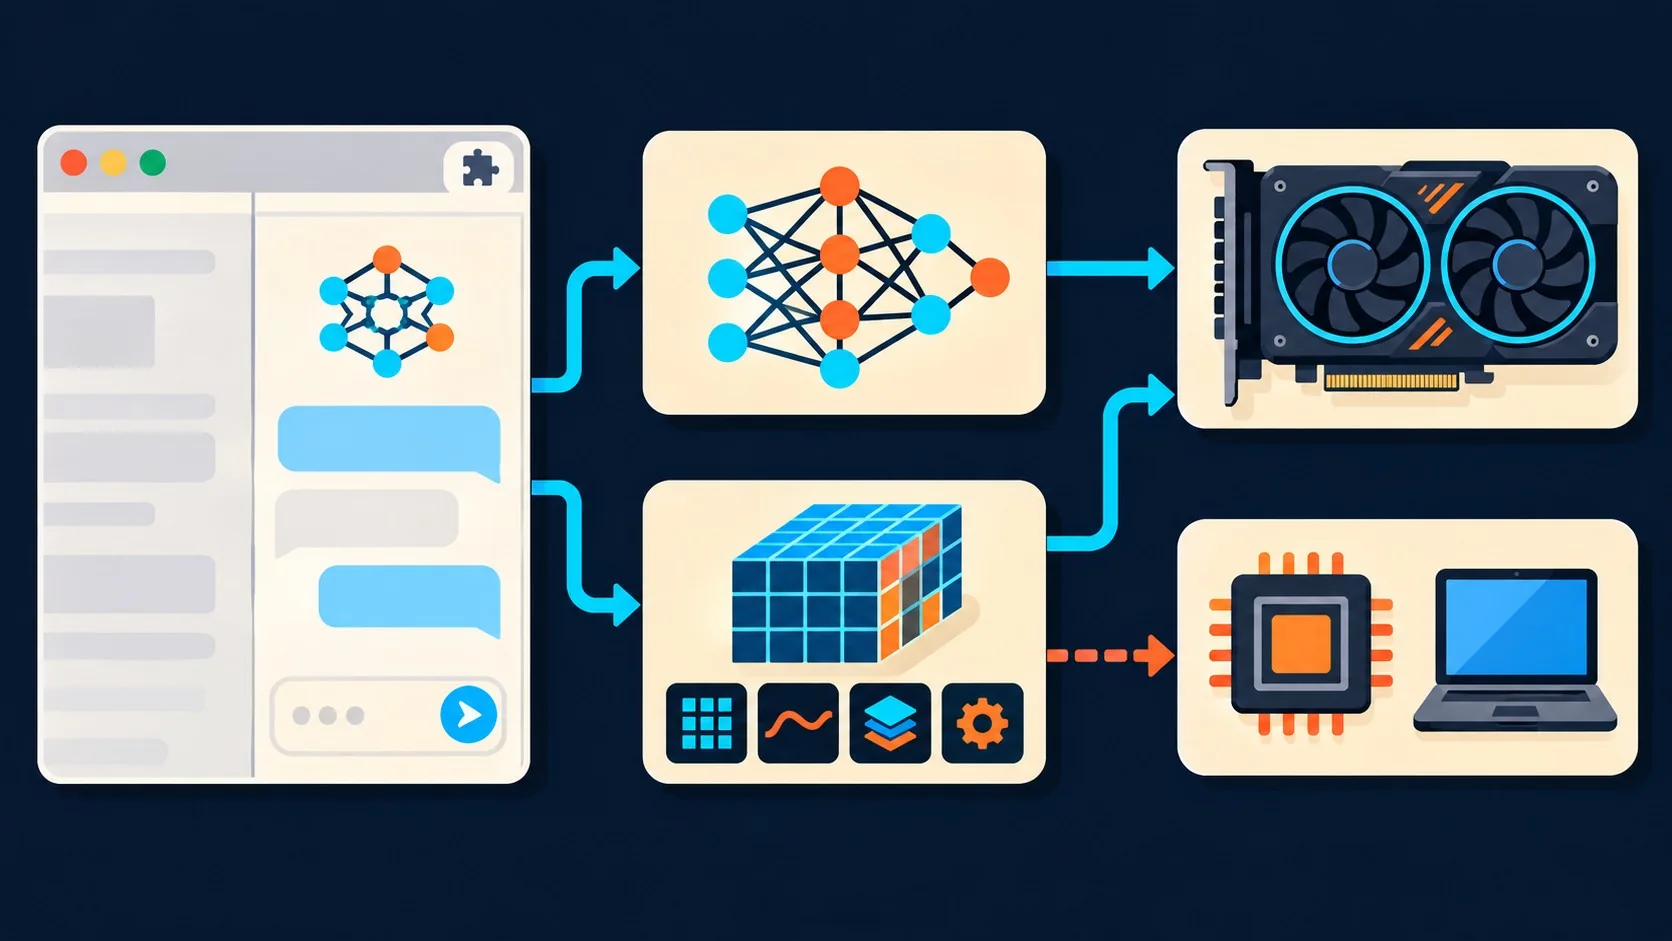
El criterio para elegir entre los tres no depende de preferencia personal, sino de qué tan abierta es la tarea: si el usuario va a mantener una conversación de ida y vuelta, WebLLM tiene sentido porque está pensado para eso; si la tarea es “metele este texto y devolveme un resultado estructurado”, transformers.js alcanza y es más liviano.
¿Qué es WebLLM y para qué sirve?
WebLLM es el motor de MLC AI que compila y corre un modelo de lenguaje tipo chat adentro del navegador, usando WebGPU para los kernels pesados. Sirve para el nodo conversacional de AWFlow, donde el usuario escribe un prompt y espera una respuesta generada token por token, todo sin salir del cliente.
¿Cómo funciona transformers.js en el navegador?
Transformers.js carga un pipeline (resumen, clasificación, extracción de features) y lo ejecuta sobre ONNX Runtime Web, el mismo motor que usa el blog de Hugging Face sobre su extensión con Gemma 4 E2B para correr generación de texto y embeddings en un background service worker. La librería cachea un pipeline por cada ID de modelo, así que la segunda corrida de un workflow no vuelve a cargar nada.
¿Para qué se usa TensorFlow.js acá?
TensorFlow.js queda para los modelos legacy que todavía no migraron a ONNX, básicamente embeddings viejos que la extensión mantiene por compatibilidad. Comparte worker con transformers.js, así que no suma otro hilo más a la arquitectura.
Por qué el CSP de Manifest V3 bloquea el runtime WASM de ONNX
El CSP por defecto de una extensión Manifest V3 es script-src 'self' 'wasm-unsafe-eval'; object-src 'self', y eso no te deja agregar un host remoto en script-src. ONNX Runtime Web, el motor que usa transformers.js por debajo, carga por defecto su loader WASM desde un CDN. Resultado: el import queda bloqueado y el error que te tira no dice por qué (spoiler: no es un bug de tu código).
Esta misma fricción aparece documentada en una discusión abierta en el repo de ONNX Runtime sobre los problemas de inicialización de WASM justo en este contexto de Manifest V3. ¿Alguien de Microsoft la respondió de forma oficial? Todavía no, según el estado público del hilo.
La solución que aplicó AWFlow fue empaquetar los assets de ONNX Runtime adentro de la propia extensión, con un plugin de Vite que los copia a /assets/ort/ en el build, y apuntar el runtime a esa ruta local antes de llamar al primer pipeline():
- Copiar los binarios localmente: un plugin de build mueve los archivos WASM de ONNX Runtime a una carpeta dentro de la extensión en vez de dejarlos en el CDN.
- Setear
wasmPathsantes del primer pipeline:tf.env.backends.onnx.wasm.wasmPaths = '/assets/ort/'hace que el runtime busque los archivos en el origen propio. - No tocar la flag
wasm-unsafe-eval: es la que habilita compilar WebAssembly en el manifest. Sin ella en el CSP, nada de esto corre.
Vale la pena marcar algo que las tres fuentes dejan entrever pero no dicen de forma explícita: este problema de CSP no es un capricho de Chrome, es la consecuencia directa de que Manifest V3 restringe qué código puede ejecutar una extensión para reducir superficie de ataque. La solución (empaquetar todo adentro) es más trabajo de build, pero es la contracara lógica de esa restricción, no un bug que algún día se arregla.
Cómo evitar que la UI se congele: Web Workers y fallback sin WebGPU
AWFlow saca toda la inferencia del hilo principal metiéndola en dos Web Workers separados: uno exclusivo para WebLLM y otro compartido entre transformers.js y TensorFlow.js. La UI, hecha en Svelte, solo manda requests y dibuja resultados, nunca compila ni corre un modelo.
El worker de WebLLM termina siendo apenas tres líneas usando WebWorkerMLCEngineHandler. El problema real apareció con el wrapper ChatWebLLM de LangChain: construye su propio engine en el hilo principal adentro del constructor, y no tiene forma de aceptar uno externo. La salida fue crear el WebWorkerMLCEngine a mano e inyectarlo después, aprovechando que ambos implementan la misma interfaz MLCEngineInterface. Si ese camino falla, por falta de WebGPU o un error de descarga, el código termina el worker para no dejarlo huérfano y cae al engine del hilo principal, sin romper el nodo.
Subís el modelo, lo probás en local, funciona bárbaro, lo activás en un workflow real y de repente el engine no arranca porque el navegador del usuario no tiene un adaptador WebGPU disponible, así que el fallback a WASM termina siendo la diferencia entre un nodo roto y uno que simplemente anda un poco más lento.
Para no probar WebGPU en cada llamada, el worker de inferencia lo chequea una sola vez y memoiza el resultado con una promesa. Después, cada pipeline decide su device según una lista por tarea, no una flag global, porque algunas tareas andan bien en WASM y son inestables en WebGPU.
Qué tareas puede resolver bien un modelo chico local y cuáles no
Después de meses corriendo esto en workflows reales, el corte queda claro: los modelos locales chicos son buenos en tareas acotadas y bien definidas. Para todo lo demás, conviene el nodo configurado con un modelo más grande.
- Bien: resumir, clasificar, extraer campos de un texto y generar embeddings para búsqueda semántica.
- Con ayuda: tool use. Los modelos chicos no tienen API de function calling nativa, así que hay que armar el prompt y parsear la salida a mano.
- No funciona bien: razonamiento largo de varios pasos, o cualquier tarea donde una respuesta equivocada sale cara.
El costo honesto es la primera descarga: va desde decenas de MB para un clasificador hasta un par de GB para un modelo de chat. Después queda cacheado y arranca rápido. El tamaño de los modelos sigue siendo un problema abierto para WebLLM: el propio autor del posteo admite no tener todavía una solución mejor que la que implementó en AWFlow.
Tres preguntas para decidir si te conviene este enfoque en tu propia extensión
Si estás evaluando replicar esta arquitectura, antes de empezar a escribir código tiene sentido responder esto, en base a lo que muestran las tres fuentes:
- ¿La tarea es acotada o abierta? Si el nodo hace una cosa puntual (resumir, clasificar, extraer), un modelo chico local alcanza. Si necesita razonamiento de varios pasos o tool calling complejo, metele un modelo en la nube y no pelees contra la limitación.
- ¿Podés tolerar una descarga inicial de hasta un par de GB? Si tu usuario espera una respuesta instantánea desde el primer uso, sin ningún tipo de espera, un modelo cloud evita ese costo. Si el flujo tolera una carga única en segundo plano, local funciona.
- ¿Tenés margen para empaquetar los binarios del runtime adentro del build? Como vimos con el CSP de Manifest V3, no es opcional: si tu pipeline de build no puede copiar los assets de ONNX Runtime a una ruta local, el enfoque local se cae antes de arrancar.
Errores comunes al meter un LLM dentro de una extensión de Chrome
- Dejar que ONNX Runtime cargue desde el CDN por defecto: en Manifest V3 el CSP lo bloquea sin avisar con claridad, y el desarrollador pierde horas pensando que el modelo está roto cuando el problema es de red de assets.
- Cargar el modelo en el hilo principal de la UI: un modelo de 2 GB compilando ahí congela el canvas entero. La solución es un Web Worker dedicado por runtime, no uno compartido para todo.
- Confiar en una flag global de WebGPU: algunas tareas andan peor en GPU que en WASM. Conviene una lista por tarea, no un interruptor único para toda la extensión.
- No terminar el worker cuando falla la inicialización: si no llamás a
worker.terminate()antes de caer al fallback, el hilo queda huérfano consumiendo memoria de fondo.
Preguntas Frecuentes
¿Cómo correr un LLM localmente dentro de una extensión de Chrome?
Se necesita un runtime que corra en el navegador, como WebLLM para chat o transformers.js para tareas puntuales, metido en un Web Worker aparte del hilo de la UI. Los assets del runtime (binarios WASM, pesos del modelo) tienen que estar empaquetados dentro de la extensión o cacheados localmente, porque el CSP de Manifest V3 bloquea cargas desde un CDN externo.
¿Por qué falla transformers.js en una extensión Manifest V3?
Falla porque ONNX Runtime Web, el motor que usa transformers.js por debajo, intenta cargar su loader WASM desde un CDN por defecto, y el CSP de Manifest V3 (script-src 'self' 'wasm-unsafe-eval') no permite scripts de hosts remotos. La solución es copiar esos archivos adentro de la extensión y apuntar wasmPaths a esa ruta local.
¿Qué diferencia hay entre WebLLM y transformers.js?
WebLLM está pensado para modelos de chat corriendo sobre WebGPU, mientras que transformers.js cubre pipelines de tarea específica (resumen, clasificación, embeddings) sobre ONNX Runtime, con WASM o WebGPU según el caso. En AWFlow conviven los dos porque cada uno resuelve un tipo de nodo distinto.
¿Cómo evitar que la interfaz se congele al cargar un modelo de IA en el navegador?
Metiendo toda la inferencia, desde la descarga hasta la compilación y la generación de tokens, en un Web Worker separado del hilo donde corre la UI. Así el side panel o la pestaña se quedan respondiendo mientras el modelo carga de fondo.
¿Qué pasa si el usuario no tiene WebGPU disponible?
El sistema cae a WASM de forma automática, probando el adaptador una sola vez y memoizando el resultado para no repetir el chequeo. Es más lento que WebGPU, pero corre en cualquier máquina, incluso sin placa de video dedicada.
Conclusión
Lo que publicó dannickstark no es una idea nueva (correr modelos en el navegador ya existe hace rato), pero el detalle de la implementación sirve como mapa real para cualquiera que esté armando algo parecido. Los dos hallazgos que importan son el bloqueo del CSP sobre el loader WASM de ONNX Runtime y la necesidad de sacar la inferencia a un Web Worker aparte, con un fallback a WASM cuando no hay WebGPU. Si estás pensando en meter IA local en tu propia extensión, el camino práctico es: empaquetar los binarios del runtime adentro del build, nunca depender de un CDN, y dejar que el usuario cambie a un modelo en la nube (OpenAI, Anthropic, Google o Ollama) solo cuando el nodo lo justifique. Local por default, no local como única opción.