En pocas palabras: Sí: MAI-DxO, el orquestador de IA de Microsoft basado en GPT-5 y GPT-5.5, acertó el 83% de 304 casos complejos del NEJM, según el estudio publicado el 22 de octubre de 2026 en Science, superando el 36% de médicos con acceso a recursos.
MAI-DxO, el orquestador de agentes de IA de Microsoft, acertó el diagnóstico en el 83% de 304 casos clínicos complejos del New England Journal of Medicine, según el estudio publicado el 22 de octubre de 2026 en la revista Science. Los médicos generalistas, en el mismo set de casos, acertaron solo el 36% con acceso a libros e internet, y 22% sin esos recursos.
MAI-DxO (Microsoft AI Diagnostic Orchestrator) es un sistema de inteligencia artificial de Microsoft que simula un panel de médicos virtuales para resolver diagnósticos médicos complejos paso a paso. Corre sobre modelos de OpenAI, principalmente GPT-5 y GPT-5.5, y fue evaluado con un benchmark propio llamado SDBench, diseñado para medir razonamiento clínico secuencial en vez de respuestas únicas tipo examen.
En este artículo:
- Resumen rápido
- ¿Qué resultados publicó Microsoft sobre MAI-DxO en Science?
- ¿Cómo funciona el orquestador de agentes mai dxo de microsoft?
- ¿Por qué mai dxo de microsoft también resultó más económico que los médicos?
- ¿Qué limitaciones tiene y qué falta para que se use en hospitales reales?
- Qué está confirmado y qué no
- ¿Qué significa esto para el futuro de la IA en salud?
- Errores comunes al interpretar este estudio
- Preguntas Frecuentes
- Conclusión
- Fuentes
Resumen rápido
- MAI-DxO logró 83% de precisión en 304 casos complejos del NEJM, contra 36% de médicos con acceso a recursos.
- En casos típicos de guardia (MIMIC-IV-ED), el sistema llegó a 80% de aciertos frente a 47% de los médicos.
- Una configuración optimizada alcanzó 81% de precisión a menos de la mitad del costo de sistemas comparables, según el anuncio oficial de Microsoft AI.
- Microsoft ya firmó una alianza con Beth Israel Deaconess Medical Center en Boston para probar el sistema con pacientes reales.
- El estudio reconoce que buena parte de la mejora viene del modelo base (GPT-5), no solo de la capa de orquestación.
¿Qué resultados publicó Microsoft sobre MAI-DxO en Science?
Microsoft publicó que MAI-DxO alcanzó 83% de precisión diagnóstica en 304 casos complejos tomados de proceedings del NEJM, contra 36% de médicos generalistas con acceso a bibliografía e internet y 22% sin esos recursos, según el paper oficial de Microsoft AI. Eso lo deja entre 2,3 y 3,7 veces más preciso que un médico humano en ese tipo de casos.
En casos más típicos de guardia, usando el dataset MIMIC-IV-ED, la diferencia fue menor pero igual contundente: 80% para MAI-DxO contra 47% para los médicos, 1,7 veces más. Ponele que estás en una guardia a las 3 de la mañana con un caso ambiguo: ese es el escenario que simula este segundo dataset, no el caso de libro de texto con diez páginas de historia clínica.
El dato que más me llamó la atención es que los resultados se mantuvieron, e incluso mejoraron, cuando Microsoft repitió la evaluación con GPT-5.5 sin tocar el método de orquestación. Eso sugiere que el enfoque no depende de un modelo específico, aunque habría que ver qué pasa con modelos de otras compañías, porque según Infobae, Microsoft también probó modelos de OpenAI, Google, Anthropic, Meta y DeepSeek, y la mejor combinación siguió siendo con GPT-5 y GPT-5.5.
¿Cómo funciona el orquestador de agentes mai dxo de microsoft?
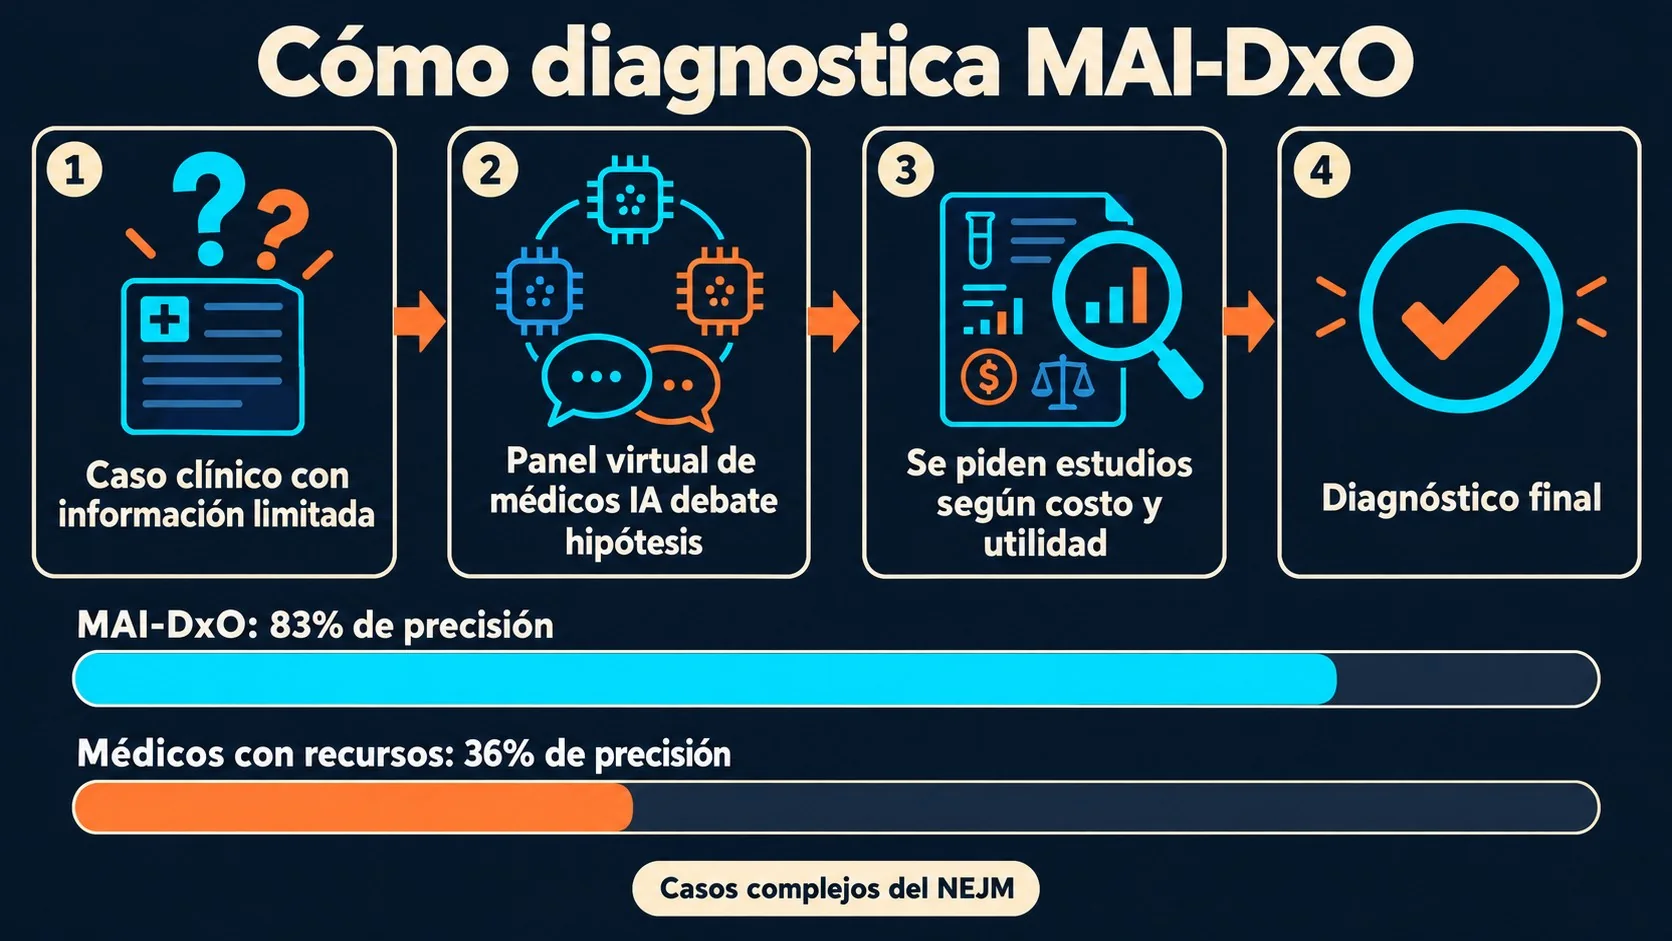
MAI-DxO no es un modelo tirando una respuesta de una. Es un panel virtual de médicos-IA que debate en rondas: cada “médico” propone diagnósticos, pide estudios o preguntas puntuales, y los demás cuestionan esa hipótesis a medida que llega evidencia nueva. Complementá con guía completa sobre seguridad en Microsoft.
El mecanismo imita cómo trabaja un médico real en la práctica, no cómo responde un examen de opción múltiple. Pensalo así: en el USMLE (el examen de licencia médica en EE.UU.) toda la información aparece de entrada y elegís una respuesta. En una guardia real nadie te da el cuadro completo de arranque, vas pidiendo estudios, descartando hipótesis, y cada decisión tiene un costo. Por eso Microsoft construyó SDBench (Sequential Diagnosis Benchmark), que mide no solo si el diagnóstico final es correcto sino también qué camino tomaste para llegar ahí: cuántos estudios pediste, cuánto costaron, cuánto tardaste.
Subís el caso, el sistema pide un dato, evalúa la respuesta, ajusta la hipótesis, pide otro dato, vuelve a ajustar, y así durante varias rondas hasta que el panel converge en un diagnóstico, todo esto mientras calcula en paralelo el costo estimado de cada estudio pedido. Microsoft va a liberar como código abierto una porción de SDBench (incluyendo el Gatekeeper, el Judge y el código de estimación de costos) para que otros equipos puedan reproducir o cuestionar los números, algo que suma puntos de transparencia en un campo donde los benchmarks propios del fabricante siempre merecen ser tomados con pinzas.
¿Por qué mai dxo de microsoft también resultó más económico que los médicos?
MAI-DxO llegó al diagnóstico correcto gastando la mitad o un tercio de lo que cuesta el camino diagnóstico típico de un médico, según el mismo estudio en Science. Una de las configuraciones probadas alcanzó 81% de precisión en casos NEJM a menos de la mitad del costo de sistemas comparables.
El tema es que esa ganancia de costo no viene gratis. Según el reporte de Infobae, GPT-5 usado solo (sin el orquestador) ya acertaba el 78,9% de los casos complejos, con un costo estimado de USD 8.400 por caso. Al sumarle MAI-DxO, el costo bajó unos USD 3.000, pero la precisión subió apenas 4 puntos porcentuales. En los casos de guardia de emergencias la diferencia entre usar GPT-5 solo o con el orquestador fue casi nula.
¿Y entonces de dónde viene la mejora real? Mayormente del modelo base. Un vocero de Microsoft explicó que las ganancias se reducen a medida que el modelo se acerca a un techo teórico de aciertos, y que el trabajo de MAI-DxO es equilibrar precisión con costo, no necesariamente empujar el techo de precisión hacia arriba. Es un matiz importante que no suele aparecer en los titulares de “la IA le gana a los médicos”, y que conviene tener presente antes de sacar conclusiones apresuradas. En los planes y precios de Copilot profundizamos sobre esto.
¿Qué limitaciones tiene y qué falta para que se use en hospitales reales?
MAI-DxO todavía no se usa en hospitales con pacientes reales: todo lo publicado hasta ahora es evaluación sobre casos escritos de benchmark, no un despliegue clínico. Microsoft lo deja bastante claro en su propio comunicado, aunque el framing mediático a veces lo deja de lado.
Eso sí: ya hay un paso concreto hacia la práctica real. Microsoft anunció una alianza con Beth Israel Deaconess Medical Center en Boston para un estudio prospectivo donde pacientes van a interactuar directamente con el sistema, y su desempeño se va a medir contra evaluaciones independientes de médicos. Todavía no hay fecha de resultados ni de cuántos pacientes va a incluir ese estudio.
Qué está confirmado y qué no
- Confirmado: el paper en Science con los números de 83% vs 36% en NEJM y 80% vs 47% en MIMIC-IV-ED, publicado el 22 de octubre de 2026.
- Confirmado: la alianza con Beth Israel Deaconess Medical Center para un estudio prospectivo con pacientes reales.
- Confirmado: la colaboración con Mayo Clinic para desarrollar un modelo de base especializado en salud.
- No confirmado: fecha de lanzamiento del modelo de Mayo Clinic. Mustafa Suleyman, director de IA de Microsoft, dijo a TechCrunch que el objetivo es “2027”, pero no hay fecha oficial.
- No confirmado: si MAI-DxO va a integrarse a productos comerciales como Dragon Copilot o si va a quedar limitado a investigación.
Suleyman también dijo que Copilot y Bing ya reciben 50 millones de consultas de salud por día, un dato que da contexto sobre la escala del negocio detrás de este anuncio, aunque no es evidencia directa de que MAI-DxO esté operando en esos canales.
¿Qué significa esto para el futuro de la IA en salud?
Microsoft enmarca todo esto dentro de lo que llama “superinteligencia médica”, un concepto que desarrolla en un paper paralelo publicado en BMJ Digital Health and AI esta misma semana. La idea no es solo diagnosticar bien, sino conectar diagnóstico, tratamiento y seguimiento longitudinal del paciente en un solo sistema. Más contexto en paper sobre fiabilidad de agentes de IA.
Para eso, la compañía está integrando equipos que antes trabajaban separados: investigadores de Microsoft Research y los equipos detrás de productos como Dragon Copilot (dictado médico) y PowerScribe (radiología) ahora forman parte de un esfuerzo unificado dentro de Microsoft AI. Microsoft presenta a MAI-DxO como una extensión de herramientas que ya vende a hospitales, no como un reemplazo de médicos, algo que tiene sentido desde lo comercial: es mucho más fácil vender “apoyo diagnóstico” que “reemplazo de especialistas”, y evita todo el lío regulatorio de aprobar un sistema autónomo.
¿Va a cambiar esto cómo se diagnostica en los hospitales mañana? No. Lo que sí cambia es el estándar de comparación: a partir de ahora, cualquier sistema de IA médica que salga va a tener que compararse contra estos números de MAI-DxO, lo que probablemente acelere la publicación de benchmarks similares por parte de Google Health, Anthropic o cualquier otro laboratorio con ambiciones en salud.
Errores comunes al interpretar este estudio
- Pensar que “le gana a los médicos” significa que ya se usa en hospitales. Son casos de benchmark escritos, no pacientes reales todavía. El estudio prospectivo con Beth Israel recién empieza.
- Atribuir toda la mejora a la “magia” del orquestador. Buena parte del salto viene del modelo base GPT-5/GPT-5.5. En casos de guardia, la diferencia entre usar el modelo solo o con MAI-DxO fue casi nula.
- Comparar contra médicos sin recursos como si fuera la práctica normal. El 22% de aciertos sin libros ni internet no representa cómo trabaja un médico real; el comparativo más justo es el 36% con recursos, que sigue siendo bajo frente al 83% de MAI-DxO, pero menos “catastrófico” que el otro número.
- Ignorar que el benchmark es del propio fabricante. Microsoft va a liberar parte del código para que se pueda replicar, lo cual es un buen gesto, pero hasta que terceros lo repliquen de forma independiente, conviene tomar los números con cierta cautela.
Preguntas Frecuentes
¿Qué es MAI-DxO de Microsoft?
MAI-DxO (Microsoft AI Diagnostic Orchestrator) es un sistema de IA que coordina un panel virtual de modelos para diagnosticar casos clínicos complejos paso a paso, en vez de dar una respuesta única e inmediata. Corre principalmente sobre GPT-5 y GPT-5.5 de OpenAI y fue publicado por Microsoft en Science el 22 de octubre de 2026. Ampliamos el tema en el chip Azure Maia 300 de Microsoft.
¿Cómo logró MAI-DxO superar a los médicos en diagnósticos?
MAI-DxO acertó el 83% de 304 casos complejos del NEJM simulando un debate entre “médicos virtuales” que piden estudios, proponen diagnósticos y se cuestionan entre rondas, a diferencia de un médico que suele formarse una hipótesis más temprano en el proceso. Los médicos humanos en el mismo set acertaron 36% con acceso a recursos externos. Ya lo cubrimos antes en la apuesta de Microsoft por Agent 365.
¿MAI-DxO ya se usa en hospitales reales?
No, todavía no. Los resultados publicados son de evaluación sobre casos de benchmark escritos. Microsoft recién arrancó una alianza con Beth Israel Deaconess Medical Center en Boston para un estudio prospectivo con pacientes reales, sin fecha confirmada de resultados. Cobertura relacionada: la expansión de la nube soberana europea.
¿Qué modelo de IA usa MAI-DxO?
MAI-DxO usa principalmente GPT-5 y GPT-5.5 de OpenAI como modelos base, aunque Microsoft también evaluó modelos de Google, Anthropic, Meta y DeepSeek durante el desarrollo. La mejor combinación de precisión y costo se logró con los modelos de OpenAI, según reportó Infobae.
¿MAI-DxO reemplaza a los médicos?
No, Microsoft lo presenta como una herramienta de apoyo diagnóstico, no como un reemplazo de médicos. La compañía lo posiciona como extensión de productos que ya vende a hospitales, como Dragon Copilot y PowerScribe, dentro de una estrategia que llama “superinteligencia médica”.
Conclusión
Lo que cambió esta semana no es que la IA “le gane” a los médicos (ese framing es demasiado simplón), sino que Microsoft publicó, en una revista con revisión por pares, un benchmark reproducible que mide razonamiento diagnóstico paso a paso y no solo respuestas tipo examen. Eso importa porque establece una vara de comparación que antes no existía de forma estandarizada.
Lo que todavía no sabemos es cómo se comporta MAI-DxO con pacientes reales, con historias clínicas incompletas, con pacientes que mienten sobre sus síntomas o no hablan bien el idioma del médico. El estudio con Beth Israel Deaconess va a ser la prueba que realmente importa. Hasta entonces, lo prudente es leer estos números como un techo de laboratorio, no como una garantía de lo que va a pasar en una guardia real. Si trabajás en salud o en IA aplicada a diagnóstico, vale la pena seguir de cerca ese próximo estudio en vez de quedarte solo con el titular de “83% vs 36%”.