En pocas palabras: MiniMax liberó los pesos de M3.1 Flash el 23 de octubre de 2026 en Hugging Face, con soporte día cero de vLLM. El checkpoint NVFP4 pesa 250.1 GB (44.6% menos que M3) y el KV cache usa 34.560 bytes por token, un 43.75% menos que en FP8.
MiniMax liberó los pesos de M3.1 Flash en Hugging Face el 23 de octubre de 2026, cuatro días después de anunciar el modelo. El mismo día, vLLM publicó soporte día cero con kernels para NVIDIA Blackwell, Rubin y AMD MI350, permitiendo self-hostear un modelo de 428B parámetros con cache NVFP4 nativo.
MiniMax M3.1 Flash es un modelo multimodal de mixtura de expertos (MoE) con aproximadamente 428.000 millones de parámetros totales y 23.000 millones activados por token, con ventana de contexto de hasta 1 millón de tokens. Usa atención dispersa (MSA) y cuantización NVFP4 tanto en los expertos como en el KV cache, pensado para self-hosting eficiente en memoria.
En este artículo:
- En 30 segundos
- ¿Qué significa que los pesos de MiniMax M3.1 Flash ya estén disponibles?
- ¿Cómo funciona la atención dispersa y el KV cache NVFP4 de M3.1 Flash?
- ¿Qué soporte día cero ofrece vLLM para MiniMax M3.1 Flash?
- ¿Cuáles son los límites reales de esta optimización de memoria?
- ¿Qué implica esto en la práctica para quien quiere self-hostear el modelo?
- MiniMax M3.1 Flash vs M3 MXFP8: la tabla que importa
- Qué está confirmado y qué no sobre MiniMax M3.1 Flash
- Errores comunes al evaluar un lanzamiento de pesos abiertos
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Los pesos de MiniMax M3.1 Flash se publicaron el 23 de octubre de 2026 en Hugging Face, cuatro días después del anuncio del 19 de octubre.
- El checkpoint pesa 250.1 GB en NVFP4, un 44.6% menos que los 451.5 GB de la versión MXFP8 de M3.
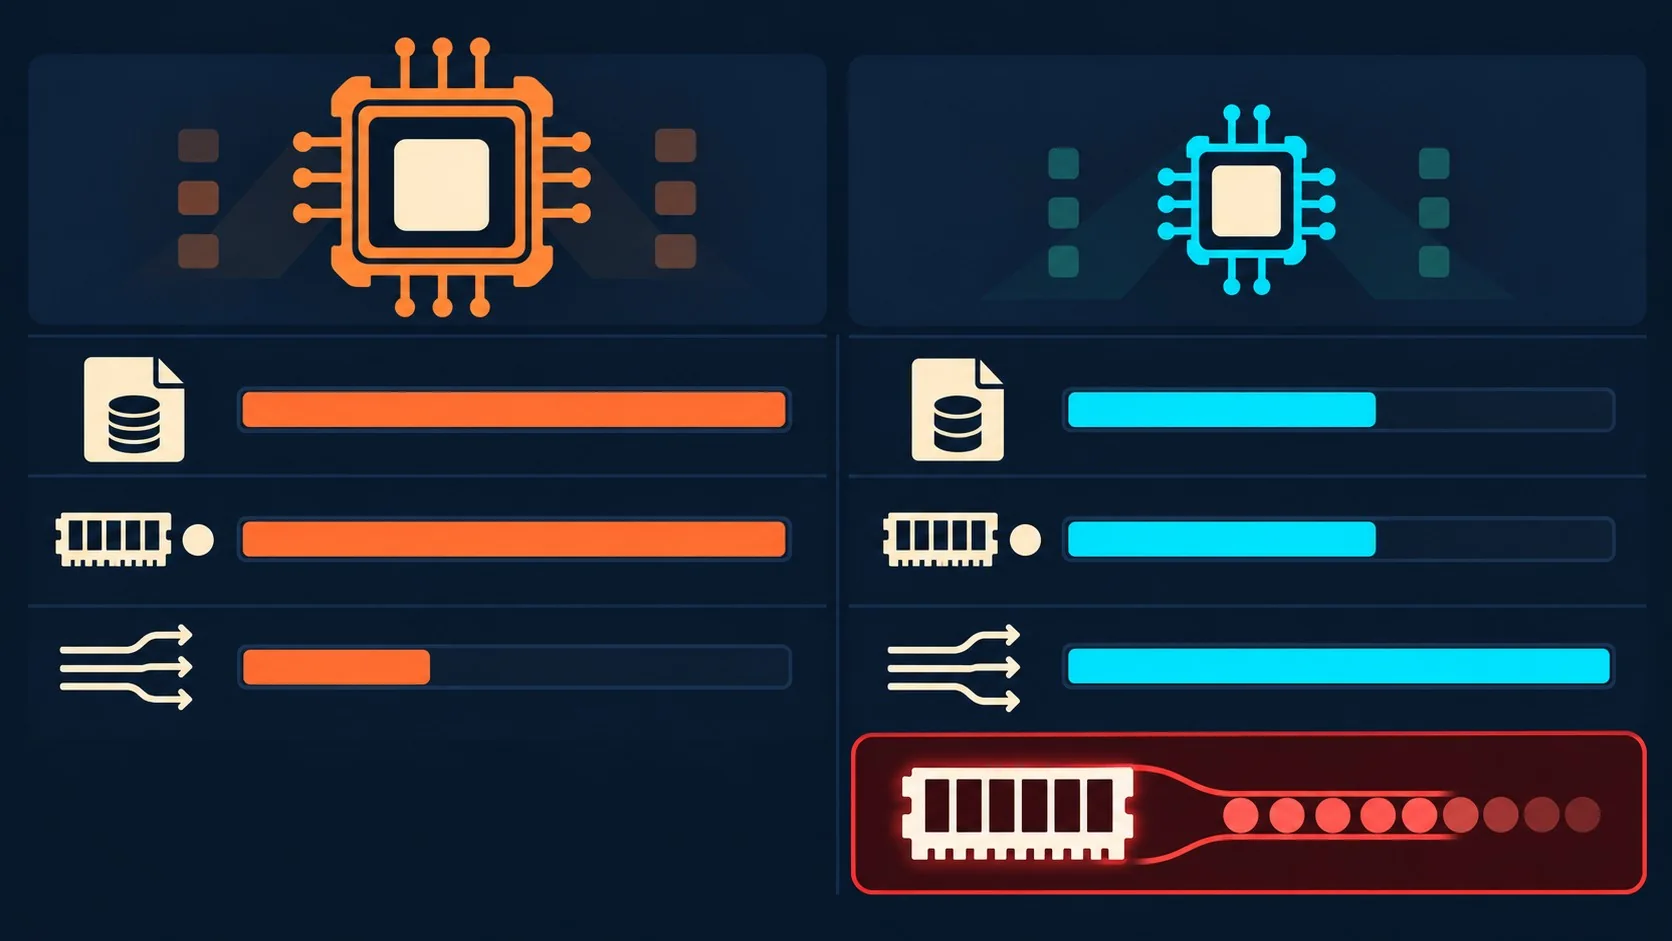
- El KV cache NVFP4 usa 34.560 bytes por token contra 61.440 bytes en FP8, una reducción del 43.75%.
- En 4x NVIDIA B300 a 256K de contexto, M3.1 soporta 76 secuencias concurrentes contra 28 de M3, 2.7 veces más en el mismo hardware.
- vLLM ofrece imágenes Docker prearmadas (
vllm/vllm-openai:minimax-m31-flashy variante ROCm) pero el wheel de PyPI tarda cerca de una semana en revisión.
¿Qué significa que los pesos de MiniMax M3.1 Flash ya estén disponibles?
Significa que el modelo pasó de ser una API cerrada a ser un checkpoint que cualquiera puede descargar y correr en su propia infraestructura. El 19 de octubre, MiniMax anunció M3.1 Flash con la API ya activa y los benchmarks publicados, según el análisis de Maya Brennan en Dev.to. Pero esa era la fecha del marketing, no la fecha de la infraestructura.
Para quien quería self-hostear, el 19 de octubre fue una promesa. El 23 de octubre, cuatro días después, llegó el producto real: los pesos abiertos en Hugging Face y, el mismo día, el soporte día cero de vLLM con kernels listos para producción.
Ojo con esto: la brecha entre “se anunció” y “se puede correr” es la que mide si un lanzamiento es real o es solo una nota de prensa. Si alguna vez esperaste semanas a que un modelo “open” tuviera kernels decentes, sabés de qué hablo. Acá no hubo esa espera.
¿Cómo funciona la atención dispersa y el KV cache NVFP4 de M3.1 Flash?
MiniMax Sparse Attention (MSA) limita cada consulta a leer un máximo de 2.048 keys, sin importar cuán largo sea el contexto. Un indexador liviano puntúa cada key del contexto, agrupa esos puntajes en bloques de 128 tokens mediante max-pooling, y la atención principal corre exacta pero solo sobre los 16 bloques con mejor puntaje.
El bloque más reciente siempre se mantiene, así que no hay pérdida de contexto inmediato. Según el post técnico de vLLM, esto reduce el tráfico de memoria HBM en decode a cerca del 12.5% de lo que lee la atención densa en contextos largos. Eso es lo que hace viable un contexto de 1M tokens sin que el ancho de banda de memoria colapse.
Lo que cambia la ecuación de costos no es solo la arquitectura dispersa, es la cuantización. Los expertos MoE ruteados están guardados en NVFP4 y el KV cache es NVFP4 nativo, entrenado así desde el principio (quantization-aware training). Eso achica el checkpoint de 451.5 GB en la versión M3 MXFP8 a 250.1 GB, y el KV cache por token baja de 61.440 bytes en FP8 a 34.560 bytes. Esto se conecta con lo que analizamos en otros modelos open source como GLM-5.3.
El modelo también viene con DSpark, un drafter de decodificación especulativa incluido en el release, que ayuda a acelerar la generación token por token sin tocar la calidad del output.
¿Qué soporte día cero ofrece vLLM para MiniMax M3.1 Flash?
vLLM publicó kernels específicos para tres familias de hardware el mismo día que salieron los pesos, no semanas después. Esto incluye imágenes Docker listas para usar y recetas completas de despliegue.
Los puntos más concretos, según el changelog de vLLM:
- Kernels Blackwell con QMUL4: usan la nueva instrucción de CUDA 13.4 para dequantizar NVFP4 a FP8 dentro del kernel, hasta 1.7x más rápido en decode del indexador y 1.3x en decode de atención dispersa.
- NVFP4 MegaMoE: extensión de DeepGEMM con expertos compartidos fusionados en MXFP8, con 20% menos latencia de kernel en prefill y 7% más throughput en prefill.
- Context parallelism en decode del indexador: hasta 3.3x más rápido por capa dispersa a 512K de contexto en 4x GB300.
- Kernel fusionado QKV+norm+RoPE+KV-insert: entre 1.1x y 1.6x más rápido en prefill, con ~19% menos P50 de time-to-first-token en TP4.
- Kernels dedicados para Rubin: optimización lista para hardware que recién está llegando al mercado.
- Port a AMD MI350: lookup table de 2 KB en memoria compartida para dequantización NVFP4, y un “mono kernel” que colapsa cerca de 1.170 llamadas de kernel por capa en una sola.
Las imágenes prearmadas son vllm/vllm-openai:minimax-m31-flash para NVIDIA y la variante ROCm para AMD. Esto es lo que separa un checkpoint de investigación de algo que podés poner detrás de un endpoint este fin de semana.
¿Cuáles son los límites reales de esta optimización de memoria?
La atención dispersa limita cuánto lee cada query, no cuánto almacena el cache. Todo el K y V de cada token sigue residente en memoria sin importar que la consulta solo use 2.048 keys, así que los despliegues de contexto largo siguen siendo memory-bound.
Esto es un caveat honesto que el propio equipo de vLLM metió en su post, no un detalle que haya que sacar con lupa. NVFP4 mueve la pared, no la elimina. La reducción de bytes por token ayuda a que la pared esté más lejos, pero sigue siendo una pared. Ya lo cubrimos antes en la competencia entre OpenAI y Deepseek.
¿Y cómo se traduce esto en números concretos? En 4x NVIDIA B300 con despliegue DEP4 y secuencias de 256K tokens, M3.1 fit 76 secuencias concurrentes donde M3 con KV cache FP8 fit 28. Eso es 2.7 veces más concurrencia en el mismo hardware, un salto real en throughput de servicio.
Dicho esto, los números de AgentX publicados (418.9 tokens por segundo por usuario en GB300, 724.9 en Rubin, 133.3M tokens por dólar de TCO en MI355X) son de un benchmark sintético con longitudes de aceptación específicas. Tratalos como techo, no como presupuesto real para tu caso de uso.
¿Qué implica esto en la práctica para quien quiere self-hostear el modelo?
Implica seguir un checklist antes de confiar en las cifras del vendor, no asumir que “70% más barato” se traduce directo a tu infraestructura. Antes de meter plata o tiempo en esto, hay pasos concretos que conviene cubrir.
- Verificá la página del checkpoint primero: no el blog de marketing, la ficha técnica real en Hugging Face.
- Leé el post del stack de serving antes que el anuncio del vendor: ahí están los números reales de kernels, no las cifras de benchmark elegidas para el lanzamiento.
- Chequeá si existen kernels para tu hardware específico: un checkpoint sin kernels optimizados es un artefacto de investigación, no algo que podés poner en producción.
- Fijá (pin) la imagen Docker: el wheel de PyPI va a tardar cerca de una semana en pasar revisión upstream, según vLLM. Si armás algo sobre esto, fijá el tag de imagen.
- Benchmarkeá tus propias trazas: una sesión real de agente de código, con tool calls, lecturas de archivos largas y reintentos, antes de que alguien cite el número de marketing en un documento de planificación.
Para quien hace fine-tuning, el soporte día cero de RL (veRL, FSDP2, LoRA sobre el checkpoint NVFP4) significa que el entrenador cuantiza el modelo base exactamente igual que lo sirve el motor de inferencia. Esto elimina una clase entera de bugs de desajuste entre entrenamiento y servicio, algo que cualquiera que haya migrado un modelo fine-tuneado a producción sabe que puede arruinarte una semana.
MiniMax M3.1 Flash vs M3 MXFP8: la tabla que importa
| Métrica | M3 (MXFP8) | M3.1 Flash (NVFP4) |
|---|---|---|
| Tamaño de checkpoint | 451.5 GB | 250.1 GB |
| KV cache por token | 61.440 bytes | 34.560 bytes |
| Secuencias concurrentes (4x B300, 256K ctx) | 28 | 76 |
| Precio API (input / output por millón de tokens) | N/D | USD 0.15 / USD 0.60 |
Esos precios de API, según el anuncio de MiniMax, hay que tratarlos como cifras del vendor hasta que terceros corran evaluaciones independientes. Lo mismo vale para los benchmarks que publicó la empresa: 73.7% en DeepSWE v1.1, 61.7 en OSWorld V2, 76.2 en BankerToolBench y 82.2 en CyberGym. Son consistentes con el run anónimo previo del modelo bajo el nombre “Space Bunny”, que procesó más de 200 billones de tokens antes de la revelación, pero consistencia no es verificación. Complementá con el hardware detrás del chip Jalapeño.
Qué está confirmado y qué no sobre MiniMax M3.1 Flash
Confirmado: los pesos están en Hugging Face desde el 23 de octubre, vLLM tiene soporte día cero con kernels para Blackwell, Rubin y AMD MI350, el tamaño del checkpoint es 250.1 GB en NVFP4, y las imágenes Docker prearmadas ya existen.
No confirmado: los benchmarks de MiniMax (DeepSWE, OSWorld, BankerToolBench, CyberGym) son cifras propias de la empresa sin evaluación independiente publicada todavía. Las cifras de AgentX (tokens por segundo por usuario, tokens por dólar de TCO) vienen de un benchmark sintético con longitudes de aceptación específicas, no de cargas de trabajo reales de producción.
Errores comunes al evaluar un lanzamiento de pesos abiertos
El primero es confundir la fecha de anuncio con la fecha de disponibilidad real. MiniMax anunció el 19 de octubre y la gente ya estaba sacando conclusiones sobre performance de self-hosting cuando ni los pesos existían públicamente. Esperá a que el checkpoint esté en Hugging Face antes de planificar infraestructura.
El segundo es tomar las cifras de AgentX o de cualquier benchmark de marketing como presupuesto de costos real. Son techos sintéticos con longitudes de aceptación específicas para decodificación especulativa, no tu carga de trabajo. Corré tu propia traza de agente antes de poner un número en un documento de planificación.
El tercero es ignorar que la atención dispersa no reduce lo que el cache almacena. Si estás dimensionando GPUs para contexto largo, seguís siendo memory-bound aunque MSA limite lo que cada query lee. NVFP4 corre la pared más lejos, no la saca del medio. Para más detalles técnicos, mirá cómo se comparan OpenAI y Anthropic.
El cuarto, más operativo: no fijar (pin) la imagen Docker. Si el wheel de PyPI tarda una semana en revisión y vos no fijaste el tag, cualquier rebuild de tu pipeline de CI puede romperse sin aviso.
Preguntas Frecuentes
¿Qué significa que salieron los pesos de MiniMax M3.1 Flash?
Significa que el checkpoint del modelo está disponible públicamente en Hugging Face desde el 23 de octubre de 2026, cuatro días después del anuncio inicial del 19 de octubre. Cualquiera puede descargarlo y correrlo en su propia infraestructura, con soporte día cero de vLLM el mismo día de publicación.
¿Cómo funciona la atención dispersa (MSA) de MiniMax M3.1 Flash?
Un indexador liviano puntúa cada key del contexto, agrupa esos puntajes en bloques de 128 tokens, y la atención principal corre exacta sobre los 16 bloques con mejor puntaje. Cada query queda limitada a un máximo de 2.048 keys sin importar el largo del contexto, lo que reduce el tráfico de memoria en decode.
¿Qué es el KV cache NVFP4 y por qué reduce memoria?
El KV cache NVFP4 es una representación cuantizada a 4 bits del cache de atención, entrenada nativamente con el modelo (quantization-aware training). Usa 34.560 bytes por token contra 61.440 bytes en FP8, una reducción del 43.75% que permite servir más secuencias concurrentes en el mismo hardware.
¿Qué hardware soporta vLLM para MiniMax M3.1 Flash?
vLLM soporta día cero NVIDIA Blackwell, NVIDIA Rubin y AMD MI350 series con kernels específicos para cada plataforma. Hay imágenes Docker prearmadas (vllm/vllm-openai:minimax-m31-flash para NVIDIA y una variante ROCm para AMD) listas para desplegar.
¿Los benchmarks de MiniMax M3.1 Flash son confiables?
Son cifras publicadas por el propio fabricante (73.7% en DeepSWE v1.1, 61.7 en OSWorld V2, entre otros) sin evaluación independiente todavía disponible. Conviene tratarlas como referencia direccional y correr benchmarks propios con cargas de trabajo reales antes de tomar decisiones de infraestructura basadas en esos números.
Conclusión
Lo que cambió el 23 de octubre no es solo que un modelo más se sumó a la lista de “open weights”. Cambió el estándar de qué significa día cero: kernels optimizados para tres familias de hardware, imágenes Docker listas, soporte de RL incluido, todo el mismo día que aparece el checkpoint. Eso es trabajo de co-diseño entre modelo y stack de serving, no un research artifact tirado en un repo.
Para quien evalúa esto en serio, la lección es procedimental más que técnica: separá la fecha de anuncio de la fecha de infraestructura real, verificá kernels para tu hardware específico antes de prometerle nada a nadie, y corré tu propia traza de agente antes de que las cifras de marketing terminen en un documento de planificación. Si manejás infraestructura propia (cloud, VPS, servidores dedicados) para este tipo de despliegues, donweb.com es una opción local a tener en cuenta para la capa de hosting que sostiene todo esto.