
En pocas palabras: THX-01, de HAL-X AI, es un modelo de decisión open source de 322 millones de parámetros (Apache 2.0) que, según el benchmark de sus autores, clasifica tickets con 98,4 % de precisión frente al 98,5 % de Claude Sonnet 5.5, y tarda unos 10 ms por pedido.
El modelo THX-01, de HAL-X AI, es un modelo de decisión open source de 322 millones de parámetros con licencia Apache 2.0. Según sus autores, clasifica tickets con 98,4 % de precisión (Claude Sonnet 5.5 marca 98,5 %) y tarda unos 10 ms por pedido en una GPU.
THX-01 es un modelo de decisión no autorregresivo y multilingüe: recibe un texto (un ticket, un mail, un documento o un registro JSON) junto con preguntas tipadas en lenguaje natural y devuelve, en una sola pasada, una probabilidad calibrada por cada opción. Sirve para rutear tickets, detectar spam y extraer valores de documentos. No redacta texto. Los autores lo publicaron el 8 de octubre de 2026.
En este artículo:
- En 30 segundos
- ¿Qué es un modelo de decisión no autorregresivo y en qué se diferencia de un LLM?
- ¿Qué resultados obtuvo el modelo THX-01 frente a Claude Sonnet 5.5?
- ¿Cómo se usa THX-01 con pip install thx01?
- ¿Cuáles son los límites del modelo THX-01?
- ¿Conviene reemplazar un LLM por THX-01 en un sistema de soporte?
- Qué está confirmado y qué no
- Errores comunes al evaluar THX-01
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Tamaño y licencia: 322M de parámetros (307M de encoder mmBERT-base y 15M de cabeza de decisión), Apache 2.0, instalación con
pip install thx01. - Precisión: 98,4 % promedio en 2.843 tickets en azerí, ruso, inglés y turco, contra 98,5 % de Claude Sonnet 5.5. El benchmark es de los autores.
- Velocidad: unos 10 ms por pedido en una GPU, contra 1,5 s de Sonnet 5.5 por API, y unas 3.000 decisiones por segundo en lote.
- Límites declarados: 65,9 % en Banking77 y 44,6 % en clasificación de emociones. El benchmark de tickets no incluye español.
¿Qué es un modelo de decisión no autorregresivo y en qué se diferencia de un LLM?
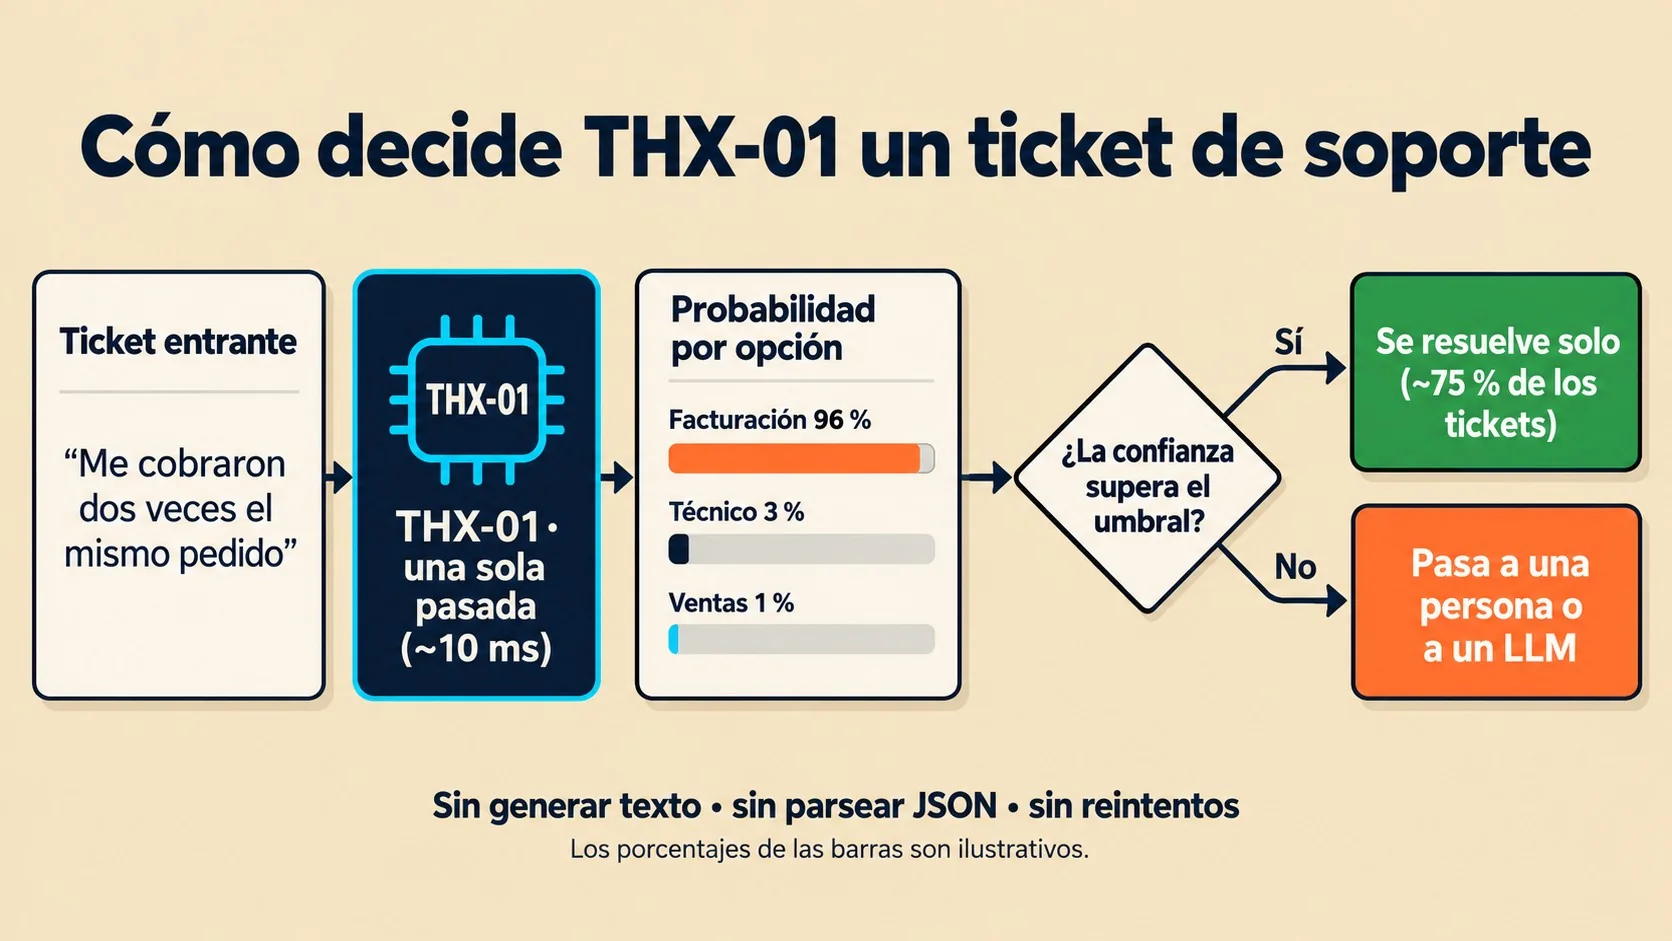
Un modelo de decisión no autorregresivo no genera texto token por token. Lee el texto y las opciones de una vez y devuelve una probabilidad para cada alternativa en un solo paso. Según el anuncio de los autores, con THX-01 no hay JSON que parsear ni reintentos.
Ponele que armás un flujo de soporte donde un LLM clasifica cada ticket, devuelve un JSON, lo parseás, de vez en cuando viene mal formado, reintentás, esperás un segundo y medio por pedido y cuando entran miles por día la cola crece al mismo ritmo que la factura de la API. Un modelo de decisión ataca ese cuello de botella: la respuesta ya llega estructurada.
Según la model card en Hugging Face, estos son los tipos de pregunta que acepta:
- choice: una opción entre N, con la probabilidad de cada una.
- noul: la probabilidad de “sí” en una pregunta de sí o no.
- score: un nivel ordinal con su distribución.
- number: un valor numérico tal como aparece en el documento, o null si no está. Normaliza “1,2 mln” a 1200000, pero no convierte monedas ni unidades.
- excerpt: un fragmento textual con sus posiciones. Como lo recorta del documento, no puede inventar texto.
- “cite”: true: en cualquier pregunta, devuelve las partes del documento que respaldan la respuesta, con probabilidades.
Por dentro, el modelo THX-01 es un encoder mmBERT-base de 22 capas y 256k de vocabulario más una cabeza de decisión de 15M. Cada pregunta entra con sus opciones y el estado, hasta 1.024 tokens, y lo que pase de ahí se trunca. El entrenamiento usa RLCD (aprendizaje por refuerzo para decisiones calibradas), con una regla de puntaje estrictamente propia: la recompensa se maximiza solo si reportás la probabilidad verdadera. Los autores atribuyen a ese diseño el ECE de 0,003 (el ECE mide cuánto se desvía la confianza declarada del acierto real, y esa cifra se midió en el set Independent). Para más detalles técnicos, mirá cómo elegir entre Sonnet y Opus.
El desarrollador es HAL-X AI. El post de lanzamiento la ubica en Bakú, Azerbaiyán, y la cita técnica de la model card firma Farid Aghayev y Elturan Ahmadbayli. Las fuentes no dicen más sobre la empresa.
¿Qué resultados obtuvo el modelo THX-01 frente a Claude Sonnet 5.5?
En el benchmark de tickets de los autores (2.843 tickets en azerí, ruso, inglés y turco, con 15 categorías), THX-01 promedia 98,4 % y Claude Sonnet 5.5 promedia 98,5 %. La diferencia grande está en el tiempo: unos 10 ms contra 1,5 s, según la model card.
| Modelo | Precisión promedio | Latencia | ECE |
|---|---|---|---|
| THX-01 (322M) | 98,4 % | ~10 ms | 0,003 |
| Claude Sonnet 5.5 | 98,5 % | 1,5 s | sin probabilidades |
| Wahoo 1.5 | 97,8 % | 145 ms | sin dato |
| GPT-6-Luna | 97,7 % | 1,9 s | sin probabilidades |
| TypeSafe Jev 1.13 | 97,4 % | 331 ms | 0,007 |
| Kev-4B | 92,8 % | 830 ms | 0,202 |
Lo que muestran los datos: un empate técnico de precisión (una décima de diferencia) y una brecha enorme de latencia, de unas 150 veces. Lo que no muestran es que THX-01 gane en todo. En el set Independent, escrito por GPT-6-Luna y nunca usado para entrenar, Sonnet 5.5 saca 99,0 % contra 97,9 %. En el set Clean, Wahoo 1.5 llega a 99,8 %.
Antes de festejar, fijate en la letra chica:
- Benchmark propio. Lo armaron y lo corrieron los autores. Las fuentes no mencionan una replicación independiente.
- Subconjunto para Sonnet. La model card aclara que Sonnet 5.5 se evaluó sobre 200 tickets estratificados por set.
- Latencias que no se comparan 1 a 1. THX-01 se midió en una GPU; los demás modelos, a través de sus APIs, con la red incluida.
- Maestro y alumno. La model card lista a Claude Sonnet 5.5 entre los modelos que generaron datos sintéticos de entrenamiento (con verificación ciega y exclusión de los ítems de prueba). No invalida nada, pero conviene tenerlo presente.
En lote, la model card informa alrededor de 1 ms por decisión, 150 pedidos en unos 156 ms y un pico de unas 3.000 decisiones por segundo.
¿Cómo se usa THX-01 con pip install thx01?
Instalás con pip install thx01, cargás el modelo con thx01.load("doofz/THX-01") y llamás a agent.decide(texto, preguntas). Según la página del paquete en PyPI, los pesos se descargan desde Hugging Face la primera vez que lo usás. Para el servidor REST, instalás "thx01[server]".
Este es el ejemplo del post de lanzamiento, reordenado para que se lea mejor:
import thx01

agent = thx01.load("doofz/THX-01")

result = agent.decide(
 "My card was charged twice for one order",
 {
 "team": {
 "type": "choice",
 "question": "Which team handles this?",
 "criteria": {
 "billing": "billing",
 "tech": "technical",
 "sales": "sales",
 },
 }
 },
)
El modelo devuelve una probabilidad para billing, tech y sales, y un doble cobro debería caer en billing. Eso último es lo esperable, no un resultado que las fuentes muestren. Más contexto en las capacidades de Claude Sonnet 4.6.
La página de PyPI trae un caso más rico. Con un texto de resultados trimestrales de Northwind Corp., hace tres preguntas: una choice para clasificar el documento, una number sobre los ingresos en dólares con cite activado y una excerpt para lo que dijo el CEO. Según los comentarios del ejemplo, devuelve “earnings”, 48300000 junto con la oración que lo respalda, y el fragmento textual que arranca con “We will open two offices in Baku”.
- Servidor REST:
THX01_MODEL=doofz/THX-01 THX01_API_KEY=tu-clave python -m thx01.server --port 8095. Los endpoints sonPOST /v1/decidey/v1/decide/batch, con alias/v1/systemonepara reemplazar sin cambios servicios de estilo TypeSafe. - Hardware: el post dice que es apto para CPU y “potencialmente” smartphones. Los ~10 ms son en una GPU, y no hay cifras de latencia en CPU.
- Entrada: hasta 1.024 tokens por pregunta. Lo que sobra se trunca.
Si querés probar el servidor sin tocar producción, un VPS de donweb.com sirve para armar un entorno de prueba. Las fuentes no dan requisitos mínimos de memoria, así que medí vos.
¿Cuáles son los límites del modelo THX-01?
Los propios autores reconocen que el modelo THX-01 sufre con conjuntos de muchas etiquetas casi sinónimas: Banking77, con 77 intenciones, llega a 65,9 %. En emociones con seis clases superpuestas (DAIR Emotion) llega a 44,6 %, y la model card aclara que ahí el modelo reporta poca confianza.
Más datos de la misma model card:
- Extracción: number acierta el valor exacto en 93,4 % de las preguntas y excerpt llega a 84,1 de F1. En number, TypeSafe Jev 1.13 llega a 96,6 % sobre los mismos documentos.
- Sin aritmética: number y excerpt ubican texto presente en el documento. No suman, no convierten unidades ni parafrasean.
- Clasificación temática: en SIB-200 los resultados van de 68,1 % a 79,9 % según el idioma.
- Español: está entre los 18 idiomas del post-entrenamiento, pero el benchmark de tickets cubre azerí, ruso, inglés y turco. La única cifra en español es MASSIVE-scenario, con 87,8 %, y es otra tarea.
La model card dice que el encoder soporta más de 100 idiomas. Eso no equivale a validación en español rioplatense, con voseo, lunfardo y tickets escritos sin tildes. Hay que verificarlo.
¿Conviene reemplazar un LLM por THX-01 en un sistema de soporte?
Para ruteo, spam, prioridad y extracción de datos, el modelo THX-01 merece una prueba. Para redactar respuestas, no sirve. Los autores informan que con un solo umbral de confianza resolvió cerca de tres cuartas partes de los tickets de forma automática, sin errores en los cuatro sets, y que cubrió 90 % de los tickets con al menos 99,5 % de acierto. Sobre eso hablamos en todo lo que necesitás saber de Claude.
La lectura práctica (es una inferencia nuestra) es un esquema en capas: el modelo chico resuelve lo que supera el umbral y el resto va a una persona o a un LLM. Ejemplo hipotético: un e-commerce argentino recibe “me cobraron dos veces el envío”, y el modelo asigna billing con alta confianza y lo rutea solo. Otro ticket, “no me anda lo del cupón y encima llegó roto”, mezcla dos temas, queda con confianza baja y pasa a un agente. Las fuentes no dan cifras de ahorro, así que no hay números de costos.
Un criterio para verificarlo antes de producción (propuesta editorial, no viene de los autores y no la probamos):
- Juntá tickets reales. Unos cientos, etiquetados por alguien de soporte, con typos, sin tildes y con voseo.
- Guardá la probabilidad. Corré el modelo y registrá la confianza de cada respuesta, no solo la etiqueta ganadora.
- Buscá tu umbral. Ordená por confianza y fijate desde qué valor no hay errores y qué porcentaje de tickets cubre.
- Chequeá la calibración. Si el modelo dice 90 %, ¿acierta cerca de 90 %?
- Medí en tu hardware. Latencia en tu CPU o GPU, contra tu LLM actual sobre los mismos tickets.
Qué está confirmado y qué no
Todo lo “confirmado” es declarado por los autores en la model card y en el post; ninguna fuente muestra una verificación de terceros.
- Declarado por los autores: 322M de parámetros, licencia Apache 2.0, instalación con pip, 98,4 % en su benchmark de tickets, ~10 ms en una GPU, ECE de 0,003 y las limitaciones de Banking77 y DAIR Emotion.
- Sin verificar: replicación independiente de los números, desempeño en tickets en español, latencia en CPU, ejecución en smartphones (el post solo dice “potencialmente”) y cualquier ahorro de costos.
Errores comunes al evaluar THX-01
- Comparar latencias como si fueran iguales. Los 10 ms son de una GPU local y los 1,5 s de Sonnet incluyen la red. Medí ambos en tu entorno.
- Trasladar el 98,4 % a tus tickets. Ese número es de azerí, ruso, inglés y turco. Armá tu propio set en español.
- Quedarte con la etiqueta ganadora. El valor del modelo está en la probabilidad calibrada. Sin umbral, perdés lo que lo diferencia.
- Pedirle cuentas o conversiones. Si preguntás en euros y el documento está en dólares, number devuelve null.
- Mandar documentos largos sin revisar. Pasado 1.024 tokens por pregunta, el texto se trunca y puede quedar afuera justo lo que importaba.
Preguntas Frecuentes
¿Quién creó THX-01?
HAL-X AI desarrolló THX-01, según la model card en Hugging Face. El post de lanzamiento ubica a la empresa en Bakú, Azerbaiyán, y la cita técnica nombra como autores a Farid Aghayev y Elturan Ahmadbayli. Ya lo cubrimos antes en nuestra guía sobre modelos de lenguaje.
¿THX-01 es tan preciso como Claude Sonnet 5.5?
En el benchmark de tickets de los autores, THX-01 promedia 98,4 % y Claude Sonnet 5.5 promedia 98,5 %. Es una medición propia, con Sonnet evaluado sobre 200 tickets por set, y las fuentes no mencionan una replicación independiente.
¿Cómo se instala THX-01?
Se instala con pip install thx01, y para el servidor REST con pip install "thx01[server]". Después cargás el modelo con thx01.load("doofz/THX-01") y los pesos se descargan desde Hugging Face la primera vez.
¿THX-01 funciona en CPU o necesita GPU?
Según el post de lanzamiento, el modelo corre en CPU. Los ~10 ms por pedido que informan los autores son en una GPU, y las fuentes no publican latencia en CPU ni requisitos de memoria.
¿Qué diferencia hay entre un modelo de decisión y un LLM?
Un modelo de decisión elige entre opciones que le das y devuelve una probabilidad por cada una en una sola pasada. Un LLM genera texto token por token, y si necesitás un dato estructurado tenés que parsearlo.
Conclusión
El modelo THX-01 pone sobre la mesa una idea concreta: para decisiones repetitivas como rutear, filtrar spam o extraer un monto, un modelo de 322M con probabilidades calibradas puede igualar a un LLM grande en precisión y bajar la latencia de segundos a milisegundos. Esa es la promesa de los autores, con cifras sólidas en su benchmark y una licencia Apache 2.0 que deja probarlo sin pedir permiso.
Lo que falta es lo que más importa para quien lee esto desde Latinoamérica: nadie mostró todavía cómo se comporta con tickets en español rioplatense. Mi recomendación es instalarlo, armar un set chico de tickets propios, medir el umbral de confianza y decidir con esos datos. Si el umbral cubre un buen porcentaje sin errores, tenés un filtro rápido adelante del LLM. Si no, perdiste una tarde.