
En pocas palabras: Sí, pero con matices: cinco instancias de Qwen3.8-27B coordinadas sin entrenamiento adicional igualaron a Fable 5 en LiveCodeBench Hard (92.4% vs 90.4%), según el paper GVS5H (agosto 2026). La reproducción independiente, con un costo mediano de 0.39 dólares por ronda, usó solo 10 problemas, no 100.
Cinco instancias de Qwen3.8-27B, coordinadas entre sí sin entrenamiento adicional, alcanzaron 92.4% en LiveCodeBench Hard contra el 90.4% de Fable 5, según el paper GVS5H de Persis Capital publicado el 27 de agosto de 2026. El costo mediano por ronda en la reproducción con memdoor fue de 0.39 dólares. La pregunta que importa no es si el número es real (lo es), sino qué significa “ganar” cuando la muestra de verificación independiente tiene apenas 10 problemas.
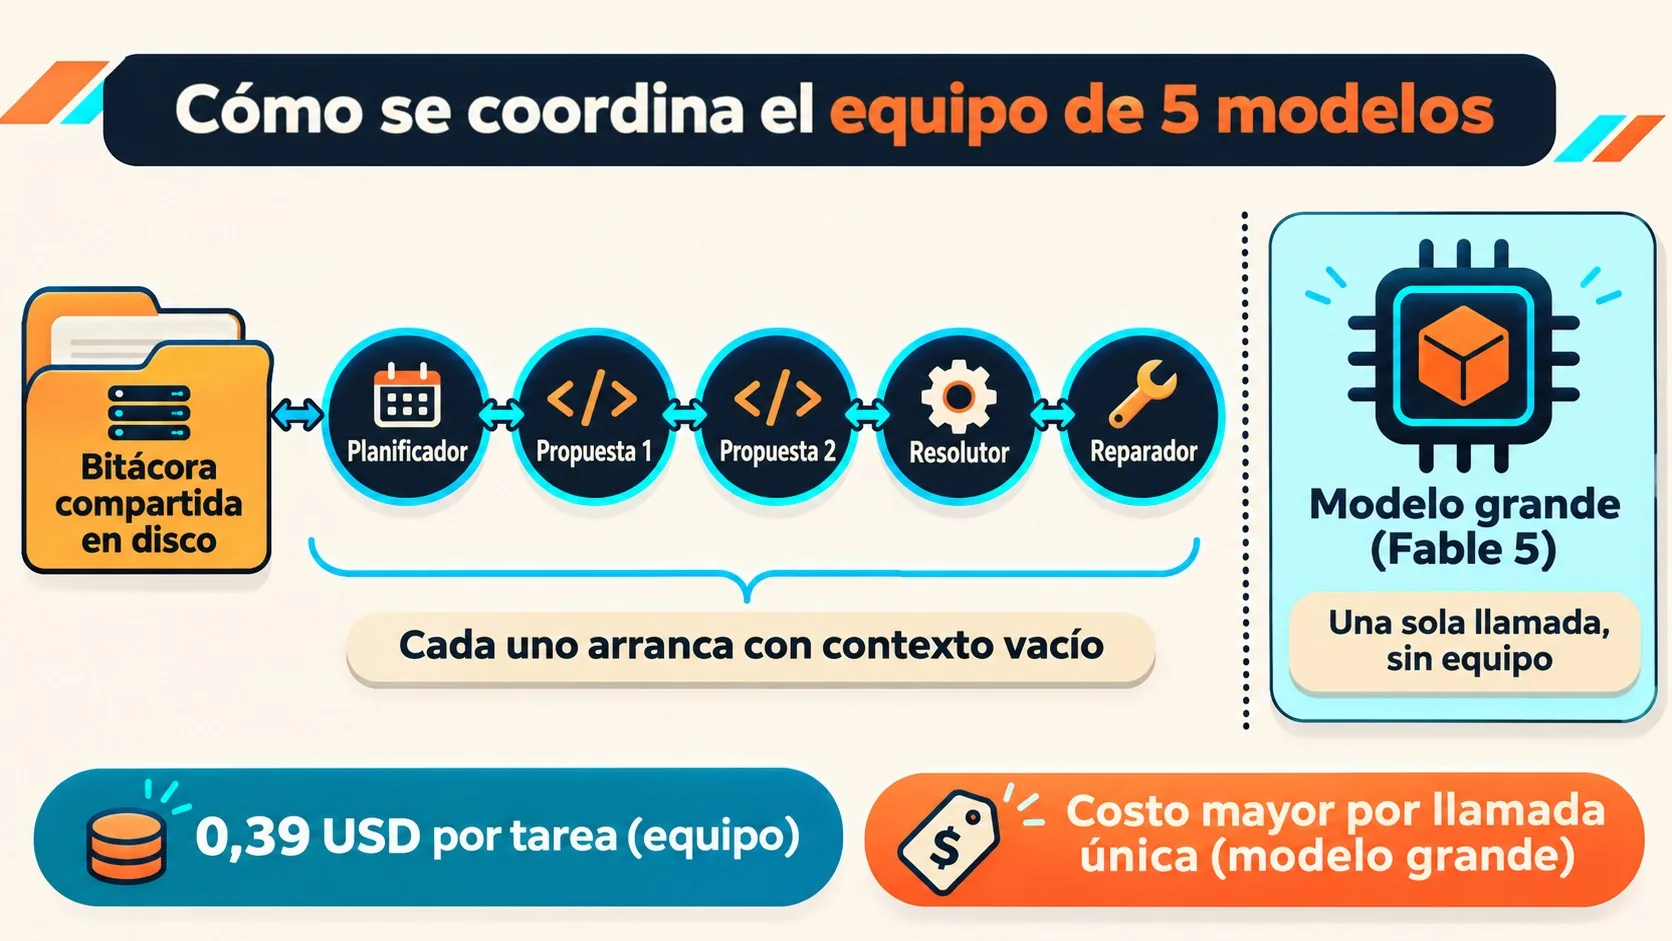
Los modelos de IA pequeños en equipo son un enfoque en el que varias instancias del mismo modelo de lenguaje, cada una con contexto vacío, se dividen una tarea de programación y coordinan su trabajo a través de archivos compartidos en disco (un plan, una bitácora, la solución vigente). El método se llama ledger-based zero-shot self-orchestration, al que los autores llaman GVS5H (sigla de “Gorilla vs. 5 Humans”), y no requiere fine-tuning: cualquier modelo puede usarse tal cual sale de fábrica.
En este artículo:
- En 30 segundos
- ¿Qué es exactamente el método GVS5H y quién lo creó?
- ¿Cuáles son los números reales detrás del 0.39 dólares por tarea?
- ¿Los 5 modelos pequeños le ganaron realmente a Fable 5?
- ¿Qué limitaciones reconocen los propios autores y la reproducción?
- ¿Cómo funciona memdoor y el workflow team-solve para reproducir el experimento?
- ¿Por qué el contexto fresco mejora el rendimiento y no es solo ahorro de tokens?
- ¿Qué se necesita para probar este método uno mismo?
- Comparativa: GVS5H orquestado vs Fable 5 solo
- Errores comunes al leer este dato
- Qué está confirmado y qué no
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El paper GVS5H (Persis Capital, 27 de agosto de 2026) reporta que Qwen3.8 Flash Next orquestado llega a 93.0% en LiveCodeBench Hard, contra 90.4% de Fable 5, con 9% del costo.
- La reproducción independiente de memdoor con el workflow team-solve usó solo 10 problemas (no 100) y midió 9.8/10 contra 9.6/10 del harness original y 8.0/10 de Fable 5 en llamada única.
- El costo mediano real por ronda fue 0.39 USD, con 40 minutos de mediana de tiempo; las 50 rondas completas costaron 35.79 USD en total.
- La mejora no es universal: el propio paper reconoce que algunos modelos quedan igual o peor con este método.
- Con una muestra de 10 casos, la diferencia entre 9.8 y 9.6 cae dentro del margen de error. Es empate técnico, no victoria.
¿Qué es exactamente el método GVS5H y quién lo creó?
GVS5H es un método de coordinación entre modelos de lenguaje que no necesita entrenamiento adicional: toma instancias frescas del mismo modelo y las hace cooperar a través de un sistema de archivos compartido. Lo desarrolló un equipo de Persis Capital (Victor Gao, Vida Khosrowshahi, Ali Khosrowshahi, Xihao Sun, Juhyun Lee y Simon Sang Won Lee), publicado en arXiv el 27 de agosto de 2026 y revisado el 21 de septiembre.
El código está bajo licencia MIT. El paper, las figuras y los datos de las corridas están bajo CC BY 4.0, lo que significa que cualquiera puede reproducir el experimento sin pedir permiso. Ponele que arrancás con una instancia de Qwen3.8-27B: en vez de que resuelva todo el problema sola, GVS5H crea varias copias nuevas de ese mismo modelo, cada una arranca sin memoria previa y todas se comunican leyendo y escribiendo en una carpeta compartida que guarda el plan de trabajo, notas de avance y la respuesta actual.
No hay fine-tuning, no hay pesos nuevos. Es puro diseño de flujo de trabajo (orquestación en tiempo de inferencia, le dicen los autores).
¿Cuáles son los números reales detrás del 0.39 dólares por tarea?
El 0.39 dólares es la mediana de costo por ronda en la reproducción de memdoor con el workflow team-solve, no un promedio del paper original. Las 50 rondas completas (10 problemas por 5 pasadas cada uno) sumaron 35.79 dólares en total, con una mediana de 40 minutos por ronda.
Ese número sale de ejecutar los modelos a través de OpenRouter, un proveedor cloud. No es el costo de electricidad de correr algo en tu propia máquina. Si corrés el mismo workflow en local con Ollama o llama.cpp, el “costo” deja de ser en dólares y pasa a ser tiempo de cómputo y los gigabytes que ocupa el modelo en disco. Más contexto en cómo funcionan los modelos de lenguaje con razonamiento.
El paper original reporta otra cifra, relacionada pero distinta: Qwen3.8 Flash Next orquestado usa apenas 9% del costo de Fable 5 para lograr un punto de accuracy más alto. Son dos mediciones de cosas parecidas pero no intercambiables: una es costo absoluto por ronda en un harness chico, la otra es costo relativo en el benchmark completo de 100 problemas.
¿Los 5 modelos pequeños le ganaron realmente a Fable 5?
En el benchmark completo del paper sí, por un margen de 2.6 puntos porcentuales (93.0% contra 90.4%). En la reproducción independiente con 10 problemas, no: la diferencia entre 9.8 y 9.6 sobre 10 no alcanza para hablar de victoria, es estadísticamente indistinguible.
El paper original probó 11 modelos abiertos y cerrados en los 100 problemas más recientes de LiveCodeBench Hard hasta agosto de 2026, y reporta mejoras de hasta 25.6 puntos en algunos casos. Qwen3.8 Flash Next orquestado llegó a 93.0%, Fable 5 (corrido como baseline de llamada única) quedó en 90.4%, y Qwen3.8-27B corrido en local saltó de 66.8% sin orquestación a 92.4% con el método aplicado.
Ahora bien: el equipo de memdoor reconstruyó el harness original con los prompts exactos de los autores, pero solo corrió los primeros 10 problemas de la lista, cinco pasadas cada uno. ¿El resultado? El workflow de memdoor sacó 9.8 de 10, el harness original de los autores (aplicado a esos mismos 10 problemas) sacó 9.6, y Fable 5 en llamada única sacó 8.0. La comparación correcta no es “team-solve le ganó al paper original”, sino “ambos empataron, y los dos le sacaron ventaja a Fable 5 solo”. Con n=10, cualquier verificador serio diría que eso es ruido estadístico, no superioridad.
¿Qué limitaciones reconocen los propios autores y la reproducción?
El repositorio de memdoor lista cinco salvedades textuales sobre su propia reproducción, y son más honestas que la mayoría de los posteos virales que circularon con este dato. Vale la pena leerlas antes de repetir el titular sin matices. Sobre eso hablamos en el caso de Sora dentro del ecosistema de OpenAI.
- Muestra chica. Memdoor probó 10 problemas, el paper original usó 100. La diferencia entre 9.8 y 9.6 cae dentro del margen de error con una muestra tan reducida.
- Posible contaminación de datos. Los problemas vienen de la primavera de 2025, así que es posible que los modelos ya los hayan visto en entrenamiento. Todavía nadie descartó esa hipótesis.
- El número de Fable 5 no es directamente comparable. Sale de los archivos del paper original, no se corrió dentro del mismo harness de memdoor, y es una sola llamada por problema, no cinco pasadas como el resto.
- La evaluación final usa hidden tests. El loop de trabajo ve ejemplos públicos, pero la nota se decide con pruebas ocultas que el equipo de agentes no vio.
- Todo corrió en OpenRouter. No en hardware propio, lo que influye en latencia y en la variabilidad de los tiempos reportados.
Hay un detalle en el README de team-solve que dice más sobre el sistema que cualquier porcentaje: en una corrida, el agente “gestor” generó un contraejemplo erróneo y el equipo completo reescribió un programa que ya estaba correcto, hasta romperlo. En dos ocasiones, un programa correcto fue sobrescrito y después recuperado. El equipo de memdoor decidió dejar ese comportamiento en los logs públicos, porque es un agujero del loop original de GVS5H, no un bug de la herramienta que lo implementa.
¿Cómo funciona memdoor y el workflow team-solve para reproducir el experimento?
Memdoor es un agente de código y ejecutor de workflows escrito en Go, distribuido como un único binario bajo licencia Apache-2.0, y es una herramienta distinta del paper académico. Lo que los conecta es que memdoor incluye un ejemplo llamado team-solve que reconstruye el método GVS5H usando ocho archivos YAML, sin escribir código y sin fijar un modelo específico dentro de los archivos.
El equipo que arma team-solve tiene un planificador, dos proponentes de ideas, un resolutor, un gestor y un reparador. Cada uno arranca de un contexto completamente vacío. Se comunican únicamente a través de archivos en disco: nadie tiene acceso a la conversación de otro, solo a lo que quedó escrito en la carpeta compartida. Un script corre los ejemplos de prueba y decide si el programa final pasa o no.
Apuntá a vos mismo si querés correrlo: necesitás un modelo configurado (local o con API key de algún proveedor), y memdoor se encarga de orquestar los roles sin que tengas que tocar la lógica interna de coordinación.
¿Por qué el contexto fresco mejora el rendimiento y no es solo ahorro de tokens?
La mejora no viene de truncar el historial de chat para ahorrar tokens, sino de dos cosas combinadas: dividir el problema en partes y mantener un contexto persistente fuera de la ventana de conversación. El propio paper hizo análisis de transcripciones y llegó a esa conclusión, no a la de “menos contexto es mejor”.
¿Y qué significa “instancia fresca” entonces? Cada agente arranca sin memoria de conversaciones anteriores, es verdad. Pero el archivo compartido en disco (el ledger) funciona como una memoria externa que todos los agentes pueden leer y escribir en cualquier momento. Es la diferencia entre acumular una ventana de contexto que crece sin control y tener una bitácora ordenada que cualquiera del equipo puede consultar sin cargar toda la historia. En las pruebas de ataque entre DeepSeek y OpenAI profundizamos sobre esto.
Subís el modelo, lo lanzás cinco veces en paralelo, cada instancia lee el plan vigente en disco, escribe su parte, actualiza la bitácora, y el siguiente agente lee esa actualización sin necesidad de que nadie le pase el chat completo anterior: eso es, en esencia, el truco de GVS5H. Mueve la memoria de la ventana de contexto inflada hacia un archivo que se puede releer tantas veces como haga falta, y eso permite que el equipo se coordine sin arrastrar historiales de chat kilométricos.
¿Qué se necesita para probar este método uno mismo?
Necesitás Python 3 y bash para correr los scripts de verificación de los ejemplos, además de acceso a algún proveedor de modelos o una instalación local. Memdoor se conecta con OpenRouter, Anthropic, OpenAI, Gemini, DeepSeek, y también puede correr en local vía Ollama, llama.cpp, vLLM o LM Studio.
- Ventana de contexto mínima en Ollama. Hay que configurarla en al menos 32K; el default de 4K no alcanza para que los agentes trabajen con el ledger.
- El costo cambia de forma según dónde corras. En cloud, pagás por token (los 0.39 USD mediana que vimos arriba). En local, el costo se traduce en tiempo de cómputo y en los gigabytes que ocupa el modelo en disco.
- Los resultados son de competencia, no de código de negocio. Ni el paper ni la reproducción probaron este método sobre un repositorio real de producción, así que no hay evidencia todavía de que escale a proyectos grandes y desprolijos como los que manejás en el trabajo real.
Si vas a dejar corriendo estos workflows de forma recurrente, en un servidor propio en vez de en tu máquina de desarrollo, conviene pensar la infraestructura con la misma seriedad que el experimento: en donweb.com podés levantar un VPS para correr modelos locales o para dejar workflows de CI corriendo sin depender de tu notebook.
Comparativa: GVS5H orquestado vs Fable 5 solo
| Configuración | Fuente del dato | Score reportado | Costo / nota |
|---|---|---|---|
| Qwen3.8 Flash Next orquestado (GVS5H) | Paper original, 100 problemas | 93.0% | 9% del costo de Fable 5 |
| Fable 5, llamada única | Paper original, 100 problemas | 90.4% | Baseline de referencia |
| Qwen3.8-27B local, sin orquestar | Paper original, 100 problemas | 66.8% | Punto de partida sin equipo |
| Qwen3.8-27B local orquestado (GVS5H) | Paper original, 100 problemas | 92.4% | Mejora de 25.6 puntos |
| Workflow team-solve (memdoor) | Reproducción, 10 problemas, 5 rondas | 9.8 / 10 | Mediana 0.39 USD por ronda |
| Harness original de los autores | Reproducción, mismos 10 problemas | 9.6 / 10 | Empate técnico con lo anterior |
| Fable 5, llamada única | Reproducción, mismos 10 problemas | 8.0 / 10 | Dato del archivo del paper, no corrido en este harness |
Errores comunes al leer este dato
- Confundir “empate” con “victoria”. La reproducción de 10 problemas muestra que team-solve y el harness original quedan prácticamente igual (9.8 vs 9.6). Decir que “le ganó” a GVS5H es forzar una lectura que los propios datos no sostienen.
- Asumir que la mejora es universal. El paper dice explícitamente que algunos modelos quedan igual o peor con este método. No es un truco que funcione automáticamente con cualquier modelo que agarres.
- Comparar el costo de cloud con el costo de correr en tu máquina. El 0.39 USD mediana es de OpenRouter. Si corrés local, no ahorrás plata: gastás tiempo y espacio en disco.
- Ignorar la posible contaminación de datos. Los problemas de LiveCodeBench Hard usados son de la primavera de 2025. Si el modelo los vio durante el entrenamiento, el score está inflado y nadie lo descartó todavía.
Qué está confirmado y qué no
- Confirmado: el paper GVS5H reporta mejoras de hasta 25.6 puntos en LiveCodeBench Hard sobre 11 modelos, con código MIT y datos CC BY 4.0 publicados.
- Confirmado: la reproducción con memdoor publicó las 50 rondas completas (requests, respuestas, programas y resultados del verificador), con costo mediano de 0.39 USD y 35.79 USD en total.
- No confirmado: que el método funcione igual sobre código de negocio real, en repositorios grandes y desprolijos, fuera de problemas de competencia como los de LiveCodeBench.
- No confirmado: que no haya contaminación de datos entre los problemas usados y el entrenamiento de los modelos probados.
- Pendiente: una reproducción independiente de un tercer equipo que corra los 100 problemas completos, no solo los 10 primeros.
Preguntas Frecuentes
¿Es verdad que 5 modelos de IA pequeños le ganan a un modelo grande?
Sí, en el benchmark completo de 100 problemas del paper GVS5H: Qwen3.8 Flash Next orquestado llegó a 93.0% contra 90.4% de Fable 5. Pero en la reproducción con solo 10 problemas, la diferencia (9.8 contra 9.6 sobre 10) no alcanza para hablar de victoria clara, es empate dentro del margen de error.
¿Cuánto cuesta usar 5 modelos de IA pequeños en equipo por tarea?
La reproducción de memdoor midió una mediana de 0.39 dólares por ronda corriendo en OpenRouter, con 40 minutos de mediana de tiempo. Si corrés los modelos en tu propia máquina, ese costo en dólares se convierte en tiempo de cómputo y espacio en disco para los pesos del modelo.
¿Qué es el método GVS5H de autoorquestación con ledger?
GVS5H (sigla de “Gorilla vs. 5 Humans”), también descrito por los autores como ledger-based zero-shot self-orchestration, es un método sin entrenamiento adicional en el que instancias frescas del mismo modelo se coordinan a través de un sistema de archivos compartido que guarda un plan, notas y la solución actual. Lo publicó Persis Capital en arXiv el 27 de agosto de 2026. Esto se conecta con lo que analizamos en el avance de ChatGPT frente a las búsquedas de Google.
¿Qué es memdoor y el workflow team-solve?
Memdoor es un agente de código y ejecutor de workflows en Go, de licencia Apache-2.0, distinto del paper académico. Team-solve es un ejemplo incluido en memdoor que reconstruye el método GVS5H con ocho archivos YAML y cinco roles de agente, sin necesidad de escribir código.
¿Los modelos pequeños de IA pueden reemplazar a los modelos grandes en programación?
Todavía no, según la evidencia disponible. Los resultados vienen de problemas de competencia como LiveCodeBench Hard, no de código de negocio real, y no hay datos sobre cuánto trabajo humano de revisión necesitan los resultados antes de hacer merge en un proyecto productivo.
Conclusión
El dato de fondo es real: coordinar varios modelos pequeños con un ledger compartido en disco mejora resultados de programación, en algunos casos de forma notable. El problema está en cómo se lo cuenta después. “Ganarle a un modelo gigante” suena a victoria total, y lo que hay detrás es una mejora medida en un benchmark específico, que no es universal entre modelos y que, en la única reproducción independiente disponible hasta ahora, da un resultado de empate técnico sobre una muestra de apenas 10 casos.
Si estás evaluando bajar costos de desarrollo con IA, el aporte real de este trabajo es el diseño del flujo de coordinación, no la promesa de reemplazar un modelo caro por cinco baratos. Antes de aplicarlo en código de producción, conviene esperar una reproducción con la muestra completa de 100 problemas y, sobre todo, probarlo contra tu propio repositorio, no contra un benchmark de competencia.
Fuentes
- GVS5H: Zero-Shot Self-Orchestration with Ledger-Based Control for Improved LLM Coding Performance – paper original en arXiv, Persis Capital (27 de agosto de 2026)
- GVS5H en GitHub – código y resultados del paper, licencia MIT
- memdoor en GitHub – agente de código y ejecutor de workflows, licencia Apache-2.0
- README del workflow team-solve – reproducción con datos publicados de las 50 rondas
- Documentación oficial de team-solve en memdoor.ai