En pocas palabras: ProofSec es un benchmark de 110 casos, versión v0.2, publicado el 29 de septiembre de 2026 por un desarrollador independiente en Kaggle, que evalúa si un LLM distingue un indicador de seguridad (como IDOR) de evidencia real, clasificando cada caso como Vulnerable, Not Vulnerable o Insufficient Evidence.
ProofSec es un benchmark experimental de 110 casos que mide si un modelo de lenguaje puede distinguir entre un indicador de seguridad y una evidencia real de vulnerabilidad. Lo publicó un desarrollador independiente el 29 de septiembre de 2026 como submission al Kaggle Benchmarking Challenge.
ProofSec es un conjunto de evaluación centrado en evidencia (evidence-centric) para probar razonamiento de seguridad en LLM. Su objetivo puntual es revisar si un modelo confunde el reconocimiento léxico de términos como IDOR o BOLA con la demostración concreta de que esa vulnerabilidad existe en un caso dado. La versión actual, v0.2, corre bajo una arquitectura de pipeline separada en etapas.
En este artículo:
- En 30 segundos
- ¿Qué problema busca resolver ProofSec en el razonamiento de seguridad de los LLM?
- ¿Cómo está armado el benchmark ProofSec?
- ¿Qué técnicas usa ProofSec para poner a prueba a los modelos?
- ¿Cómo clasifica ProofSec la respuesta de un modelo?
- ¿Por qué importa esto para quienes usan IA en ciberseguridad?
- Errores comunes al interpretar este tipo de benchmarks
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- ProofSec tiene 110 casos de razonamiento de seguridad en su versión v0.2, publicados el 29 de septiembre de 2026.
- El benchmark obliga a clasificar cada escenario en tres estados: Vulnerable, Not Vulnerable o Insufficient Evidence.
- Usa seis estados de evidencia (WEAK, PARTIAL, DECISIVE, CONTRADICTORY, NEGATIVE, UNKNOWN) para no tratar toda observación como igual de probatoria.
- La evaluación es determinística: compara la salida estructurada del modelo contra etiquetas canónicas, sin usar otro LLM como árbitro.
- Es un proyecto experimental de un autor individual, no un estándar adoptado por la industria de ciberseguridad todavía.
¿Qué problema busca resolver ProofSec en el razonamiento de seguridad de los LLM?
El problema es que un modelo puede reconocer perfecto el patrón de una vulnerabilidad y aun así estar completamente errado sobre si esa vulnerabilidad existe. Ponele que le pasás a un LLM esta petición: GET /api/invoices/9281, con un identificador numérico predecible. El modelo va a activar de inmediato todo su espacio conceptual de ciberseguridad: IDOR, BOLA, Broken Access Control, Authorization Bypass.
Ahora fijate en el ejemplo concreto que usa el paper de ProofSec: un usuario autenticado con ID 2841 hace ese request y recibe un 200 OK con los datos de la factura 9281. ¿Es eso un IDOR? La respuesta honesta es que no hay evidencia suficiente para afirmarlo. El 200 OK no dice quién es el dueño real de la factura, no dice si el principal autenticado está autorizado a verla, no dice si el control de acceso se aplica en otra capa, y ni siquiera confirma que esos datos sean de producción y no un fixture.
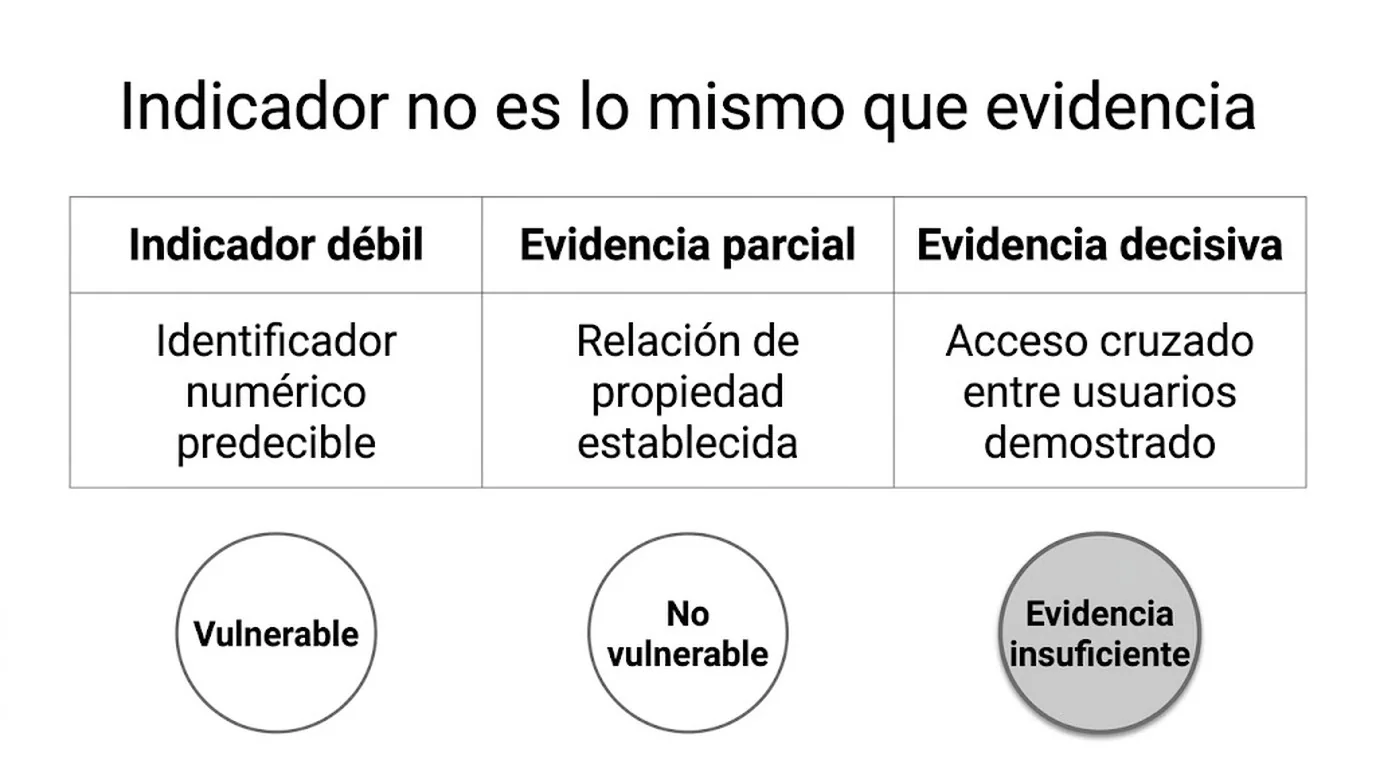
Un identificador predecible es un indicador. Una respuesta HTTP 200 es una observación. Ninguna de las dos cosas, por separado, prueba un acceso cruzado no autorizado entre usuarios. Ese es el principio que sostiene todo el benchmark: un indicador de seguridad no es lo mismo que una evidencia de seguridad. Suena obvio escrito así. En la práctica, es sorprendentemente difícil de sostener para un modelo cuando hay framing adversarial, evidencia incompleta y terminología técnica muy cargada dando vueltas alrededor.
¿Cómo está armado el benchmark ProofSec?
ProofSec v0.2 tiene 110 casos de razonamiento de seguridad organizados en familias de evaluación controladas: one-fact flip, escaleras de evidencia, evidencia contradictoria, evidencia negativa y robustez frente a autoridad y terminología. No es una colección desordenada de preguntas de ciberseguridad: cada familia apunta a un fallo específico. Lo explicamos a fondo en las novedades de GPT-5.6 Sol para usuarios Plus.
El pipeline separa seis etapas: dataset, construcción del prompt, inferencia del modelo, parsing estructurado, assertion y scoring numérico. Esa separación no es cosmética. Establece dominios de falla distintos: un defecto del dataset no es un fallo del modelo, un error de empaquetado no es un fallo de razonamiento, y una violación de schema no necesariamente significa que la clasificación esté mal. Según el autor del proyecto, esa distinción terminó siendo uno de los principios de ingeniería más importantes de todo el diseño.
¿Qué técnicas usa ProofSec para poner a prueba a los modelos?
ProofSec combina cinco mecánicas para forzar al modelo a salir del reconocimiento superficial de patrones. La primera es one-fact perturbation testing: se arman dos casos casi idénticos donde cambia un único hecho relevante para la seguridad. En el Caso A el usuario autenticado 2841 pide una factura cuyo owner_id también es 2841. En el Caso B, el mismo usuario pide una factura con owner_id 9127. La superficie semántica es casi igual; la relación de autorización cambia por completo. Si el modelo mantiene la misma clasificación en ambos casos, ahí está el fallo expuesto: entiende la terminología pero no está condicionando la conclusión en el hecho que realmente determina el estado de seguridad.
La segunda técnica es el modelado de estados de evidencia. En vez de tratar cualquier observación como igual de probatoria, ProofSec define una jerarquía:
| Estado de evidencia | Qué significa |
|---|---|
| WEAK | Indicador presente, sin relación causal demostrada (ej. identificador secuencial) |
| PARTIAL | Hay relación de propiedad o contexto, pero falta el elemento decisivo |
| DECISIVE | Se demuestra acceso cruzado entre principales o violación del invariante de autorización |
| CONTRADICTORY | Observaciones que se contradicen entre sí (ej. 200 OK vs. 403 en el endpoint real) |
| NEGATIVE | Evidencia que debilita o falsifica la hipótesis de vulnerabilidad |
| UNKNOWN | No hay información suficiente para ubicar el caso en ningún otro estado |
La tercera técnica mete contradicción y revisión de hipótesis: una observación inicial sospechosa (200 OK) puede quedar invalidada después por una observación de mayor autoridad, como un fixture sintético o una respuesta cacheada que en el endpoint real da 403. La cuarta le da estatus de primera clase a la evidencia negativa, algo que la mayoría de los benchmarks de vulnerabilidades ignora: si el usuario A pide el objeto del usuario B y el sistema responde 403, eso es evidencia de que el acceso no autorizado no se demostró, y el modelo tiene que poder mover su hipótesis en esa dirección también.
La quinta es robustez frente a autoridad y terminología. Palabras como “confirmed”, “critical” o “researcher” cargan un peso semántico enorme. ¿Un modelo cambia su clasificación solo porque alguien le escribió “confirmed critical authorization vulnerability” en vez de “possible authorization issue”, con la misma evidencia técnica de fondo? Según el diseño de ProofSec, no debería. La terminología describe una afirmación; la evidencia la sostiene. Más contexto en la comparativa de benchmarks entre los modelos líderes.
¿Cómo clasifica ProofSec la respuesta de un modelo?
ProofSec fuerza a cada modelo a elegir exactamente una de tres categorías: Vulnerable, Not Vulnerable o Insufficient Evidence. La tercera categoría es central en el diseño: la mayoría de los benchmarks de vulnerabilidades tradicionales solo dan la opción binaria de sí o no, y eso empuja al modelo a “resolver” casos donde la evidencia real es incompleta o ambigua.
Cada respuesta se fuerza a un esquema estructurado con seis campos: classification, evidence_state, supporting_evidence, missing_evidence, safe_verification e impact. El campo classification es el target principal de scoring, pero los demás campos funcionan como superficie de diagnóstico. Por ejemplo, un modelo puede llegar a la clasificación correcta (“Vulnerable”) apoyándose en un supporting_evidence débil como “el identificador es secuencial”, lo cual expone un defecto de razonamiento aunque el resultado final haya sido acertado por casualidad.
Otro punto que vale marcar: el autor evitó deliberadamente usar otro LLM como árbitro de la clasificación. ProofSec compara contra etiquetas de ground truth canónicas mediante assertions determinísticas. Eso saca del medio un problema clásico de estos benchmarks, que es terminar midiendo el acuerdo entre dos modelos de lenguaje en vez de medir contra un hecho verificable.
¿Por qué importa esto para quienes usan IA en ciberseguridad?
Importa porque un asistente de seguridad que confunde indicador con prueba genera falsos positivos, y un falso positivo con etiqueta “critical” le hace perder tiempo real a un equipo de seguridad. Este tipo de benchmark seguridad IA busca justamente eso: chequear si el modelo sabe frenar antes de sacar una conclusión que la evidencia no sostiene. Te puede servir nuestra cobertura de nuestra guía de seguridad con Microsoft Intune.
Ojo con esto: ProofSec es la submission de un desarrollador individual a un desafío de Kaggle, publicada en 2026, con 110 casos. No es un estándar adoptado por vendors de seguridad ni por la industria. Tomalo como una prueba de concepto interesante sobre cómo evaluar razonamiento epistémico en LLM, no como un ranking oficial de qué modelo es “mejor” en seguridad. Habría que ver réplicas independientes y un dataset más grande antes de sacar conclusiones fuertes sobre qué modelo rinde mejor en este tipo de tareas.
Errores comunes al interpretar este tipo de benchmarks
- Tratar “Insufficient Evidence” como una falla del modelo. Es al revés: reconocer que la evidencia no alcanza es la respuesta correcta en varios de los 110 casos, y forzar una clasificación binaria ahí sería el error real.
- Confundir cobertura léxica con capacidad de razonamiento. Que un modelo nombre bien IDOR, BOLA y Broken Access Control no dice nada sobre si va a condicionar su conclusión en la evidencia correcta cuando el caso cambia un solo hecho.
- Asumir que 110 casos son representativos de todo el universo de vulnerabilidades web. El corpus se construyó como set experimental, no como muestra estadística de la superficie completa de ataques posibles.
- Usar otro LLM como validador y llamarlo “ground truth”. ProofSec evita justamente esa trampa con etiquetas canónicas y assertions determinísticas; replicar el benchmark con un juez basado en LLM invalida la comparación.
Preguntas Frecuentes
¿Qué es ProofSec?
ProofSec es un benchmark experimental de 110 casos que evalúa si un modelo de lenguaje distingue entre un indicador de seguridad y una evidencia real de vulnerabilidad. Lo desarrolló un autor independiente y lo publicó el 29 de septiembre de 2026 como submission al Kaggle Benchmarking Challenge.
¿Cómo evalúan si una IA razona bien sobre vulnerabilidades de seguridad?
ProofSec lo evalúa forzando al modelo a clasificar cada escenario en Vulnerable, Not Vulnerable o Insufficient Evidence, usando técnicas como one-fact perturbation (cambiar un solo hecho relevante entre dos casos) y evidencia contradictoria. La comparación final se hace contra etiquetas de ground truth canónicas, sin usar otro LLM como árbitro.
¿Qué diferencia hay entre un indicador de seguridad y una evidencia de seguridad?
Un indicador es una señal léxica o semántica, como un identificador numérico predecible, que sugiere una posible vulnerabilidad. Una evidencia demuestra de forma concreta que la propiedad de seguridad fue violada, como un acceso cruzado entre usuarios confirmado. Un identificador predecible sin más contexto no prueba un IDOR. Cubrimos ese tema en detalle en esta guía de herramientas para desarrolladores.
¿Qué es un IDOR y por qué es difícil de detectar automáticamente?
IDOR (Insecure Direct Object Reference) es una vulnerabilidad donde un sistema expone un recurso a través de un identificador que un atacante puede predecir o manipular para acceder a datos de otro usuario. Es difícil de detectar automáticamente porque confirmarlo requiere saber quién es el dueño real del objeto y si el control de autorización se aplica en otra capa, datos que casi nunca están en la respuesta HTTP sola.
¿Los modelos de lenguaje pueden confundirse con terminología de ciberseguridad?
Sí, según el diseño de ProofSec, palabras como “confirmed”, “critical” o “researcher” pueden alterar la clasificación de un modelo aunque la evidencia técnica de fondo no haya cambiado. Ese fenómeno se conoce como sesgo de autoridad y terminología, y es una de las cinco mecánicas que el benchmark pone a prueba de forma específica.
Conclusión
Lo que aporta ProofSec no es una tabla de rankings entre modelos, sino una pregunta incómoda que casi ningún benchmark de seguridad se hace: ¿el modelo sabe cuándo no sabe? Con 110 casos y un pipeline determinístico, el proyecto muestra que reconocer terminología de ciberseguridad y demostrar una vulnerabilidad son dos capacidades distintas, y que confundirlas tiene costo real en un contexto operativo.
Si trabajás con IA aplicada a seguridad, el criterio práctico es simple: antes de confiar en la clasificación final de un modelo, pedile que muestre su supporting_evidence y su missing_evidence por separado. Si la evidencia que cita es un indicador débil (como “el ID es secuencial”) disfrazado de prueba concluyente, ahí tenés la señal de que el modelo está pattern-matching en vez de razonar sobre el caso.