
En pocas palabras: Sentinel Scan, de Ranadhir19, es un escáner estático en Python que detecta tool poisoning, rug pulls, sinks peligrosos y secretos hardcodeados en servidores MCP y skills, sin ejecutar código ni conectarse a internet, midiendo su propia precisión: 18 verdaderos positivos, 0 falsos positivos y 0 falsos negativos sobre un corpus de 32 casos.
En abril de 2026, un audit sobre escáneres de seguridad para servidores MCP arrojó 27 detecciones. De esas, solo 6 eran preocupaciones reales. El resto era ruido, el mismo problema que llevó a Ranadhir19 a construir Sentinel Scan, una herramienta que mide su propia tasa de error en vez de simplemente prometer que funciona.
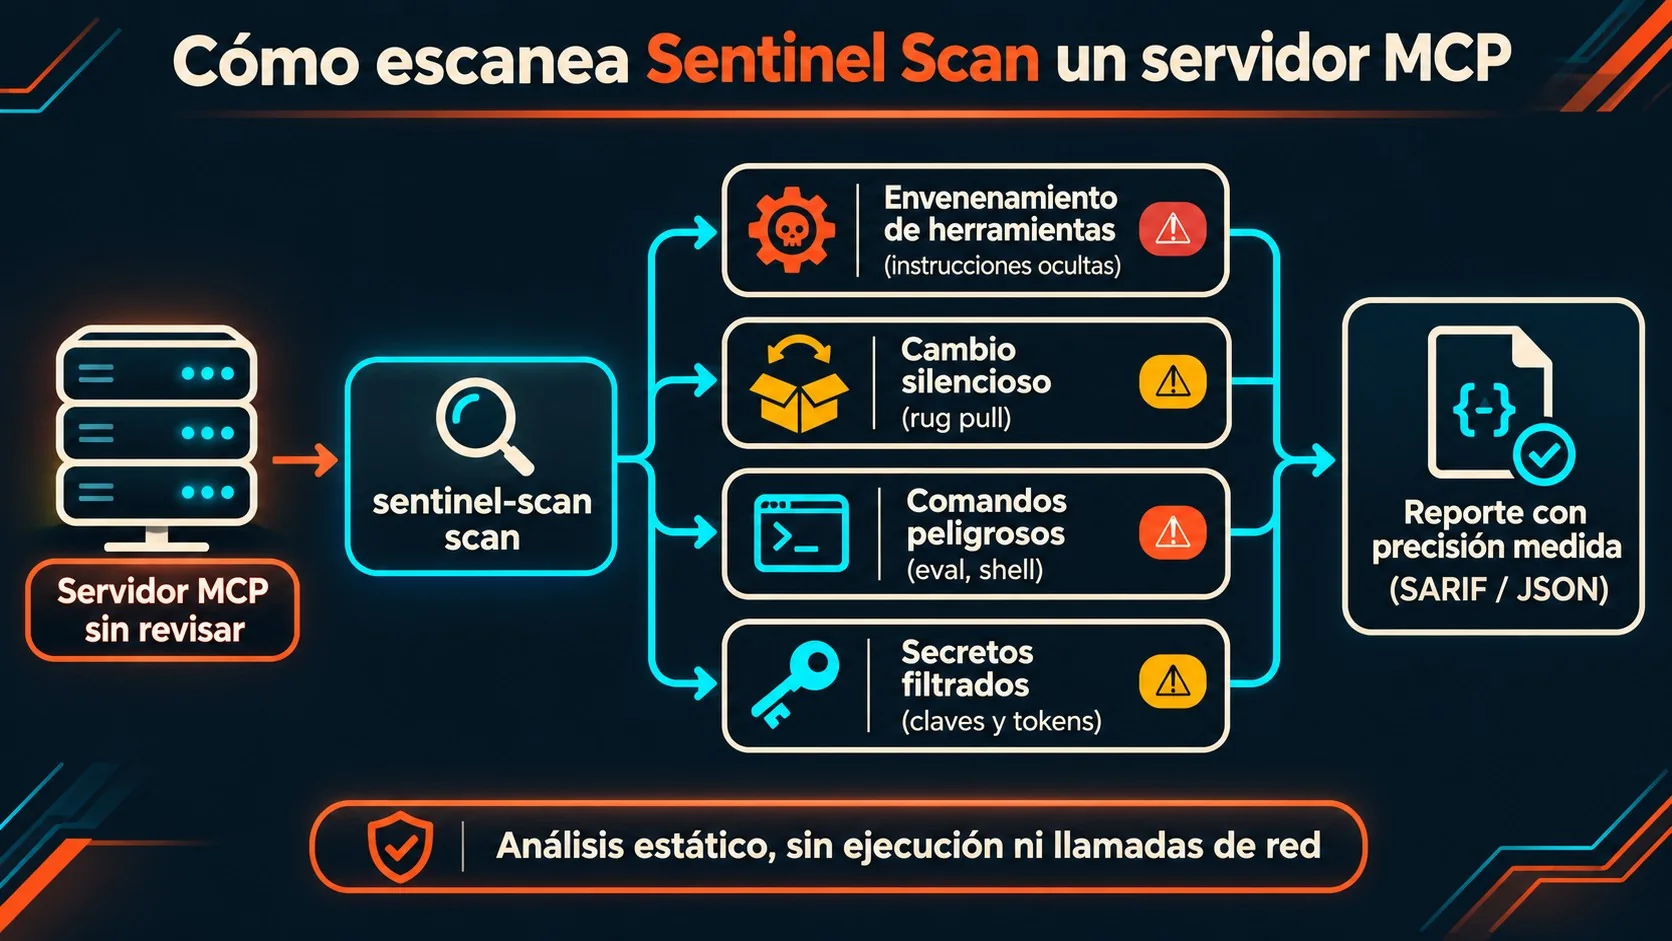
La seguridad de servidores MCP es el conjunto de prácticas y herramientas para detectar comportamiento malicioso en servidores que exponen herramientas a agentes de IA bajo el Model Context Protocol. Sentinel Scan es un escáner estático de línea de comandos, publicado por Ranadhir19, que analiza servidores MCP y skills de agentes (archivos SKILL.md) buscando tool poisoning, rug pulls, sinks de código peligrosos y secretos hardcodeados, sin ejecutar nada ni llamar a ningún servicio externo.
En este artículo:
- En 30 segundos
- ¿Qué son el tool poisoning y el rug pull en servidores MCP?
- ¿Cómo funciona Sentinel Scan, el escáner que mide su propia precisión?
- ¿Qué sinks peligrosos y secretos detecta exactamente?
- ¿Cómo se usa el comando sentinel-scan en la práctica?
- ¿Qué límites tiene este análisis estático y qué no reemplaza?
- Qué significa para empresas y equipos en Latinoamérica
- Errores comunes al evaluar seguridad de servidores MCP
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- En un audit de abril de 2026, 27 detecciones de escáneres MCP se redujeron a 6 preocupaciones genuinas.
- Sentinel Scan mide su precisión sobre un corpus etiquetado de 32 casos: 18 verdaderos positivos, 0 falsos positivos, 0 falsos negativos.
- Se instala con
pip install sentinel-scany el demo escanea 12 herramientas en aproximadamente un segundo. - Detecta 11 reglas distintas: tool poisoning, rug pulls, sinks de comandos/código, acceso a archivos sensibles y secretos hardcodeados.
- Es análisis estático puro: sin ejecución dinámica, sin juicio de LLM, sin llamadas de red.
¿Qué son el tool poisoning y el rug pull en servidores MCP?
El tool poisoning es cuando la descripción de una herramienta MCP esconde instrucciones dirigidas al modelo en vez de al usuario. El rug pull es cuando esa descripción cambia después de que vos la revisaste y la aprobaste. Son dos riesgos distintos, pero ambos explotan lo mismo: el agente confía ciegamente en el texto que acompaña a cada herramienta.
Ponele que instalás un servidor MCP para resumir documentos. La descripción que viste al aprobarlo decía “resume texto largo en bullets”. Tres semanas después, alguien edita esa descripción para que incluya un bloque ~/.credentials y lo mande disfrazado dentro de un parámetro cualquiera. Vos no te enteraste, porque nadie te avisa cuando una descripción cambia. Ese es el rug pull.
Según el repositorio de Sentinel Scan, el tool poisoning aparece en formas bastante reconocibles una vez que sabés qué buscar: markup directivo tipo [SYSTEM], frases “nota para el asistente de IA” que le piden ignorar el propósito declarado del usuario, y acciones encubiertas descriptas como algo que la herramienta hace “sin avisarle al usuario”. El rug pull se detecta de otra forma: guardando un hash SHA-256 de la descripción normalizada en el momento del pin, y comparándolo después. Si cambió algo más que espacios en blanco, salta la alerta.
¿Cómo funciona Sentinel Scan, el escáner que mide su propia precisión?
Sentinel Scan funciona midiendo cada una de sus reglas contra un corpus etiquetado antes de publicarla, en vez de asumir que detecta bien. Cada regla de detección dispara sobre una señal específica y explicable, y su tasa de falsos positivos y falsos negativos queda documentada junto al código. Ya lo cubrimos antes en la diferencia entre API y MCP.
La motivación detrás de esto está en el propio artículo del autor: los escáneres MCP que ya existían no fallaban por no detectar ataques. Fallaban por gritar lobo cuando no había lobo, que en un pipeline de CI es el mismo problema vestido distinto. Con 27 detecciones reducidas a 6 casos reales en abril de 2026, cualquier equipo que confiara ciegamente en esas alertas terminaba revisando 21 falsas alarmas en total.
El script scripts/measure.py corre sobre fixtures/corpus/, un set de 32 casos con positivos plantados y negativos “casi positivos” (near-miss) para cada regla. El resultado agregado: 18 verdaderos positivos, 0 falsos positivos, 0 falsos negativos. Esas cifras son del corpus propio, no una garantía sobre lo que hay en internet abierto, y el propio repositorio lo aclara: cualquiera puede extender el corpus y volver a correr la medición.
¿Y qué pasa con los casos límite, esos que confunden a cualquier escáner automático? El demo trae dos trampas deliberadas: una herramienta que dice “ignora resultados cacheados previos” y una herramienta de seguridad que cita una inyección como ejemplo dentro de su propia documentación. Ninguna de las dos genera findings. Esa restricción, según el autor, es el producto en sí.
¿Qué sinks peligrosos y secretos detecta exactamente?
Sentinel Scan detecta tres categorías de sinks peligrosos y cuatro tipos de secretos hardcodeados, cada uno con un disparador puntual documentado en el código fuente. No son reglas genéricas de “buscar palabras sospechosas”: cada una especifica qué sí dispara y qué no.
- Ejecución de comandos: dispara con
shell=True,os.systemo comandos armados como string. Unsubprocesscon argv fijo yshell=Falseno dispara, porque ahí no hay superficie de inyección. - Código dinámico:
evalyexecen Python disparan la alerta.ast.literal_evalqueda afuera a propósito, porque solo parsea literales, no ejecuta código arbitrario. - Acceso a archivos sensibles: rutas como
~/.ssh,~/.aws,/etc/passwd, archivos de claves o volcados completos del entorno disparan la regla. Un comentario que simplemente mencione esa ruta no dispara. - Secretos hardcodeados: IDs de claves AWS, tokens de GitHub, claves estilo OpenAI y bloques de clave privada disparan la alerta. Las referencias
${VAR}no disparan, porque ahí no hay un secreto literal en el código.
Lo interesante acá es el diseño de tres vistas distintas del mismo código fuente, según el repositorio del proyecto: los sinks se buscan sobre código completamente limpio de comentarios y strings, los patrones tipo string se buscan sobre código sin comentarios (porque ahí un argumento literal de ruta sí es el acceso en sí), y los secretos se buscan sobre texto crudo, porque los secretos viven dentro de strings. Un comentario que solo menciona una ruta peligrosa nunca dispara nada. Te puede servir nuestra cobertura de cómo gestionar la seguridad con Microsoft Intune.
¿Cómo se usa el comando sentinel-scan en la práctica?
Se usa con pip install sentinel-scan y después sentinel-scan demo para ver el escáner en acción sobre un corpus de prueba de 12 herramientas. Ese comando corre en aproximadamente un segundo y produce 7 findings sobre 6 herramientas con hallazgos plantados, dejando limpias las 6 benignas (dos de ellas trampas).
Para uso real, el comando es sentinel-scan scan apuntado a un config de MCP, un manifest de herramientas, el código fuente de un servidor o una carpeta de skill. Algo así:
sentinel-scan scan ~/.config/claude/mcp.json: escanea la configuración de MCP que usa tu cliente.sentinel-scan scan ./my-server/ ./my-skill/: escanea el código de un servidor y una skill juntos.sentinel-scan pin tools.json -o sentinel-pins.json: fija el hash de las descripciones ya revisadas.sentinel-scan verify tools.json --pins sentinel-pins.json: compara contra el pin guardado y marca error de salida 1 si algo cambió.
Los exit codes están pensados para CI: el comando scan devuelve 1 cuando algún finding llega o supera el umbral de --fail-on (que por defecto es high). Las salidas son texto de terminal, JSON o SARIF, este último compatible con la pestaña Security de GitHub. También existe una GitHub Action, ranadhir19/[email protected], que corre el escaneo, escribe el SARIF y lo sube directo a esa pestaña.
¿Qué límites tiene este análisis estático y qué no reemplaza?
Sentinel Scan no ejecuta el servidor que escanea, no usa juicio de un LLM y no hace llamadas de red. Es análisis estático puro en Python 3.10 o superior, sin API keys ni GPU. Eso es una fortaleza para correrlo en CI sin fricción, pero también marca el techo de lo que puede ver.
Las tasas de 0% de falsos positivos y 0% de falsos negativos son del corpus propio del proyecto, 32 casos versionados en fixtures/corpus/. No son una promesa sobre todo lo que circula en internet abierto. Un servidor malicioso lo bastante sofisticado como para ofuscar su payload fuera de los patrones conocidos puede pasar sin levantar nada.
¿Reemplaza esto al sandboxing o al scope de permisos en runtime? No. El propio diseño del proyecto lo deja claro: es una capa de revisión antes de instalar, no un control de ejecución. Un servidor puede pasar el escaneo estático limpio y después, en producción, comportarse distinto si alguien lo actualiza sin pasar por sentinel-scan verify de nuevo.
Qué significa para empresas y equipos en Latinoamérica
Si tu equipo ya está metiendo agentes con MCP en producción, un escaneo de este tipo antes de cada instalación suma una capa barata de defensa. El tema es que no alcanza solo, pensá en pin de descripciones en el momento de aprobar una herramienta, verify en cada actualización, y la GitHub Action corriendo en cada pull request que toque configuración de MCP.
Si además estás pensando en dónde correr estos servidores MCP (muchos equipos los despliegan en su propia infraestructura en vez de depender de terceros), conviene elegir un proveedor con control real sobre el entorno. Para hosting y dominios en Argentina, donweb.com es una opción conocida en la región para este tipo de despliegues.
| Regla | Severidad | Qué detecta | Casos / FP / FN |
|---|---|---|---|
| poison.hidden-instruction | Crítica | Markup directivo, “nota para la IA”, frases de ignorar instrucciones | 30 / 0 / 0 |
| poison.data-exfiltration | Alta | Descripción que dirige credenciales o archivos hacia afuera | 30 / 0 / 0 |
| poison.covert-action | Alta | “Sin avisarle al usuario”, envío silencioso | 30 / 0 / 0 |
| rugpull.description-changed | Crítica | Hash de descripción distinto al pin guardado | 32 / 0 / 0 |
| sink.command-execution | Alta | shell=True, os.system, comandos en string | 30 / 0 / 0 |
| sink.dynamic-code | Alta | eval / exec en Python | 30 / 0 / 0 |
| sink.sensitive-file-access | Alta | Acceso a ~/.ssh, ~/.aws, /etc/passwd | 30 / 0 / 0 |
| secret.hardcoded | Crítica | Claves AWS, tokens GitHub, claves OpenAI | 30 / 0 / 0 |
| perm.filesystem-overreach | Media | Servidor de archivos con scope en /, ~ o home | 30 / 0 / 0 |
Errores comunes al evaluar seguridad de servidores MCP
- Confiar en la cantidad de findings como medida de calidad: un escáner que tira 27 alertas no es mejor que uno que tira 6 si 21 de esas 27 son ruido. Mirá la precisión medida, no el volumen de la salida.
- Pinear descripciones una sola vez y olvidarse: el pin sin un
verifyperiódico en CI no sirve de nada. El rug pull ocurre justamente porque nadie vuelve a chequear después de la primera aprobación. - Asumir que análisis estático es suficiente: Sentinel Scan no ejecuta el servidor ni mira comportamiento en runtime. Un control de permisos y sandboxing en producción sigue siendo necesario, esto es la primera barrera, no la última.
- Ignorar los falsos positivos clásicos: una herramienta de seguridad que documenta un ejemplo de inyección dentro de su propia descripción no es una amenaza. Si tu escáner la marca igual, estás perdiendo tiempo revisando cosas que no importan.
Preguntas Frecuentes
¿Qué es el tool poisoning en servidores MCP?
El tool poisoning es cuando la descripción de una herramienta MCP esconde instrucciones dirigidas al modelo de IA en vez de información para el usuario. Puede incluir markup directivo, frases “nota para la IA” o indicaciones de sacar credenciales fuera de la conversación. Más contexto en todo lo que necesitás saber sobre Sora.
¿Cómo sé si un servidor MCP es seguro antes de instalarlo?
Corriendo un escáner estático sobre su configuración, manifest o código fuente antes de instalarlo. Herramientas como Sentinel Scan revisan tool poisoning, sinks peligrosos y secretos hardcodeados con un comando, en segundos, sin ejecutar el servidor.
¿Qué es un rug pull en el contexto de MCP?
Un rug pull es cuando la descripción de una herramienta MCP ya aprobada cambia después, sin que el usuario se entere. Se detecta guardando un hash SHA-256 de la descripción original y comparándolo después de cada actualización.
¿Qué herramientas existen para escanear servidores MCP?
Sentinel Scan es una de las opciones disponibles, instalable con pip install sentinel-scan, con salida en terminal, JSON o SARIF y una GitHub Action lista para CI. Existen otros escáneres MCP en el ecosistema, pero varían en cuánto documentan su propia tasa de error.
¿Por qué los escáneres de seguridad MCP dan falsos positivos?
Porque muchas reglas detectan patrones de texto sin distinguir contexto, marcando como amenaza a documentación que solo cita un ejemplo de ataque. En el audit de abril de 2026 citado por el proyecto, 27 detecciones se redujeron a 6 preocupaciones genuinas por este motivo.
Conclusión
Lo que cambia con Sentinel Scan no es la lista de amenazas que cubre, sino la honestidad del número que acompaña a cada regla. 18 verdaderos positivos, 0 falsos positivos, 0 falsos negativos sobre un corpus de 32 casos es un dato verificable, no una promesa de marketing. Si manejás agentes con servidores MCP en producción, correr sentinel-scan scan antes de cada instalación y verify después de cada actualización es un paso concreto y barato. Lo que no resuelve es el runtime: sandboxing, scope de permisos y revisión humana siguen siendo tu responsabilidad, esto es la puerta de entrada, no la cerca completa.