
En pocas palabras: Precedent, el agente de cuentas por pagar construido sobre Hindsight, solo aprueba una factura si encuentra un precedente que lo respalde: sin memoria, la confianza cae a 0% y escala a una persona. En una prueba de 11 semanas con 96 facturas, pasó de 0% de aciertos en la semana 1 a 100% en las últimas cuatro, con 88% de excepciones resueltas sin intervención humana y cero errores de aprobación automática.
Una factura del proveedor de empaques llegó un 4,52% por encima del precio pactado en la orden de compra, con una nota que decía “tarifas revisadas por aumento del papel kraft”. El agente de IA con memoria que la procesó la retuvo sin dudar, porque recordaba que semanas antes había devuelto a compras una variación del 4,26% del mismo proveedor. Sin esa memoria, la hubiera escalado a una persona.
Hindsight es un sistema de memoria para agentes de IA desarrollado por Vectorize que extrae hechos de texto en lugar de guardar conversaciones completas y los recupera con cuatro búsquedas en paralelo. Precedent es un agente de cuentas por pagar construido sobre esa memoria: solo aprueba una factura si encuentra un precedente que lo respalde, y si no hay memoria, la confianza cae a 0% y la decisión pasa a un humano.
En este artículo:
- En 30 segundos
- ¿Qué problema resuelve un agente de IA en cuentas por pagar?
- ¿Cómo funciona la memoria Hindsight dentro del agente Precedent?
- ¿Cómo calcula el agente su nivel de confianza?
- ¿Qué resultados dio la prueba con 11 semanas de historial real de facturas?
- ¿Qué límites y errores mostró el sistema en producción?
- ¿Qué lecciones aplican a otros agentes de IA con memoria que toman decisiones repetitivas?
- ¿Cuándo tiene sentido construir algo como Precedent y cuándo no?
- Errores comunes al implementar memoria en un agente de IA
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Precedent es un agente de IA con memoria para cuentas por pagar, construido sobre Hindsight, que solo decide si encuentra un precedente que lo respalde.
- En la prueba con 96 facturas de 12 proveedores, el agente pasó de 0% de aciertos en la semana 1 a 100% de coincidencia y 88% de excepciones resueltas sin persona en las últimas 4 semanas.
- Sin memoria, la confianza cae a 0% y toda factura escala a un humano, según documenta el desarrollador en dev.to.
- Un bug real mostró que once aprobaciones casi idénticas de un proveedor tapaban el único rechazo guardado, y una factura que debía retenerse escaló a una persona en lugar de resolverse sola.
- El código de Precedent está publicado en GitHub bajo el usuario Sowmya-Krishna05.
¿Qué problema resuelve un agente de IA en cuentas por pagar?
Resuelve las excepciones del 3-way match: cuando la orden de compra, la recepción de mercadería y la factura no calzan, alguien tiene que decidir qué hacer, y según el repositorio de Precedent en GitHub entre el 20% y el 40% de las facturas de una empresa mediana caen en esa categoría.
El tema es que esas excepciones se repiten todos los meses, casi siempre con el mismo patrón. El proveedor de empaques agrega un recargo por combustible que su contrato permite hasta 2,5% (cláusula 7.2). El proveedor de granos factura en quintales contra órdenes de compra escritas en kilos. El proveedor de logística factura el pedido completo en el primer envío parcial. La imprenta reenvía facturas impagas agregando “/R” al final. Y de vez en cuando llega una carta amable avisando que la cuenta bancaria cambió.
¿Y quién sabe la respuesta correcta para cada caso? Por lo general, exactamente una persona senior del equipo. Un LLM sin contexto no sirve de mucho acá: le das la factura, la orden de compra y la política, y escribe un párrafo prolijo que termina escalando todo. La cláusula 7.2 no está en ningún documento que el modelo pueda leer. Está en el historial de decisiones que tomó esa persona, año tras año. Lo explicamos a fondo en esta guía sobre cómo funciona ChatGPT.
¿Cómo funciona la memoria Hindsight dentro del agente Precedent?
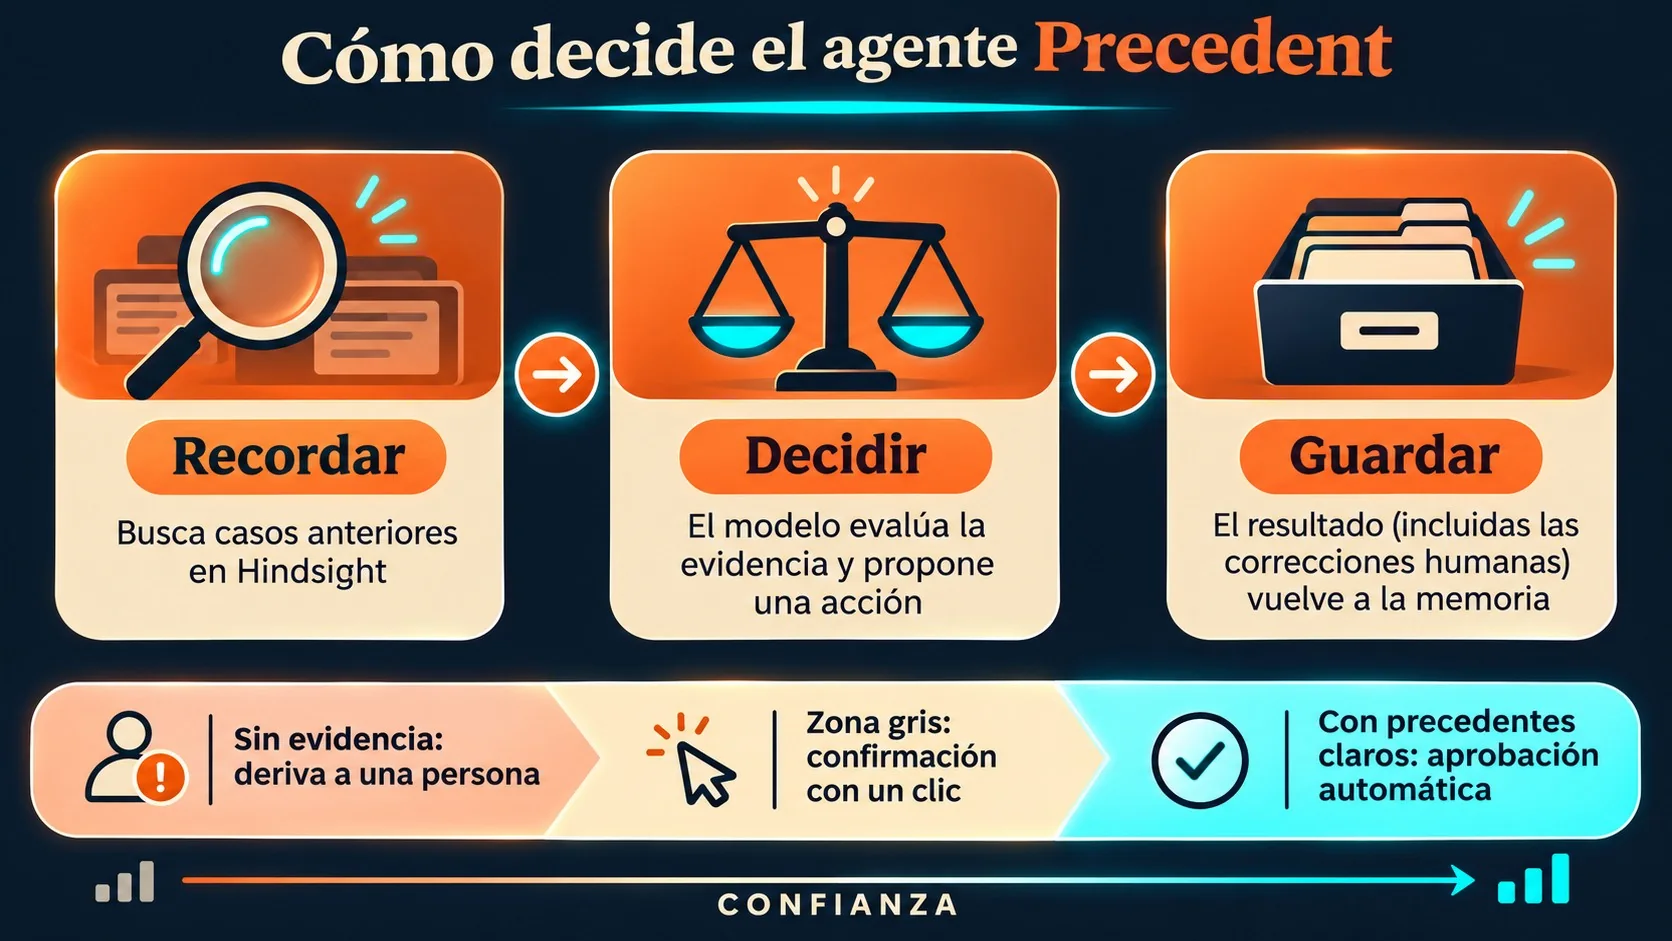
Funciona con un ciclo de tres pasos: recuerda precedentes, decide con un LLM validado contra esa evidencia, y guarda el resultado para la próxima vez. Un match de 3 vías detecta la excepción (variación de precio, cantidad, unidad de medida, tipo de impuesto, cargos no planificados, duplicados, cambios de cuenta bancaria) y recién ahí entra el agente.
- Recall: pide a Hindsight precedentes filtrados por proveedor y tipo de excepción, y después por el mismo tipo de excepción entre todos los proveedores, para capturar reglas de política general.
- Decide: un LLM corriendo en Groq (gpt-oss-120b, con qwen3-32b como respaldo) pesa esos precedentes y propone una decisión mediante function calling. Un razonador auditable chequea esa propuesta contra la evidencia antes de aceptarla.
- Retain: pase lo que pase, el resultado vuelve a Hindsight, incluida la corrección de una persona cuando el agente se equivocó, con la razón en sus propias palabras.
Lo interesante del diseño es cómo se escribe cada memoria: en prosa y con tags al mismo tiempo, como si fuera una fila de base de datos. La prosa alimenta la extracción de hechos de Hindsight (eso es lo que le permite construir una observación como “los recargos de Shree Balaji se aprueban bajo la cláusula 7.2”). Los tags, en cambio, sirven para preguntas exactas: este proveedor, esta excepción, qué se decidió. Y el document_id importa más de lo esperado, porque Hindsight extrae varios hechos por documento, y sin deduplicar por ese identificador, un caso terminaría votando tres veces en vez de una.
¿Cómo calcula el agente su nivel de confianza?
Calcula la confianza en función exclusiva de lo que tiene en memoria, nunca de lo que el LLM “cree”. Con el banco de memoria vacío, toda excepción marca 0% y va directo a una persona. La autonomía se gana factura por factura resuelta, no se asume de entrada.
Para variaciones de precio y cargos extra, el razonador no vota por mayoría simple: aprende el umbral de tolerancia del proveedor como un techo (lo máximo aprobado) y un piso (lo mínimo rechazado), y la zona gris entre ambos siempre va a un humano. El rol del LLM es explicar la decisión y pesar contexto que los tags no capturan, como un correo del proveedor o una alerta de fraude, pero no puede inflar la certeza: si el modelo no está de acuerdo con lo que dice la memoria, la confianza queda topada en 50% y decide una persona. Si no hay ningún precedente que cubra el caso, el tope baja a 40%.
Eso sí: los cambios de cuenta bancaria siempre van a tesorería, sin importar qué tan alta sea la confianza calculada. No hay excepción posible para ese tipo de riesgo. Sobre eso hablamos en esta nota sobre qué es GPT.
¿Qué resultados dio la prueba con 11 semanas de historial real de facturas?
Dio una curva de aprendizaje medible: el agente pasó de no acertar nada en la primera semana a coincidir con el 100% de las decisiones humanas en el último mes de la prueba. El experimento replicó 11 semanas de historial de cuentas por pagar (96 facturas, 12 proveedores, modelado sobre una empresa mediana de alimentos de Hyderabad) y dejó que el agente recomendara antes de revelar qué había decidido la persona en ese momento.
| Métrica | Semana 1 | Últimas 4 semanas | Memoria apagada |
|---|---|---|---|
| Coincidencia con decisión humana | 0% | 100% | 0% |
| Excepciones resueltas sin persona | 0% | 88% | 0% |
| Auto-aprobaciones erróneas | 0 | 0 | 0 |
El dato que más llama la atención es el cero: en toda la corrida, con memoria activa, no hubo una sola aprobación automática equivocada. Cuando se repitió la misma tanda de facturas con la memoria apagada, todo volvió a escalar porque no había ningún precedente del cual partir. Y en el caso de los cambios de cuenta bancaria, Hindsight recordó tres casos previos de otros proveedores (dos confirmados como fraude) más un correo interno de advertencia sobre cartas bancarias falsas, lo que bastó para bloquear el pago y mandarlo a una llamada de verificación de tesorería.
¿Qué límites y errores mostró el sistema en producción?
Mostró que el ranking por relevancia puede esconder justo la memoria que define una regla. La primera corrida contra Hindsight Cloud, la misma factura del 4,52% del inicio, escaló en lugar de quedar retenida, aunque en las pruebas locales había funcionado bien.
La causa fue específica: ese proveedor tenía once aprobaciones registradas y un solo rechazo. Hindsight ordena resultados por relevancia dentro de un presupuesto de tokens, y las once aprobaciones casi idénticas tapaban al único rechazo que marcaba el límite real. Sin ese dato, el razonador vio un techo de 2,43% y ningún piso, y concluyó que 4,52% estaba “por encima de todo lo visto antes”, en vez de reconocerlo como un caso que ya había sido rechazado antes con una magnitud parecida. Más contexto en este otro caso de agentes integrados con Jira.
La solución no fue ajustar el modelo, fue cambiar la pregunta. El agente ahora pide explícitamente el límite, consultando por separado las acciones de frontera (retener para compras, devolver al proveedor) con una búsqueda estricta por tags. Los casos raros suelen ser justo los que definen la regla, y confiar en una sola consulta rankeada por relevancia para encontrarlos es, lisa y llanamente, una apuesta perdida.
¿Qué lecciones aplican a otros agentes de IA con memoria que toman decisiones repetitivas?
Aplican sobre todo a cualquier proceso donde la misma decisión se repite mes tras mes y el criterio vive en la cabeza de una sola persona. Las lecciones que deja este caso son concretas, no genéricas.
- La memoria tiene que ser la fuente de la confianza, no un adorno. Si un agente puede estar igual de seguro con el banco de memoria vacío que con uno lleno, la memoria no está haciendo nada.
- Escribí las memorias para dos lectores distintos. Prosa para que el sistema extraiga hechos y reflexione, tags para que el mismo sistema pueda responder preguntas exactas sin ambigüedad.
- Guardá las correcciones humanas con la razón del revisor. Son las memorias más valiosas del banco entero, porque marcan exactamente dónde se equivocó el agente.
- Consultá el límite de forma explícita. El caso que define un umbral suele ser el más raro, y por eso mismo el más fácil de perder en una búsqueda genérica.
- Planificá que el function calling falle. Groq devuelve a veces
tool_use_failedo JSON mal formado; conviene reintentar, tener un modelo de respaldo y, si todo falla, decidir solo con la evidencia de memoria mostrando una advertencia visible.
Ejemplo hipotético: la misma lógica fuera de cuentas por pagar
Nota: lo que sigue es un ejemplo hipotético para ilustrar el principio, no un caso reportado por las fuentes. Pensemos en un agente de mesa de ayuda de IT que decide si aprueba el reembolso de una licencia de software. El equipo de IT viene rechazando reembolsos de una herramienta puntual por arriba de u$s 40 mensuales, pero aprobó sin problema uno de u$s 38 la semana pasada. Si ese agente funcionara como Precedent, no promediaría ambos casos ni fallaría a favor del pedido más reciente: tomaría u$s 38 como techo de aprobación y u$s 40 como piso de rechazo, y cualquier pedido entre esos dos valores —la “zona gris”— iría directo a una persona en lugar de inventar un criterio. Si llegara un pedido de u$s 150 sin ningún precedente parecido en la memoria, el agente no debería animarse a decidir solo: como máximo, sugeriría una recomendación con la confianza topada (en Precedent, ese tope es 40% cuando no hay precedente), dejando la decisión final a alguien del equipo. El valor no está en que el LLM “entienda” la política de reembolsos, sino en que no se le permite estar más seguro que la evidencia que tiene guardada.
¿Cuándo tiene sentido construir algo como Precedent y cuándo no?
No todo proceso repetitivo justifica meses de trabajo construyendo un sistema de memoria. Del propio diseño de Precedent se puede extraer una lista de condiciones que, si se cumplen, hacen más probable que el esfuerzo valga la pena:
- Hay volumen y repetición real. Si las mismas excepciones vuelven a aparecer mes tras mes (como el recargo del 2,5% o la factura en quintales), hay algo para que la memoria aprenda. Si cada caso es distinto, no hay precedente que recuperar.
- El criterio vive en una sola cabeza y no está escrito. Cuando la regla real —la cláusula 7.2, el hábito del proveedor que reenvía con “/R”— nunca llegó a un manual, un LLM sin memoria no tiene de dónde sacarla por más contexto que se le dé.
- El costo de un error automático es asimétrico. Aprobar mal un cambio de cuenta bancaria es mucho peor que escalar de más una factura legítima. Por eso tiene sentido capar la confianza —o directamente excluir del todo la autonomía, como con los cambios bancarios— en los casos de mayor riesgo, aunque eso signifique menos automatización.
- Existe forma de capturar la corrección humana con su razón. El dato más valioso de todo el sistema no es la decisión del agente sino la corrección de la persona cuando se equivoca. Si no hay un flujo para registrar esa corrección con el motivo, la memoria no mejora con el tiempo.
- El equipo puede tolerar arrancar en cero. La semana 1 del experimento tuvo 0% de coincidencia porque la memoria estaba vacía. Si ese arranque lento genera un cuello de botella inaceptable para el negocio, probablemente no es el momento de reemplazar el criterio humano por uno que recién está aprendiendo.
Errores comunes al implementar memoria en un agente de IA
- Confiar en la relevancia por defecto para umbrales. Como pasó en Precedent, un ranking por relevancia puede esconder la única excepción que marca un límite entre miles de casos repetidos. Si tu agente razona con umbrales, pedí ese dato con una búsqueda específica.
- No deduplicar por documento. Si un sistema de memoria extrae varios hechos de un mismo caso y no se filtra por
document_id, ese único caso termina votando varias veces y distorsiona cualquier conteo de precedentes. - Dejar que el LLM decida solo cuando no hay evidencia. Sin memoria, un LLM “razona” igual y entrega una respuesta con apariencia sólida. Topar la confianza cuando no hay precedente (en este caso, en 40%) es lo que evita que esa apariencia se confunda con certeza real.
- Ignorar las fallas de function calling. Asumir que el modelo siempre va a devolver una llamada de función válida es un error común; en la práctica hay que re-prompt, reparar argumentos y tener un modelo de respaldo.
Preguntas Frecuentes
¿Qué es Hindsight y para qué sirve en agentes de IA?
Hindsight es un sistema de memoria para agentes de IA desarrollado por Vectorize que extrae hechos, observaciones y páginas de conocimiento a partir de texto, en lugar de guardar transcripciones completas. Sirve para que un agente recuerde decisiones pasadas y recupere esa información con búsquedas semánticas, por palabra clave, por grafo de entidades y por tiempo, combinadas en paralelo.
¿Cómo funciona un agente de IA para cuentas por pagar?
Funciona detectando primero las facturas que no calzan con la orden de compra y la recepción de mercadería (el llamado 3-way match), y después recuperando precedentes de casos similares antes de proponer una decisión. En el caso de Precedent, esa decisión pasa por un razonador que chequea si la evidencia realmente la respalda antes de autorizar el pago. Esto se conecta con lo que analizamos en la llegada de este nuevo modelo a GitHub Copilot.
¿Qué es el proyecto Precedent de GitHub?
Precedent es un agente open source de cuentas por pagar construido sobre la memoria de Hindsight, publicado en GitHub por el usuario Sowmya-Krishna05. El repositorio incluye un dataset generado de 114 facturas y 12 proveedores, además de scripts para comparar el comportamiento del agente con y sin memoria activa.
¿Cómo le da memoria a un agente de IA para que tome mejores decisiones?
Se le da memoria guardando cada decisión resuelta (incluidas las correcciones humanas) como un documento con prosa y con tags exactos por proveedor, tipo de excepción y acción tomada. Esa combinación permite que el agente consulte tanto el significado general del caso como el dato preciso que necesita para decidir.
¿Qué pasa si un agente de IA no tiene memoria de decisiones anteriores?
Sin memoria de decisiones anteriores, la confianza del agente queda en 0% y cada caso escala a una persona, según se verificó al correr la misma tanda de 96 facturas con la memoria de Precedent apagada. Un LLM sin ese historial puede escribir una respuesta razonable, pero no conoce reglas no escritas como el límite exacto de un recargo contractual.
Conclusión
Lo que cambia con Precedent no es el modelo de lenguaje, es dónde vive la certeza. Durante años, el criterio para resolver una excepción de cuentas por pagar vivió en la cabeza de una sola persona senior, y cuando esa persona estaba de vacaciones, las facturas se acumulaban o se pagaban mal. Acá la certeza queda en un banco de memoria auditable, que arranca en cero y solo gana autonomía caso por caso resuelto.
Para cualquiera que esté evaluando meter un agente de IA con memoria en un proceso repetitivo, el dato más útil de todo este experimento no es el resultado final sino el bug: once aprobaciones casi idénticas pueden tapar el único caso que define un límite. Antes de automatizar una decisión con umbrales, conviene preguntarse si el criterio con el que se va a medir el éxito está realmente en la memoria, o si simplemente nunca se lo buscó de la forma correcta.