
En pocas palabras: El costo real de un modelo de IA no depende solo del modelo, sino del wrapper que lo rodea: system prompt, RAG y tool calling. Según el pricing de OpenAI, gpt-6-astra cobra USD 10 por millón de tokens de entrada y USD 50 por millón de salida, cinco veces más.
El costo por token IA no es una tarifa fija: se paga distinto por los tokens que vos mandás (entrada) y los que el modelo te devuelve (salida), con la salida entre tres y ocho veces más cara. El pricing público de OpenAI confirma esa asimetría en toda su línea de modelos.
El costo por token IA es el precio que cobra un proveedor de modelos de lenguaje por cada fragmento de texto procesado, medido en tokens de entrada (lo que enviás) y tokens de salida (lo que el modelo genera). Según el pricing público de OpenAI, la salida siempre cuesta más que la entrada porque generarla exige cómputo secuencial, token por token, mientras que leer la entrada es un único pase paralelo por la red.
En este artículo:
- En 30 segundos
- ¿Qué es un token y qué es la ventana de contexto en un modelo de lenguaje?
- ¿Qué diferencia hay entre un modelo base y un modelo instruction-tuned (chat)?
- ¿Qué es el wrapper que envuelve a un modelo de IA?
- ¿Qué son el system prompt, el RAG y el tool calling?
- ¿Por qué el costo por token no es una tarifa plana?
- ¿Por qué el historial de la conversación encarece cada turno?
- Qué significa para empresas y equipos en Latinoamérica
- Errores comunes al calcular el costo por token IA
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- La salida cuesta entre 3 y 8 veces más que la entrada en la mayoría de los proveedores, según explica la serie Technical Logbook.
- gpt-6-astra de OpenAI cobra USD 10 por millón de tokens de entrada y USD 50 por millón de tokens de salida (pricing estándar).
- gpt-6-luna, el modelo más barato de la línea, cobra USD 0,10 de entrada y USD 0,50 de salida por millón de tokens.
- Cada turno de una conversación reenvía el historial completo como tokens de entrada, así que 40 intercambios salen mucho más que 40 preguntas sueltas.
- El prompt caching de OpenAI baja el costo de la entrada repetida hasta un 90% en gpt-6-astra: de USD 10 a USD 1 por millón de tokens cacheados.
¿Qué es un token y qué es la ventana de contexto en un modelo de lenguaje?
Un token es el fragmento de texto más chico que procesa un modelo de lenguaje: puede ser una palabra completa, parte de una palabra, un signo de puntuación o un espacio. Un LLM nunca “lee” tu oración como la leés vos. La ve como una secuencia numerada de fragmentos, y sobre esa secuencia hace la única tarea que sabe hacer: predecir cuál es el token que más probablemente viene después.
En inglés, la relación aproximada es de un token por cada tres cuartos de palabra, según detalla la fuente de Technical Logbook. En español la proporción cambia (tenemos más flexiones, más acentos, más variantes de una misma raíz), pero la lógica de fondo es idéntica.
Ahí entra la ventana de contexto: la cantidad máxima de tokens que el modelo puede “tener a la vista” en un momento dado, sumando lo que vos escribiste y lo que él ya generó. Cuando una conversación se alarga más de eso, el modelo pierde acceso a las partes más viejas. No porque las “olvide” en el sentido humano. Porque ya no entran en la ventana.
¿Qué diferencia hay entre un modelo base y un modelo instruction-tuned (chat)?
Un modelo base completa texto con fluidez pero no tiene ningún concepto de “pregunta” y “respuesta”; un modelo instruction-tuned, en cambio, pasó por una etapa de ajuste con ejemplos de conversaciones reales para comportarse como asistente. Esa diferencia explica por qué GPT-3 existía desde 2020 y validaba las leyes de escala a una magnitud inédita, y sin embargo no fue GPT-3 el que llegó a cien millones de usuarios en dos meses. Fue ChatGPT, dos años después. Lo explicamos a fondo en la llegada de GPT-6 Astra a Copilot.
Ponele que le escribís a un modelo base “¿Cuál es la capital de Francia?”. No necesariamente te responde “París”. Puede, con la misma probabilidad estadística, seguir la oración con otra pregunta parecida, porque en sus datos de entrenamiento eso también es un patrón frecuente: listas de preguntas de geografía, exámenes, trivias. El modelo no se está equivocando. Está haciendo exactamente lo que le enseñaron a hacer: completar texto de forma plausible.
Convertir ese generador de texto libre en un asistente que sigue instrucciones requiere RLHF (reinforcement learning from human feedback): personas evaluando y corrigiendo conversaciones hasta que el modelo aprende a comportarse como un interlocutor y no como una máquina de autocompletar. Por eso algunas empresas ofrecen acceso tanto al modelo base como al afinado de la misma familia: el base, aunque sea menos usable en una charla, a veces retiene capacidades de razonamiento puro que el ajuste posterior diluye un poco en ciertas tareas.
¿Qué es el wrapper que envuelve a un modelo de IA?
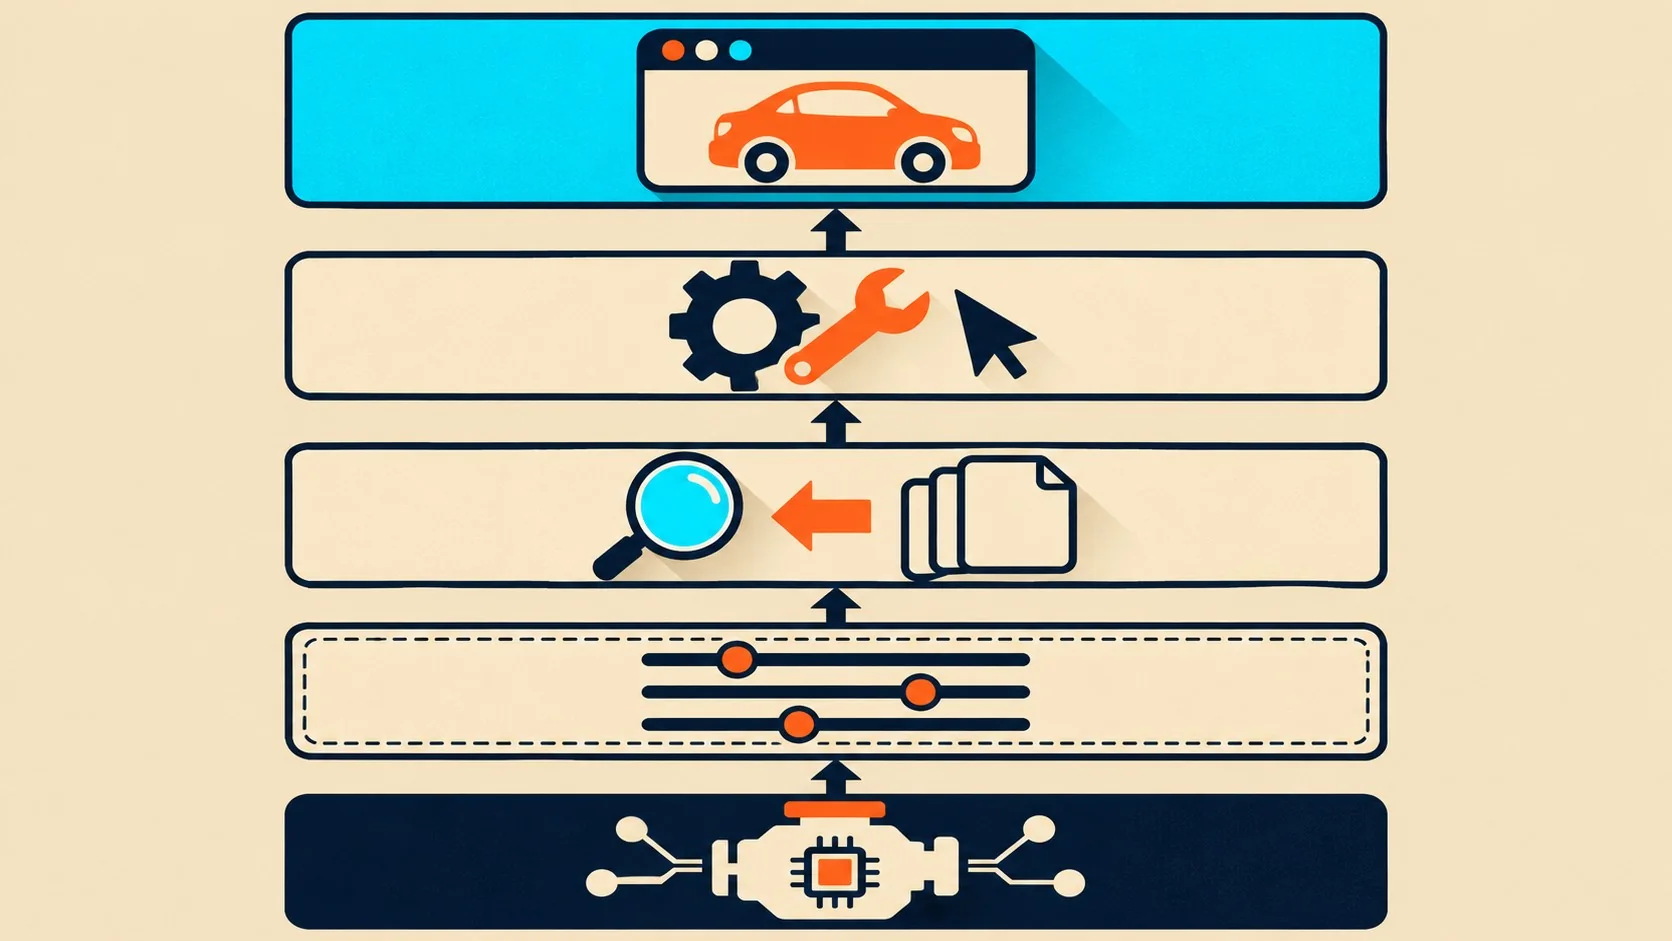
El wrapper es el conjunto de instrucciones, integraciones y reglas que envuelven a un modelo de lenguaje y lo convierten en un producto específico. Esa capa es la que determina casi todo lo que una herramienta puede o no puede hacer, mucho más que el modelo en sí.
El modelo es el motor: razona, genera texto, predice el siguiente token con fluidez asombrosa. Pero un motor solo no es un auto. Le falta la carrocería, el tablero, la dirección, todo lo que convierte una capacidad bruta en algo utilizable para un propósito concreto. Más contexto en nuestra guía completa sobre ChatGPT.
¿Y qué pasa cuando dos productos usan exactamente el mismo modelo por debajo? Se comportan distinto. Siempre. Porque lo que los diferencia no es el motor, es todo lo que le construyeron alrededor, que es justamente el punto que arranca esta nota.
¿Qué son el system prompt, el RAG y el tool calling?
El system prompt son instrucciones invisibles que un producto le inyecta al modelo antes de cada conversación para fijar tono y límites; el RAG le da acceso a información externa sin que el modelo aprenda nada permanente; el tool calling le permite ejecutar acciones concretas y recibir el resultado de vuelta. Son los tres componentes que explican por qué el mismo modelo subyacente puede sonar y actuar distinto según en qué producto lo uses.
- System prompt: le dice al modelo qué tono usar, qué hacer si no sabe algo, qué límites respetar. Es la razón por la que el mismo motor suena distinto en cada herramienta.
- RAG (Retrieval-Augmented Generation): un sistema busca fragmentos relevantes en una base de datos (documentos internos de tu empresa, por ejemplo) y se los agrega al contexto antes de que el modelo genere la respuesta. Cada consulta es un préstamo temporal de información, nada queda grabado en el modelo.
- Tool calling (o function calling): el modelo le pide al sistema que ejecute una acción (buscar en la web, consultar una base, correr una calculadora, enviar un mail) y recibe el resultado para seguir razonando con él.
¿Por qué el costo por token no es una tarifa plana?
El costo por token no es plano porque cada proveedor cobra una tarifa distinta por entrada y por salida, y la salida siempre sale más cara. Procesar la entrada es un solo pase paralelo por la red neuronal; generar la salida es secuencial, un token a la vez, cada uno requiriendo otro pase completo sobre el contexto acumulado hasta ese punto. Generar cuesta más cómputo que leer, y eso se traduce directo en el precio.
El pricing público de OpenAI del catálogo de modelos flagship muestra esa asimetría con una regularidad llamativa: en los cuatro modelos principales de la línea estándar, la salida cuesta exactamente cinco veces más que la entrada.
| Modelo | Input (USD/1M tokens) | Output (USD/1M tokens) | Cached input (USD/1M tokens) | Ratio salida/entrada |
|---|---|---|---|---|
| gpt-6-astra | 10,00 | 50,00 | 1,00 | 5x |
| gpt-6.1-sol | 2,00 | 10,00 | 0,10 | 5x |
| gpt-6.1-terra | 1,00 | 5,00 | 0,05 | 5x |
| gpt-6-luna | 0,10 | 0,50 | 0,01 | 5x |
Fijate que gpt-6-astra, el modelo tope de gama, cuesta cien veces más que gpt-6-luna en entrada y en salida por igual. No es que astra sea “cien veces más inteligente”: es que tiene más capacidad representacional y cuesta más cómputo correrlo, lo cual no es poco cuando estás armando el presupuesto de un producto que va a procesar millones de requests por mes. Relacionado: todo lo que necesitás saber sobre GPT.
¿Por qué el historial de la conversación encarece cada turno?
El historial encarece cada turno porque la mayoría de las implementaciones reenvían la conversación completa como parte del contexto de entrada en cada intercambio. No es que el modelo “recuerde” lo que dijiste diez mensajes atrás, es que literalmente todo ese historial se vuelve a mandar, turno tras turno, y cada palabra de esa historia acumulada se factura de nuevo como tokens de entrada.
Subís una conversación, la vas alargando, sentís que “no estás pidiendo nada nuevo”, el sistema te sigue respondiendo bien, todo parece normal, y de repente la factura del mes te sorprende porque nadie te avisó que una charla de cuarenta intercambios no cuesta lo mismo que cuarenta preguntas sueltas: cuesta bastante más, porque el contexto crece con cada turno que agregás.
Acá entra el prompt caching. OpenAI ofrece tarifas de entrada cacheada notablemente más bajas: en gpt-6-astra, el input cacheado cuesta USD 1 por millón de tokens contra USD 10 del input normal, una reducción del 90%. En gpt-6.1-terra la caída es incluso mayor en términos relativos, de USD 1 a USD 0,05. Diseñar un sistema que minimice cuánto contexto hay que reenviar, resumiendo el historial en vez de acumularlo íntegro, o aprovechando estos descuentos de cache, no es una optimización menor. Es, muchas veces, la diferencia entre un producto viable y uno que se vuelve económicamente inmanejable a escala.
Qué significa para empresas y equipos en Latinoamérica
Para un equipo que factura en pesos y paga APIs en dólares, la asimetría entrada-salida no es un detalle técnico: es una línea del presupuesto. Si tu producto genera respuestas largas (resúmenes, reportes, código) vas a sentir el costo de salida mucho más que el de entrada, y ahí conviene revisar si necesitás el modelo tope de gama o si un modelo intermedio, tipo gpt-6.1-terra, alcanza para la tarea.
Lo que no podés inferir de los precios publicados es cuánto vas a gastar realmente en producción: eso depende de cuántos turnos promedio tienen tus conversaciones, cuánto contexto reenviás y si implementaste caching. Esa cuenta hay que hacerla con tus propios logs, no con la tabla de precios del proveedor.
Errores comunes al calcular el costo por token IA
- Presupuestar solo con el precio de entrada: si tu aplicación genera respuestas largas, el costo real está dominado por la salida, que sale entre 3 y 8 veces más según el proveedor.
- Ignorar el crecimiento del historial: calcular el costo de “una consulta” y multiplicarlo por la cantidad de turnos sin tener en cuenta que cada turno reenvía todo lo anterior. El resultado real termina siendo varias veces más alto que esa cuenta simple.
- No activar prompt caching cuando corresponde: si tu system prompt o tus documentos de contexto se repiten en cada llamada, no cachearlos significa pagar entrada completa una y otra vez por el mismo texto.
- Elegir el modelo más caro “por si acaso”: usar gpt-6-astra para tareas que gpt-6.1-terra resuelve igual de bien implica pagar hasta diez veces más por token sin necesidad real.
Preguntas Frecuentes
¿Qué es un token en inteligencia artificial?
Un token es el fragmento de texto más chico que procesa un modelo de lenguaje: puede ser una palabra, parte de una palabra, un signo de puntuación o un espacio. El modelo no lee oraciones como las leés vos, las ve como una secuencia numerada de estos fragmentos.
¿Por qué se paga distinto por tokens de entrada y de salida?
Se paga distinto porque procesar la entrada es un solo pase paralelo por la red neuronal, mientras que generar la salida es secuencial, un token a la vez. Esa diferencia de cómputo hace que la salida cueste entre tres y ocho veces más que la entrada, según documenta el pricing de proveedores como OpenAI.
¿Qué diferencia hay entre un modelo base y ChatGPT?
Un modelo base completa texto sin concepto de pregunta y respuesta; ChatGPT es la versión instruction-tuned de un modelo base, ajustada con RLHF para seguir instrucciones y sostener una conversación coherente. GPT-3 existía desde 2020 pero fue ChatGPT, dos años después, el que convirtió esa tecnología en un producto masivo.
¿Qué es el system prompt y para qué sirve?
El system prompt es un conjunto de instrucciones invisibles para el usuario que un producto inyecta al modelo antes de cada conversación. Define el tono, qué hacer si el modelo no sabe algo y qué límites respetar, y es la razón por la que el mismo modelo subyacente puede comportarse distinto en dos aplicaciones diferentes.
¿Qué es RAG y qué es tool calling en IA?
RAG (Retrieval-Augmented Generation) es el mecanismo que le da a un modelo acceso a información externa buscando documentos relevantes y agregándolos al contexto antes de generar una respuesta, sin que el modelo aprenda nada permanente. Tool calling es la capacidad del modelo de pedirle al sistema que ejecute una acción concreta, como buscar en la web o consultar una base de datos, y recibir el resultado para seguir razonando.
Conclusión
El costo por token IA deja de ser un misterio en cuanto separás entrada de salida y entendés que el historial de la conversación se refactura en cada turno. Con el pricing público de OpenAI como referencia, la brecha es consistente: la salida cuesta cinco veces más que la entrada en toda la línea estándar, y el caching puede bajar hasta un 90% lo que pagás por contexto repetido.
Lo que de verdad define cuánto vas a gastar en producción no es el modelo que elegís, es el wrapper que le construís alrededor: cuánto contexto reenviás, si cacheás lo repetible, si usás RAG en vez de meter documentos enteros en cada llamada. Antes de elegir el modelo más caro de la lista, mirá si tu wrapper está diseñado para no desperdiciar tokens. Esa decisión de arquitectura pesa más en la factura final que la diferencia entre dos modelos de la misma familia.