
En pocas palabras: NerveCenter, un agente SRE con el modelo openai/gpt-oss-120b sobre Groq y memoria Hindsight, hizo más seguros sus comandos al recuperar incidentes pasados: en el caso INC-892 sugiere redis-cli FLUSHALL ASYNC pero advierte que esa orden causó un pico de latencia de 12 segundos la vez anterior.
NerveCenter es un agente de IA para guardias técnicas (on-call) que responde alertas de producción como Redis OOM o CrashLoopBackOff citando comandos exactos de incidentes pasados, en vez de inventar sugerencias genéricas. Lo construyó un equipo liderado por Naguru Kethan Kumar Reddy, con Manya Agarwal entre sus desarrolladoras, usando el modelo openai/gpt-oss-120b corriendo sobre Groq y una capa de memoria basada en Hindsight.
En este artículo:
- En 30 segundos
- ¿Qué es NerveCenter, el agente SRE creado para probar la memoria Hindsight?
- ¿Cómo funciona la memoria Hindsight dentro del agente?
- ¿Qué diferencia hay entre una respuesta con memoria y una genérica?
- ¿Cómo se vuelve más seguro un comando como FLUSHALL con memoria de incidentes?
- Ejemplo hipotético: cómo se vería esto con una alerta distinta
- ¿Qué otros casos muestra el agente, como el de Kubernetes CrashLoopBackOff?
- ¿Qué limitaciones reconoce el propio creador del proyecto?
- Criterios para decidir si tu equipo necesita algo así
- ¿Qué lecciones deja este experimento para equipos de DevOps?
- Errores comunes al armar memoria para un agente SRE
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- NerveCenter es un dashboard en Streamlit que responde alertas de infraestructura usando el modelo openai/gpt-oss-120b sobre Groq.
- Un toggle en la interfaz activa o desactiva la memoria Hindsight para comparar respuestas genéricas contra respuestas basadas en incidentes reales.
- En el caso INC-892, el agente recomienda
redis-cli FLUSHALL ASYNCpero adjunta la advertencia de que esa misma orden causó un pico de latencia de 12 segundos la vez anterior. - El recall actual funciona por coincidencia de palabras clave sobre solo tres incidentes cargados a mano, no por búsqueda semántica.
- El código está publicado en GitHub bajo el repositorio nervecenter-sre-agent, hecho por un equipo de cuatro personas como prueba de concepto.
¿Qué es NerveCenter, el agente SRE creado para probar la memoria Hindsight?
NerveCenter es un proyecto personal, no un producto de OpenAI ni de ninguna empresa de infraestructura. Lo armó un equipo de cuatro personas (sync4ce) como prueba de concepto publicada en GitHub, con el objetivo puntual de resolver un problema concreto: los asistentes genéricos de IA, a las 3 de la mañana, te tiran un “revisá la conexión a la base de datos” que no sirve para un deadlock de Postgres en la tabla de checkout.
La interfaz es simple a propósito. Es un chat en Streamlit donde escribís el nombre de la alerta (ponele, Redis OOM Error o Kubernetes pods failing with CrashLoopBackOff) y el agente busca incidentes parecidos, te muestra el registro recuperado para que lo verifiques, y recién después genera la respuesta con el modelo. El motor de inferencia es Groq corriendo openai/gpt-oss-120b, elegido por la latencia baja que necesita un flujo de on-call real.
¿Cómo funciona la memoria Hindsight dentro del agente?
La memoria Hindsight funciona con un interruptor en el sidebar que decide si el modelo responde solo o con contexto de incidentes previos. Con el toggle apagado, el system prompt es genérico: le pide al modelo que actúe como un SRE y dé comandos, sin ningún dato del historial real de la organización.
Con el toggle prendido, la cosa cambia. El sistema recupera un incidente parecido y lo inyecta en el prompt con una instrucción explícita: “DEBES basar tu solución estrictamente en esta memoria de incidentes pasados, citar los comandos específicos usados y resaltar las advertencias del post-mortem”, según el fragmento de código compartido por Manya Agarwal en el artículo donde documentó el proyecto. Ahí es donde entra agente IA con memoria para SRE como concepto central: no es un chatbot que improvisa, es uno que cita su fuente antes de responder.
¿Qué diferencia hay entre una respuesta con memoria y una genérica?
La diferencia es la especificidad: sin memoria el agente da un diagnóstico de manual, con memoria da el comando exacto más la advertencia de lo que salió mal la última vez. Son dos prompts distintos corriendo el mismo modelo, y el resultado no se parece en nada.
El system prompt sin memoria dice, textual: “Sos un ingeniero SRE de élite. Da comandos exactos de terminal, análisis de causa raíz y consejos de post-mortem para caídas de servidor.” Es competente, pero es lo que te daría cualquier asistente genérico, sin saber nada de tu entorno específico. El prompt con memoria agrega el bloque “CRITICAL HINDSIGHT MEMORY” con el registro del incidente completo: síntoma, causa raíz, resolución y post-mortem. El modelo deja de adivinar y empieza a trabajar sobre un caso documentado.
| Aspecto | Sin memoria Hindsight | Con memoria Hindsight |
|---|---|---|
| Tipo de respuesta | Consejo genérico de manual | Comando exacto del incidente documentado |
| Advertencias incluidas | Ninguna | Post-mortem con riesgos conocidos |
| Verificabilidad | No hay fuente para chequear | Registro visible en un expander de la UI |
| Ejemplo Redis | “Revisá la memoria del cluster” | redis-cli FLUSHALL ASYNC + aviso de latencia de 12 segundos |
¿Cómo se vuelve más seguro un comando como FLUSHALL con memoria de incidentes?
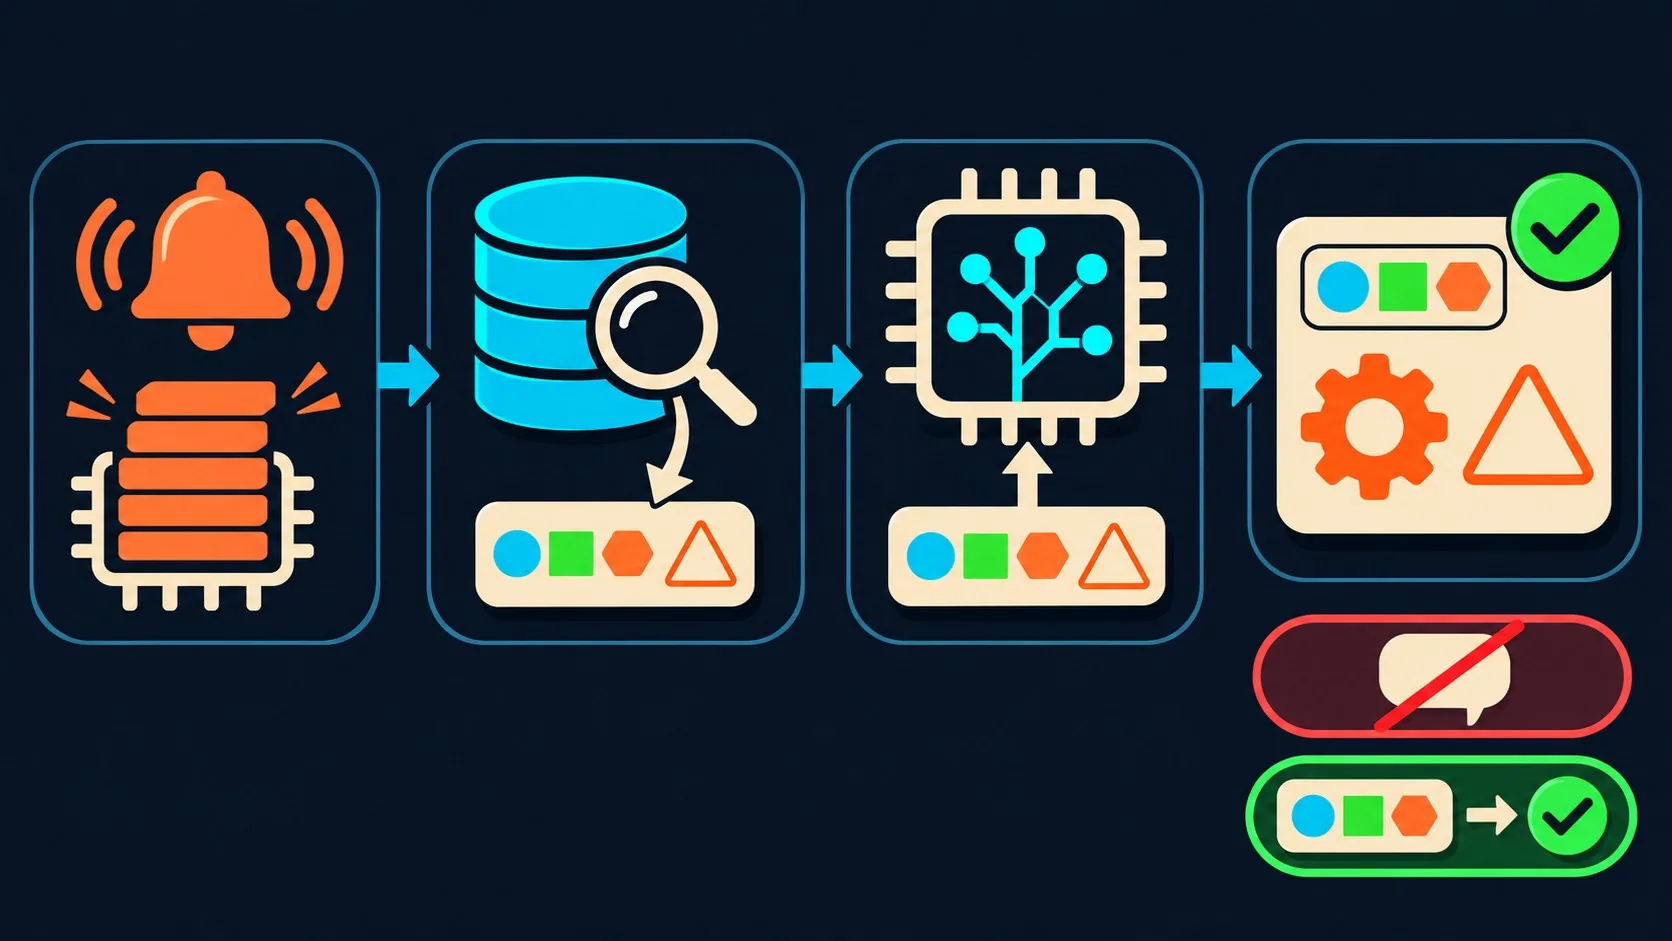
Un comando como FLUSHALL se vuelve más seguro cuando el agente adjunta, en la misma respuesta, el costo que tuvo ejecutarlo la vez anterior. En el incidente INC-892 (severidad P1), el síntoma fue un error de memoria de Redis en el cluster principal de API, causado por claves de sesión que no expiraban por una política de TTL mal configurada.
La resolución documentada fue ejecutar redis-cli FLUSHALL ASYNC y escalar el nodo ElastiCache a tamaño r6g.2xlarge. Hasta ahí, nada que un asistente genérico no pudiera sugerir, con el riesgo de que lo tire con total confianza y cero contexto. Lo que cambia la jugada es el post-mortem: ese mismo comando causó un pico de latencia de 12 segundos la vez anterior, y la lección guardada es enrutar el tráfico al cluster standby antes de ejecutar el flush la próxima vez. El prompt obliga al modelo a citar el post-mortem, así que la advertencia llega junto con el comando, no después del desastre.
Ejemplo hipotético: cómo se vería esto con una alerta distinta
Ejemplo hipotético, no documentado en las fuentes originales. Imaginemos que un equipo de e-commerce usa un sistema con esta misma lógica y recibe la alerta “Timeout en gateway de pagos durante Black Friday”. Si el patrón de NerveCenter se mantiene, el flujo debería verse así:
- Sin memoria: el agente sugeriría algo genérico como “revisá la configuración de timeout del servicio de pagos”, sin saber si ese timeout ya se tocó antes ni qué pasó cuando se lo hizo.
- Con memoria: el sistema debería recuperar un incidente previo con ese mismo síntoma (si existiera en su base), mostrar el comando o cambio de configuración que se usó la vez anterior, y adjuntar el post-mortem correspondiente: por ejemplo, que subir el timeout sin ajustar el circuit breaker generó una cola de reintentos que saturó otro servicio.
Esto es una extrapolación razonable del patrón que describen las fuentes (post-mortem viaja junto al comando), no un caso real documentado por el equipo de NerveCenter. Sirve para ilustrar que el valor del diseño no depende de Redis o Kubernetes puntualmente: depende de que exista un registro de “qué pasó la última vez que hicimos esto”, sea cual sea la tecnología.
¿Qué otros casos muestra el agente, como el de Kubernetes CrashLoopBackOff?
El otro caso documentado es Kubernetes con pods en CrashLoopBackOff, resuelto subiendo el timeout del liveness probe de 3 a 10 segundos. La causa raíz, según el incidente INC-911, fue que el liveness probe fallaba por la latencia de un gateway de pagos externo, no por un problema real del pod.
La lección del post-mortem acá es más de diseño que de comando puntual: no hagas fallar liveness probes por la latencia de una API externa, usá readiness probes para dependencias de terceros. Es el tipo de conocimiento que normalmente vive en la cabeza de un ingeniero senior y en ningún otro lado. La memoria lo saca de ahí y lo pone en una herramienta que cualquiera del equipo puede consultar a las 3 de la mañana.
¿Qué limitaciones reconoce el propio creador del proyecto?
El propio equipo admite que la memoria todavía se carga a mano y que el recall actual es un simple keyword match sobre tres incidentes, no una búsqueda semántica. Funciona para una demo. No generaliza si alguien describe la misma alerta con otras palabras.
- Memoria sembrada manualmente: los tres registros de incidentes (INC-892, INC-904, INC-911) fueron cargados a mano, no capturados en vivo durante incidentes reales.
- Recall por palabra clave, no semántico: el siguiente paso planeado es migrar a las funciones retain y recall de Hindsight, donde los incidentes se guardan a medida que ocurren y se buscan por significado.
- Métricas placeholder en el dashboard: el “ping de 32ms” es un valor estático y la latencia de base de datos se simula con una pausa (sleep) de código, según aclara el propio desarrollador.
- El prompt no es garantía de seguridad: la temperatura del modelo está fija en 0.1 para reducir la improvisación, pero la instrucción “DEBES basarte en esta memoria” sigue siendo una instrucción de prompt, no un control de seguridad real.
¿Alguien validó los comandos generados antes de correrlos en un entorno real? Todavía no, y el propio proyecto lo dice: una implementación seria necesita validar las órdenes generadas antes de que cualquiera las ejecute.
Criterios para decidir si tu equipo necesita algo así
Antes de copiar este patrón, conviene filtrarlo con preguntas concretas en vez de adoptarlo porque suena bien:
- ¿Tenés post-mortems escritos, aunque sea en un doc suelto? Si la respuesta es no, el primer paso no es un agente de IA, es empezar a documentar qué salió mal y qué costó cada fix. Sin esa materia prima, cualquier capa de memoria queda vacía.
- ¿El volumen de incidentes repetidos justifica la automatización? Si tu equipo enfrenta la misma familia de alertas (Redis, timeouts, deadlocks) una o dos veces por año, un runbook compartido en texto plano puede alcanzar. El valor de un agente crece con la frecuencia de incidentes similares.
- ¿Alguien va a validar los comandos antes de ejecutarlos? El propio equipo de NerveCenter es explícito: el prompt no es un control de seguridad. Si no hay un paso de revisión humana (o al menos un entorno de staging para probar el comando sugerido), el riesgo de automatizar mal supera el beneficio.
- ¿Podés mostrar la fuente de cada respuesta? Si tu implementación no puede exhibir de dónde salió el comando recomendado, perdés la parte más valiosa del diseño: la verificabilidad en segundos que señala el propio proyecto.
¿Qué lecciones deja este experimento para equipos de DevOps?
La lección central es que el post-mortem vale más que el comando en sí. “Engineers forgive limitations. They don’t forgive surprises”, escribió Manya Agarwal, una de las desarrolladoras del proyecto, en el artículo donde documentó el experimento. Esa frase resume bastante bien el criterio de todo el diseño.
- El post-mortem es el campo más valioso del registro: es lo que evita que alguien repita el mismo error dos veces.
- Un toggle de memoria en la UI vende la idea mejor que cualquier explicación: ver el antes y después en vivo convence más que un párrafo de documentación.
- Mostrar el contexto recuperado genera confianza: si el agente dice “terminá el PID 4821”, el ingeniero de guardia tiene que poder ver de dónde salió esa orden en segundos.
- Diseñar primero la interfaz de memoria: mantener el recall detrás de un único método (recall(query)) permite cambiar el backend de almacenamiento sin tocar el resto del agente.
- Ser transparente sobre lo que es placeholder: los equipos perdonan limitaciones conocidas, no perdonan sorpresas en producción.
Para equipos que gestionan su propia infraestructura (sea en un VPS, en contenedores o en servidores dedicados, como los que ofrece donweb.com para proyectos en Argentina), la idea de fondo aplica igual aunque nunca uses NerveCenter: documentar el post-mortem de cada incidente en un formato que una IA pueda leer después es, hoy, más valor que cualquier dashboard de métricas bonito.
Errores comunes al armar memoria para un agente SRE
- Guardar solo la solución, no el costo de aplicarla: un comando sin su post-mortem es tan peligroso como no tener memoria, porque el agente lo va a recomendar con la misma confianza ciega de siempre.
- Confiar en el prompt como si fuera un control de acceso: decirle al modelo “DEBES basarte en esto” reduce alucinaciones, no las elimina. Sigue haciendo falta una validación humana o automática antes de ejecutar comandos destructivos.
- Escalar el recall por keyword sin revisar la cobertura: si el sistema solo matchea palabras exactas, una alerta fraseada distinto (“Redis se quedó sin memoria” en vez de “Redis OOM Error”) puede no encontrar nada, y ahí el agente vuelve a ser genérico sin que nadie se dé cuenta.
- No mostrar la fuente recuperada en la interfaz: ocultar el registro de incidente detrás de la respuesta final convierte al agente en una caja negra, justo en el momento donde más necesitás poder verificar rápido.
Preguntas Frecuentes
¿Qué es Hindsight y cómo le da memoria a un agente de IA?
Hindsight es la capa de memoria que NerveCenter usa para guardar y recuperar incidentes pasados, inyectándolos en el prompt del modelo antes de que este genere una respuesta. En la versión actual del proyecto funciona con tres registros cargados a mano y recall por palabra clave, con planes de migrar a recuperación semántica mediante las funciones retain y recall de Hindsight.
¿Cómo evita un agente de IA dar comandos peligrosos en producción?
Un agente IA con memoria para SRE evita comandos peligrosos adjuntando el post-mortem del incidente anterior junto con el comando recomendado, en vez de sugerirlo aislado. En NerveCenter, el system prompt obliga al modelo a citar las advertencias registradas, aunque el propio equipo aclara que esto sigue siendo una instrucción de prompt, no una garantía técnica de seguridad.
¿Qué es NerveCenter, el agente SRE con memoria de incidentes?
NerveCenter es un dashboard en Streamlit construido por un equipo de cuatro desarrolladores como prueba de concepto de automatización de DevOps asistida por IA. Recibe alertas de producción en texto libre y responde con comandos de terminal y análisis de causa raíz basados en incidentes documentados previamente.
¿Qué modelo de IA usa NerveCenter para responder alertas?
NerveCenter usa el modelo openai/gpt-oss-120b corriendo sobre la infraestructura de inferencia de Groq, elegida por su baja latencia. La temperatura del modelo está configurada en 0.1 para que la respuesta se apegue lo más posible al incidente recuperado, en vez de improvisar.
¿Por qué un comando como FLUSHALL puede ser riesgoso sin contexto previo?
FLUSHALL borra todos los datos de una instancia de Redis y puede generar picos de latencia severos si se ejecuta sin preparación, como pasó en el incidente INC-892 documentado por NerveCenter, donde causó un pico de 12 segundos. Sin el contexto del post-mortem previo, un asistente genérico puede sugerir ese comando con total confianza y sin advertir el riesgo real.
Conclusión
Lo que cambia con NerveCenter no es el modelo de lenguaje, es el contexto que recibe antes de responder. El mismo openai/gpt-oss-120b que te da un consejo de manual sin memoria, con el registro de un incidente real inyectado en el prompt, te cita el comando exacto y la advertencia que te hubiera ahorrado un dolor de cabeza la vez anterior.
Eso sí, conviene no perder de vista que esto es una prueba de concepto de cuatro personas, con memoria cargada a mano y recall por keyword todavía. Si estás evaluando algo así para tu equipo, el criterio práctico es simple: antes de confiar en cualquier agente que sugiera comandos de producción, pedile que te muestre la fuente del dato, igual que hace el expander de NerveCenter, y validá ese comando vos mismo antes de ejecutarlo. Ese paso de verificación manual sigue siendo indispensable, lo diga o no el propio sistema.