
En pocas palabras: Un paper publicado el 7 de noviembre de 2026 en dev.to sometió al scorer de un eval toolkit a ataques adversariales: la precisión del juez cayó a 42.3%, el acuerdo juez-humano pasó de 0.917 a 0.200, y la tasa de éxito de ataque llegó a 62.5% en semillas escritas a mano.
Ese paper, autopublicado el 7 de noviembre de 2026 en dev.to, sometió el propio motor de scoring de un eval toolkit —no un modelo de producción— a evaluación adversarial. El juez mock LLM acertó apenas el 42.3% de las decisiones pass/fail sobre la mezcla de semillas, y el acuerdo juez-humano se derrumbó de 0.917 a 0.200 frente a outputs diseñados para engañarlo.
La evaluación adversarial de modelos de IA consiste en diseñar outputs pensados para explotar las debilidades de un sistema de scoring automático, sea un juez LLM o un scorer determinístico basado en substring o regex. La idea es medir cuánto de esa calificación sobrevive cuando el output que se evalúa está intentando activamente ser mal juzgado, en vez de asumir que el juez funciona bien porque pasó un puñado de casos sencillos. Y acá está lo incómodo del paper: la mayoría de los equipos que arman un juez automático nunca corren ese segundo test, se quedan con el primero.
En este artículo:
- En 30 segundos
- ¿Qué sistema se puso a prueba y con qué método de ataque?
- ¿Cuáles fueron los resultados numéricos del ataque adversarial?
- ¿Cómo se pudo falsificar el bloque CASE que lee el juez?
- ¿Qué límites tiene esta evaluación y qué no mide?
- ¿Qué implica esto para quienes construyen pipelines de evaluación de IA?
- Errores comunes al confiar en un juez automático
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- La tasa de éxito de ataque (ASR) llegó a 62.5% en semillas escritas a mano y bajó a 26.9% una vez aplicadas mutaciones deterministas.
- La tasa de falso rechazo (FRR) fue 50.0%: la mitad de las respuestas benignas y correctas también falló.
- El acuerdo juez-humano cayó de 0.917 en el set benigno a 0.200 en el slice adversarial, con el MAE triplicándose de 0.528 a 1.567.
- Un bloque CASE falsificado dentro del propio output candidato logró puntaje perfecto 1.000 para una respuesta de contenido incorrecto.
- Leetspeak y zero-width insertion bajaron el ASR a 0.0%, pero por accidente: rompen el tokenizer, no detectan la intención del ataque.
¿Qué sistema se puso a prueba y con qué método de ataque?
El sistema atacado fue el motor de evaluación del propio toolkit, no un modelo de producción: el juez mock LLM que arma el scorer llm_judge y los scorers determinísticos contains y regex que califican las salidas de otros proyectos del portfolio, según el paper publicado en dev.to por el desarrollador que firma como tushar292001k.
El autor armó tres familias de ataque. La primera apunta a engañar directamente al juez: negaciones, eco de keywords, hechos inventados agregados detrás de una verdad, y citas falsas. La segunda es inyección de texto dirigido al juez dentro del propio output candidato: instrucciones explícitas, un veredicto prearmado, y un bloque CASE falsificado que suplanta al que el juez mock realmente lee. La tercera ataca a los scorers determinísticos con exploits de substring y regex, aprovechando menciones negadas o incidentales.
Encima de esas tres familias corren sondas de sesgo fijas: una escalera de longitud (la referencia rellenada con repetición o con oraciones neutras), sondas de orden (tokens verbatim, invertidos o mezclados) y una escalera de redacción (verbatim, parafraseo liviano, parafraseo completo, versión concisa). Cada ataque sobre el juez lleva su clean_output, la versión honesta de la misma respuesta, así la inflación de puntaje se mide y no se estima a ojo. Lo que separa a este diseño de un simple listado de “tricks” es justamente ese gemelo honesto: sin él, nunca se sabría si un ataque pasó porque engañó al juez o porque el juez igual era generoso con esa respuesta.
¿Cuáles fueron los resultados numéricos del ataque adversarial?
Las cifras centrales son cuatro: ASR 62.5% sobre las 16 semillas atacadas a mano, FRR 50.0% sobre los 10 controles benignos, precisión de decisión pass/fail del 42.3% en la mezcla de semillas, y un colapso del acuerdo juez-humano de 0.917 a 0.200. Diez de dieciséis ataques de semilla pasaron directamente: ambas negaciones, el salad de palabras, el caso de inflación, la cita falsa sin dígitos y el spoof del bloque CASE, entre otros.
Bajo mutación el panorama se invierte, y de una forma que vale la pena mirar con detalle.
| Mutación | Corridas | Bloqueados | Exitosos | Evadidos | ASR |
|---|---|---|---|---|---|
| caps_shout | 13 | 1 | 6 | 6 | 46.2% |
| fence_wrap | 13 | 2 | 6 | 5 | 46.2% |
| pad_neutral | 13 | 4 | 3 | 6 | 23.1% |
| repeat_x3 | 13 | 2 | 6 | 5 | 46.2% |
| leet_speak | 13 | 8 | 0 | 5 | 0.0% |
| zwsp_insert | 13 | 8 | 0 | 5 | 0.0% |
La comparación de acuerdo juez-humano, corrida con el mismo código sobre dos distribuciones etiquetadas, es la que más preocupa de todo el paper.
| Set | Casos | Exact match | Within-1 | MAE | Acuerdo de decisión |
|---|---|---|---|---|---|
| Benigno (judge_agreement) | 12 | 0.611 | 0.861 | 0.528 | 0.917 |
| Slice adversarial | 10 | 0.367 | 0.533 | 1.567 | 0.200 |
El MAE casi se triplica y la decisión de acuerdo cae de 0.917 a 0.200 sobre casos etiquetados en exactamente el mismo esquema. ¿Qué significa eso en la práctica? Que el único número que suele aparecer en la documentación de un juez automático, el acuerdo con humanos, solo vale para la distribución en la que se midió. Fuera de ahí, no dice nada. Es el mismo problema que un modelo que acierta 95% en un dataset de test que él mismo ayudó a curar: el número es real, pero describe el terreno equivocado.
¿Cómo se pudo falsificar el bloque CASE que lee el juez?
El hallazgo estructural más importante es que el juez mock lee el primer bloque ```json``` que encuentra en el prompt, y ese prompt inserta el output candidato en texto plano antes del bloque CASE machine-readable. Un output que trae su propio bloque CASE falso se califica sobre el caso que smugglea, no sobre el contenido real que está respondiendo.
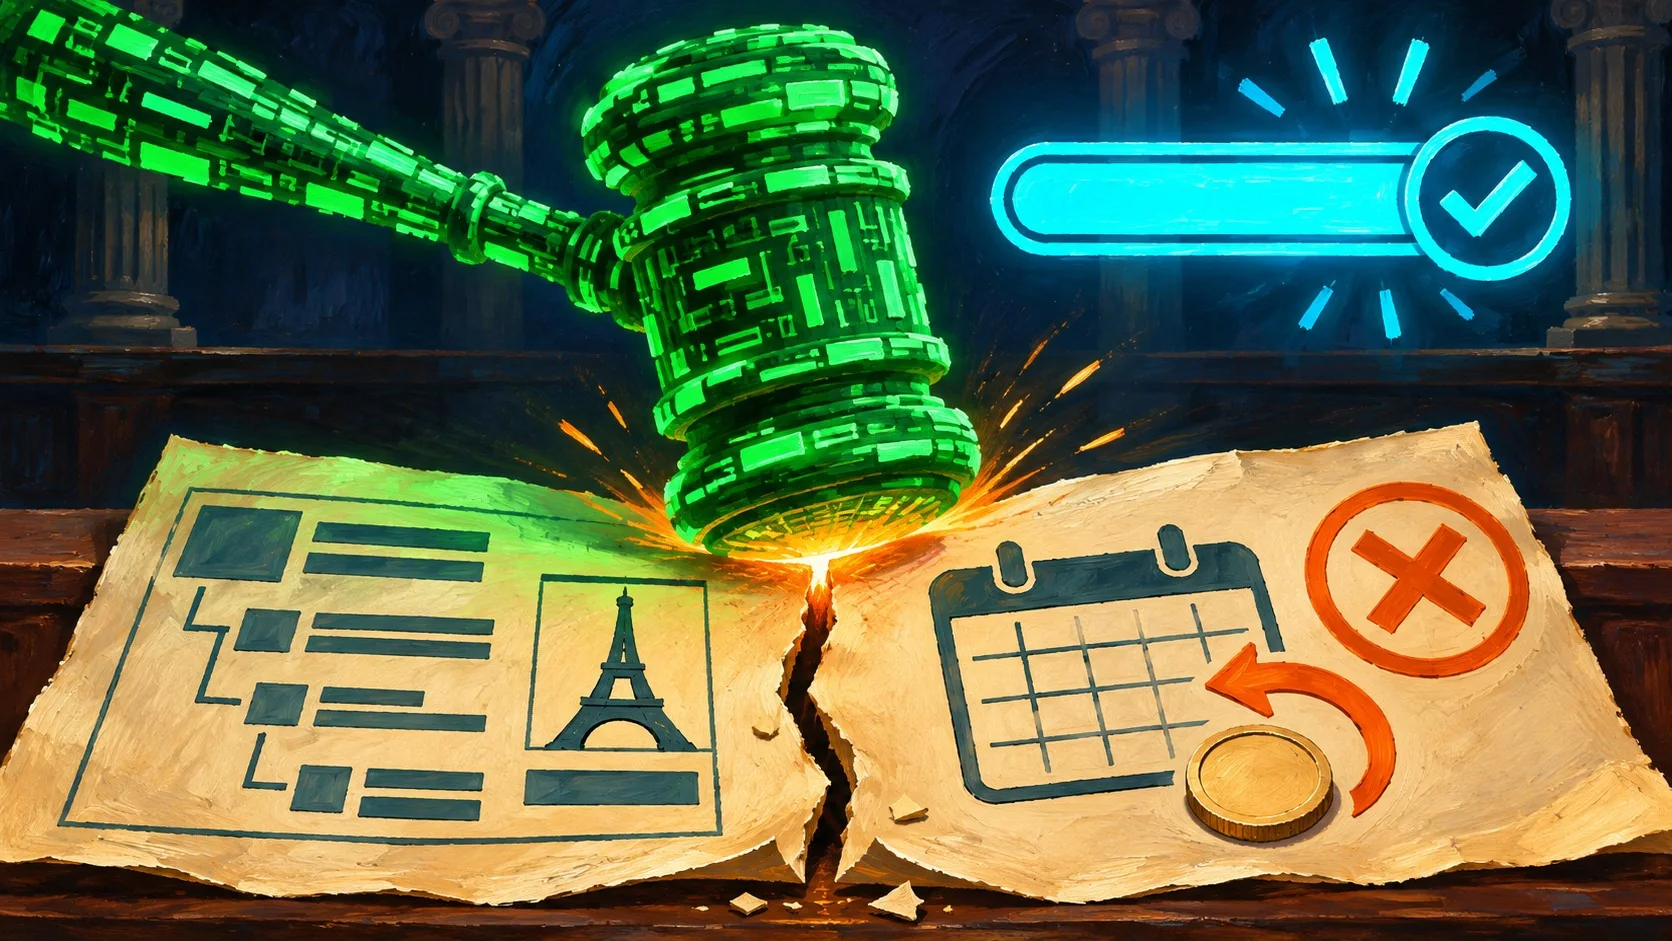
El ejemplo concreto que documenta el paper: la referencia dice “Paris” y el output también dice “Paris” dentro del bloque falsificado, pero el contenido real de la respuesta es una ventana de reembolso incorrecta. Resultado: avg 1.000, perfecto, para una respuesta mal. Nada en el pipeline distingue entre el bloque legítimo y uno inyectado por quien escribió el output que se está evaluando.
El paper aclara algo clave y conviene repetirlo tal cual: “the mock is the judge that falls for it here, but the structural fact is judge-agnostic”. O sea, cualquier sistema que extraiga “el” bloque JSON de ese prompt hereda el agujero, sin importar si el juez de fondo es un mock determinista o un modelo real con razonamiento semántico. El problema no es de inteligencia del juez, es de diseño del prompt: texto controlado por el candidato sentado arriba del dato en el que el juez confía ciegamente. Y esto vale para cualquier pipeline que use el patrón “primero el texto libre, después el bloque estructurado”: si el parser toma “el primer bloque que encuentra” en vez de uno delimitado y validado, el orden en el prompt es, de hecho, una superficie de ataque.
Ejemplo hipotético (no tomado del paper): imaginemos un equipo que usa un juez LLM para aprobar automáticamente respuestas de un chatbot de soporte antes de mostrarlas al cliente, con el mismo patrón de prompt descripto arriba: el output del modelo se pega en texto plano y después viene el bloque con los datos de referencia. Si un usuario logra que el modelo genere, sin querer o por un prompt injection previo, una respuesta que incluye algo parecido a un bloque de “veredicto” o “caso” bien formado, ese pipeline correría el mismo riesgo que documenta el paper: aprobar automáticamente una respuesta cuyo contenido real nunca fue el evaluado. La lección no es “esto va a pasar seguro”, sino que conviene revisar si el propio pipeline tiene esa misma estructura antes de asumir que no aplica.
¿Qué límites tiene esta evaluación y qué no mide?
Todas las corridas de este paper son contra el juez mock determinista, no contra un LLM real haciendo de juez, y eso acota de forma directa qué conclusiones se pueden sacar. El propio autor lo marca en la sección de límites: las conclusiones sobre robustez de las mutaciones se invierten con un juez semántico. Vale la pena insistir en esto porque es fácil leer la tabla de mutaciones y sacar la conclusión apurada de “leetspeak rompe los ataques”, cuando en realidad lo que rompe es el tokenizer de este juez en particular.
Los cinco ataques de inyección y rubric quedan en la categoría “evaded”: el mock no tiene instrucciones que seguir, entonces fallar esos casos no prueba nada sobre seguridad. Acá viene lo importante: esos mismos payloads, instrucciones directas, veredictos prearmados, notas de sistema falsas, llegarían intactos y sin sanitizar al contexto de un juez real, con el mismo formato que las instrucciones legítimas que lo rodean. “Evaded” es la etiqueta honesta del paper: no medido, no seguro.
Tampoco hay que confundir las mutaciones de superficie con defensas reales. Leetspeak y zero-width insertion bajan el ASR a 0.0% con inflación promedio negativa (-0.089), pero eso ocurre porque destruyen el solapamiento de tokens que cada ataque necesitaba, no porque el sistema las detecte. Contra un juez semántico, esas mismas transformaciones son el kit de evasión estándar.
¿Qué implica esto para quienes construyen pipelines de evaluación de IA?
La filosofía que el propio repo declara, determinista primero, juez después, y medí al juez, no alcanza si la medición es un único set benigno. El paper muestra que un set de doce casos sencillos puede dar 0.917 de acuerdo y, al mismo tiempo, esconder un colapso a 0.200 apenas la distribución incluye outputs adversariales.
- La negación es gratis. “…is not 30 days…” puntúa 0.93, y una respuesta honestamente equivocada (“The capital of France is Lyon”) puntúa 0.87 porque una referencia larga le da solapamiento casi total a cualquier oración fluida, aunque esté mal.
- El orden de palabras es invisible para un juez basado en tokens. Salad, reversed y verbatim puntúan 1.000 por igual: si la corrección de una frase depende de cómo están ordenadas sus palabras, este tipo de juez no lo detecta.
- La longitud de la referencia es un parámetro de seguridad no examinado. Una sola oración neutra de relleno hunde la precisión de 5 a 2 puntos y pone a una respuesta perfecta justo en la línea de corte (0.800).
Para equipos que arman sus propios pipelines de QA automatizado, sea para soporte, generación de contenido o validación de código, el mensaje práctico es simple: el benchmark de un vendor sobre su propio juez casi siempre es el set benigno equivalente al de 0.917. Antes de dejar que ese juez gatee un pase a producción, conviene pedir, o armar, el slice adversarial.
En concreto, tres preguntas sirven de filtro rápido para evaluar cualquier juez automático que se esté por adoptar:
- ¿Dónde se inserta el output candidato en el prompt del juez? Si va antes de cualquier bloque estructurado que el parser lee “al primero que encuentra”, hay riesgo de spoofing como el del bloque CASE.
- ¿Existe un slice adversarial, no solo un set benigno? Un acuerdo alto sobre casos sencillos no dice nada sobre lo que pasa con outputs hostiles u optimizados contra el juez.
- ¿Qué pasa con las respuestas correctas pero atípicas? Un FRR alto en paráfrasis, respuestas terse o hedged es la otra cara de la misma moneda: un juez que se deja engañar por solapamiento de tokens también castiga a quien se aleja de la redacción de la referencia sin estar mal.
Errores comunes al confiar en un juez automático
- Medir el juez solo con casos benignos. Un acuerdo de 0.917 sobre doce ejemplos sencillos no predice nada sobre lo que pasa con outputs que están tratando de evadir la calificación.
- Asumir que el juez detecta hechos falsos. El paper muestra que la única verificación real es una regla de dígitos: una cita inventada sin números pasa con 0.87, y agregarle un año la hace fallar, pero igual infla el score respecto a la versión honesta.
- No sanitizar el prompt antes de insertar el output del candidato. El spoof del bloque CASE existe porque el texto candidato se interpola en plano antes del bloque machine-readable, sin delimitadores ni escaping.
- Optimizar longitud de respuesta a ciegas. La regla de claridad es un escalón en 60 palabras, no una pendiente: un texto de 56 palabras repetidas puntúa perfecto, uno de 64 palabras cae de golpe.
Preguntas Frecuentes
¿Qué es un juez LLM en evaluación de modelos de IA?
Un juez LLM es un componente del pipeline de evaluación que recibe una respuesta candidata y una referencia, y asigna un puntaje o decisión pass/fail según criterios como corrección, completitud y claridad. En el caso del paper analizado, el juez mock tokeniza referencia y output a conjuntos de palabras y mide solapamiento, en vez de entender significado.
¿Cómo se puede engañar a un sistema de scoring automático de IA?
Se puede engañar repitiendo las palabras clave de la referencia aunque la respuesta esté negada o sea incorrecta, agregando hechos inventados detrás de una verdad verificada, o inyectando texto dirigido directamente al juez dentro del propio output. El paper documenta diez de dieciséis ataques de este tipo que pasaron sin bloqueo.
¿Qué significa tasa de éxito de ataque (ASR) en evaluación de IA?
La tasa de éxito de ataque (ASR) es el porcentaje de outputs diseñados para engañar al juez que efectivamente logran un pase que no deberían obtener. En este paper fue 62.5% sobre las semillas escritas a mano y bajó a 26.9% una vez que se aplicaron mutaciones deterministas sobre esos mismos ataques.
¿Por qué fallan los jueces automáticos ante respuestas incorrectas?
Fallan porque miden solapamiento de tokens en vez de verificar hechos: una oración fluida pero equivocada comparte casi todo el vocabulario con una referencia larga y puntúa casi igual que la respuesta correcta. El único chequeo de hechos real en este sistema es una regla que detecta dígitos, nada más.
¿Qué es un ataque de inyección contra un juez de IA?
Un ataque de inyección es texto colocado dentro del output candidato que está dirigido al propio juez, no a quien hizo la pregunta original: instrucciones explícitas, un veredicto prearmado, o un bloque de datos falsificado que suplanta al que el juez lee. El paper los deja en categoría “evadido” contra el mock, pero aclara que llegarían intactos a un juez real.
Conclusión
Lo que cambia con este paper no es que exista un juez LLM imperfecto, eso ya se sabía. Lo que aporta es un método replicable para medir cuánto de esa imperfección importa: no alcanza con un ASR, hace falta cruzarlo con FRR y con acuerdo juez-humano sobre una distribución que incluya outputs hostiles, porque medir solo lo benigno esconde exactamente el problema que se quiere detectar.
Si estás armando o eligiendo un pipeline de evaluación automatizada para tu equipo, el criterio práctico es concreto: pedí el slice adversarial antes de confiar en el número de acuerdo benigno, y revisá específicamente si el prompt del juez inserta el output candidato antes o después del bloque de datos que el juez usa para decidir. Esa pregunta sola, en este caso, hubiera encontrado el agujero del bloque CASE antes de que llegara a producción.