
En pocas palabras: SGLang 0.5.23 (2 de noviembre de 2026) incorpora Paged Experts, que mantiene K expertos por capa en la GPU y pagina el resto desde RAM fijada del host. En Qwen3-30B-A3B alcanzó hasta 205.6 tok/s en decode y, según la configuración, entre 12x y 30x más rápido que –cpu-offload-gb, pero con 4 solicitudes concurrentes el rendimiento cae si K // top_k queda por debajo de 4.
SGLang 0.5.23, publicada el 2 de noviembre de 2026, suma una función opt-in llamada Paged Experts que permite correr modelos MoE (Mixture of Experts) cuyos pesos no entran en la VRAM de la GPU. En Qwen3-30B-A3B llegó a 205.6 tok/s en decode de una sola solicitud, 12.4 veces más rápido que --cpu-offload-gb y prácticamente empatado con llama.cpp tuneado (1.06x), mientras que en el caso FP8 (87.7 tok/s) la mejora llegó hasta 30 veces más rápido que –cpu-offload-gb y 1.94 veces más rápido que llama.cpp, según un análisis que calculó esos ratios sobre las tablas de medición del PR #42557 que la implementó.
En este artículo:
- En 30 segundos
- ¿Qué es la paginación de expertos de SGLang y en qué se diferencia del offload clásico?
- ¿Qué resultados dio el benchmark de Paged Experts en Qwen3-30B-A3B?
- ¿Por qué es rápido si los expertos cruzan el PCIe en cada paso?
- ¿Qué pasa con varias solicitudes simultáneas? El límite de las 4 solicitudes
- ¿Cuánto contexto (KV cache) cuesta mantener cada experto residente en GPU?
- ¿Paginar expertos afecta la calidad de las respuestas del modelo?
- ¿Cómo evaluar si conviene activar Paged Experts en tu propio servidor?
- Qué está confirmado y qué no
- Errores comunes al configurar Paged Experts
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- SGLang 0.5.23 (2 de noviembre de 2026) agrega Paged Experts: mantiene K de los E expertos de cada capa MoE en GPU y pagina el resto desde RAM fijada del host.
- En Qwen3-30B-A3B midió 205.6, 87.7 y 32.6 tok/s en tres configuraciones, contra 16.6, 2.9 y 1.2 tok/s con
--cpu-offload-gb(entre 12x y 30x más rápido). - Contra llama.cpp tuneado el resultado empata cuando el modelo casi entra en VRAM, y es hasta 1.94x más rápido cuando hay que paginar mucho y el link PCIe es rápido.
- Con 4 solicitudes concurrentes, el rendimiento se desploma si K // top_k queda por debajo de 4: la laptop cayó a 11 tok/s contra 41 de llama.cpp.
- Paginar mal un experto puede arruinar la calidad en silencio: gpt-oss-20b con MXFP4 llegó a puntuar 0.000 en GSM8K antes de un fix documentado en el PR #45787.
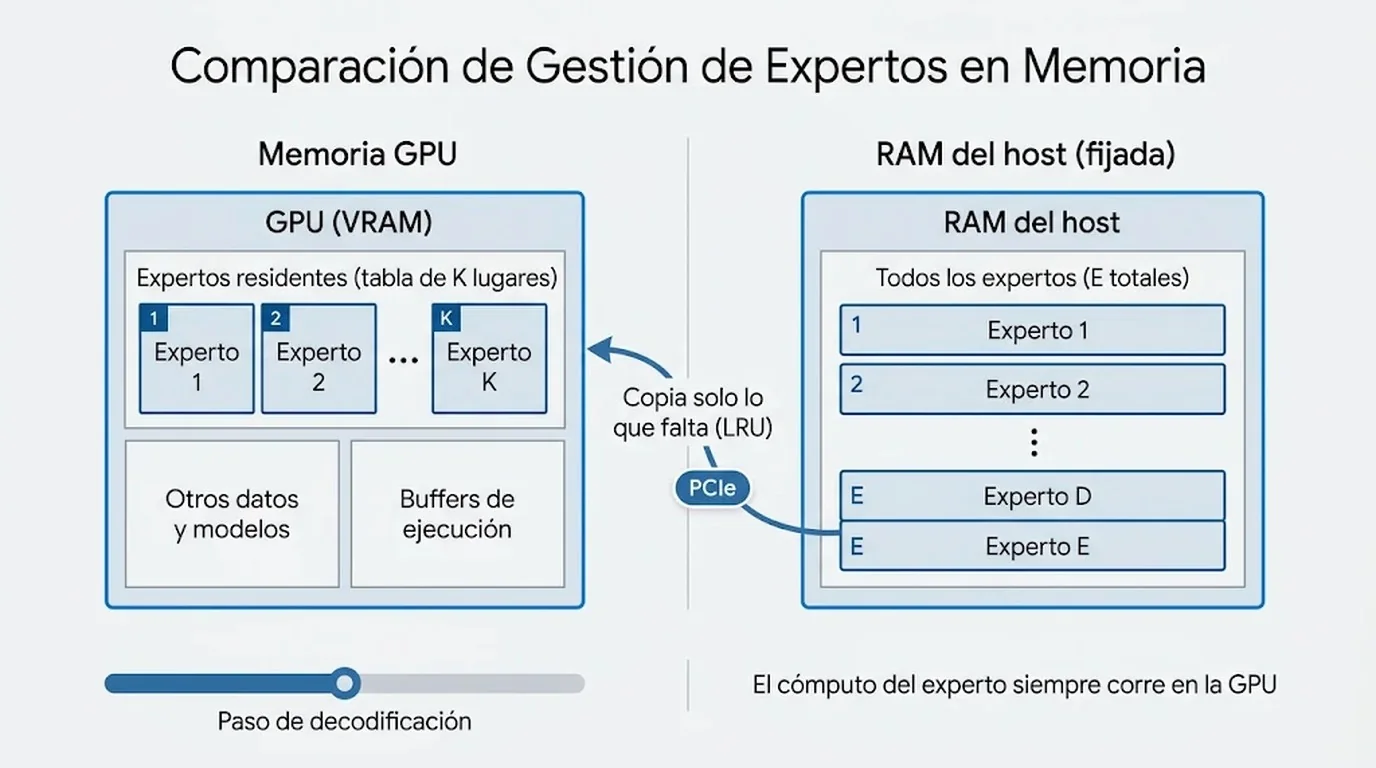
Dicho simple: la paginación de expertos de SGLang guarda K de los E expertos routeados de cada capa MoE en memoria de la GPU, y el resto en RAM del host fijada (pinned), copiando solo los expertos faltantes antes de cada paso de cómputo. A diferencia del offload clásico, el cálculo nunca se muda a la CPU: siempre corre en la GPU, con el kernel fused-MoE propio del modelo. La diferencia parece técnica, pero es la que decide si tu GPU chica puede o no servir un modelo que, en papel, le queda grande.
¿Qué es la paginación de expertos de SGLang y en qué se diferencia del offload clásico?
Paged Experts mantiene una tabla de K slots por capa en la GPU, mientras los E expertos completos quedan en RAM del host page-locked (pinned), y cada paso copia desde esa tabla solo lo que falta, con una política LRU para decidir qué se descarta. Es distinto de --cpu-offload-gb, que transmite los pesos a la GPU en cada forward pass sin importar qué eligió el router, y también distinto de --n-cpu-moe de llama.cpp, que directamente calcula esas capas en la CPU.
Un modelo MoE enruta cada token a top_k de E expertos. En Qwen3-30B-A3B eso son 8 de 128 expertos por capa, repetido en 48 capas, según el config.json del modelo verificado por la fuente original. Los expertos son la mayor parte de los 30B parámetros, así que un modelo barato de calcular puede terminar siendo imposible de alojar en una GPU chica, ponele una de 8 GB como la de una laptop gamer promedio.
La idea de fondo viene de HiCache aplicada a pesos de expertos: la GPU guarda el working set, la RAM del host guarda el resto. El PR #42557, mergeado el 19 de octubre de 2026, sumó soporte para bf16, FP8 por bloques y GPTQ. El PR #45787, mergeado el 25 de octubre, agregó AWQ, compressed-tensors, MXFP4, NVFP4, W8A8 e INT8 por bloques. Activarlo son dos flags: --enable-paged-experts y --paged-experts-num-resident K.
Eso sí: hay restricciones duras. Según la documentación oficial de SGLang, la función solo funciona en una sola GPU (paralelismo tensor, de expertos, de pipeline y de datos quedan rechazados al arrancar), rechaza decoding especulativo, y necesita que la RAM del host pueda fijar en memoria todos los expertos de todas las capas. Bajo WSL2 la memoria pinned queda limitada a la mitad de la RAM del sistema, así que en laptops con Windows hay que hacer la cuenta antes de ilusionarse.
¿Qué resultados dio el benchmark de Paged Experts en Qwen3-30B-A3B?
El PR midió las velocidades en tok/s de cada configuración; comparándolas entre sí, la mejora resultante fue de entre 12x y 30x contra --cpu-offload-gb, y de empate a 1.94x contra llama.cpp tuneado a su mejor configuración de --n-cpu-moe. Las pruebas corrieron en dos máquinas: una laptop RTX 4070 (8 GB, PCIe 4.0 x8, 54 GB RAM, WSL2) y una desktop RTX 5070 Ti (16 GB, PCIe 5.0 x16, 62 GB RAM, Linux nativo).
| Configuración | Paged Experts | llama.cpp (mejor) | cpu-offload-gb | vs offload | vs llama.cpp |
|---|---|---|---|---|---|
| 16 GB, int4, K=92 | 205.6 tok/s | 194.4 tok/s | 16.6 tok/s | 12.4x | 1.06x |
| 16 GB, FP8, K=40 | 87.7 tok/s | 45.2 tok/s | 2.9 tok/s | 30.2x | 1.94x |
| 8 GB laptop, int4, K=26 | 32.6 tok/s | 32.8 tok/s | 1.2 tok/s | 27.2x | 0.99x |
El patrón que queda claro: contra la base más débil (--cpu-offload-gb) la mejora es enorme, pero contra llama.cpp tuneado el resultado se divide en dos. Cuando el modelo casi entra en la VRAM o el link PCIe es lento, paginar y calcular en CPU terminan en el mismo lugar. Cuando hace falta tener muchos expertos en RAM y el link es rápido, el cómputo en GPU gana por una ventaja clara porque las capas CPU-side de llama.cpp se convierten en el cuello de botella. Ojo: estos números vienen de dos máquinas de un solo autor del PR, no de un benchmark independiente, así que conviene leerlos como una señal fuerte y no como un veredicto final.
¿Por qué es rápido si los expertos cruzan el PCIe en cada paso?
Es rápido porque el router reusa expertos entre tokens consecutivos, no porque cada paso traiga todo de cero. Pensalo como una heladera chica: si cada visita necesitara un ingrediente distinto, habría que vaciarla y llenarla entera todo el tiempo, y ningún link PCIe aguanta ese ritmo. Pero si casi siempre se usan los mismos ingredientes, alcanza con reponer lo que falta de a poco, y eso explica la velocidad medida.
Un token en batch 1 activa 48 x 8 = 384 expertos en Qwen3-30B-A3B. Un experto int4 pesa 2.43 MB y uno FP8 unos 4.72 MB, así que si todas las activaciones fallaran, un solo token necesitaría 0.93 GB (int4) o 1.81 GB (FP8) cruzando el link PCIe.
Hagamos la cuenta con los números medidos. El caso FP8 corre a 87.7 tok/s, o sea 11.4 ms por token. Copiar 1.81 GB en 11.4 ms exige 159 GB/s, más de lo que entrega un link PCIe 5.0 x16 (unos 63 GB/s teóricos). ¿Entonces qué pasó? La mayoría de las activaciones no pueden haber fallado. Con un ancho de banda efectivo estimado en ~50 GB/s (a partir de que una prefill pagina unos 4 GB en 80 ms), el miss rate máximo que permite cada velocidad medida queda muy por debajo del que esperaría un ruteo aleatorio uniforme: 31% contra 69% en el caso FP8, y 52% contra 80% en la laptop. Esto implica reuso de expertos, el supuesto que da por sentado la documentación oficial. El caso int4 de 16 GB queda inconcluso: a 63 GB/s en vez de 50, el límite sube al 33%, por encima de la base aleatoria.
¿Qué pasa con varias solicitudes simultáneas? El límite de las 4 solicitudes
Con 4 solicitudes concurrentes el rendimiento puede caer por debajo de llama.cpp, y la variable que decide todo es K // top_k, el tamaño máximo de lote que entra en una sola “wave” capturable con CUDA graph. En la laptop, 4 solicitudes dieron 11-12 tok/s contra 41 de llama.cpp. En la desktop con FP8 y K=40 dio 84 tok/s (contra 55 de llama.cpp), pero con K=24 cayó a 31 (contra los mismos 55).
La regla que se desprende: cuando K // top_k queda por debajo de la cantidad de solicitudes simultáneas que querés servir, cada paso necesita varias “waves” con su propio page-in, y ahí se pierde. Cuatro solicitudes con top-8 pueden tocar hasta 32 expertos distintos por capa. Si K // 8 es menor a 4, perdés contra llama.cpp; si es 5 o más, ganás. Cuatro puntos de datos no hacen una ley, pero sí alcanzan para una regla práctica de sizing: elegí K al menos igual a batch x top_k para el batch que pensás servir, o aceptá que te quedás afuera del camino rápido capturado por CUDA graph.
Ejemplo hipotético: ¿conviene activarlo para un chat interno con 3 usuarios a la vez?
Aclaración: esto es un ejemplo hipotético para ilustrar el criterio de decisión, no un caso real medido por nadie. Imaginemos un equipo que quiere servir Qwen3-30B-A3B en GPTQ int4 en una GPU de 16 GB, para un chat interno que casi siempre tiene 3 personas escribiendo en simultáneo.
Con top_k=8, esas 3 solicitudes pueden llegar a tocar hasta 3 x 8 = 24 expertos distintos por capa en un mismo paso. Siguiendo la regla de K // top_k que se desprende de los datos del PR, este equipo necesita K ≥ 24 para que las 3 solicitudes entren en una sola wave capturada por CUDA graph. Si al arrancar el servidor el log muestra algo como K=92 (la configuración de 16 GB que usó el PR), sobra margen de lejos: 92 // 8 = 11, bien por encima de 3. Pero si alguien bajó K a 24 a mano para ganar más contexto —como en una de las filas de la tabla de 4 solicitudes—, el sistema queda justo en el límite, y apenas un cuarto usuario se suma en la hora pico, ya cae del lado perdedor.
La conclusión práctica para este caso: antes de tocar K a mano para ganar contexto, conviene calcular primero cuántas solicitudes simultáneas espera atender el servidor en el pico real de uso, multiplicarlas por top_k, y recién después ver cuánto contexto queda disponible. Hacerlo al revés —fijar el contexto que gustaría tener y ver qué K sobra— es, ni más ni menos, la receta del escenario de la laptop que se desplomó a 11 tok/s.
¿Cuánto contexto (KV cache) cuesta mantener cada experto residente en GPU?
Cada slot resident le quita memoria al KV cache, porque K y la caché comparten el mismo presupuesto de memoria estática (--mem-fraction-static). En Qwen3-30B-A3B un token de KV cache en bf16 pesa 98.304 bytes (96 KiB): un slot int4 de 117 MB equivale a unos 1.190 tokens de contexto bf16 (casi 2.370 con KV en FP8), y un slot FP8 de 227 MB equivale a unos 2.300 tokens.
Bajar K en 10 en el modelo int4 libera unos 11.900 tokens de contexto, al precio de paginar más seguido. El caché completo de 10.240 tokens que usó el PR pesa apenas 1.0 GB, así que los expertos son los que dominan el presupuesto de memoria, no el KV cache. Si la caché no entra al arrancar, la documentación sugiere bajar K o usar --kv-cache-dtype fp8.
¿Paginar expertos afecta la calidad de las respuestas del modelo?
Por diseño, no: el ruteo queda intacto y la capa paginada devuelve el mismo resultado que la capa sin paginar. La documentación de SGLang reporta logprobs bit-idénticos para expertos sin cuantizar, FP8 e INT8 bajo inferencia determinística, y dentro del ruido propio del kernel Marlin para los demás formatos. En GSM8K (200 preguntas), gpt-oss-20b con MXFP4 puntuó entre 0.96 y 0.97 paginado contra 0.975 sin paginar.
Lo más interesante es cómo puede fallar sin avisar, documentado en el PR #45787. Si un tensor del experto no está marcado como “pageable”, se queda sin paginar y un experto recién copiado termina corriendo con los valores de otro experto distinto. En un control AWQ con los zero points sin paginar, el error medio de logprob fue 1.67 nats, contra 0.003 cuando se paginaba bien. Y los expertos MXFP4 de gpt-oss-20b, que el kernel Marlin rellena (de 2880 a 2944 o 3072), antes del fix hicieron que gpt-oss-20b paginado puntuara 0.000 en GSM8K, con cada respuesta truncada. Después del fix, 0.960. Ninguno de estos dos errores tira el servidor abajo: produce texto fluido pero equivocado, así que conviene correr un test de precisión contra el modelo sin paginar antes de confiar en producción.
¿Cómo evaluar si conviene activar Paged Experts en tu propio servidor?
Conviene calcular tres números antes de activarlo: el costo de memoria por slot, el batch cap (K // top_k) y si tu velocidad medida implica reuso de expertos o no. El escenario típico donde esto se rompe es el de siempre: subís el modelo, lo probás con una sola solicitud, funciona bárbaro, lo mandás a producción con varios usuarios concurrentes y de repente el throughput se derrumba porque nadie calculó que K // top_k quedaba en 3 cuando el tráfico real pedía servir 4 o 5 solicitudes a la vez (el ejemplo hipotético de arriba muestra justamente ese cálculo).
La fórmula práctica, tomada de la lógica del PR original: calculá cuánto GB por token necesitarías si todas las activaciones fallaran (capas x top_k x MB por experto), compará contra el ancho de banda de tu link PCIe y la velocidad que medís, y obtené el miss rate máximo que esa velocidad permite. Si ese número queda bien por debajo del miss rate que daría un ruteo aleatorio uniforme (1 – K/E), hay reuso real de expertos y la paginación tiene sentido para tu carga. Si no, probablemente estés en un escenario donde conviene más --n-cpu-moe de llama.cpp. Como criterio rápido: si tu concurrencia esperada x top_k supera a K, resolvé eso primero; recién después mirá el resto de la cuenta.
Qué está confirmado y qué no
- Confirmado: SGLang 0.5.23 incluye Paged Experts de forma opt-in desde el 2 de noviembre de 2026.
- Confirmado: las velocidades en tok/s de cada configuración, medidas al menos dos veces por celda, vienen directo de las tablas del PR; los ratios de 12x a 30x contra
--cpu-offload-gby el empate o 1.94x contra llama.cpp son cálculos hechos a partir de esas tablas, no cifras que el PR exprese como tales. - Confirmado: la caída de rendimiento con 4 solicitudes concurrentes cuando K // top_k baja de 4 está documentada con números concretos en el propio PR.
- No confirmado (todavía): el miss rate real de expertos. Los cálculos que citamos son cotas superiores a partir de la velocidad medida, no mediciones directas con un contador dentro del motor.
- No confirmado: cómo se comporta con tráfico sintético o con patrones de uso distintos al ShareGPT usado en el PR. La propia fuente advierte que los prompts sintéticos miden mal la paginación.
Errores comunes al configurar Paged Experts
- Dejar K en “auto” sin revisar el log de arranque. El sizing automático prioriza un request completo del contexto del modelo, y eso puede dejarte con menos K del que necesitás para servir varios usuarios a la vez. Conviene fijar K manual según tu batch esperado.
- Medir con prompts sintéticos y sacar conclusiones de producción. La propia fuente advierte que esos prompts no capturan bien el patrón de reuso de expertos. Si tu tráfico real es distinto al ShareGPT, el resultado puede no replicarse.
- Ignorar el límite de memoria pinned en WSL2. Bajo WSL2 la memoria page-locked queda topeada en la mitad de la RAM del sistema, así que un modelo con muchos expertos puede no entrar aunque la RAM “nominal” alcance.
- Confundir velocidad en single-stream con capacidad multiusuario. Un setup que vuela con una sola solicitud puede desplomarse con 4 o 5 concurrentes si K // top_k no acompaña ese batch, tal como se ve en el ejemplo hipotético de los 3 usuarios.
Preguntas Frecuentes
¿Qué es Paged Experts en SGLang?
Paged Experts es una función opt-in de SGLang 0.5.23 que mantiene K de los E expertos de cada capa MoE en memoria de la GPU y el resto en RAM del host fijada, copiando solo los expertos que falten en cada paso de inferencia. El cómputo siempre corre en la GPU, usando el kernel fused-MoE del propio modelo.
¿Cómo correr un modelo MoE que no entra en la VRAM?
Hay tres caminos: --cpu-offload-gb de SGLang (transmite pesos en cada paso), --n-cpu-moe de llama.cpp (calcula esas capas en CPU) o Paged Experts, que guarda el working set en GPU y pagina el resto desde RAM del host sin mover el cómputo a la CPU. Según un análisis de las tablas de medición del PR original, Paged Experts rindió entre 12x y 30x más que --cpu-offload-gb en Qwen3-30B-A3B.
¿SGLang es más rápido que llama.cpp con modelos MoE grandes?
Depende del caso. Contra llama.cpp tuneado a su mejor --n-cpu-moe, Paged Experts empató cuando la mayoría del modelo entra en VRAM o el link PCIe es lento (206 vs 194 y 33 vs 33 tok/s), y fue casi el doble de rápido cuando hay que paginar mucho y el link es rápido (87.7 vs 45.2 tok/s en el caso FP8).
¿Cuántos usuarios concurrentes soporta SGLang con Paged Experts?
Depende del valor de K que configures: el límite práctico es K // top_k solicitudes antes de perder el camino rápido capturado con CUDA graph. En las pruebas del PR, configuraciones con K // top_k de 5 o más ganaron a llama.cpp con 4 solicitudes concurrentes, mientras que valores de 3 perdieron (por ejemplo, 11 contra 41 tok/s en la laptop).
¿Paginar expertos afecta la calidad de las respuestas del modelo?
No, cuando está implementado correctamente: el ruteo no cambia y los logprobs quedan bit-idénticos o dentro del ruido normal del kernel usado. Eso sí, el PR #45787 documentó dos bugs donde una mala implementación sí degradó la calidad, incluyendo un caso de gpt-oss-20b que llegó a puntuar 0.000 en GSM8K antes de corregirse.
Conclusión
Paged Experts le da a SGLang una tercera opción entre transmitir pesos en cada paso y calcular en CPU: guardar el working set de expertos en GPU y pagar el costo de red solo cuando el router realmente cambia de expertos. Para una sola solicitud, los números del PR son contundentes: entre 12x y 30x contra --cpu-offload-gb, y hasta casi el doble contra llama.cpp en el mejor caso. Para tráfico con varios usuarios a la vez, la historia cambia por completo, y ahí es donde conviene hacer la tarea antes de prometerle algo a un cliente o a un equipo: nadie quiere enterarse en producción de que K // top_k se le quedó corto.
Si pensás activarlo en un servidor propio, el paso obligatorio es calcular K // top_k para el batch real que vas a servir, no para la demo de un solo usuario que probaste en tu máquina (el ejemplo hipotético de los 3 usuarios de más arriba sirve como plantilla de esa cuenta). Y antes de confiar en la calidad de las respuestas, correr un test de precisión contra la versión sin paginar en tu propio checkpoint, porque los bugs documentados en el PR #45787 no rompen el servidor: generan texto fluido pero equivocado, que es el peor tipo de error para detectar tarde.