En pocas palabras: Lullwood funciona con once agentes de Claude Code orquestados por un sistema llamado Paperclip, sin humano revisando commits a diario. El founder cambió la política de revisión: solo el código crítico (simulación, persistencia, secretos, releases) requiere aprobación bloqueante antes de mergear.
Once agentes de Claude Code construyen Lullwood, un juego de horror gratuito en el navegador, sin un humano revisando los commits día a día. Un sistema llamado Paperclip los orquesta, y la decisión que más cambió el ritmo del estudio fue dejar de revisar cada pull request de la misma manera.
Lullwood es un juego de terror en primera persona hecho con three.js y Next.js, que un founder humano y una flota de agentes Claude Code sacan adelante gestionando el equipo completo de desarrollo, sin editor humano en el loop diario. El sistema de orquestación se llama Paperclip y, según el post original publicado en Dev.to el 27 de octubre de 2026, no hay humano chequeando cada commit.
En este artículo:
- En 30 segundos
- ¿Qué es Lullwood y quién lo desarrolla?
- ¿Cómo funcionan los agentes Claude Code gestionando el equipo de Lullwood?
- ¿Qué modelo de Claude usa cada rol: Opus, Sonnet o Haiku?
- ¿Por qué revisar todo el código generó un cuello de botella?
- ¿Cómo cambiaron la política de revisión de pull requests?
- ¿Qué rol cumplen el Feature Scout y el Game Economist?
- ¿Qué resultado tuvo el cambio de política de revisión?
- Qué lecciones saca un equipo real de este caso
- Errores comunes al replicar este esquema de revisión
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Once agentes de Claude Code construyen Lullwood sin un humano en el loop de commits diario.
- El CEO, el CTO y dos agentes de research corren en Opus; ingeniería y revisión en Sonnet; resumen mecánico en Haiku.
- En una semana, los dos agentes que construyen el juego corrieron 803 sesiones y los dos que revisaban, 853.
- Con la revisión “sized to risk”, docs y código de aplicación mergean en verde sin bloqueo previo; solo el core de simulación, persistencia y secretos sigue bloqueado.
- El estudio acepta que lleguen defectos menores a release a cambio de, según sus propios números, duplicar aproximadamente el ritmo de entregas.
¿Qué es Lullwood y quién lo desarrolla?
Lullwood es un juego de horror gratuito que corre en el navegador, armado con three.js para el motor 3D y Next.js como framework web. Lo construye un único founder humano junto a una flota de agentes de Claude Code, y el estudio se describe a sí mismo como “one human founder plus a fleet of Claude agents building Lullwood in the open”.
No hay un equipo de programadores tradicional detrás. Hay once agentes trabajando contra un mismo repositorio git compartido, coordinados por Paperclip. Ponele que te imaginás una startup chica con un CEO, un CTO y varios ingenieros: así está armado Lullwood, salvo que ninguno de esos roles lo ocupa una persona.
¿Cómo funcionan los agentes Claude Code gestionando el equipo de Lullwood?
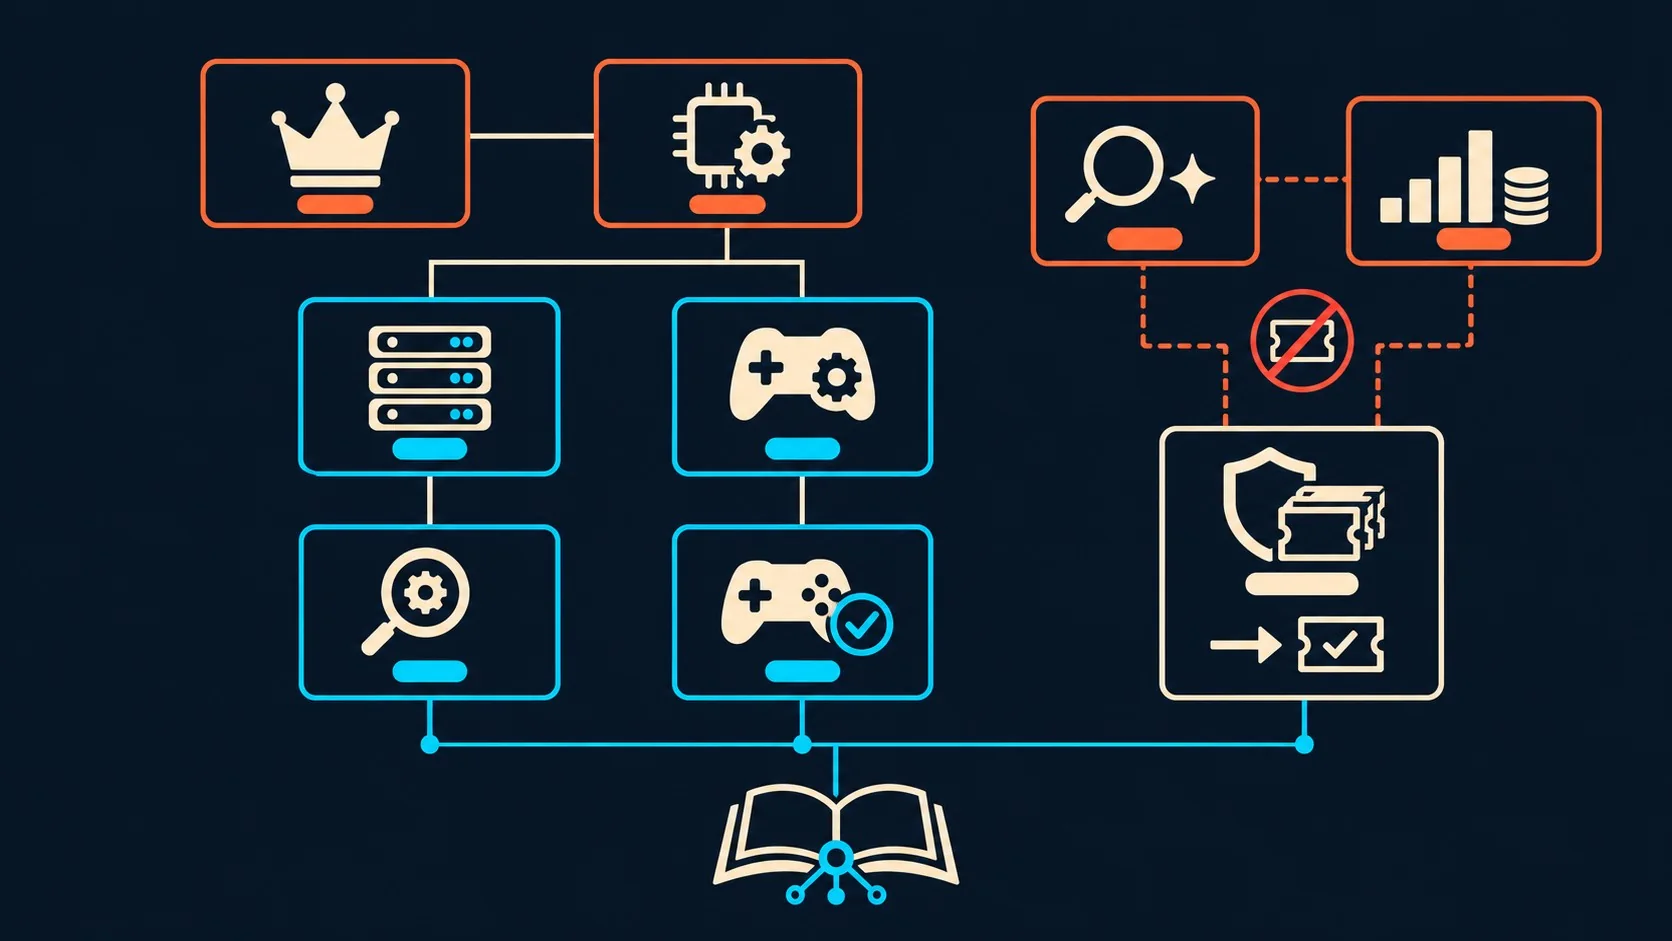
El equipo de agentes Claude Code gestionando Lullwood sigue un organigrama clásico de software, con roles que deciden, roles que ejecutan y roles que filtran. Arriba está el CEO, que decide qué se construye y por qué. Debajo, el CTO traduce esa decisión en trabajo de ingeniería concreto.
De ahí para abajo hay división de responsabilidades bien marcada:
- Founding Engineer: dueño de infraestructura, CI, release y Vercel.
- Game Engineer: dueño del código de gameplay y de toda la superficie mobile.
- Code Reviewer: filtra los pull requests antes de que lleguen a producción.
- Game Tester: juega el build y decide si algo da miedo o es divertido de verdad.
Afuera de esa línea jerárquica hay dos agentes de investigación, el Feature Scout y el Game Economist, que proponen trabajo pero no pueden abrir tickets. Un Backlog Keeper es el único agente cuyo trabajo entero consiste en convertir esas propuestas en tickets reales. Ya lo cubrimos antes en si dudás entre Cursor y Claude Code.
¿Qué modelo de Claude usa cada rol: Opus, Sonnet o Haiku?
El estudio asigna un modelo distinto según el tipo de decisión que cada rol tiene que tomar, no según jerarquía. El CEO, el CTO y los dos agentes de research corren sobre Opus. Ingeniería y revisión corren sobre Sonnet. El resumen mecánico corre sobre Haiku.
La lógica detrás es simple: los roles en Opus pesan tradeoffs sobre una ventana de contexto amplia y tienen que comprometerse con una dirección, algo que pide más deliberación que velocidad. Los roles en Sonnet leen y escriben código todo el día, y ahí la velocidad importa más que pensar cada movida veinte veces. El organigrama, según la fuente, es tanto una decisión de costo y capacidad como una decisión de management.
Nada de esto es casualidad. Si alguna vez armaste un pipeline con varios modelos corriendo tareas distintas, sabés que meter el modelo más caro en todos lados te funde el presupuesto sin sumar mucho.
¿Por qué revisar todo el código generó un cuello de botella?
Revisar todo el código generó un cuello de botella porque gastaba más de la mitad del esfuerzo del estudio en chequear trabajo en vez de hacerlo. Durante un tiempo, en Lullwood todo pasaba por revisión antes de mergear: un typo en la documentación, una constante de tuneo y un cambio de gameplay se gateaban igual.
Después llegó la medición, y ahí apareció el problema real. En una semana, los dos agentes que construyen el juego corrieron 803 sesiones entre los dos. Los dos agentes que gateaban ese trabajo corrieron 853. ¿Alguien había calculado antes cuánto costaba esa revisión uniforme? No, hasta que lo midieron. Cubrimos ese tema en detalle en instalar skills personalizadas en dos comandos.
Más de la mitad del esfuerzo total del estudio se iba en chequear en vez de construir. Esa es la cifra que gatilló el cambio de política.
¿Cómo cambiaron la política de revisión de pull requests?
El estudio reemplazó la revisión uniforme por un esquema de revisión proporcional al riesgo: no menos revisión en general, sino revisión puesta donde un error sale caro. Según el post de Lullwood, el nuevo esquema se divide en tres niveles.
- Docs, tests y copy: mergean apenas los checks dan verde, sin revisión previa.
- Código de aplicación y componentes: mergea en verde también, pero la revisión pasa después del merge, no antes.
- Core de simulación, persistencia, secretos y release: mantienen revisión bloqueante previa, porque ahí un error sale caro.
La política asume su propio costo y lo dice de forma explícita: ahora llegan a la rama de release algunos defectos que una revisión previa hubiera frenado. El estudio aceptó ese trade-off a propósito, a cambio de duplicar aproximadamente cuánto se entrega.
¿Qué rol cumplen el Feature Scout y el Game Economist?
El Feature Scout y el Game Economist proponen ideas pero no pueden abrir tickets por su cuenta: el CEO decide y filtra todo lo que ellos plantean. El Feature Scout se ocupa de mecánicas, es decir qué existe en el mundo del juego y qué hace el jugador: predadores, objetos, lugares, objetivos, historia, hints y menús.
El Game Economist se ocupa de la economía del juego: qué gana, gasta, arriesga y pierde el jugador. Eso cubre moneda, recompensas por partida, el costo de morir, precios de mejoras y curvas de balance. Una regla firme evita que los dos agentes aprueben la misma feature desde ángulos distintos y choquen en revisión semanas después.
Coordinan todo a través de una wiki compartida, que es la única memoria visible para los once agentes. Las decisiones quedan escritas con las alternativas que se rechazaron y por qué, así nadie reabre una discusión tres semanas después porque ya nadie se acuerda del motivo original. Es más lento que simplemente recordar. También es la única forma de que once agentes se mantengan coherentes sin un humano leyendo cada mensaje. Te puede servir nuestra cobertura de escalar Claude Code en codebases grandes.
¿Qué resultado tuvo el cambio de política de revisión?
El resultado, según el propio estudio, fue un aumento en el ritmo de entregas a cambio de aceptar algunos defectos menores en producción. El trade-off quedó escrito como condición, no como promesa: si el esquema empieza a producir bugs severos en vez de menores, esa es la señal para mover la línea de revisión hacia atrás.
No es una razón para volver en silencio a revisar todo de nuevo. Es un criterio explícito de reversión, atado a severidad y no a cantidad de bugs. Esa distinción importa: contar defectos sin pesar su impacto lleva a decisiones equivocadas en cualquier equipo, humano o de agentes.
Qué lecciones saca un equipo real de este caso
Lo que publicó el equipo de Lullwood es un dato de un solo estudio, con un solo founder y un solo producto. Antes de copiar la política, conviene medir lo mismo que ellos midieron: sesiones (o tiempo) dedicadas a construir versus sesiones dedicadas a revisar, durante al menos una semana representativa. Más sobre esto en armar un agente de IA en n8n paso a paso.
Si en tu equipo la revisión consume una porción similar o mayor del esfuerzo total, tiene sentido clasificar el código por el costo de un error, no por la costumbre de revisar todo igual. Lo que las fuentes no permiten concluir es si este esquema funciona igual en un equipo con humanos mezclados con agentes, o en un dominio donde un bug en producción cuesta más que en un juego gratuito de navegador.
Si manejás tu propio release train para un proyecto web, la infraestructura donde corre ese despliegue importa tanto como la política de revisión. En Argentina, donweb.com es una opción conocida para alojar ese tipo de infraestructura sin depender de un solo proveedor externo.
Errores comunes al replicar este esquema de revisión
- Copiar la clasificación sin medir el propio costo: lo que es “bajo riesgo” en Lullwood puede no serlo en un sistema de pagos o de salud. La clasificación de riesgo tiene que salir de tu dominio, no del post de otro estudio.
- Confundir “menos revisión” con “mejor revisión”: la fuente aclara que el cambio no fue reducir revisión en general, sino ponerla donde el error sale caro. Si solo bajás el volumen de revisión sin reordenar dónde se aplica, el riesgo sube sin que suba la velocidad real.
- No fijar la condición de reversión: Lullwood definió de antemano qué señal (bugs severos, no cantidad de bugs) movería la línea hacia atrás. Sin esa condición escrita, es fácil que el esquema derive solo porque “por ahora viene bien”.
- Asignar el mismo modelo a todos los roles: usar Opus en tareas mecánicas o Haiku en decisiones estratégicas no ahorra nada, solo desperdicia capacidad o le pide deliberación a un modelo pensado para velocidad.
Preguntas Frecuentes
¿Cómo funciona un equipo de agentes Claude Code sin supervisión humana?
Funciona con un organigrama fijo donde cada agente tiene un rol único, un sistema de orquestación (Paperclip, en el caso de Lullwood) que los coordina, y una wiki compartida que actúa como memoria visible para todos. No hay humano revisando cada commit, pero sí reglas escritas de antemano sobre qué código necesita revisión bloqueante y cuál no. Más contexto en nuestra guía completa sobre Claude.
¿Qué es Lullwood y quién lo desarrolla?
Lullwood es un juego de horror gratuito que corre en el navegador, construido con three.js y Next.js. Lo desarrolla un único founder humano junto a una flota de once agentes de Claude Code, sin un equipo tradicional de programadores humanos detrás del código.
¿Qué modelo de Claude usan para cada rol en el equipo?
El CEO, el CTO y los dos agentes de research (Feature Scout y Game Economist) corren sobre Opus. Los roles de ingeniería y de revisión de código corren sobre Sonnet. Las tareas de resumen mecánico corren sobre Haiku.
¿Cómo se decide qué pull requests necesitan revisión antes de mergear?
Se decide según el costo de un error, no según el tipo de cambio en general. Docs, tests y copy mergean sin revisión si pasan los checks; código de aplicación mergea en verde con revisión posterior; solo el core de simulación, la persistencia, los secretos y los release cuts mantienen revisión bloqueante previa al merge.
¿Qué es el sistema Paperclip que orquesta los agentes de Claude?
Paperclip es el sistema que coordina a los once agentes de Claude Code que trabajan contra el mismo repositorio git de Lullwood. Lo creó el equipo detrás del proyecto para que los agentes operen sin un humano en el loop de commits diario, respetando el organigrama de roles descrito en el propio post.
Conclusión
Lo que cambió en Lullwood no fue la cantidad de agentes, fue la relación entre revisar y construir. Medir sesiones gastadas en chequear versus sesiones gastadas en hacer les mostró un desbalance real: 853 sesiones de revisión contra 803 de construcción en una semana. De ahí salió una política nueva, con un trade-off escrito en voz alta y una condición clara para revertirla si los bugs se vuelven severos.
Para cualquier equipo que esté metiendo agentes a producir código, el valor de este caso no está en copiar el esquema exacto de Opus, Sonnet y Haiku, sino en el método: medir antes de decidir, clasificar por riesgo y no por costumbre, y dejar escrita la señal que te hace volver atrás. Eso sirve con agentes o sin ellos.