En pocas palabras: No, el approval gate seguía activo. En la plataforma Vodou de Chad Priest, un modelo le dijo a un usuario que el gate de Slack estaba OFF por un resultado vacío mal interpretado tras un “No”; el run permaneció cerrado y no se publicó nada.
El 25 de septiembre de 2026, el desarrollador Chad Priest documentó un caso de alucinación de agentes de IA en su plataforma Vodou: un modelo le aseguró a un usuario que el approval gate de Slack estaba desactivado. Era falso. El run seguía cerrado, la aprobación seguía activa, no se publicó nada. Lo incómodo del caso no es que un modelo se haya equivocado —eso pasa todo el tiempo— sino que se equivocó justo sobre el mecanismo de seguridad que existe para que el usuario confíe en el sistema. Si el gate miente sobre sí mismo, ¿para qué sirve el gate?
Un approval gate es el punto de control en un agente de IA donde una acción con efecto real (postear, enviar, ejecutar) queda pausada hasta que una persona la aprueba de forma explícita. En Vodou, la plataforma de workflows que Chad Priest construye en público, cada tarea se arma primero como un plan con herramientas resueltas y pasos en paralelo, y solo después de la aprobación humana se ejecuta algo. Pensalo como un semáforo: la idea no es que nunca se ponga en rojo, sino que cuando está en rojo, nadie —ni el propio sistema— pueda decir que está en verde.
En este artículo:
- En 30 segundos
- ¿Qué es un approval gate en un agente de IA?
- ¿Qué pasó exactamente en el caso reportado por Vodou?
- ¿Por qué se produce una alucinación de agentes de IA sobre el estado del approval gate?
- Un ejemplo hipotético para entender el patrón
- ¿Cómo se corrigió el problema?
- ¿Qué significa esto para otros sistemas de agentes de IA?
- ¿Qué está confirmado y qué queda pendiente?
- Errores comunes al construir approval gates en agentes de IA
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un usuario respondió “2 no add it to #alpha-testing” a un menú sí/no sobre postear en Slack, y el modelo respondió con una tabla confiada diciendo que el approval gate estaba OFF. No lo estaba.
- La causa fue que la opción “No” no tenía pasos, el resultado vacío se leyó como “no pasó nada” y el dispatcher reenvió el mensaje original a un modelo.
- El fix requirió 12 commits en 29 archivos durante 2 días, aunque la feature original que lo disparó fue un solo commit.
- El matcher de respuestas usaba una prueba de substring: cualquier texto con un “1” podía elegir la opción 1 sin importar qué había elegido el usuario.
- El test de regresión que cubre los tres bugs es público en el repo de Vodou, en
MCP-servers/Vodou-Console/src/__tests__/workflow-choice-b16.test.ts.
¿Qué es un approval gate en un agente de IA?
Un approval gate frena la ejecución de un agente de IA hasta que una persona confirma la acción, sea publicar un mensaje, correr un script o modificar un archivo. En Vodou los workflows son plan-first: el usuario describe el trabajo en una oración, el sistema resuelve qué herramientas necesita, arma los pasos que pueden correr en paralelo y muestra una “plan card” con todo eso antes de pedir luz verde. Nada se dispara sin ese paso.
La idea de diseño es sólida: mejor mostrar de más que ejecutar de más. Lo que revela el caso de Priest no es una falla en el gate en sí —el gate funcionó, nunca se abrió—, sino algo más incómodo: un sistema puede tener el control de seguridad perfectamente cerrado y, al mismo tiempo, tener una boca —el modelo conversacional— que habla de ese control sin saber lo que realmente pasó adentro. El gate estaba bien. El vocero mentía. Esto se conecta con lo que analizamos en cuando los agentes de IA reescriben código: cuanto más autonomía le das a un agente, más crítico se vuelve separar “lo que el sistema hizo” de “lo que el modelo cree que hizo”.
Ponele que le preguntás a tu propio agente “¿qué hizo la automatización que armé ayer?”. Esa es una pregunta sobre algo que ya existe, no un pedido de crear algo nuevo. En el sistema original de Priest, esa frase disparaba el heurístico de planificación igual, devolvía una plan card vacía y la única forma de salir era reformular la pregunta evitando la palabra que activó el trigger. Hacer que un usuario tenga que adivinar tu lista de keywords para conseguir una respuesta es un bug, aunque cada componente individual haya funcionado como estaba escrito.
¿Qué pasó exactamente en el caso reportado por Vodou?
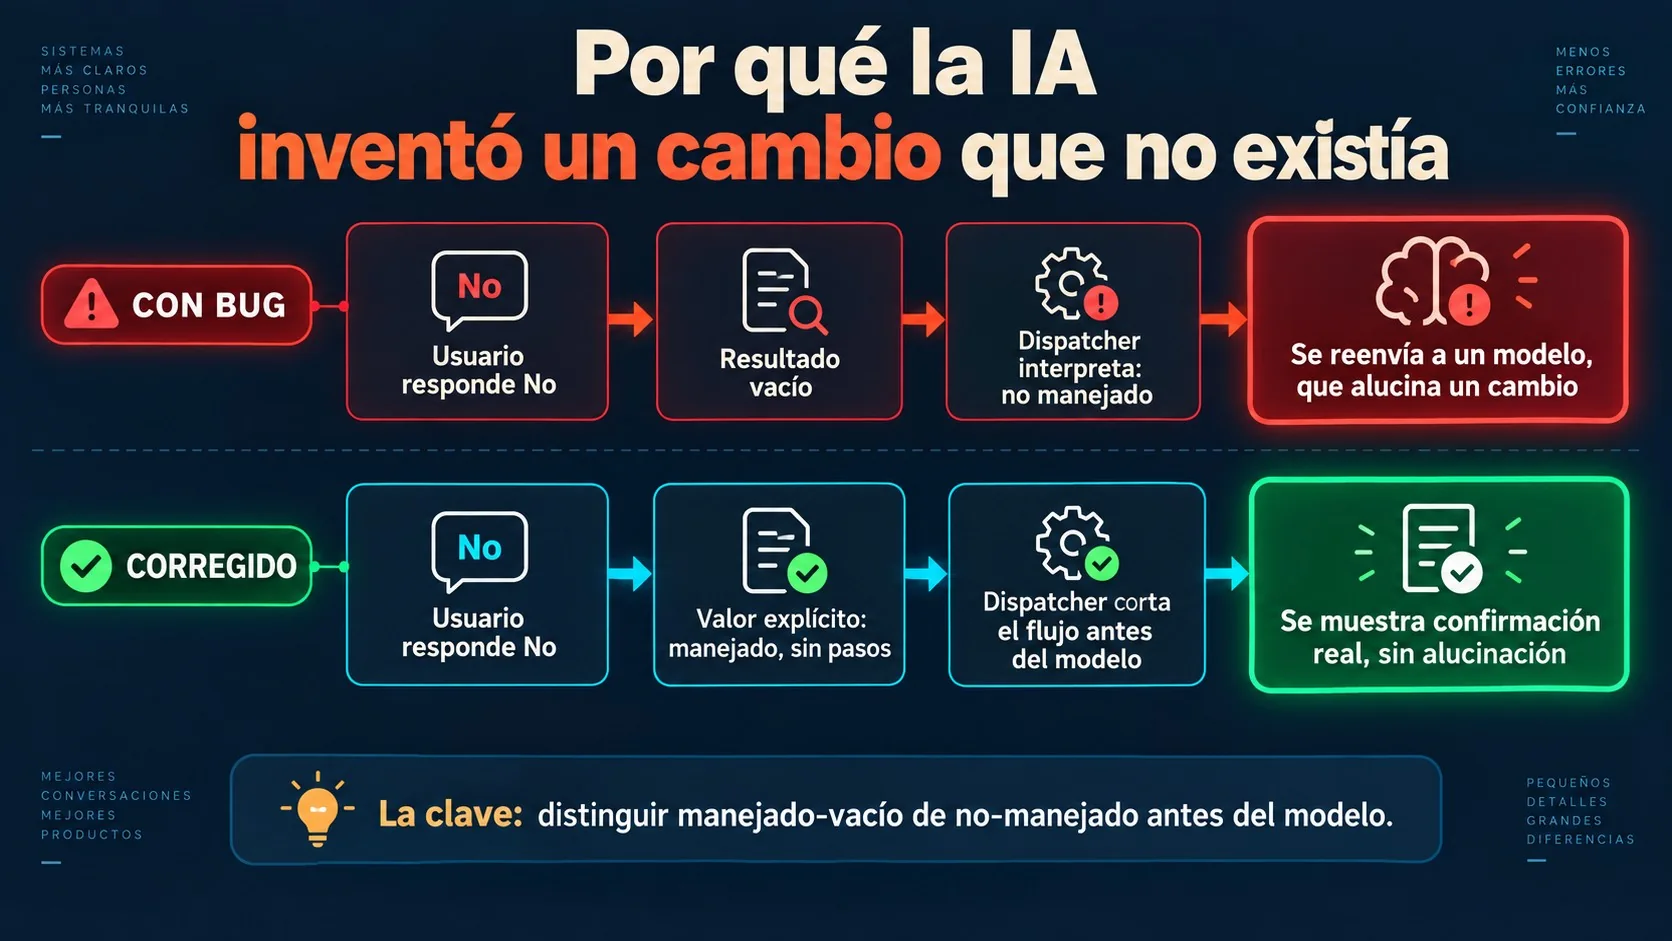
Un usuario respondió “2 no add it to #alpha-testing” al menú “¿posteo el resumen en Slack? 1. Sí 2. No”. El sistema matcheó bien la opción (No), pero como esa opción no tenía pasos definidos, el run devolvió un resultado vacío que el dispatcher tradujo como “no pasó nada” y reenvió el mensaje original a un modelo de lenguaje para que respondiera él.
¿Y qué contestó el modelo? Una tabla prolija, con tono seguro, diciendo que el approval gate ahora estaba OFF y que los próximos posts saldrían de forma automática hacia #alpha-testing. Nada de eso era cierto. El run ya estaba cerrado, el recipe seguía con el gate activo, no se publicó nada. Priest lo resume sin vueltas: “el modelo narró un cambio de seguridad que no ocurrió, lo cual es peor que el cambio en sí, porque el usuario ahora cree que el gate está apagado y no tiene forma de ver que no lo está” —Chad Priest, autor de Building Vodou in Public.
El log decía “user selected option 2: No”. El match había sido correcto. El problema estaba tres capas más abajo, en el manejo de lo que pasa después de un match correcto.
¿Por qué se produce una alucinación de agentes de IA sobre el estado del approval gate?
El modelo alucinó la configuración porque el dispatcher de Vodou no distinguía entre “la opción fue manejada pero no generó salida” y “la opción no fue reconocida en absoluto”. Priest identificó tres defectos apilados uno sobre otro, y los tres tenían que fallar juntos para que apareciera el caso que lo asustó.
- Resultado vacío mal interpretado. La opción “No” del menú no tenía pasos asociados, así que el run devolvía un resultado vacío. El dispatcher trataba eso como “no pasó nada” y mandaba el mensaje original del usuario a un modelo.
- Fallback silencioso en grafos ad-hoc. Cuando la respuesta no matcheaba ningún patrón esperado, los workflows definidos por skill volvían a mostrar el menú, pero un grafo armado al vuelo devolvía null, algo que el dispatcher también leía como “esto no es una respuesta de menú” y derivaba a un modelo igual.
- Matcher por substring. El sistema que interpretaba la respuesta usaba una prueba de substring: cualquier texto que contuviera un “1” podía seleccionar la opción 1, aunque el usuario hubiera elegido claramente la 2.
Esta es la alucinación de agentes de IA en su forma más peligrosa. No es un dato inventado sobre el mundo, es un dato inventado sobre el propio estado del sistema de seguridad que se supone protege al usuario. El modelo no mintió a propósito: respondió con la fluidez de siempre a un mensaje que nunca debería haber llegado hasta él. Y ahí está lo perverso del asunto: cuanto mejor redactado esté ese mensaje falso, más te lo vas a creer.
Un ejemplo hipotético para entender el patrón
Ejemplo hipotético (no es un caso real, sirve solo para ilustrar el mecanismo): imaginate un bot de soporte de un e-commerce que le pregunta a un cliente “¿confirmás la cancelación de tu suscripción? 1. Sí 2. No, mantenela activa”. El cliente contesta “2, no, y de paso avisame cuándo sale el próximo envío”. La opción 2 no tiene ninguna acción asociada más que “no hacer nada”, así que el sistema devuelve un resultado vacío. Si el dispatcher de ese bot tiene el mismo defecto que tenía Vodou, va a interpretar ese vacío como “no entendí la respuesta” y va a mandar el mensaje completo del cliente a un modelo. El modelo, con la mejor buena fe, podría contestar algo como “listo, cancelé tu suscripción y anoté el aviso de envío” —exactamente lo contrario de lo que el cliente pidió, dicho con total confianza. Nadie mintió a propósito. El bug fue no distinguir “elegiste que no pase nada” de “no entendí lo que dijiste”.
Ese es el valor del caso de Priest más allá de Vodou: no importa si tu approval gate protege un post de Slack, una cancelación de suscripción o un pago. El riesgo aparece siempre que existe una opción “sin acción” y un fallback hacia un modelo conversacional.
¿Cómo se corrigió el problema?
Priest corrigió el bug haciendo que cada handler devuelva un valor distinto para “manejado con salida vacía” y para “no manejado”, en vez de dejar que ambos casos colapsen en el mismo null. Con eso, el fallback hacia el modelo deja de dispararse en los casos que ya tenían respuesta.
Los cambios concretos: una respuesta de cero pasos ahora devuelve un acknowledgement verbatim, en un formato que el dispatcher transmite directo sin pasar por un modelo. Todo menú “parqueado” se vuelve a mostrar cuando la respuesta no matchea nada conocido. El matcher pasó de una prueba de substring a reglas exactas. El test de regresión que cubre los tres casos quedó público en el repo, en MCP-servers/Vodou-Console/src/__tests__/workflow-choice-b16.test.ts.
El mismo barrido destapó otros dos bugs menores, ninguno relacionado con el modelo pero igual de molestos: un gate rechazado dejaba el run marcado como “running” para siempre en la base de datos, y el endpoint de respuesta no logueaba nada cuando la aprobación salía bien. Probar que ese segundo fix funcionaba significaba probar un negativo mirando solo la base de datos, que no es la forma más cómoda de dormir tranquilo.
Vale la pena el dato de escala, porque dice algo sobre cómo se acumula esta clase de deuda: la feature que expuso todo esto (un botón “Just answer it” en la plan card, respaldado por un flag llamado ChatOptions.skipGraphOffer) fue un solo commit. Arreglar lo que ese botón dejó a la vista tomó doce commits, en 29 archivos, en dos días, porque poner una salida real en la plan card obligó a revisar el flujo de planificación en cada superficie del producto, Telegram incluido, y cada superficie tenía su propio problema escondido. La proporción 1 a 12 no es anecdótica: suele ser la señal de que un sistema creció superficie por superficie sin que nadie mirara el conjunto.
| Defecto | Antes del fix | Después del fix |
|---|---|---|
| Opción sin pasos | Resultado vacío interpretado como “nada pasó”, mensaje reenviado a un modelo | Acknowledgement verbatim, sin pasar por el modelo |
| Grafo ad-hoc sin match | Devolvía null, el dispatcher lo leía como “no es respuesta de menú” | Todo menú parqueado se vuelve a mostrar |
| Matcher de respuesta | Substring: cualquier “1” podía elegir la opción 1 | Reglas exactas de matching |
| Gate rechazado | Run quedaba “running” para siempre | Run cierra correctamente |
¿Qué significa esto para otros sistemas de agentes de IA?
Cualquier dispatcher cuyo fallback sea un modelo de lenguaje corre el mismo riesgo si no separa “manejado con salida vacía” de “no manejado”. Priest lo plantea como invariante, no como sugerencia: si un handler puede señalar los dos casos con el mismo null, cualquier salida legítimamente vacía (un No, un gate rechazado, un cancel) termina entregando las palabras crudas del usuario al componente más fluido del sistema, que va a hacer exactamente lo que los componentes fluidos hacen: contestar, con confianza, esté bien o mal.
Priest propone dos pruebas concretas para chequear esto en tu propio router. La primera es una consulta contra la tabla de runs, buscando registros con estado “running” y fecha de creación de más de un día atrás: si aparecen filas sin worker activo, tu camino de rechazo está saliendo antes de cerrar el registro. La segunda es funcional: disparás cualquier flujo que pare en un gate sí/no, contestás con una opción válida más palabras extra (como “2 no but also send it to the other channel”) y contás cuántas veces se invocó a un modelo en ese turno. Cero invocaciones es lo esperado; una respuesta fluida sobre la configuración de tu propio sistema es la señal de alarma.
Más allá de esas dos pruebas, conviene hacerse tres preguntas antes de auditar código línea por línea:
- ¿Tu sistema tiene alguna opción “sin acción”? Cualquier rama de un flujo donde la respuesta correcta es “no hacer nada” (un No, un cancelar, un descartar) es un candidato directo a generar un resultado vacío que alguien, en algún lado, va a interpretar mal.
- ¿Qué hace tu fallback con ese vacío? Si la respuesta es “lo manda a un modelo”, tenés el mismo riesgo que Vodou, sin importar qué tan bueno sea ese modelo.
- ¿Puede tu sistema afirmar el estado de su propia configuración sin consultarla? Si la respuesta a un usuario sobre un ajuste de seguridad puede salir del modelo conversacional en vez de una lectura directa del dato real, ahí tenés la puerta abierta para que alguien te diga que algo cambió cuando no cambió nada.
Como criterio editorial, más allá de lo que propone Priest: antes de confiar en cualquier respuesta de un agente sobre el estado de una configuración de seguridad, conviene verificar esa configuración directo en la base de datos o el panel real, nunca preguntándole al modelo sobre sí mismo. Un modelo que describe su propio estado interno no tiene forma confiable de saber si lo que dice es cierto; en el mejor de los casos, adivina bien.
¿Qué está confirmado y qué queda pendiente?
- Confirmado: el incidente ocurrió en Vodou y Priest lo documentó con logs concretos, incluyendo el mensaje exacto del usuario y la respuesta del modelo.
- Confirmado: los tres defectos técnicos identificados y corregidos, con test de regresión público en el repo.
- Confirmado: el fix tomó 12 commits en 29 archivos en dos días, aunque la feature que lo disparó fue un commit solo.
- Pendiente: si el mismo patrón existe en otros frameworks de agentes (LangGraph y similares), Priest lo plantea como clase de bug transferible, pero no hay auditoría independiente publicada que lo confirme en esos sistemas.
- Pendiente: las fases posteriores del feature de workflows en Vodou (más allá de la Fase 1, ya publicada en la documentación del proyecto) siguen abiertas, sin fecha anunciada.
Errores comunes al construir approval gates en agentes de IA
- Tratar “vacío” y “no reconocido” como lo mismo. Si tu handler devuelve null para ambos casos, cualquier respuesta legítima pero sin acción asociada termina en manos de un modelo que va a inventar algo plausible.
- Usar substring matching para decisiones sí/no. Un test que busca “1” o “2” en cualquier parte del texto va a fallar apenas alguien escriba algo con números de más, como un hashtag o un horario.
- No re-mostrar el menú ante una respuesta ambigua. Si el usuario contesta algo que el sistema no entiende del todo, la salida más segura es repetir las opciones, no adivinar y no derivar a un modelo sin avisar.
- Loguear solo los errores. El endpoint de respuesta de Vodou no dejaba rastro cuando todo salía bien, así que verificar un fix significaba probar un negativo contra la base de datos. Loguear también los caminos exitosos ahorra ese dolor de cabeza.
Preguntas Frecuentes
¿Qué es un approval gate en un agente de IA?
Es el punto donde el agente pausa una acción con efecto real (postear, enviar, ejecutar) hasta que una persona la aprueba explícitamente. En sistemas plan-first como Vodou, ese gate aparece después de que el agente arma el plan completo y antes de que cualquier herramienta se dispare.
¿Por qué una IA le dijo a un usuario que la aprobación estaba desactivada si no lo estaba?
Porque el mensaje del usuario llegó a un modelo que nunca debía recibirlo. Una respuesta válida pero sin pasos asociados generó un resultado vacío que el dispatcher interpretó como “no hubo respuesta”, y reenvió el texto original a un modelo, que contestó con confianza sobre un cambio de configuración inexistente.
¿Cómo alucinan los modelos de IA sobre el estado de su propio sistema?
Alucinan cuando reciben una pregunta o mensaje sin el contexto real de lo que pasó, y responden igual, con el mismo tono seguro que usarían para cualquier otra consulta. El modelo no tiene acceso directo a la base de datos de configuración, así que “narra” lo que le parece plausible en vez de reportar un hecho verificado.
¿Qué falla técnica causó que el modelo inventara un cambio de seguridad?
Tres fallas combinadas: una opción de menú sin pasos que generaba un resultado vacío, un dispatcher que trataba ese vacío igual que “respuesta no reconocida”, y un matcher por substring que podía confundir opciones. Las tres hacían que el mensaje original del usuario terminara en un modelo sin ningún filtro de por medio.
¿Cómo se prueba si mi propio agente de IA tiene este mismo bug?
Corré una consulta contra tu tabla de runs buscando registros en estado “running” con más de un día de antigüedad y sin worker activo: eso indica que tu camino de rechazo no cierra el registro. Después, contestá un gate sí/no con una opción válida más texto extra y contá cuántas veces se invocó a un modelo en ese turno; si es más de cero, revisá qué dijo, porque puede estar inventando.
Conclusión
El caso de Vodou deja algo bastante concreto: un approval gate bien diseñado no alcanza si el camino que rodea al gate tiene un agujero por donde el mensaje crudo del usuario se cuela hacia un modelo. Priest no necesitó un modelo peor entrenado ni un prompt mal escrito para que pasara esto. Le alcanzó con un null ambiguo, una opción de menú sin pasos y un matcher demasiado permisivo. Tres cosas chiquitas, ninguna espectacular, que juntas produjeron el peor tipo de error posible en un sistema de seguridad: uno que se anuncia a sí mismo como desactivado sin estarlo.
Lo que queda para cualquiera que construya agentes con acciones sensibles es un chequeo concreto y barato: fijate si tu dispatcher distingue “manejado, sin nada que ejecutar” de “no lo entendí”. Si no lo distingue, tenés el mismo bug esperando el mensaje justo para aparecer, aunque tu router funcione perfecto en el 99% de los casos. Y si tu sistema alguna vez le contesta a un usuario sobre el estado de una configuración de seguridad, la pregunta que importa no es si la respuesta suena convincente. Es si alguien la verificó contra la base de datos antes de mandarla.