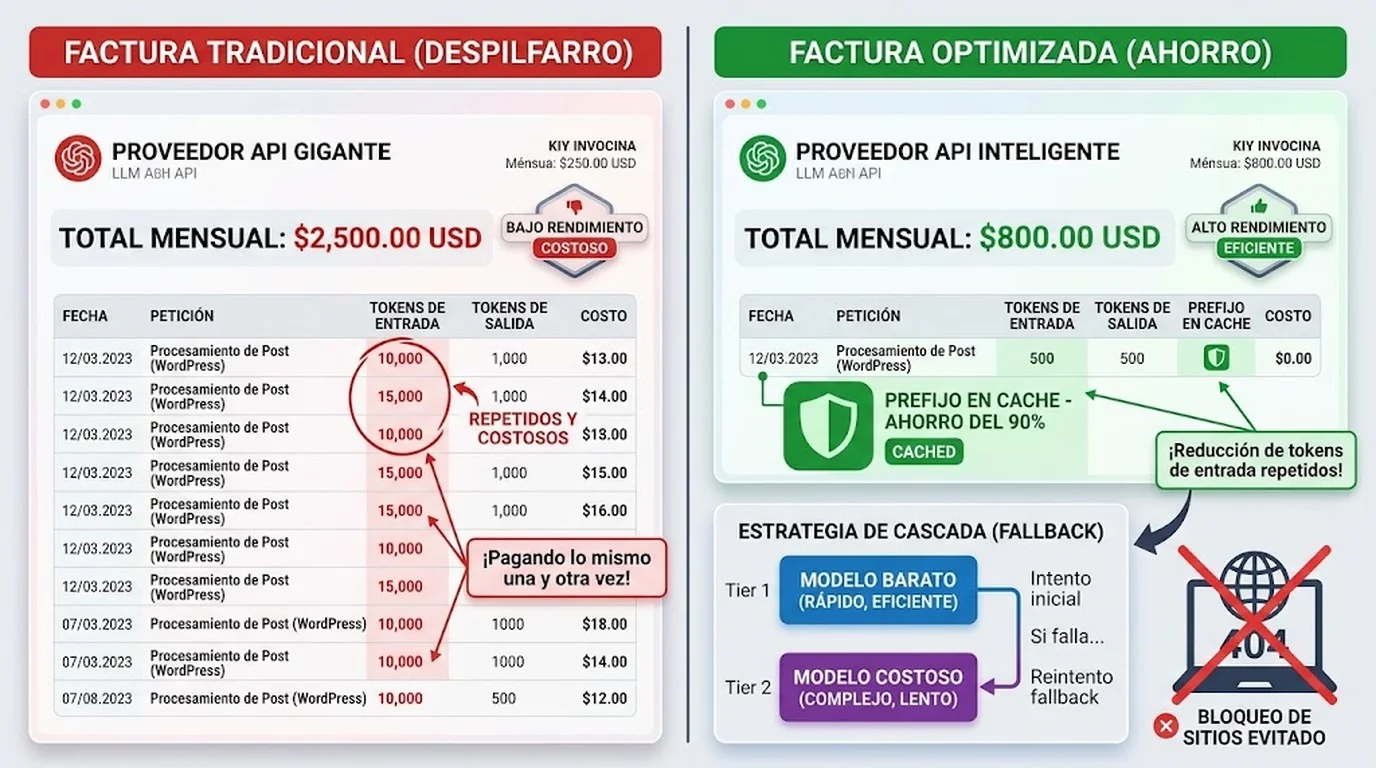
En pocas palabras: Se reduce combinando prompt caching (hasta 90% de descuento en tokens repetidos), Batch API (rebaja del 50% en trabajo asíncrono), cascadas de modelo barato a caro según el gap de precio, y control de reintentos: en 3 intentos fallidos, HTML crudo cuesta 136 veces más que texto extraído.
Ponele que tenés un agente corriendo en producción, le pasás una tarea de scraping y de repente la factura de OpenAI se te duplica sin que hayas subido el volumen de llamadas. Un análisis publicado el 25 de septiembre de 2026 por Decodo midió cuánto se puede reducir el costo de la API de un LLM combinando caching, Batch API, cascadas de modelos y control de reintentos en scraping.
Antes de meternos en los números, conviene separar dos cosas que se mezclan todo el tiempo: el precio por token (rate) y la cantidad de tokens que facturás (volumen). Son palancas distintas y se atacan con herramientas distintas. El caching baja el rate de un prefijo repetido; el batching baja el rate a la mitad pero solo si podés esperar la respuesta; las cascadas bajan el volumen de tokens caros mandando primero al modelo barato; y el control de reintentos evita pagar volumen por respuestas que no sirven para nada. El caching es automático por default arriba del mínimo cacheable; los otros tres mecanismos hay que activarlos y medirlos a propósito, porque nadie te avisa cuando te estás perdiendo el ahorro.
En este artículo:
- En 30 segundos
- ¿Por dónde empezar según el tipo de agente que tenés?
- ¿Por qué la factura de un LLM sube sin que el volumen de trabajo cambie?
- ¿Cómo funciona el caching de prompts para ahorrar costos en LLM?
- ¿Qué es la Batch API y cuándo conviene usarla en vez de caching?
- ¿Cómo funciona una cascada de dos modelos para bajar costos?
- ¿Por qué cuesta tan caro cuando un scraping falla o queda bloqueado?
- ¿Qué hacer en la práctica para dejar de pagar por llamadas que no devuelven nada?
- Qué está confirmado y qué no
- Errores comunes al intentar reducir costos de API de LLM
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El 98% de los equipos ya gestiona costos de IA, contra el 31% en 2024, según el State of FinOps 2026 citado por Decodo.
- El prompt caching en GPT-5.6 requiere un prefijo mínimo de 1.024 tokens según la documentación oficial de OpenAI; por debajo de eso no hay descuento ni error visible.
- La Batch API descuenta 50% en input y output sin mínimo de longitud, pero no sirve para chat en vivo.
- Una cascada de dos modelos con gap de 10x ahorra 60% si solo 3 de cada 10 llamadas escalan al modelo caro.
- Un bloqueo de scraping de 147.539 tokens (caso Glassdoor) se refacture en cada turno posterior: 3 intentos cuestan 317 veces más que una llamada exitosa.
¿Por dónde empezar según el tipo de agente que tenés?
No todos estos mecanismos aplican igual a cualquier caso. Antes de tocar código, conviene hacerse una pregunta simple: ¿de dónde viene la mayor parte de mi factura, del rate o del volumen? Con eso ya podés priorizar:
- Si reenviás el mismo system prompt o las mismas instrucciones en cada llamada, empezá por prompt caching. Es el que menos trabajo de implementación pide, porque en GPT-5.6 es automático arriba del mínimo cacheable.
- Si tenés trabajo que corre en background (resúmenes nocturnos, reprocesamiento de datasets, clasificación masiva sin usuario esperando), la Batch API te da el 50% de descuento sin tocar la lógica del prompt.
- Si tu agente hace triage —clasificar, filtrar, decidir si algo pasa a una etapa más cara— una cascada de dos modelos tiene sentido, pero solo si podés validar la respuesta del modelo barato de forma barata (una lista cerrada de etiquetas, no una evaluación abierta).
- Si tu agente hace scraping o consume APIs de terceros que bloquean, el problema no es el rate ni el volumen de trabajo útil: es el volumen de reintentos fallidos que quedan pegados en el contexto. Ahí el control de reintentos pesa más que cualquier otro mecanismo.
Estos cuatro puntos no son excluyentes. Un agente de scraping típico necesita los cuatro a la vez: caching para el prompt fijo, batch para los jobs que no son en vivo, cascada para decidir qué páginas vale la pena procesar con el modelo caro, y control de reintentos para no pagar de más cuando un sitio te bloquea. Vamos por partes.
¿Por qué la factura de un LLM sube sin que el volumen de trabajo cambie?
Porque un agente reenvía todo el contexto en cada turno, aunque la tarea de fondo no haya crecido un ápice. Subís el prompt inicial, el agente llama a una herramienta, la herramienta falla, el agente reintenta, y en cada uno de esos pasos vuelve a pagar por el system message, las definiciones de herramientas y toda la conversación anterior. Un error temprano se multiplica turno tras turno sin que lo notes hasta que llega la factura.
Los tokens de razonamiento se facturan como output, no aparte. Eso significa que activar razonamiento en preguntas que no lo necesitan infla el costo por respuesta sin mejorar nada (spoiler: la mayoría de las preguntas de clasificación simple no lo necesitan).
Hay algo peor todavía. Un tool call fallido, una respuesta malformada y un scraping bloqueado se facturan igual que una llamada exitosa, porque consumieron tokens. Tu invoice lista tokens, no resultados, así que el costo por request no te muestra dónde está el desperdicio. Según Decodo, el 98% de los equipos ya gestiona costos de IA (contra el 31% en 2024), pero gestionar no es lo mismo que explicar el gasto. La recomendación concreta de la fuente: sumar los tokens por tarea usando el campo usage que ya viene en cada respuesta de la API, no confiar en el promedio por request.
¿Cómo funciona el caching de prompts para ahorrar costos en LLM?
El prompt caching descuenta el precio del prefijo (la parte inicial del prompt) cuando la reutilizás sin cambios entre requests. Según la guía oficial de OpenAI, en GPT-5.6 el caching es automático arriba de un prefijo mínimo de 1.024 tokens: escribir en caché cuesta 1,25x la tarifa normal de input, pero leerlo después cuesta solo 0,1x esa tarifa.
La cuenta que hace OpenAI es directa: escribir un prefijo una vez y reutilizarlo una vez cuesta 1,35x el costo normal, contra 2x si procesás el mismo prefijo dos veces sin caching. El ahorro crece con cada lectura adicional. En diez requests, una escritura y nueve lecturas completas cuestan 2,15x, contra 10x sin cachear nada.
Ojo con esto: si tu prefijo compartido nunca se repite, pagás la escritura y no recuperás nada. Cachear solo tiene sentido cuando lo que va primero en el prompt es estable (instrucciones del sistema, definiciones de herramientas) y lo que cambia va al final (la pregunta del usuario, el contexto dinámico). Si invertís ese orden, rompés el prefijo compartido y el caching deja de aplicar sin que te avisen. Otro detalle que la mayoría pasa por alto: las cachés viven en máquinas individuales, y el tráfico por arriba de 15 requests por minuto puede generar overflow routing, que rompe el match del prefijo aunque el contenido sea idéntico.
¿Qué es la Batch API y cuándo conviene usarla en vez de caching?
La Batch API descuenta 50% tanto en input como en output, sin mínimo de longitud y sin costo extra por escritura. Sirve para trabajo asíncrono, no para chat ni nada que necesite baja latencia: si el resultado nadie lo está esperando en tiempo real, va a batch.
Hay una alternativa intermedia que Decodo menciona: la opción “flex”, que te da la misma tarifa descontada sin el circuito async completo, a cambio de sacrificar algo de latencia y disponibilidad. El tema es que migrar un flujo a batch puede hacerte perder el descuento de prompt caching que ya tenías funcionando, así que antes de mover algo a batch conviene revisar el campo cached_tokens de tu tráfico actual. Si ese número ya es alto, quizás el batching no te suma tanto como parece en el papel. Tema relacionado: recortar la factura de IA sin tocar código.
¿Cómo funciona una cascada de dos modelos para bajar costos?
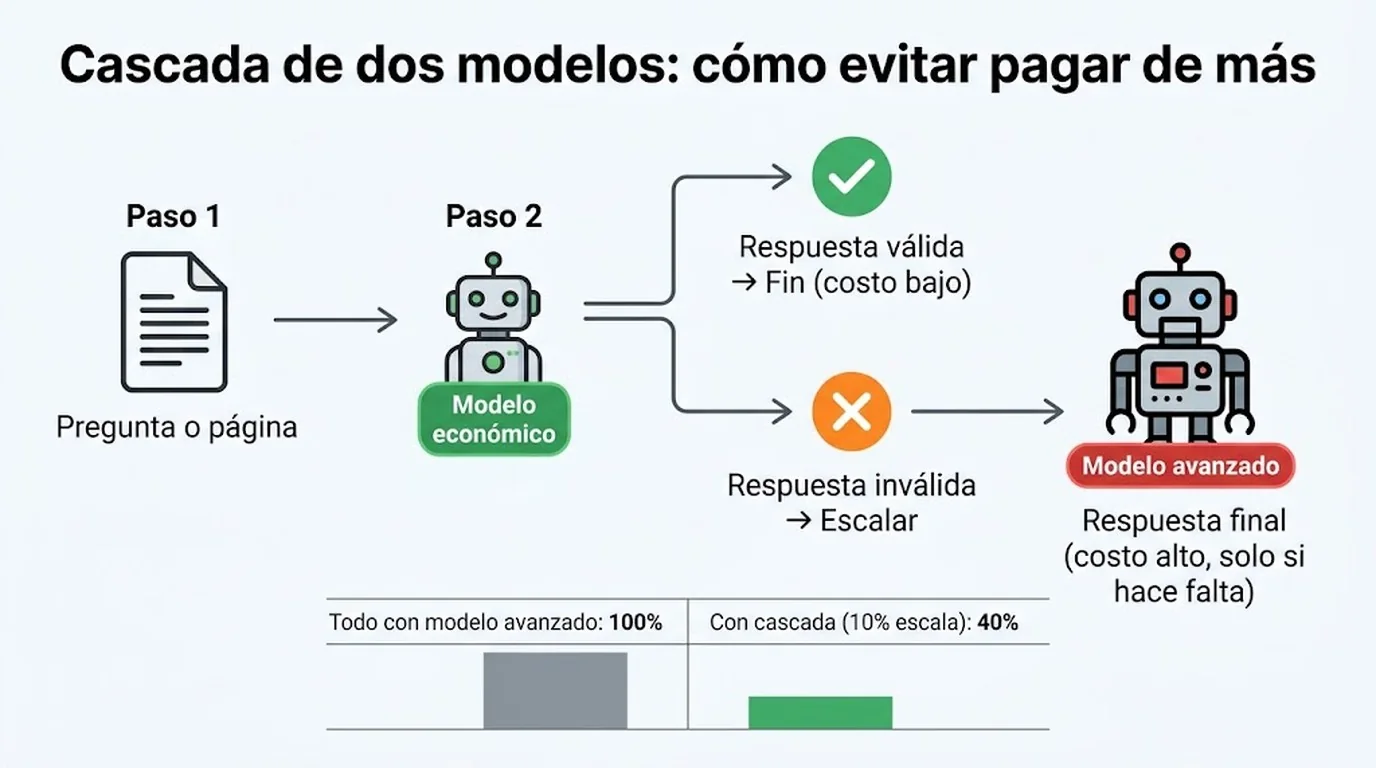
Una cascada de dos modelos manda primero la consulta al modelo barato y solo escala al modelo caro cuando la respuesta falla una validación. Decodo ilustra el patrón con nombres de modelo genéricos, gpt-5.6-luna como barato y gpt-5.6-terra como caro, para ejemplificar una rate card con gap de 10x entre ambos. Aclaración necesaria: esos nombres son ilustrativos del artículo fuente, no un anuncio oficial de producto.
Con un gap de 10x, el punto de equilibrio está en 90% de escalado. Si escalás 3 de cada 10 llamadas al modelo caro, ahorrás 60% contra usar el modelo caro para todo. La fórmula que da la fuente es simple: el break-even es 1 menos 1 dividido el gap de tarifa, cuando input y output tienen la misma diferencia de precio. Con un gap de 5x, el break-even sube a 80%.
Ejemplo hipotético (ilustrativo, no un caso real medido): imaginá que tenés un agente que clasifica 20.000 tickets de soporte por mes, cada uno como “urgente” o “no urgente”. El modelo barato acierta la etiqueta clara en la mayoría de los casos, pero en los tickets ambiguos —los que mencionan plazos vagos o mezclan dos pedidos— falla la validación y hay que escalar al modelo caro para que decida. Aplicando la fórmula de break-even (1 − 1/gap) con un gap de 10x entre modelos, el punto de equilibrio cae en 90% de escalado: mientras menos de 9 de cada 10 tickets terminen en el modelo caro, la cascada te conviene. Si tu histórico de tickets ambiguos ronda el 15-20% (una cifra que tenés que medir vos, no asumir), la cascada te deja bastante margen antes de perder plata. Si en cambio la mayoría de tus consultas son ambiguas por naturaleza —por ejemplo, resúmenes legales o diagnósticos médicos donde casi todo necesita revisión fina— la cascada probablemente no rinda: vas a terminar escalando cerca del 90% igual, y sumás la latencia extra del paso barato sin ahorrar casi nada.
El patrón en la práctica tiene tres pasos:
- Clasificá con el modelo barato primero. Enviá la consulta a un modelo de rate bajo con un prompt corto y una lista cerrada de etiquetas válidas.
- Validá contra un set de respuestas conocidas. Si la salida no matchea ninguna etiqueta válida, no confiés en la confianza que reporta el modelo: chequeá la etiqueta, no el score.
- Escalá solo lo que falla. Mandá al modelo caro únicamente las consultas que el modelo barato no pudo resolver de forma válida.
Cada modelo en la cascada mantiene su propia caché, así que el ahorro real termina siendo menor a la diferencia de tarifa pura. Y una etiqueta válida no siempre es una etiqueta correcta: conviene samplear contra el modelo fuerte antes de confiar en los números de ahorro. En criollo: la cascada te salva plata en volumen predecible con respuestas fáciles de chequear, no en tareas donde validar la respuesta del modelo barato es casi tan caro como resolver la tarea con el modelo caro directamente.
¿Por qué cuesta tan caro cuando un scraping falla o queda bloqueado?
Porque un bloqueo no cuesta una llamada, cuesta todas las llamadas siguientes. Cada turno de un agente reenvía la conversación completa, así que una respuesta bloqueada que quedó en el contexto se refacture en cada intento posterior. Decodo probó esto en septiembre de 2026 contra 7 sitios con protección anti-bot, comparando un fetch simple, un fetch con IP residencial y su propia API de scraping. Para más detalles técnicos, mirá diferencias entre API y MCP para developers.
| Sitio | Fetch simple | +IP residencial | Web Scraping API |
|---|---|---|---|
| Zillow | 403 | 200, listados reales | 200 |
| Amazon | 503 | 200, precios reales | 200 |
| Walmart | 200, bot-check | 200, precios reales | 200 |
| Glassdoor | 403, 147.539 tokens | 403 | 200 |
| Indeed | 403 | 403 | 200 |
| Crunchbase | 403 | 403 | 200 |
| G2 | 403 | 403 | 613 tokens, rechazado |
| Total (7 sitios) | 0 usables | 3 usables | 6 usables |
El fetch simple no sirvió en ninguno de los 7 casos. La IP residencial resolvió 3, pero los otros 4 rechazaron la misma dirección en 12 de 12 reintentos espaciados cada 6 segundos, así que el bloqueo depende de más factores que solo la IP de origen. Walmart además devolvió un falso positivo: HTTP 200 con una página de bot-check en el body, algo que un tool que solo chequea el status_code reporta como éxito y le pasa al modelo como si fuera data real.
El caso Glassdoor es el que muestra la escala del problema. La página de bloqueo medía 147.539 tokens (medidos con el tokenizer o200k_base), y se refacturó en los 3 turnos siguientes del agente: 891.670 tokens de input en total, sin ninguna respuesta útil. Con 3 intentos, se envían 6 veces más tokens que con un intento único, pero se paga 11 veces más, porque los turnos 3 y 4 superan el umbral de 272.000 tokens y se facturan a una tarifa más alta. El resultado en dólares por cada 1.000 llamadas de ese tipo: $302,47 por un intento bloqueado, $3.267,09 por 3 intentos con HTML crudo, y apenas $10,31 por una llamada exitosa que devuelve markdown limpio. Extraer solo el texto antes de reintentar baja el costo de 3 intentos a $24,09, todavía 2,3 veces más que una llamada exitosa, y encima sin devolver respuesta.
La lección que se saca de esta tabla no es “conseguí mejor IP” ni “usá tal proveedor”: es que el costo de un bloqueo depende de dónde vive el reintento. Si el reintento vive dentro del historial de la conversación del agente, cada intento fallido se vuelve a facturar completo en el turno siguiente. Si vive afuera —en un servicio o script separado que solo le devuelve al agente el resultado final—, el agente paga una sola vez por una sola respuesta, exitosa o no.
¿Qué hacer en la práctica para dejar de pagar por llamadas que no devuelven nada?
Sacá los reintentos de scraping fuera del loop principal del agente. Si cada reintento vive adentro de la conversación, el contexto crece con cada bloqueo y arrastra el costo con él; si vive afuera, en un servicio dedicado, el agente recibe una sola respuesta limpia en vez de cada intento fallido acumulado.
Tres acciones concretas, en orden de impacto:
- Medí por tarea, no por request. Sumá los tokens del campo
usageagrupados por tipo de operación, no el promedio de costo por llamada. - Moveé los reintentos fuera del contexto del agente. Un servidor MCP dedicado a scraping (como el que ofrece Decodo) retorna una sola respuesta en vez de que cada intento fallido quede pegado en la conversación.
- Revisá el body, no solo el status_code. El caso Walmart mostró un HTTP 200 con contenido de bot-check: sin chequear el body, el agente cree que tiene data real y no reintenta.
Si corrés vos mismo esos workers de scraping o algún servicio de caché intermedio, la infraestructura donde viven importa tanto como el código: un worker con latencia alta hacia el proveedor externo te va a generar más reintentos, no menos. Para proyectos en Argentina o Latinoamérica, tener el hosting cerca de donde vive tu agente ayuda a que esos reintentos —si igual tenés que hacerlos— sean más baratos en tiempo y no sumen otro cuello de botella a la cuenta; donweb.com es una opción local para ese tipo de infraestructura.
Qué está confirmado y qué no
Confirmado, según la documentación oficial de OpenAI y el análisis de Decodo: el mínimo cacheable de GPT-5.6 es 1.024 tokens, la escritura en caché cuesta 1,25x la tarifa normal, la lectura cuesta 0,1x, y la Batch API descuenta 50% sin mínimo de longitud. También está confirmado el resultado del test de 7 sitios: 0 páginas usables con fetch simple, 3 con IP residencial, 6 con la API de scraping de Decodo. Cubrimos ese tema en detalle en armar un fallback que atrape las fallas.
No confirmado, o dependiente de tu caso: los números exactos de ahorro de la cascada de modelos (10%, 30%, 90% de escalado) son un ejemplo de cálculo con una rate card ilustrativa, no una garantía universal. Tu gap real entre modelo barato y caro puede ser distinto, y el ahorro efectivo depende de cuánto realmente escale tu propio sistema de validación. El ejemplo de los tickets de soporte de más arriba es exactamente eso, un ejercicio con la fórmula, no una medición sobre un caso real.
Errores comunes al intentar reducir costos de API de LLM
- Cachear contenido que nunca se repite. Si tu prefijo cambia en cada request, pagás la escritura (1,25x) y no recuperás nada. Cacheá solo lo verdaderamente estable: instrucciones del sistema, definiciones de herramientas.
- Confiar en el status_code sin mirar el body. Un HTTP 200 puede traer una página de bot-check, como pasó con Walmart en el test de Decodo. El agente lo toma como éxito y sigue con data basura.
- Mover todo a Batch API sin revisar el caching actual. Si ya tenías un prefijo cacheado funcionando bien, migrar ese flujo a batch puede hacerte perder ese descuento. Revisá
cached_tokensantes de decidir. - Dejar que el agente reintente scraping adentro del mismo contexto. Cada reintento fallido queda pegado a la conversación y se refacture en cada turno siguiente, como el caso Glassdoor que llegó a 891.670 tokens sin respuesta.
- Armar una cascada sin poder validar barato. Si chequear la respuesta del modelo barato cuesta casi lo mismo que resolver la tarea con el modelo caro, la cascada no ahorra nada, solo suma un paso.
Preguntas Frecuentes
¿Cómo se puede reducir el costo de usar la API de un LLM?
Combinando prompt caching para prefijos repetidos, Batch API para trabajo asíncrono, cascadas de modelo barato a modelo caro para preguntas fáciles, y sacando los reintentos de scraping fuera del contexto del agente. El caching es automático por default arriba del mínimo cacheable; el resto de estos mecanismos hay que medirlos y activarlos a propósito.
¿Qué es el prompt caching y cuánto ahorra?
El prompt caching descuenta el precio de un prefijo de prompt que se reutiliza sin cambios entre requests. Según la documentación oficial de OpenAI, en GPT-5.6 la escritura cuesta 1,25x la tarifa normal y la lectura 0,1x, lo que en diez requests con una escritura y nueve lecturas da un costo total de 2,15x contra 10x sin cachear.
¿Cuándo conviene usar la Batch API en vez de llamadas normales?
Cuando el trabajo es asíncrono y nadie está esperando la respuesta en tiempo real. La Batch API descuenta 50% en input y output sin mínimo de longitud, pero no sirve para chat en vivo ni para nada que necesite baja latencia.
¿Cómo funciona una cascada de dos modelos para bajar costos?
Mandás primero la consulta a un modelo barato y escalás al modelo caro solo si la respuesta falla una validación. Con un gap de tarifa de 10x entre ambos modelos, escalar 3 de cada 10 llamadas ahorra 60% contra usar el modelo caro para todo, y el punto de equilibrio llega recién en 90% de escalado.
¿Por qué cuesta tan caro cuando un scraping falla o queda bloqueado?
Porque cada turno del agente reenvía toda la conversación anterior, así que una página bloqueada que quedó en el contexto se refacture en cada intento posterior. En el test de Decodo, un bloqueo de Glassdoor de 147.539 tokens terminó costando $3.267,09 por cada 1.000 llamadas en 3 intentos, contra $10,31 de una llamada exitosa.
Conclusión
Reducir costos de API de LLM no es negociar un descuento con el proveedor. Es dejar de pagar tarifa completa por trabajo que ya está resuelto (prompt caching), por trabajo que nadie espera en tiempo real (Batch API), por preguntas fáciles que no necesitan el modelo caro (cascadas), y por reintentos que no devuelven nada (scraping bloqueado que queda pegado en el contexto).
Lo que cambia con estos datos es la forma de medir. Si solo mirás el costo promedio por request, el desperdicio queda invisible. Sumá tokens por tarea con el campo usage, revisá cached_tokens antes de mover algo a batch, chequeá si tu caso realmente tiene margen para una cascada antes de armarla, y sacá los reintentos de scraping del loop del agente. Esos cuatro chequeos, aplicados en ese orden según de dónde venga tu gasto, son los que más impacto tienen sobre la factura final.