En pocas palabras: No hay una sola API de inferencia IA más rápida: según llmlatency.dev (27/9 al 26/10 de 2026, 1.190.063 probes), Fireworks AI lideró en US Central (28 ms) y Tokio (19 ms), mientras que OpenRouter fue el más veloz en São Paulo (61 ms). OpenAI registró 139 ms, 214 ms y 257 ms respectivamente en esas mismas regiones.
Si tu backend corre en Buenos Aires o São Paulo y elegiste tu proveedor de inferencia mirando un benchmark hecho desde Virginia, estás midiendo mal. Según el tracker independiente llmlatency.dev, que corrió 1.190.063 probes de red durante 30 días (27 de septiembre al 26 de octubre de 2026) desde US Central, Tokio y São Paulo, no existe una sola api de inferencia ia más rápida: el ranking cambia según desde dónde mandás el request, y en algunos casos la diferencia es de hasta 15 veces entre regiones para el mismo proveedor.
Latencia de inferencia es el tiempo que pasa entre que tu aplicación manda un request a una API de modelos de lenguaje y recibe el primer dato de respuesta. Se mide en dos capas distintas: latencia de red pura (cuánto tarda en llegar al “front door” del proveedor) y time to first token (cuánto tarda en aparecer la primera palabra generada). Groq, Cerebras, SambaNova, Fireworks AI y otros 42 proveedores fueron medidos por llmlatency.dev con esta metodología.
En este artículo:
- En 30 segundos
- ¿Qué midió el estudio de llmlatency.dev sobre 46 APIs de inferencia?
- ¿Cuál es la API con menor latencia de red según la región?
- ¿Groq o Gemini Flash-Lite entrega el primer token más rápido?
- ¿Por qué la región con menor latencia de red no es siempre la más rápida en responder?
- ¿Qué no mide este estudio y qué limitaciones tiene?
- ¿Cómo elegir una API de inferencia de IA según la latencia?
- Qué está confirmado y qué no
- Errores comunes al evaluar velocidad de APIs de IA
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Fireworks AI tuvo el front door más cercano en US Central (28 ms) y Tokio (19 ms), pero en São Paulo quedó a 252 ms.
- Groq entregó el primer token en 794 ms desde São Paulo, 1.379 ms desde US Central y 1.497 ms desde Tokio, usando el modelo openai/gpt-oss-120b.
- Gemini Flash-Lite de Google tuvo una mediana similar a Groq (1,2 a 1,7 s) pero un p95 de 5,6 a 6,1 segundos, con 8 a 10% de requests fallidos.
- SambaNova es el caso más extremo de variación regional: 25 ms desde Tokio contra 371 ms desde São Paulo, 15 veces más lento.
- Alemania quedó excluida del reporte porque el contenedor de pruebas estaba limitado por CPU y distorsionaba los números.
¿Qué midió el estudio de llmlatency.dev sobre 46 APIs de inferencia?
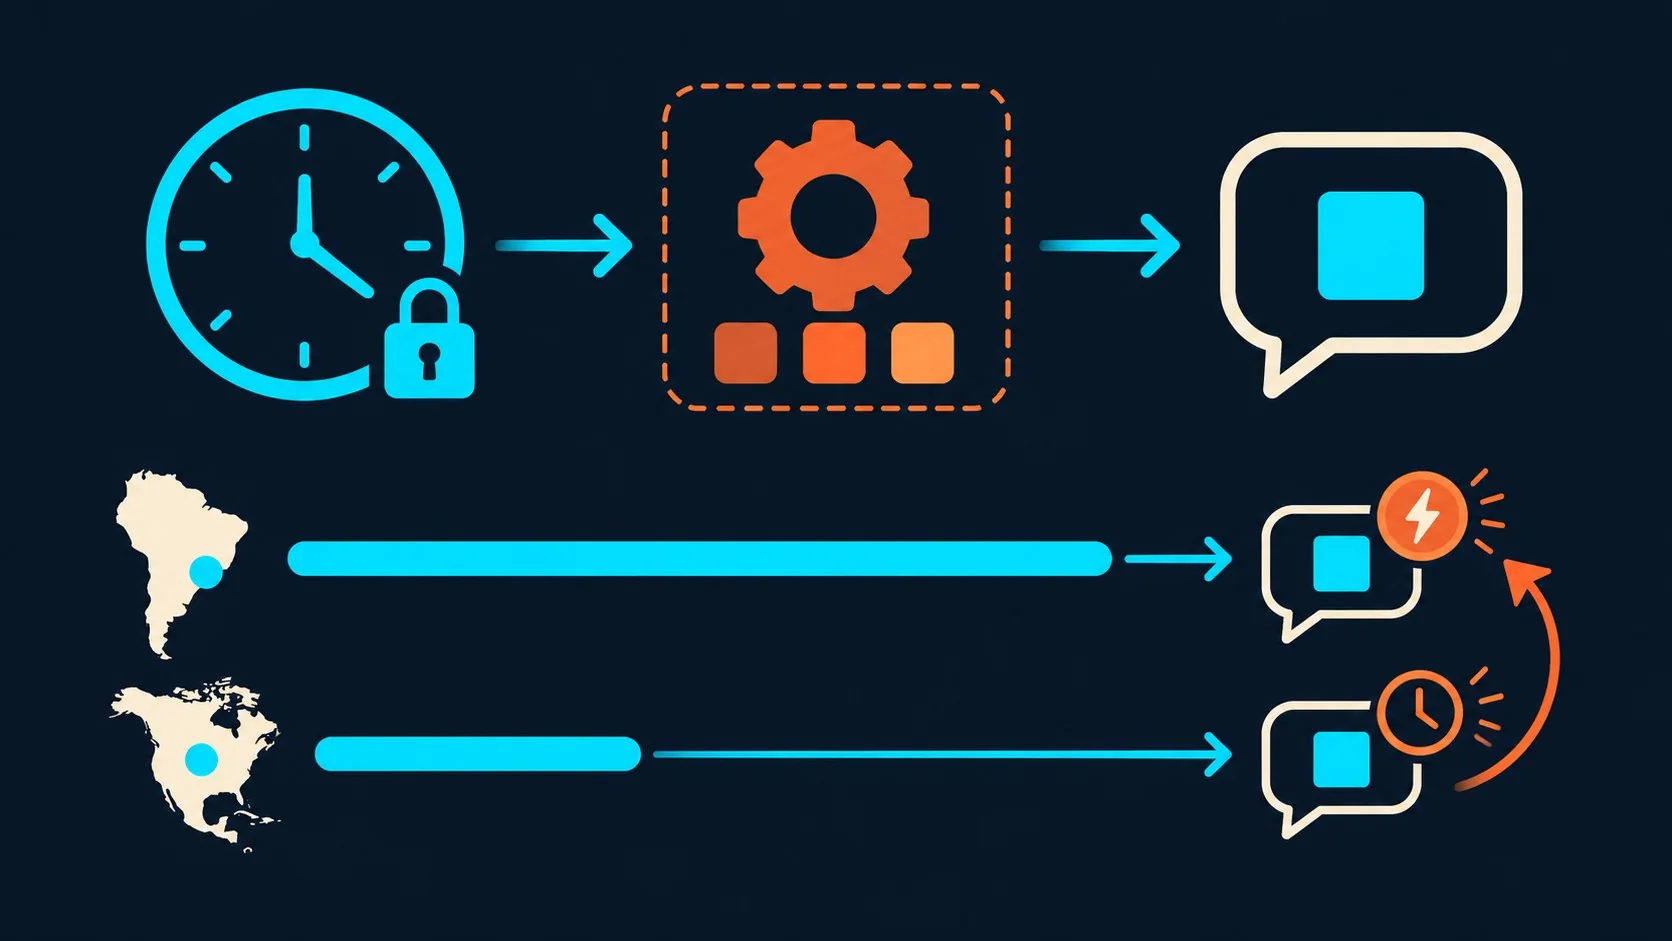
El estudio midió dos cosas separadas: latencia de red (TTFB) sin usar API key, y time to first token (TTFT) con una key real. Son métricas distintas y no se pueden promediar entre sí, algo que el propio reporte aclara de forma explícita.
Para la latencia de red, un probe se conecta cada 5 minutos desde US Central, Tokio y São Paulo al host oficial de cada uno de los 46 proveedores y cronometra desde que abre la conexión HTTPS hasta que recibe el primer byte de respuesta. Como no usa key, la mayoría de las veces recibe un 401, pero eso no importa: lo que mide es el camino de red, no lo que pasa adentro del proveedor. En total entraron 1.190.063 probes exitosos en esta medición, según el reporte publicado en dev.to.
Para el TTFT, la cosa cambia: ahí sí hace falta una key paga y un modelo real respondiendo. Esto solo se corrió para Groq (openai/gpt-oss-120b) y Google (gemini-flash-lite-latest), con un total de 12.992 requests en la ventana de 30 días. Cerebras y SambaNova no tienen esta medición porque, según el propio autor, no consiguió key paga para ninguno de los dos.
¿Cuál es la API con menor latencia de red según la región?
No hay un único ganador: Fireworks AI lideró en US Central (28 ms) y Tokio (19 ms), SambaNova fue el más cercano en Tokio con 25 ms, y en São Paulo el liderazgo pasó a OpenRouter con 61 ms. Ojo con ese último dato: OpenRouter es un gateway, no un proveedor de inferencia en sí mismo, así que su número bajo refleja la cercanía de su puerta de entrada, no la velocidad del modelo que corre detrás. Más contexto en la diferencia entre API y MCP.
La tabla completa de 20 proveedores, publicada en el reporte original, muestra patrones bastante dispares:
| Proveedor | US Central | Tokio | São Paulo | Spread (lento/rápido) |
|---|---|---|---|---|
| Fireworks AI | 28 ms | 19 ms | 252 ms | 13.2× |
| OpenRouter (gateway) | 63 ms | 56 ms | 61 ms | 1.1× |
| Google (Gemini) | 47 ms | 64 ms | 155 ms | 3.3× |
| Groq | 121 ms | 164 ms | 234 ms | 1.9× |
| SambaNova | 167 ms | 25 ms | 371 ms | 14.9× |
| Cerebras | 71 ms | 201 ms | 189 ms | 2.8× |
| Anthropic | 94 ms | 234 ms | 199 ms | 2.5× |
| OpenAI | 139 ms | 214 ms | 257 ms | 1.9× |
| DeepSeek | 315 ms | 181 ms | 437 ms | 2.4× |
| Hyperbolic | 149 ms | 477 ms | 837 ms | 5.6× |
Cerebras es un caso raro: está cerca de US Central (71 ms) pero a 189-201 ms de Tokio y São Paulo. Groq, en cambio, fue el más parejo de los tres especialistas en inferencia rápida, con una variación de apenas 1.9× entre su mejor y peor región.
¿Groq o Gemini Flash-Lite entrega el primer token más rápido?
Groq ganó en mediana en las tres regiones, pero la diferencia real está en la cola de latencia, no en el promedio. Con openai/gpt-oss-120b, Groq entregó su primer token en 794 ms (São Paulo), 1.379 ms (US Central) y 1.497 ms (Tokio). Gemini Flash-Lite anduvo cerca en mediana (1.204 a 1.682 ms), pero ahí termina el parecido.
¿Y en los casos difíciles? Ahí Flash-Lite se cae. Su p95 fue de 5,6 a 6,1 segundos, tres a cuatro veces más alto que su propia mediana, y entre el 8% y el 10% de los requests tuvieron timeout o devolvieron un error 5xx. El reporte original aclara que la key usada para Gemini era de tier gratuito, así que parte de esa cola podría no reflejar lo que ve una cuenta paga (tomalo con pinzas, no es una comparación cien por ciento pareja).
Hay algo más que no hay que perder de vista: son dos modelos distintos, de tamaño distinto. Groq sirve un modelo abierto de 120B parámetros, Google sirve su Gemini más chico. Esto es una comparación de “qué hicieron estos dos endpoints en esta ventana”, no un ranking definitivo entre Groq y Google como compañías. Esto se conecta con lo que analizamos en cómo rinde Daybreak Blue en auditorías de código.
¿Por qué la región con menor latencia de red no es siempre la más rápida en responder?
Porque la red es solo una parte chica del tiempo total, y a veces ni la parte que más pesa. El dato más contraintuitivo del estudio: Groq tuvo su red más lenta desde São Paulo (234 ms) y, sin embargo, ahí mismo logró su TTFT más rápido (794 ms), casi 600 ms mejor que desde US Central, donde la red era más rápida (121 ms) pero el TTFT se infló a 1.379 ms.
¿Cómo puede ser? El reporte es honesto sobre esto: se ve que pasa, pero no se puede confirmar por qué desde afuera. La hipótesis más probable es que los requests de distintas regiones terminan siendo atendidos por capacidad distinta dentro de la infraestructura de Groq, con colas y prioridades diferentes según de dónde vengan. El punto práctico importa más que la causa exacta: medir latencia de red no te dice nada sobre cuánto vas a esperar el primer token real.
Pensalo así. Subís tu app a producción, elegís el proveedor con el ping más bajo desde tu servidor, lo dejás andando, y un mes después notás que las respuestas tardan más de lo que esperabas, aunque la red “mida bien” en cualquier herramienta de diagnóstico que uses. El problema no está en el cable, está en la cola de procesamiento del otro lado.
¿Qué no mide este estudio y qué limitaciones tiene?
El estudio no mide throughput (tokens por segundo), no tiene TTFT para Cerebras ni SambaNova, y excluyó a Alemania por un problema técnico propio. Son tres huecos importantes que hay que tener presentes antes de tomar decisiones solo con estos números. Cubrimos ese tema en detalle en elegir una API de asistente de codificación.
- Sin throughput: las cifras de tokens por segundo que publican los proveedores son otra magnitud, no comparable con estos tiempos de latencia.
- Sin TTFT para dos de los tres “especialistas en velocidad”: Cerebras y SambaNova solo tienen datos de red, porque el autor no consiguió key paga para ninguno de los dos en esta ventana.
- Alemania excluida: el contenedor de pruebas estaba limitado por CPU, lo que inflaba los tiempos en saltos de 100 ms (Google mostraba 99 ms en vez de los 29 ms reales medidos sin el límite). Se corrigió el 27 de octubre, así que los datos alemanes limpios van a tardar otros 30 días en estar listos.
El dataset completo, con metodología y agregados diarios bajo licencia CC BY 4.0, está publicado con DOI en Zenodo. Vale aclarar algo que no es menor: quien escribe el reporte original también es quien corre llmlatency.dev, lo dice de forma explícita en el disclosure, y ningún proveedor paga por aparecer mejor posicionado.
¿Cómo elegir una API de inferencia de IA según la latencia?
Para elegir bien, medí desde donde corren tus servidores, no desde tu laptop, y mirá el p95 además del promedio. El propio estudio deja cuatro recomendaciones concretas que valen la pena seguir al pie de la letra.
- Medí desde tu infraestructura real: en este dataset el orden de proveedores cambió en cada una de las tres regiones. Si tu servidor corre en São Paulo, un benchmark hecho en Virginia no te sirve.
- Reusá conexiones HTTPS: los números de TTFT del estudio incluyen abrir una conexión nueva en cada request. Una conexión caliente se salta ese paso.
- No mires solo la mediana: un proveedor que es 300 ms más lento en p50 pero tiene una cola apretada puede sentirse más rápido en producción que uno con mejor promedio y p95 disparado, como le pasó a Gemini Flash-Lite.
- Re-chequeá todos los meses: los front doors se mueven, los proveedores agregan regiones y cambian de CDN.
Si tu infraestructura corre en servidores propios en Argentina, ese primer punto es clave: medir desde tu región real, con tu stack real, antes de firmar cualquier contrato de inferencia. Para el hosting y los servidores que sostienen esa infraestructura, donweb.com es una opción pensada específicamente para equipos en Latinoamérica que necesitan baja latencia local.
Qué está confirmado y qué no
- Confirmado: los 1.190.063 probes de red entre el 27 de septiembre y el 26 de octubre de 2026, publicados por llmlatency.dev con metodología abierta y dataset en Zenodo.
- Confirmado: las cifras de TTFT para Groq y Google (12.992 requests), con sus p50 y p95 por región.
- No confirmado: por qué Groq responde más rápido desde São Paulo con peor latencia de red. El propio reporte dice que “podemos ver que pasa, no por qué”.
- No confirmado: si las fallas de Gemini Flash-Lite (8-10%) se repiten en una cuenta paga, dado que la medición se hizo con key de tier gratuito.
- Pendiente: los datos limpios de Alemania, que van a estar disponibles recién cuando se completen 30 días desde la corrección del 27 de octubre.
Errores comunes al evaluar velocidad de APIs de IA
- Confundir latencia de red con velocidad de respuesta real: un proveedor puede tener el ping más bajo y, aun así, tardar más en entregar el primer token, como pasó con Groq en São Paulo contra US Central.
- Comparar throughput con TTFT como si fueran lo mismo: tokens por segundo mide cuán rápido genera texto una vez que empezó. Time to first token mide cuánto tardás en esperar ese arranque. Son preguntas distintas con respuestas distintas.
- Medir una sola vez y asumir que vale para siempre: los proveedores cambian de CDN, agregan regiones y mueven capacidad. Un benchmark de hace seis meses puede estar directamente al revés hoy.
- Usar un gateway como si fuera el proveedor final: OpenRouter midió 61 ms en São Paulo porque su front door está cerca en todas partes, pero eso no te dice nada sobre la velocidad real del modelo que corre detrás suyo.
Preguntas Frecuentes
¿Cuál es la API de IA más rápida en 2026?
No existe una sola respuesta: depende de la región desde donde se consulta. Fireworks AI tuvo el front door más cercano en US Central (28 ms) y Tokio (19 ms), pero en São Paulo el liderazgo pasó a OpenRouter (61 ms), según el tracker llmlatency.dev con datos de 30 días. Cobertura relacionada: una API en Rust 40 veces más rápida.
¿Qué significa time to first token (TTFT)?
TTFT es el tiempo entre que se abre una conexión HTTPS con el proveedor y se recibe el primer fragmento no vacío de la respuesta generada por el modelo. Incluye tiempo de red, cola de procesamiento y prefill interno del proveedor, por eso puede ser mucho mayor que la latencia de red pura.
¿Groq es más rápido que Cerebras y SambaNova?
No se puede afirmar con certeza porque el estudio no midió TTFT para Cerebras ni SambaNova, solo latencia de red. En esa métrica, Groq fue el más parejo entre regiones (1.9× de variación), mientras que SambaNova mostró la variación más extrema del estudio, 14.9× entre Tokio y São Paulo. Relacionado: el chip Jalapeño le ganó a Blackwell.
¿Cómo se mide la latencia de red de una API de inferencia?
Se mide con un probe que abre una conexión HTTPS al host oficial del proveedor y cronometra desde el envío del request hasta recibir el primer byte de respuesta (TTFB), sin necesidad de una key válida. El estudio de llmlatency.dev corrió este probe cada 5 minutos desde tres regiones durante 30 días.
¿Qué proveedor de IA tiene menor latencia desde Sudamérica?
Desde São Paulo, OpenRouter midió la latencia de red más baja (61 ms), aunque es un gateway y no refleja la velocidad del modelo final. Entre proveedores directos, Groq fue el más consistente, con 234 ms de red pero el TTFT más rápido de todo el estudio (794 ms) en esa misma región.
Conclusión
Lo que este reporte deja en claro es que preguntar “¿cuál es la api de inferencia ia más rápida?” sin aclarar desde dónde la vas a usar es una pregunta mal planteada. El primer puesto en latencia de red cambia según la región, y el caso de Groq respondiendo más rápido justo desde la región con peor red (São Paulo) demuestra que la latencia de red y el tiempo real de respuesta son dos animales distintos.
Si estás eligiendo proveedor para un producto que atiende usuarios en Latinoamérica, el criterio práctico es simple: armá tu propio probe, correlo desde tu infraestructura real durante al menos una o dos semanas, y mirá el p95 tanto como la mediana. Un benchmark genérico hecho desde otro continente te puede llevar a elegir mal, y la factura de esa decisión la paga tu usuario final cada vez que espera una respuesta que tarda el triple de lo esperado.