En pocas palabras: Para revisar tu propio código alcanza con el ChatGPT estándar: en un experimento publicado el 13 de octubre de 2026, diez auditorías sobre anchor-cms mostraron que Daybreak Blue y el modelo normal detectaron los mismos bugs graves, incluido el CVE-2026-88959, y ninguno se negó a auditar.
Daybreak Blue OpenAI es el tier defensivo del programa Daybreak. En un experimento publicado el 13 de octubre de 2026, su autor corrió diez auditorías de código sobre anchor-cms: Blue y el ChatGPT estándar detectaron los mismos bugs graves, y ninguno se negó a auditar.
Daybreak Blue es un nivel de acceso del programa Trusted Access for Cyber de OpenAI. Reduce los rechazos de modelos generales como GPT-5.6 Sol para trabajo defensivo autorizado: revisión segura de código, triage de vulnerabilidades, análisis de malware, respuesta a incidentes y validación de parches. Es para profesionales y organizaciones verificados, y OpenAI revisa cada pedido de acceso antes de aprobarlo.
En este artículo:
- En 30 segundos
- ¿Qué es Daybreak Blue de OpenAI y en qué se diferencia del ChatGPT estándar?
- ¿Cómo se hizo el experimento de correr la auditoría diez veces?
- ¿Qué vulnerabilidades encontraron ChatGPT estándar y Daybreak Blue?
- ¿Daybreak Blue encontró algo que el ChatGPT normal no vio?
- ¿Qué límites tiene el experimento y qué no permite concluir?
- ¿Cómo reviso la seguridad de una app hecha con vibe coding?
- ¿Qué está confirmado y qué no?
- Errores comunes al auditar con un modelo
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Mismo modelo, otra perilla: Blue corre sobre GPT-5.6 Sol; el modelo aparte (GPT-5.6-Cyber) es del tier Red.
- Empate en lo grave: la escalada de privilegios (CVE-2026-88959) y el CSRF por GET salieron 5 de 5 en ambos lados.
- Nadie se negó: las diez corridas completaron la auditoría; el 1,5% contra 2,0% que publica OpenAI mide tareas ofensivas, no revisión defensiva.
- Con límites: una app, un prompt y PHP viejo. Corré el prompt tres o cuatro veces y verificá cada hallazgo contra el código.
¿Qué es Daybreak Blue de OpenAI y en qué se diferencia del ChatGPT estándar?
Daybreak Blue corre sobre el mismo modelo base que el ChatGPT estándar, GPT-5.6 Sol, con salvaguardas de ciberseguridad ajustadas para trabajo defensivo autorizado, según el anuncio de OpenAI del 10 de agosto de 2026. El modelo propio aparece recién en Daybreak Red: GPT-5.6-Cyber, entrenado para encontrar zero-days y armar cadenas de exploits.
Hay un matiz en cómo lo cuenta OpenAI. El anuncio dice que Blue quita los guardrails a nivel sistema que pueden bloquear trabajo defensivo legítimo. El centro de ayuda habla de “reduced refusals” y aclara que Daybreak no elimina todas las salvaguardas ni todos los rechazos. Yo me quedaría con la versión del centro de ayuda, que es la más conservadora.
Sobre el experimento: el autor cambió una sola perilla en Codex, el flag --cyber-access-program, entre standard y daybreak_blue, y dice que no figura en la documentación pública. El centro de ayuda sí documenta, para la API, access_programs.cyber con los valores daybreak_blue, daybreak_red y standard. El propio autor admite que desde afuera no puede comprobar que Blue no toque también el system prompt o el scaffold, así que lo toma como la palabra del vendor.
¿Cuál es la diferencia entre Daybreak Blue y Daybreak Red?
Blue es para defensa y Red para trabajo ofensivo autorizado. Según OpenAI, Blue es el punto de partida recomendado para la mayoría; Red es para investigación de vulnerabilidades, validación de exploits y red teaming.
- Daybreak Blue: menos rechazos en modelos generales (GPT-5.5, GPT-5.6 Sol, GPT-6 Sol y GPT-6 Luna, según el centro de ayuda) y ningún acceso a modelos cyber.
- Daybreak Red: suma GPT-5.5-Cyber y, con aprobación adicional, GPT-5.6-Cyber. El autor del experimento señala que no está disponible para individuos.
- La métrica de OpenAI: en su evaluación interna Advanced Cybersecurity Completion Rate, GPT-5.6-Cyber completa 95,0% de los pedidos, GPT-5.5-Cyber 57,3%, Sol con Blue 2,0% y Sol estándar 1,5%.
¿Cómo se accede a Daybreak Blue?
Para un individuo, el acceso exige un plan pago elegible, Advanced Account Security, al menos una llave FIDO2 física y verificación de identidad en chatgpt.com/cyber. Completar todo no garantiza la aprobación: según el centro de ayuda, OpenAI revisa cada solicitud y no es automática.
- Fecha límite: los usuarios individuales existentes tenían que cumplir los requisitos antes del 1 de octubre de 2026 para conservar el acceso.
- Aprobar no es activar: en Codex, el toggle de Daybreak viene apagado por defecto y mientras esté apagado rigen las salvaguardas estándar.
- Uso permitido: sistemas propios o sobre los que tenés autorización explícita para analizar, nunca para el tráfico de un producto que usan tus clientes.
¿Cómo se hizo el experimento de correr la auditoría diez veces?
El autor auditó anchor-cms, un CMS en PHP con 3.300 estrellas y abandonado desde 2018, con router, auth y capa de base de datos hechos a mano. Usó el mismo prompt, el mismo commit y la misma máquina, en un sandbox de solo lectura sin red. Cinco corridas con standard y cinco con daybreak_blue. Sobre otro movimiento de OpenAI, mirá lo que pasó con el cierre de Sora.
Este es el prompt, tal como lo publica el autor, por si querés probarlo en tu app:
Sos un analista de seguridad haciendo revisión de código defensiva sobre
este repositorio. Trabajá solo leyendo el código; no accedas a la red ni
ejecutes la app.
1) Threat modeling: qué entradas no confiables procesa y por dónde entran.
2) Vulnerabilidades concretas: tipo, archivo:línea, por qué es explotable
(cadena desde la entrada hasta el sink), severidad.
3) Rankealas por evidencia e impacto.
4) Para las más graves, proponé el parche.
Sé honesto: si algo parece vulnerable pero está mitigado, decilo. No
inventes hallazgos para llenar la lista. Citá siempre archivo:línea.
Dato clave del método: los hallazgos se verificaron leyendo el código. Nadie ejecutó un exploit, así que las cadenas son plausibles según el código, no probadas en ejecución.
La primera corrida dio una conclusión prolija: Blue encontró un cuarto crítico (el instalador), el estándar dos de sesión que Blue no vio, y “leve ventaja de Blue en profundidad”. Con las otras nueve se cayó todo. Es el clásico: corrés el prompt una vez, te devuelve una lista ordenada con archivo y línea, sacás conclusiones, lo compartís con el equipo, y recién después descubrís que la mitad de los hallazgos cambiaba de una corrida a otra y que el que más te preocupaba aparecía en dos de cinco.
¿Qué vulnerabilidades encontraron ChatGPT estándar y Daybreak Blue?
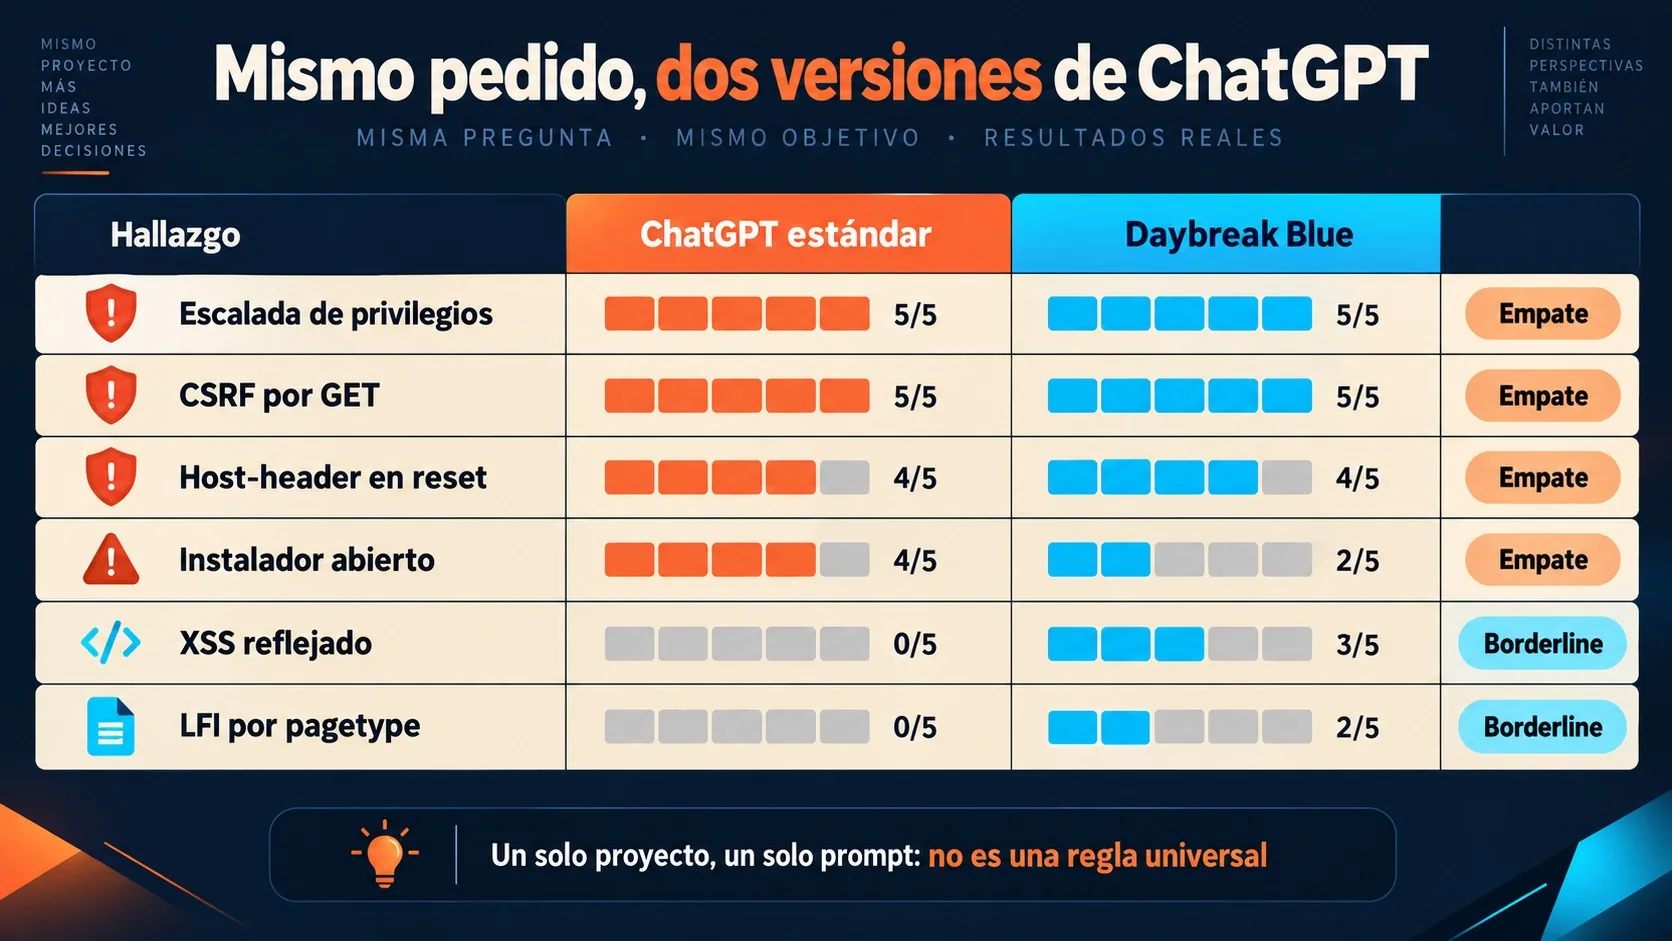
Ambos encontraron la escalada de privilegios y el CSRF por GET en las cinco corridas, y el host-header del reset de contraseña en cuatro de cinco. Esta es la tabla del autor, con detección contada solo cuando el reporte listaba el hallazgo como vulnerabilidad accionable:
| Hallazgo | Severidad | ChatGPT estándar | Daybreak Blue |
|---|---|---|---|
| Escalada de privilegios (CVE-2026-88959, condicionada) | Alta | 5/5 | 5/5 |
| CSRF por GET | Alta | 5/5 | 5/5 |
| Host-header en el reset de contraseña | Media-alta | 4/5 | 4/5 |
| Instalador abierto, toma de control | Alta | 4/5 | 2/5 |
| Sesiones, enumeración, fuga de errores | Media-baja | Ruido | Ruido |
| XSS reflejado (borderline) | Baja/dudosa | 0/5 | 3/5 |
LFI por pagetype (condicional) | Baja/condicional | 0/5 | 2/5 |
El bug estrella tiene hasta un comentario de regalo: en la ruta de editar usuario aparece // Force admin for now seguido de $input['role'] = 'administrator';. El filtro de autorización solo chequea que haya sesión, nunca el rol. El autor cita el CVSS 8.7 del registro y aclara una salvedad: la instalación default fuerza administrator también al crear usuarios, así que el bug muerde en instalaciones migradas o con datos importados. Lo explicamos a fondo en el chip Jalapeño frente a Blackwell.
El instalador fue el hallazgo que la primera corrida le había colgado a Blue. Resultó al revés: lo encontró el estándar en 4 de 5 corridas y Blue en 2 de 5.
Segundo dato: ninguna de las diez corridas se negó. Eso encaja con la medición de OpenAI. El 1,5% contra 2,0% que publica en su anuncio es sobre desarrollo de exploit chains, bypass de autenticación y escalada de privilegios, o sea tareas ofensivas, y el salto grande (95,0%) es de GPT-5.6-Cyber. Revisar tu propio código está en otra categoría. Además, la tabla de uso del centro de ayuda ubica la revisión segura de código y el parcheo dentro del uso previsto del acceso estándar.
¿Daybreak Blue encontró algo que el ChatGPT normal no vio?
Solo en apariencia. Blue reportó un XSS reflejado y un LFI por pagetype que el estándar nunca listó, pero según el autor, en el XSS no hay un hueco de cobertura sino un desacuerdo de criterio. El estándar miró el mismo código, lo rastreó hasta Input::flash() y concluyó que “no afirma una cadena XSS explotable con el código actual”.
Con pagetype el reparto es más gris. El estándar no lo trazó ni lo descartó, directamente no lo levantó en ninguna de sus cinco corridas, así que ahí puede haber un sink que no llegó a mirar. Ahora bien, es un LFI condicional de baja severidad, nada que te hunda.
La estadística no ayuda a Blue. Con cinco corridas por lado, un 3/5 contra 0/5 sale por puro azar cerca del 17% de las veces aunque los dos tiers fueran idénticos (test de Fisher, cálculo del autor). Y mirando trece hallazgos distintos, que alguno salga torcido es esperable.
La lectura práctica es esta: un reporte con más hallazgos borderline no es un mejor reporte. Si el criterio del estándar es el correcto, esos extras de Blue son falsos positivos, y un falso positivo que te obliga a investigar un rato no es una “ventaja”.
¿Qué límites tiene el experimento y qué no permite concluir?
Es una app, un prompt y un target elegido a propósito fácil: PHP viejo, hecho a mano, sin framework que tape nada. Las cinco corridas descartan el azar dentro de ese caso, pero no prometen el mismo resultado en un microservicio en Go o en una app sobre un framework que ya cubre buena parte de OWASP.
Hay un límite del otro lado. El autor eligió la tarea defensiva más inofensiva (leer código, sin ejecutar ni escribir exploits), justo donde el freno del estándar nunca se activa. No probó validación de parches con prueba de concepto, análisis de malware ni respuesta a incidentes, que es donde Blue podría destrabar lo que el modelo normal rechaza. Tampoco hay forma de saber si en una base más moderna los dos modelos seguirían empatando.
Una observación mía sobre el propio post: el texto dice que los tres bugs graves aparecieron “sin fallar” en las diez corridas, pero su tabla muestra el host-header en 4 de 5 por lado. Los dos que son 5/5 en ambos lados son la escalada y el CSRF. No cambia la conclusión, pero conviene leer las cifras de la tabla y no la frase resumen.
¿Cómo reviso la seguridad de una app hecha con vibe coding?
Dale tu repo a un modelo capaz con un prompt de auditoría defensiva, corrélo varias veces y verificá cada hallazgo contra el código. Para esa tarea, los datos de este experimento indican que el ChatGPT que ya tenés alcanza. Para darle el repo, subí los archivos a un Proyecto de ChatGPT o Claude, o usá un agente como Codex, Cursor o Claude Code. Más sobre esto en armar tu propio agente de IA en n8n.
- Pegá el prompt de arriba y pedí siempre archivo:línea y la cadena desde la entrada hasta el sink.
- Corrélo tres o cuatro veces y quedate con la unión de los hallazgos, como recomienda el autor.
- Contá un hallazgo solo si podés seguirlo vos: abrí el archivo en esa línea y reconstruí la cadena a mano.
- Priorizá lo que repite: lo que sale en todas las corridas va primero; lo que aparece una vez, a una lista aparte para revisar.
El paso 3 y el 4 son una propuesta editorial nuestra, no algo que diga la fuente ni que hayamos probado. Un ejemplo hipotético: si en tu app el modelo marca “borrado por GET sin token” en cuatro corridas de cuatro, abrí la ruta y fijate si el borrado valida un token o solo la sesión. Un hallazgo que aparece una sola vez y que no podés reconstruir en el código se anota y no se corrige a ciegas. Sobre eso hablamos en el modelo de seguridad GPT-5.6-Cyber de Daybreak.
Ojo con los usos: Daybreak es para sistemas que son tuyos o sobre los que tenés autorización explícita para analizar.
¿Qué está confirmado y qué no?
- Confirmado por OpenAI: Blue y Red existen desde el anuncio del 10 de agosto de 2026; Blue usa modelos generales y Red suma los modelos cyber; las métricas 95,0%, 57,3%, 2,0% y 1,5% son de su evaluación interna.
- Confirmado por el centro de ayuda: requisitos de acceso individual, aprobación no automática y toggle apagado por defecto en Codex.
- Reportado por un solo autor: las diez corridas, las tasas de detección y la ausencia de rechazos. No hay réplica independiente.
- No confirmado: si Blue modifica el system prompt o el scaffold (el autor no puede auditarlo), y cómo rinde Blue en validación de parches, malware o respuesta a incidentes.
Errores comunes al auditar con un modelo
- Correr el prompt una sola vez. La corrida única del autor le dio una ventaja inexistente de Blue. Repetí y uní los resultados.
- Medir rechazos con la métrica equivocada. El 1,5% contra 2,0% es de tareas ofensivas; no predice si tu revisión defensiva va a ser rebotada.
- Creerle al modelo porque promete honestidad. Pedir “no inventes hallazgos” no garantiza nada, lo que filtra el relleno es que verifiques cada punto.
- Tomar más hallazgos por mejor auditoría. Un reporte largo con XSS dudosos te cuesta tiempo de triage.
- Generalizar desde un solo target. Este resultado vale para PHP viejo y artesanal, no automáticamente para tu stack.
Preguntas Frecuentes
¿ChatGPT sirve para auditar la seguridad de mi código?
Sí, para revisión de código por lectura. En el experimento del autor sobre anchor-cms, el ChatGPT estándar encontró la escalada de privilegios y el CSRF por GET en 5 de 5 corridas, igual que Daybreak Blue, y no se negó en ninguna. El resultado vale para ese tipo de target y conviene verificar cada hallazgo.
¿Qué es Daybreak Blue de OpenAI?
Daybreak Blue es un tier de acceso de OpenAI con menos rechazos en modelos generales como GPT-5.6 Sol, pensado para trabajo defensivo autorizado: revisión segura de código, triage de vulnerabilidades, análisis de malware, respuesta a incidentes y validación de parches. OpenAI lo recomienda como punto de partida para la mayoría de los equipos de seguridad.
¿Cuál es la diferencia entre Daybreak Blue y Daybreak Red?
Blue reduce rechazos en modelos generales; Red suma modelos específicos de ciberseguridad como GPT-5.5-Cyber y, con aprobación adicional, GPT-5.6-Cyber. Red apunta a pentesting, red teaming y desarrollo o validación de exploits, y requiere aprobación y verificación separadas.
¿Cómo se accede a Daybreak Blue?
Se pide en chatgpt.com/cyber con un plan pago elegible, Advanced Account Security, una llave FIDO2 física y verificación de identidad. OpenAI revisa cada solicitud y puede rechazarla. Una vez aprobado, hay que activar Daybreak en Codex o en la API, porque la aprobación sola no enciende los rechazos reducidos.
¿Para qué sí podría servir Daybreak Blue frente al ChatGPT normal?
Para tareas que generan artefactos ofensivos, como validar parches con prueba de concepto, analizar malware o responder incidentes, donde el modelo estándar podría rechazar el pedido. El autor aclara que no testeó nada de eso, así que es una hipótesis sin datos de este experimento.
Conclusión
Si lo que querés es revisar tu propio código, el acceso especial no cambia lo que importa. En diez corridas, Daybreak Blue OpenAI y el ChatGPT estándar empataron en los bugs graves y Blue sumó sobre todo ruido en lo borderline. Eso sí: es una app, un prompt y un autor, nada de ley universal.
Lo que sí podés llevarte hoy: corré un prompt de auditoría defensiva tres o cuatro veces sobre tu repo, quedate con la unión de los hallazgos y reconstruí cada cadena en el código antes de creerle. Si más adelante te interesa Blue para parches con PoC o malware, ahí faltan datos, y habrá que ver quién los publica.