En pocas palabras: Según sus autores, el ahorro de tokens de dsh-phocinae, plugin local para DeepSeek Harness, depende del umbral τ: sobre 400 casos, con τ=0,4 fue de 86,1% y con τ=0,6, el valor por defecto, cayó a 8,5%, porque escalaron 363 de 400 casos (90,8%).
El ahorro de tokens de dsh-phocinae, el plugin local para DeepSeek Harness, fue de 86,1% con τ=0,4 y de 8,5% con τ=0,6 sobre los mismos 400 casos, según la medición de sus propios autores publicada el 13 de octubre de 2026. El umbral cambia todo.
dsh-phocinae es un plugin local de decisiones para DeepSeek Harness (dsh). Tiene dos herramientas, phocinae_ask y phocinae_gate, respaldadas por Phocinae-Largha-150M-v1, un modelo chico que responde preguntas tipadas (sí/no, elección única, puntajes de 2 a 10) en un solo forward pass, sin generar texto. Cuando la confianza es baja, marca la respuesta con una señal escalate para que quien llama decida si consulta a un modelo hosted.
En este artículo:
- En 30 segundos
- ¿Qué es dsh-phocinae y cómo decide cuándo escalar a DeepSeek?
- ¿Cómo se mide el ahorro de tokens en un pipeline de agentes?
- ¿Qué es el umbral τ en un modelo local que escala a uno hosted?
- ¿Qué ahorro de tokens dio cada umbral: 86,1% con τ=0,4 y 8,5% con τ=0,6?
- ¿Qué está confirmado y qué falta por verificar?
- ¿Cómo repetir la medición con tu propio tráfico?
- Errores comunes al medir ahorro de tokens
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Con τ=0,4 escalaron 27 de 400 casos (6,8%) y el ahorro fue de 86,1% con la huella del plugin incluida.
- Con τ=0,6, el default del plugin, escalaron 363 de 400 casos (90,8%) y el ahorro cayó a 8,5%.
- La huella fija es de 685 tokens por request (473 de phocinae_ask y 212 de phocinae_gate), más 234 por decisión.
- Los números son autorreportados, sobre un banco de 400 casos y no sobre sesiones reales de agente.
¿Qué es dsh-phocinae y cómo decide cuándo escalar a DeepSeek?
El modelo local responde cada pregunta con una confianza calibrada y una bandera escalate de carácter consultivo. El plugin no llama a ningún modelo grande por vos: produce la señal y vos decidís qué hacer con ella, como aclara el repositorio del plugin. Además, el gate de aprobación corre como hook previo a la ejecución de cada herramienta.
La medición usa el conjunto publicado de decisiones tipadas: 400 casos, cada uno con un estado y cinco preguntas, o sea 2.000 decisiones. El modelo local (CPU, fp32) se compara contra deepseek-flash a temperatura 0. El snapshot es del plugin 0.2.1, con fecha 2026-10-08.
Ojo con un detalle: el README del repo ya está en la versión 0.2.5, que cerró dos agujeros de la lista de auto-allow. La medición de tokens se hizo con la 0.2.1.
¿Cómo se mide el ahorro de tokens en un pipeline de agentes?
Hay que contar en tres lugares distintos, porque no existe un medidor único. Los autores miden por request, por decisión y por caso, y todo ahorro se expresa en tokens facturados del modelo hosted que dejaron de enviarse. Cubrimos ese tema en detalle en nuestra comparativa entre Google y DeepSeek.
- Por request (parte fija): las dos definiciones de herramientas viajan en cada pedido. Son 473 tokens de phocinae_ask más 212 de phocinae_gate, 685 en total, contados con el tokenizer del proveedor.
- Por decisión (ida y vuelta): 99 tokens de argumentos más 135 de resultado renderizado dan 234. La primera decisión de una sesión suma además los 685 fijos, o sea 919.
- Por caso (lo que llama al modelo hosted): los contadores usage de la API sumaron 1.222.211 tokens en las 400 corridas (290.606 de entrada y 931.605 de salida), es decir 3.055,5 por caso.
El gate es la excepción: corre como hook y suma cero tokens a la conversación, aunque sí consuma tiempo de reloj.
Acá viene lo que más confunde. Cuando escala, el modelo hosted recibe el caso entero, y si una sola de las cinco decisiones es dudosa, se vuelve a responder todo. Contar “decisiones que quedaron locales” y contar “casos que nunca tocaron la API” da dos porcentajes distintos para la misma corrida.
Ejemplo hipotético, solo aritmética: en una sesión de 10 requests con el plugin cargado, las definiciones solas suman 6.850 tokens (685 × 10), antes de contar una sola decisión.
¿Qué es el umbral τ en un modelo local que escala a uno hosted?
τ es el nivel de confianza por debajo del cual el modelo local marca una respuesta como dudosa y levanta la señal de escalar. Lo elige quien llama, no el plugin. No es un umbral de similitud ni tiene que ver con compresión de contexto: es un corte sobre la confianza de cada respuesta. Profundizamos en esto en nuestra comparativa entre OpenAI y DeepSeek.
Los autores lo resumen así (traducción nuestra): un reclamo de ahorro sin τ es media oración. Tienen razón, y el 86,1% frente al 8,5% lo demuestra.
¿Qué ahorro de tokens dio cada umbral: 86,1% con τ=0,4 y 8,5% con τ=0,6?
Con τ=0,4 el ahorro fue de 86,1% y con τ=0,6 fue de 8,5%, ambos con la huella del plugin incluida y contados en tokens facturados a nivel de caso. Estas son las filas completas según el post de los autores:
| Configuración | Casos escalados | Tokens facturados | Ahorro | Accuracy |
|---|---|---|---|---|
| Solo hosted (deepseek-flash) | 400 de 400 | 1.222.211 | 0% | 0,7085 |
| Híbrido τ=0,4 | 27 (6,8%) | 82.499 | 86,1% con huella | 0,7305 |
| Híbrido τ=0,6 (default) | 363 (90,8%) | no informado | 9,2% solo modelo, 8,5% con huella | 0,7115 |
| Solo local | 0 | 0 facturados | no aplica | 0,7320 |
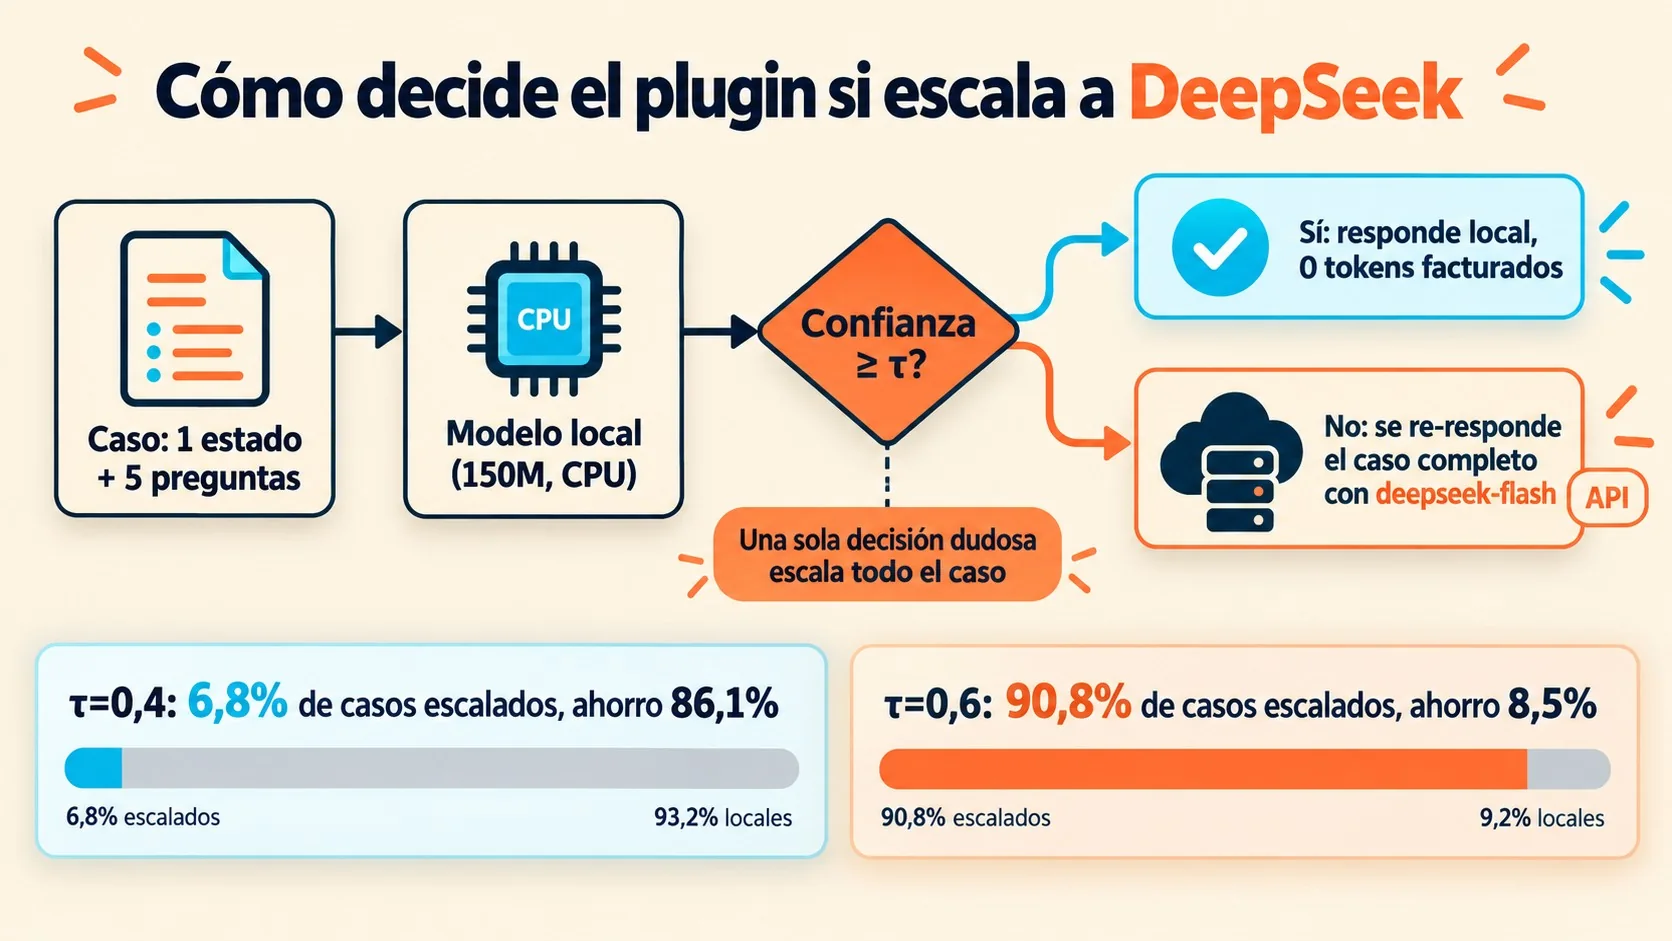
Por qué 0,6 escala tanto: la mediana de confianza es 0,6294 y 851 de las 2.000 decisiones (42,6%) quedan debajo de 0,6. Como una sola decisión dudosa arrastra al caso entero, eso termina en 90,8% de casos escalados. Un umbral que suena “conservador” acá es casi una renuncia al modelo local.
Sobre accuracy, los autores reportan que en este banco el escalamiento fue casi neutro con τ=0,4 y empeoró con 0,6. El hosted rindió peor en las preguntas de tipo choice: 0,6793 contra 0,7529 del local, sobre 1.400 preguntas.
El camino local puro, sin escalar nada, ahorra 69,9% con una decisión, 90,1% con diez y 92,3% con mil. Se estanca cerca de 92% porque las definiciones y los viajes de ida y vuelta quedan en el contexto sin importar cuánto crezca la sesión. Complementá con el cobro de Copilot por tokens.
En plata, con precios publicados de USD 0,28 por millón de tokens de entrada y USD 1,10 por millón de salida, la corrida de 400 casos cuesta USD 1,1061 solo con el hosted y USD 0,0747 con τ=0,4.
Tomalo con pinzas, porque el README del repo muestra otra lectura del mismo umbral. Con la evaluación de la publicación del modelo, τ=0,6 escala 45,0% y recorta 55,0% de las llamadas al LLM, con accuracy local de 0,906 (versión de referencia v1.1, 2026-10-09). Los autores del post aclaran que sus accuracies salen del renderizado de este protocolo y no son comparables con las de la ficha del modelo. Lo que no queda claro es cómo se concilian los porcentajes de escalamiento entre ambos documentos.
¿Qué está confirmado y qué falta por verificar?
Está confirmado lo que los autores publicaron con scripts y resultados crudos en el repositorio. Falta todo lo que dependa de sesiones reales o de terceros que repitan la corrida. Según mi lectura, nadie lo reprodujo de forma independiente todavía.
Confirmado por los autores:
- Huella fija: 685 tokens por request y 234 por decisión, contados con el tokenizer del proveedor.
- Filas de τ: 86,1% con 0,4 y 8,5% con 0,6 sobre 400 casos, con resultados guardados en bench/results/.
- Latencia en CPU fp32, una máquina: 42,6 ms por decisión local, unos 21 ms de media en el gate y 0,02 ms para un comando en la allow-list.
Pendiente o no confirmado:
- Sesiones reales de agente: el banco son 400 casos legibles por máquina. Los autores deben un experimento con más de 30 tareas, con el plugin activado y desactivado.
- Latencia en GPU: el p50 de 21,0 ms en una RTX 5090 es la cifra publicada con el modelo, no una medición de ellos.
- Portabilidad de τ: 0,4 sale de la distribución de confianza de este banco y no es una constante.
Son números de quien hizo el plugin, y conviene leerlos así.
¿Cómo repetir la medición con tu propio tráfico?
Levantás el modelo local, corrés el script de ahorro apuntando a tus filas y a tu par de modelos, y barrés τ. Todo está en bench/ dentro del repositorio, y el modelo (Apache-2.0) está en Hugging Face.
- Servidor local: python -m phocinae.main.
- Ahorro de tokens: node bench/token-savings.mjs –rows 400 –dataset ./tus_filas.jsonl –model <modelo-hosted>.
- Huella del plugin: node bench/context-cost.mjs.
- Amortización e híbridos: node bench/economics.mjs.
- Gate solo: node bench/gate-by-mode.mjs, con bench/cases.json (53 comandos anotados) reemplazado por tu tráfico.
Barré τ en 0,3, 0,4, 0,5 y 0,6 y mirá accuracy al lado del ahorro: en este banco, subir τ dio menos ahorro y peor accuracy. Lo explicamos a fondo en velocidad de tokens por segundo en Blackwell.
Propuesta editorial, no atribuida a los autores ni probada por nosotros: guardá por caso cuántas decisiones escalaron y cuántos tokens facturó la API, y antes de comparar dos porcentajes chequeá que usen el mismo contador, la misma unidad y el mismo τ.
Errores comunes al medir ahorro de tokens
- Citar un porcentaje sin τ. Con los mismos 400 casos hay 86,1% y 8,5%. Corrección: escribí siempre contador, unidad y umbral.
- Mezclar decisiones con casos. Si una de cinco decisiones es dudosa, el caso entero va al hosted. Corrección: decidí si medís decisiones ruteadas o tokens facturados.
- Olvidar los 685 tokens fijos. Por eso el camino local puro se estanca cerca de 92%. Corrección: sumalos en cada request.
- Dejar el default sin barrer. Con τ=0,6 escaló 90,8% de los casos en este banco. Corrección: hacé el barrido sobre tu tráfico.
- Instalar mal el plugin. Según el README, npm i dsh-phocinae no lo monta en ningún perfil, y un add sin versión puede resolver a la 0.1.2, que no funciona. Corrección: dsh plugin –profile <nombre> add [email protected].
Preguntas Frecuentes
¿Cuántos tokens agrega dsh-phocinae a cada request?
Agrega 685 tokens por request: 473 de la definición de phocinae_ask y 212 de phocinae_gate, contados con el tokenizer del proveedor. Cada decisión local suma además 234 tokens (99 de argumentos y 135 de resultado). El gate no suma tokens a la conversación.
¿Por qué τ=0,6 ahorra tan poco en este banco?
Porque la mediana de confianza es 0,6294 y 42,6% de las decisiones quedan debajo de 0,6. Como una decisión dudosa escala el caso completo, terminan escalando 363 de 400 casos (90,8%). El ahorro resultante es de 8,5% con la huella del plugin.
¿Sirve el 86,1% como promesa para mi agente?
No, es el resultado de un banco de 400 casos con τ=0,4, y los propios autores piden tratarlo como un banco calibrado y no como una promesa. Tu distribución de confianza puede dar otro τ óptimo, y falta el experimento con sesiones reales.
¿Qué latencia tiene una decisión local?
Según los autores, 42,6 ms por decisión local en CPU fp32 y una sola máquina. La cifra de GPU (p50 de 21,0 ms en una RTX 5090) es la de la publicación del modelo y no fue reproducida por ellos.
¿Cómo instalo dsh-phocinae para reproducir la medición?
Con dsh plugin –profile <nombre> add [email protected], nombrando la versión. Los autores midieron con la 0.2.1, así que tus resultados pueden diferir si el cambio de versión toca algo relevante para tu caso.
Conclusión
El hallazgo útil no es el 86,1% sino la brecha: el mismo plugin, con los mismos 400 casos, ahorró desde 8,5% hasta 86,1% según τ. Antes de creerle a cualquier titular de ahorro de tokens, pedí el contador, la unidad y el umbral. Si pensás probar dsh-phocinae, apuntá bench/ a tus propios logs, barré τ entre 0,3 y 0,6, mirá accuracy junto al costo y quedate con tu fila, no con la de los autores.