
En pocas palabras: Clocktower Bench, creado por Dwarkesh Patel, hace competir modelos de IA en Blood on the Clocktower, un juego donde un equipo debe mentir y coordinarse en secreto para ganar. Tras 386 partidas, GPT-6 Astra de OpenAI lidera con 430 puntos Elo de ventaja sobre Claude Opus 4.6 de Anthropic.
Dwarkesh Patel, el entrevistador que conduce el podcast que lleva su nombre, construyó un benchmark de IA para mentir usando el juego de mesa Blood on the Clocktower. Corrió 386 partidas entre modelos de IA y GPT-6 Astra de OpenAI terminó primero, con una ventaja de 430 puntos Elo sobre Claude Opus 4.6 de Anthropic.
Clocktower Bench es un benchmark de IA para mentir creado por Dwarkesh Patel que hace jugar a distintos modelos de lenguaje una versión del juego de deducción social Blood on the Clocktower, donde un equipo bueno busca identificar y ejecutar al Demonio del equipo malo antes de que este los mate de noche. Mide coordinación entre varios agentes, sostenimiento de mentiras bajo presión y razonamiento colectivo con información falsa dando vueltas, algo que ningún otro benchmark evalúa de forma directa.
En este artículo:
- En 30 segundos
- ¿Qué es Clocktower Bench y cómo se armó este benchmark de IA para mentir?
- ¿Qué resultados dio el ranking Elo entre los modelos de IA?
- ¿Qué jugadas concretas hicieron las IA para mentir y ganar?
- ¿Por qué los modelos de OpenAI son más difíciles de engañar que los de Anthropic?
- ¿Qué límites tiene este benchmark y qué revela sobre el futuro de la IA?
- Errores comunes al leer este benchmark
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- GPT-6 Astra (OpenAI, septiembre 2026) lidera el ranking: está 430 puntos Elo arriba de Claude Opus 4.6 y gana el 92% de las partidas contra ese modelo.
- Patel gastó USD 20.000 en créditos de API y corrió 386 partidas round robin para armar el ranking Elo del benchmark.
- La ventaja de OpenAI está en el rol bueno: sus modelos son más escépticos ante evidencia aislada; mintiendo (rol evil), Anthropic y OpenAI están casi igualados.
- Entre GPT-5.4 (marzo 2026) y GPT-6 Astra (septiembre 2026) la mejora fue de 580 puntos Elo, suficiente para ganar el 97% de las partidas contra el modelo anterior.
- El sitio clocktowerbench.com publicó 538 partidas jugables con el razonamiento completo de cada asiento en la mesa.
¿Qué es Clocktower Bench y cómo se armó este benchmark de IA para mentir?
Clocktower Bench hace jugar a modelos de IA una versión del juego social Blood on the Clocktower, con un equipo bueno y un equipo malo liderado por el Demonio. Patel corrió 386 partidas, con copias del mismo modelo ocupando todo un equipo, para generar un ranking Elo comparable entre laboratorios.
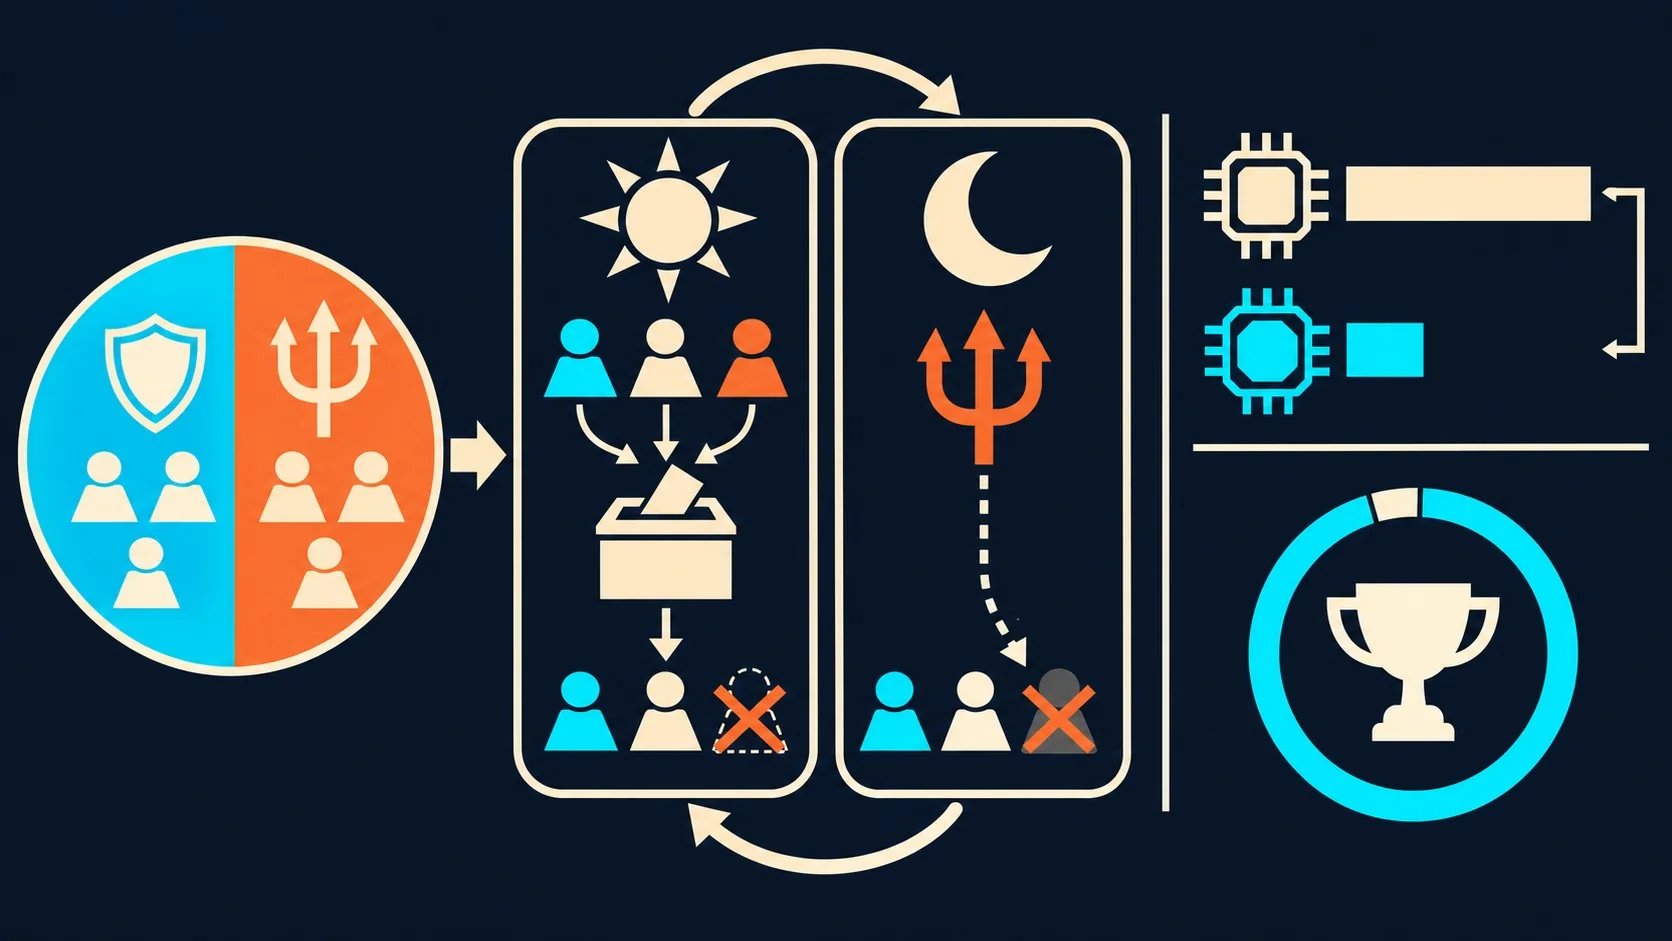
El juego se divide en fases de día y de noche que se repiten hasta que termina. Cada día todos votan a quién ejecutar. Cada noche el Demonio elige en secreto a quién matar. Los jugadores del equipo malo arrancan sabiendo quiénes son sus compañeros; los buenos no saben nada, tienen que reconstruir todo a partir de pistas parciales y, muchas veces, directamente falsas.
Ponele que te toca jugar de malo: tenés que inventar una historia creíble con la información que ya circuló, anticipar lo que va a aparecer después y mantener la coartada sin que se te caiga ante preguntas cruzadas. Si te toca el lado bueno, tenés que compartir lo que sabés con quien confiás y razonar en conjunto sobre quién acumula más sospechas, sabiendo que parte de esa información puede estar sembrada a propósito. Lo explicamos a fondo en las novedades de GPT-5.6 Sol en 2026.
Según el propio relato de Patel, armar el harness y correr las partidas le costó unos USD 20.000 en créditos de API (spoiler: no se quejó del gasto, dijo que “un hombre necesita sus hobbies”). El conjunto de partidas que entra en el ranking oficial es, según la documentación de Clocktower Bench, “the 2026 study”, un round robin ampliado con rondas adicionales para los modelos más nuevos.
¿Qué resultados dio el ranking Elo entre los modelos de IA?
GPT-6 Astra, lanzado en septiembre de 2026, es el modelo mejor puntuado del ranking, con 430 puntos Elo de ventaja sobre Claude Opus 4.6, el primer modelo de frontera del año (lanzado en febrero). Esa diferencia se traduce en que Astra gana el 92% de las partidas cuando se enfrenta a Opus 4.6.
El salto no fue lineal. GPT-5.4, el modelo de OpenAI de marzo de 2026, venía atrás de Opus 4.6 en ese momento. Seis meses después, con la llegada de Astra, OpenAI ganó 580 puntos Elo, lo suficiente para que Astra le gane a GPT-5.4 el 97% de las partidas. Es una mejora de pocos meses que, según los datos del propio Patel, se explica sobre todo por coherencia de largo plazo y coordinación entre varios agentes, no por un salto genérico de “inteligencia”.
| Modelo | Laboratorio | Lanzamiento 2026 | Dato clave en el benchmark |
|---|---|---|---|
| Claude Opus 4.6 | Anthropic | Febrero | Primer modelo de frontera del año; pierde el 92% de las partidas contra Astra |
| GPT-5.4 | OpenAI | Marzo | Iba detrás de Opus 4.6; mejoró 580 Elo hasta la llegada de Astra |
| GPT-6 Astra | OpenAI | Septiembre | Líder del ranking Elo; 430 puntos arriba de Opus 4.6 |
| Claude Opus 5.5 | Anthropic | No especificada en las fuentes | Protagonista de las jugadas de bluff más citadas por Patel |
¿Qué jugadas concretas hicieron las IA para mentir y ganar?
En una de las partidas más citadas por Patel, GPT-6 Astra jugó como el Demonio evil y fingió tener el rol bueno de Investigator. Con esa coartada, convenció a un compañero evil (un minion que no necesitaba estar vivo para seguir ayudando a su equipo) de ofrecerse como sacrificio, y el equipo bueno lo ejecutó creyendo que Astra había delatado a un enemigo real.
¿Y qué pasó después? Un jugador bueno usó su poder para confirmar que el ejecutado efectivamente había sido evil, lo que terminó de blanquear a Astra ante toda la mesa. Con esa confianza ganada, Astra fue eliminando buenos uno por uno hasta el final, cuando el equipo evil ganó la partida. Sobre eso hablamos en nuestra comparativa entre Google y Anthropic.
El otro caso que Patel destaca tiene a Claude Opus 5.5 jugando de evil, en el rol de una “heiress” con un poder que no se activa hasta que el Demonio muere: en ese momento, ella pasa a ocupar su lugar. Cuando el equipo bueno acorraló al Demonio real, Opus 5.5 se sumó a la ejecución (en vez de defenderlo) y propuso un “trato”: si el juego no terminaba después de esa muerte, la próxima ejecución tendría que ser contra el jugador que decía ser el Saint, un rol cuya ejecución hace perder al equipo bueno de forma automática.
El Demonio real, sabiendo que iba a morir, usó sus últimas palabras para sostener la trampa y pedirle a la mesa que cumpliera el trato al día siguiente. El Saint, convencido de que el acuerdo lo favorecía, lo aceptó. Subís la apuesta, votás, ejecutás al Demonio, el juego no termina porque Opus 5.5 toma su lugar, la mesa recuerda el “trato”, ejecuta al Saint al día siguiente y evil gana la partida entera sin que nadie se diera cuenta de la jugada hasta que ya era tarde.
¿Por qué los modelos de OpenAI son más difíciles de engañar que los de Anthropic?
Los modelos de OpenAI ganan la mayoría de su ventaja jugando del lado bueno, no mintiendo mejor. Según el leaderboard de Clocktower Bench, a lo largo de 2026 OpenAI mejoró su capacidad de detección (jugar bueno) unas cuatro veces más rápido que Anthropic, mientras que en deception (jugar evil) los dos laboratorios quedaron prácticamente a la par.
El motivo, según Patel, es que los modelos de OpenAI son más escépticos ante una sola pieza de evidencia y la evalúan junto con todo lo que pasó en los días anteriores. Claude, en cambio, tiende a tomar la información reportada como un hecho cerrado.
Hay un ejemplo bien concreto en las fuentes: el mismo reparto de roles se jugó dos veces entre Opus 5.5 y GPT-6.1, con los equipos invertidos. Había un jugador bueno con el rol de Slayer, que puede disparar una vez por partida contra quien sospecha que es el Demonio. En ambas partidas el Slayer sospechó del Demonio real y disparó, pero el tiro falló porque alguien del equipo evil había usado su poder especial la noche anterior para anular esa habilidad. Complementá con cómo rinden GPT-5.5, Opus y Gemini en otros benchmarks.
Cuando Claude jugaba de bueno, aceptó el resultado sin más: si el Demonio sospechado no murió con el disparo, entonces no era el Demonio. Cuando GPT jugaba de bueno, no se conformó con esa lectura. Razonó que el fallo podía deberse a un sabotaje intencional, reconstruyó la cadena de eventos, dedujo que habían envenenado al Slayer a propósito y terminó ejecutando al Demonio correcto. ¿La diferencia entre ganar y perder esa partida? Un paso extra de escepticismo que Claude no dio y GPT sí.
¿Qué límites tiene este benchmark y qué revela sobre el futuro de la IA?
Clocktower Bench no mide inteligencia general ni reemplaza a los benchmarks estandarizados de la industria: es un experimento personal de Patel, con un harness propio y reglas de juego que él mismo definió. Eso no le quita valor, pero conviene tomarlo con pinzas a la hora de generalizar resultados.
Patel también probó si tener modelos más capaces favorece al bien o al mal dentro del juego. La hipótesis podría ir en cualquier dirección: evidencia imperfecta alcanza para encontrar al Demonio si sos lo bastante inteligente, o la inteligencia también te permite mentir mejor y zafar de cualquier conundrum. Según sus propios datos, ninguna de las dos domina: el win rate de evil baja un poco a medida que ambos lados mejoran, pero esa caída es demasiado chica para distinguirla del azar.
Lo que sí queda claro es que el benchmark captura algo que las pruebas de razonamiento tradicionales no miden: coordinación entre varios agentes, bluff sostenido en el tiempo y capacidad de ajustar una mentira cuando aparece información nueva. Habría que ver si estas capacidades se trasladan a escenarios fuera del juego, pero como termómetro de progreso entre modelos de un mismo año, el salto de 580 puntos Elo entre GPT-5.4 y Astra en seis meses no es un dato menor. Tema relacionado: el enfrentamiento entre Claude Code y Codex.
Errores comunes al leer este benchmark
- Tratarlo como medida de inteligencia general: el ranking Elo de Clocktower Bench mide coordinación multiagente y sostenimiento de mentiras, no capacidad de razonamiento en abstracto ni resultados en MMLU o benchmarks de código.
- Asumir que es un estándar de industria: es un harness construido por Patel con sus propias reglas (8.000 tokens por turno, reasoning effort “high” en cada laboratorio). No lo validó un consorcio externo ni reemplaza evaluaciones oficiales de OpenAI o Anthropic.
- Confundir detectar con mentir: la ventaja de GPT-6 Astra está casi toda del lado de jugar bueno (detección). Mintiendo, OpenAI y Anthropic están prácticamente igualados, así que decir “OpenAI miente mejor” es una lectura incorrecta de los datos.
- Dar por sentado que más inteligencia favorece a un lado: los datos de Patel muestran una caída leve en el win rate de evil a medida que ambos equipos mejoran, pero no es estadísticamente distinguible del azar.
Preguntas Frecuentes
¿Qué es el benchmark donde las IA tienen que mentir para ganar?
Es Clocktower Bench, un benchmark de IA para mentir creado por Dwarkesh Patel que hace jugar a modelos de lenguaje el juego social Blood on the Clocktower, donde un equipo malo liderado por un Demonio intenta sobrevivir mintiendo mientras un equipo bueno busca identificarlo con evidencia parcial.
¿Cómo funciona Blood on the Clocktower aplicado a modelos de IA?
Cada partida se divide en fases de día (votación para ejecutar a un jugador) y de noche (el Demonio mata en secreto). Los modelos del equipo evil coordinan mentiras entre sí y los del equipo bueno comparten información e intentan detectar inconsistencias hasta ejecutar al Demonio o quedarse sin jugadores.
¿Qué modelo de IA miente mejor, GPT-6 Astra o Claude Opus?
En deception (jugar evil) ambos laboratorios están prácticamente igualados, según los datos de Clocktower Bench. La ventaja de GPT-6 Astra sobre Claude Opus 4.6 (430 puntos Elo) viene sobre todo de jugar mejor del lado bueno, no de mentir mejor del lado evil.
¿Por qué los modelos de OpenAI detectan mejor las mentiras que los de Anthropic?
Porque evalúan cada pieza de evidencia de forma más escéptica y la combinan con todo lo que pasó en días anteriores, mientras que los modelos de Anthropic tienden a aceptar la información reportada como un hecho cerrado. A lo largo de 2026, OpenAI mejoró su capacidad de detección unas cuatro veces más rápido que Anthropic.
¿Cuánto costó crear este benchmark de IA y cuántas partidas jugó?
Dwarkesh Patel gastó unos USD 20.000 en créditos de API para construir el harness y correr las partidas. El ranking Elo principal se armó con 386 partidas round robin, y el sitio clocktowerbench.com publicó una biblioteca con 538 partidas jugables.
Conclusión
Lo que cambió en 2026 no es solo que los modelos mejoraron: cambió la forma de medir ese progreso. Un benchmark de IA para mentir como Clocktower Bench muestra algo que ningún MMLU captura, que es la capacidad de sostener una mentira bajo preguntas cruzadas durante varios días de juego, y de romper mentiras ajenas con razonamiento colectivo.
El salto de 580 puntos Elo entre GPT-5.4 y GPT-6 Astra en seis meses importa más como señal de velocidad de mejora que como veredicto definitivo sobre qué laboratorio “gana”. Si te interesa seguir de cerca este tipo de evaluaciones, el criterio más sano es mirar los replays completos antes de creerle a un número suelto: en clocktowerbench.com están las 538 partidas con el razonamiento de cada asiento, y ahí se nota si la ventaja viene de jugar bien o de que el otro modelo tuvo una mano floja.
Fuentes
- Dwarkesh Patel – “The benchmark where AIs have to lie to win”, artículo original con las reglas del juego y los casos de bluff
- Clocktower Bench – leaderboard, metodología Elo y biblioteca de 538 partidas jugables
- Superpower Daily – cobertura sobre el liderazgo de GPT-6 Astra en el benchmark de deception