En pocas palabras: En el benchmark “Would you ship this Italian?”, con 29 pares reales de strings en italiano, GPT-5.4 mini acertó 19 de 29 pares completos, y GPT-5.4 nano bajó a 18 y 16 según el run porque marcó como error hasta un tercio de las traducciones correctas.
Un desarrollador armó un benchmark con 29 pares de strings reales de interfaces de software (el texto que se shippeó con errores y la versión que un hablante nativo escribiría) y le pidió a 18 modelos de IA que actuaran como revisores de QA. Resultado: ningún modelo superó los 26 aciertos sobre 29, y el punto ciego más grande fue algo tan básico como los números.
El benchmark italiano IA conocido como “Would you ship this Italian?” es una tarea publicada en Kaggle Benchmarks por Giuseppe Castelluccio, basada en auditorías reales de QA sobre sitios de software. Cada modelo ve un string por vez (la versión shippeada o la corregida) junto con el tipo de producto, dónde aparece el texto y el original en inglés cuando existe, y responde si está “ok” o tiene “error”. Si trabajás con localización de sitios, esto es más que una curiosidad: es básicamente el mismo control de calidad que muchos equipos ya tercerizan en un modelo, sin saber en qué falla.
En este artículo:
- En 30 segundos
- ¿Qué mide exactamente el benchmark “Would you ship this Italian”?
- ¿Cómo se armó el benchmark de bugs reales de sitios web?
- ¿Qué modelos se probaron y cuáles dieron resultados confiables?
- ¿Qué modelo de IA detectó mejor los errores de italiano?
- ¿Por qué los modelos de IA fallan en detectar errores de formato numérico?
- Ejemplo hipotético: el mismo problema, pero en español
- ¿Qué significa que un modelo “flaguee” una traducción correcta como error?
- Errores comunes al leer este tipo de benchmarks
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El benchmark tiene 29 pares reales de strings en italiano, sacados de auditorías de QA hechas por su creador durante 2026.
- Se probaron 18 modelos de distintas empresas y familias abiertas, pero solo 9 completaron runs confiables (con máximo 2 de 58 respuestas ilegibles).
- Gemini 3.5 Flash-Lite, el Gemini más barato del lote, empató el mejor puntaje y en un run dejó en paz los 29 fixes nativos.
- Los modelos detectaron errores de formato numérico solo 18 veces de 48 posibles, muy por debajo del resto de las categorías.
- GPT-5.4 nano atrapa tantos bugs como los líderes, pero marca como error a un tercio de las correcciones que ya estaban bien.
¿Qué mide exactamente el benchmark “Would you ship this Italian”?
Mide si un modelo de IA puede distinguir, a nivel de string individual, entre italiano defectuoso que ya se publicó y su corrección nativa. Castelluccio armó la tarea para el Kaggle Benchmarking Challenge a partir de casos que encontró él mismo revisando sitios de software durante 2026.
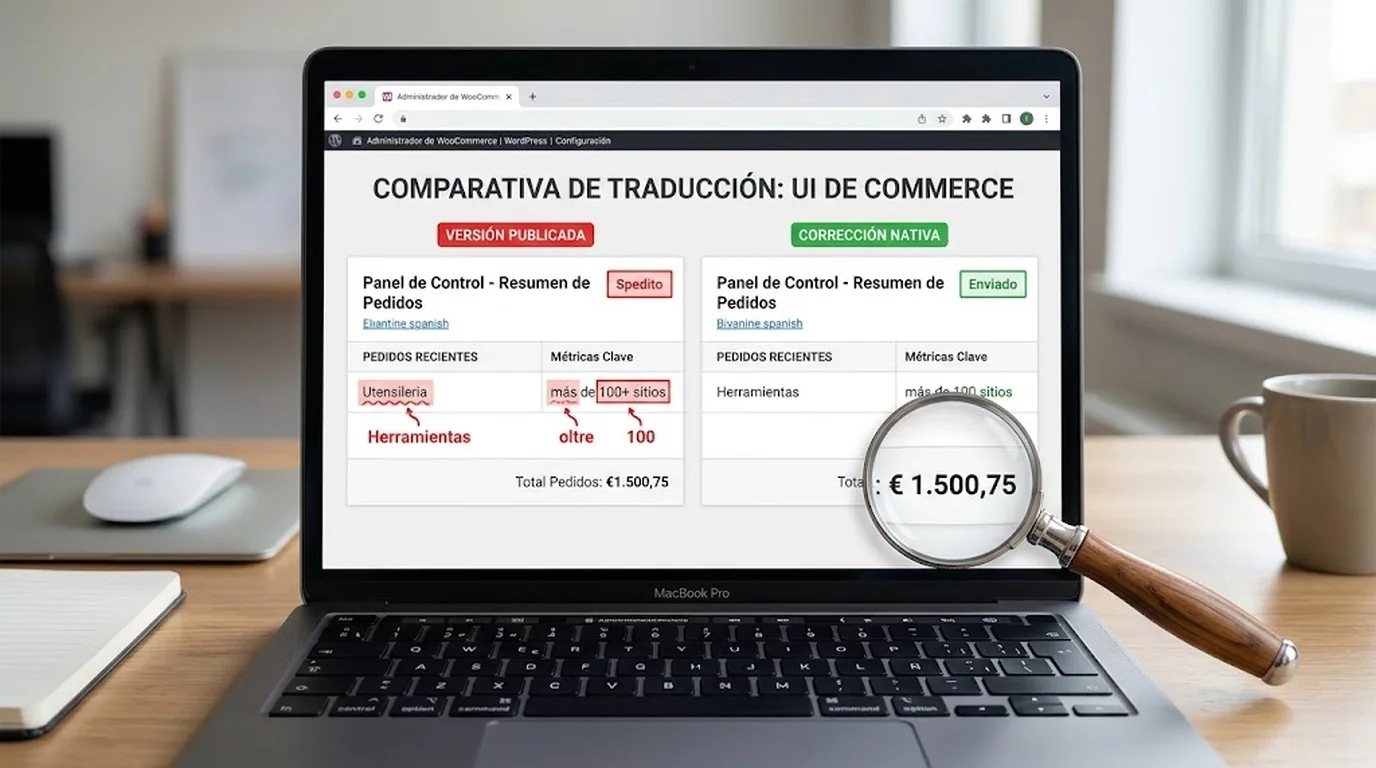
Los ejemplos que cita en su artículo original en dev.to son casi cómicos si no fuera porque salieron a producción de verdad. Una herramienta de transcripción tenía un menú “Tools” traducido como Utensileria. En italiano eso significa ferretería, no herramientas de software — básicamente le dijiste a tu usuario italiano que vaya al bazar. Una landing page se jactaba de “5 Mld+ Altoparlanti nativi“, es decir, cinco mil millones de parlantes nativos (spoiler: ninguna empresa real tiene esa cantidad de usuarios). Y más de un sitio tradujo “Trusted by” palabra por palabra como “Fidato da“, una construcción que ningún italiano usaría así, aunque cualquier traductor automático la escupiría sin dudar.
La pregunta que se hizo el autor es simple: si los modelos ya funcionan como revisores de contenido en muchos equipos, ¿pueden distinguir un defecto shippeado de su arreglo nativo cuando ven el string aislado, tal como lo vería un revisor humano?
¿Cómo se armó el benchmark de bugs reales de sitios web?
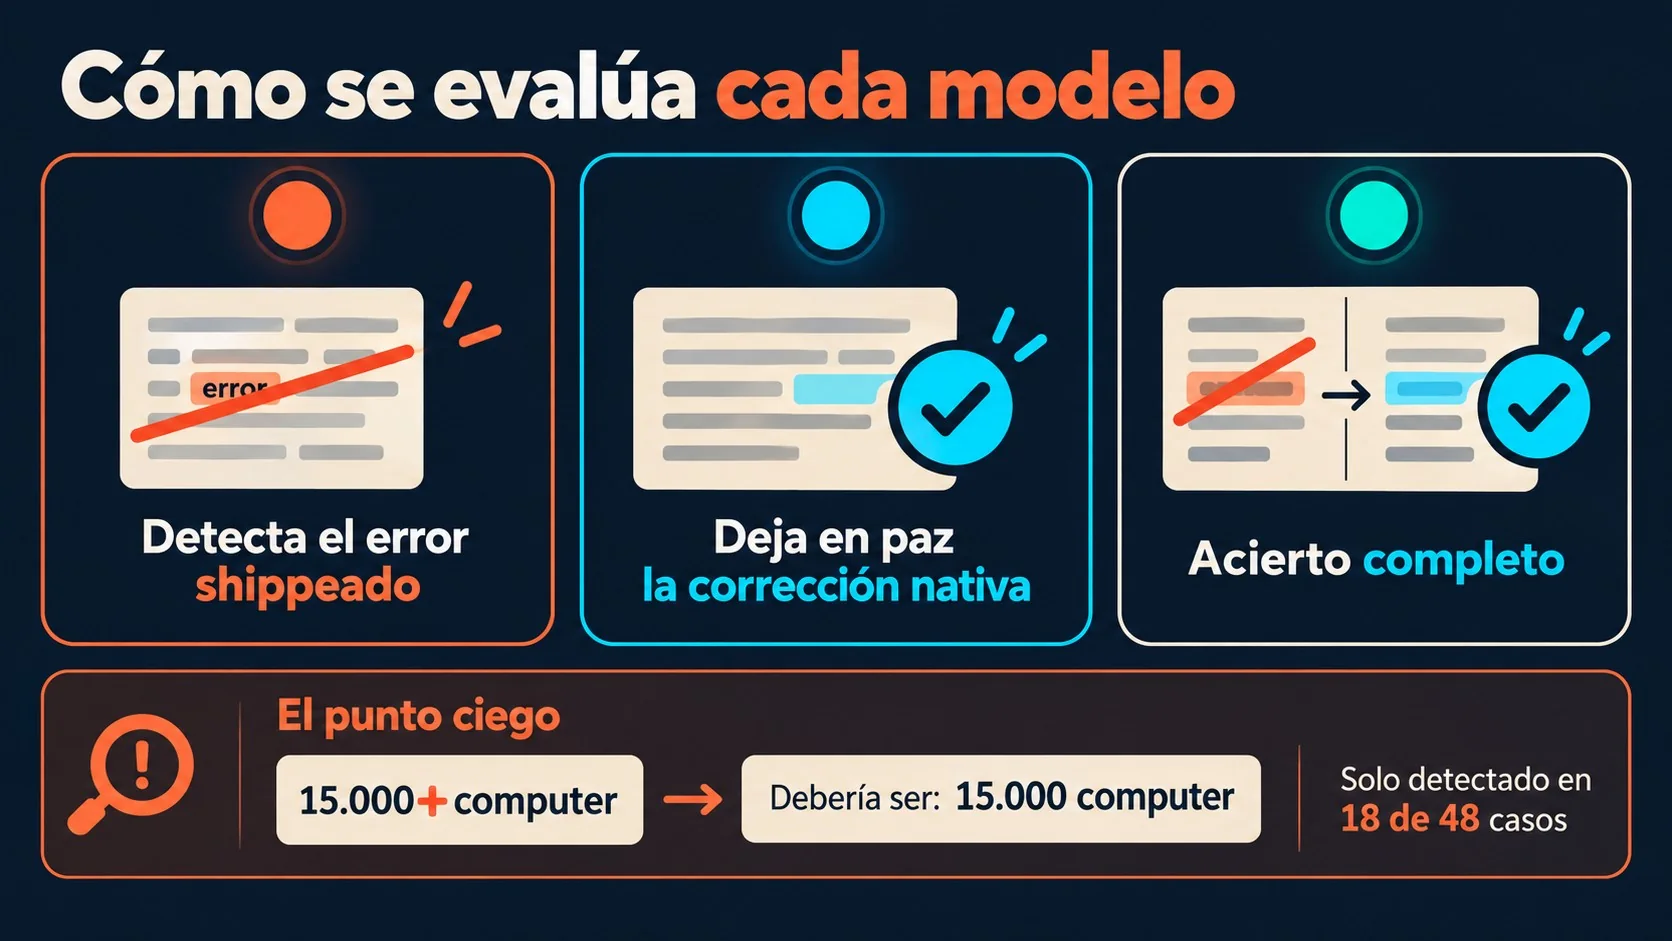
El benchmark tiene 29 pares de strings: la versión que se publicó con error y la versión que un hablante nativo escribiría en su lugar, con los nombres de marca enmascarados. El modelo evalúa cada mitad por separado (no las ve juntas) y responde “ok” o “error” para cada una.
Acá está la parte más interesante del diseño: un par solo cuenta como acierto si el modelo marca el string shippeado como error y deja en paz la versión corregida. Un modelo que marca todo como error saca cero. Uno que aprueba todo también saca cero. Los revisores que gritan “lobo” todo el tiempo son inútiles en la práctica, y una métrica de accuracy plana los escondería, cosa que cualquiera que haya lidiado con un linter demasiado estricto va a entender enseguida.
Los defectos se dividen en diez categorías: 8 términos sin traducir, 5 calcos del inglés, 4 errores de concordancia, 3 errores de formato numérico, 2 de sentido de palabra equivocado, 2 errores de ortografía, 2 de gramática rota, y uno cada uno de encoding roto, frase poco idiomática y capitalización al estilo inglés.
¿Qué modelos se probaron y cuáles dieron resultados confiables?
Castelluccio corrió la tarea sobre los 18 modelos que ofrecía Kaggle Benchmarks al momento del desafío, cubriendo Google, Anthropic, OpenAI, xAI, Alibaba, DeepSeek, Zhipu y las familias abiertas Gemma y gpt-oss. La elección tiene sentido: un equipo de localización elige revisor tanto por costo como por calidad, así que tenía que incluir modelos chicos y grandes.
Ahora bien, no todos los modelos produjeron respuestas utilizables. Siete devolvieron errores de API en la mayoría de sus llamadas (permission denied, rate limits, algún modelo directamente no encontrado), así que el autor los reporta como “no medidos” en vez de asignarles cero, algo bastante más honesto que la mayoría de los rankings que circulan por ahí. Corrió la tarea dos veces, y un run solo cuenta si como máximo 2 de sus 58 respuestas fueron ilegibles. Con ese filtro quedaron 9 modelos con runs limpios.
¿Qué modelo de IA detectó mejor los errores de italiano?
Gemini 3.8 Flash, Gemini 3.7 Flash y Gemini 3.5 Flash-Lite lideraron con 26 pares totalmente correctos sobre 29 en al menos uno de sus dos runs. Ningún modelo probado alcanzó el score perfecto de 29, y la diferencia entre el primero y el noveno puesto fue de hasta 10 pares.
| Modelo | Pares totalmente correctos | Bugs detectados | Fixes respetados |
|---|---|---|---|
| Gemini 3.8 Flash | 26 · 25 | 27 · 26 | 28 · 27 |
| Gemini 3.7 Flash | 26 · 23 | 27 · 27 | 28 · 25 |
| Gemini 3.5 Flash-Lite | 26 · 25 | 26 · 27 | 29 · 27 |
| Gemma 4 31B | 23 · 24 | 25 · 27 | 26 · 26 |
| Gemini 3.1 Pro (preview) | 23 · 24 | 27 · 27 | 25 · 26 |
| Gemini 2.5 Flash | 21 | 24 | 26 |
| GPT-5.4 mini | 19 · 19 | 24 · 24 | 23 · 23 |
| GLM-5 | 19 | 26 | 22 |
| GPT-5.4 nano | 18 · 16 | 26 · 26 | 20 · 19 |
Lo llamativo es que Gemini 3.5 Flash-Lite, el modelo más barato de toda la familia Gemini, empató el primer puesto y en uno de sus runs dejó en paz los 29 fixes nativos, un puntaje perfecto en esa columna. Gemini 3.1 Pro, la versión “preview” supuestamente más capaz, no logró superar a los modelos Flash más chicos. Eso solo ya debería hacerte reconsiderar la idea de que pagar más por un modelo más grande te garantiza mejor criterio editorial, al menos para esta tarea puntual.
¿Por qué los modelos de IA fallan en detectar errores de formato numérico?
Porque los números “parecen” correctos incluso cuando no lo son, y los modelos los dejan pasar por default. Según los 16 runs limpios del benchmark, los modelos atraparon el 100% de los términos sin traducir, los calcos y el encoding roto, y 63 de 64 errores de concordancia. Pero solo detectaron los errores de formato numérico 18 veces de 48 posibles.
Los tres casos concretos que documenta el autor son reveladores: “6+ piattaforme“, “15.000+ computer” y “oltre 100+ siti“. Este último es el más gracioso (si es que eso cuenta como gracioso en un reporte de QA): dice “más de” dos veces, porque “oltre” ya significa “más de” en italiano y el “+” pegado al número es redundante. El mismo patrón redundante aparece en “6+ piattaforme”, que en italiano correcto se escribe simplemente “oltre 6”. Los modelos ven un número con un símbolo al lado y lo procesan como dato válido, no como texto a revisar.
¿Y qué explica esa brecha tan marcada? Las cadenas parecen números válidos, y los modelos las dejan pasar sin marcarlas como error, algo que el propio benchmark deja ver pero sin profundizar en la causa exacta. Es un punto ciego más de forma que de contenido: el modelo no está leyendo el número, está reconociendo el patrón “dígito + símbolo” y asumiendo que ya está resuelto.
Ejemplo hipotético: el mismo problema, pero en español
Nota: lo que sigue es un ejemplo hipotético para ilustrar el criterio, no un dato del benchmark ni un caso verificado.
Imaginemos que tu equipo usa un modelo de IA para revisar el copy en español antes de publicar un sitio. Aparece este texto: “Más de 10.000+ usuarios confían en nosotros”. Un revisor humano nativo lo marcaría al toque: “más de” y “+” dicen lo mismo dos veces, igual que el “oltre 100+” del benchmark italiano. Lo correcto sería “Más de 10.000 usuarios” o “10.000+ usuarios”, pero no las dos formas juntas.
Si el patrón que muestra este benchmark se sostiene en español (cosa que el estudio original no prueba, pero es razonable sospechar dado que el mecanismo del error es el mismo: un símbolo pegado a un dígito que “parece” correcto), un modelo usado como único revisor probablemente dejaría pasar ese “más de… +” sin marcarlo, mientras sí atraparía un calco más obvio como “confiado por” en vez de “de confianza de”. El criterio práctico que se puede sacar de acá: cuando revises copy con un modelo de IA, no le confíes ciegamente la revisión de números, porcentajes, rangos y símbolos de “más/menos”. Esa categoría necesita una pasada humana aparte, aunque el resto del texto haya salido limpio.
¿Qué significa que un modelo “flaguee” una traducción correcta como error?
Significa que el modelo marca como defectuosa una versión que ya estaba bien escrita en italiano nativo, lo cual en la práctica es peor que no tener revisor. GPT-5.4 nano es el ejemplo más claro del benchmark: atrapa tantos bugs reales como los modelos líderes (26 de 29 en ambos runs), pero flaguea un tercio de los fixes nativos correctos como si tuvieran error.
Pensalo desde el lado del equipo de localización: te llega un reporte del “revisor IA” marcando 9 strings como problemáticos, mandás a un traductor a revisarlos, y resulta que un tercio ya estaban perfectos. El traductor pierde tiempo, el equipo pierde confianza en la herramienta, y probablemente termine ignorando futuras alertas del mismo modelo, que es exactamente el problema que querías evitar con un revisor automático.
Ojo con esto también: un solo run no alcanza para sacar conclusiones firmes. Gemini 3.7 Flash se movió hasta 3 pares entre corridas distintas (26, después 23, y 25 en la primera corrida del notebook original). En un benchmark de 29 pares, una diferencia de uno o dos pares entre modelos es ruido estadístico, no una señal real de que un modelo es mejor que otro.
Errores comunes al leer este tipo de benchmarks
- Tomar un solo run como definitivo. El propio autor corrió la tarea dos veces y encontró variaciones de hasta 3 pares en el mismo modelo. Si vas a comparar modelos, corré la tarea más de una vez antes de decidir.
- Ignorar los “no medidos”. Siete de los 18 modelos probados fallaron por errores de API y no entraron al ranking. Confundir eso con “estos modelos no sirven” es un error de lectura, no un resultado del benchmark.
- Mirar solo el score total y no la composición. Un modelo puede atrapar muchos bugs y aun así ser mal revisor si flaguea demasiados fixes correctos, como GPT-5.4 nano. El score que importa es el balance entre ambas columnas, no una sola métrica.
- Asumir que un modelo más grande o más caro rinde mejor. Gemini 3.1 Pro no superó a los modelos Flash más chicos y baratos en este benchmark específico. El tamaño del modelo no predice el desempeño en una tarea de nicho como esta.
Preguntas Frecuentes
¿Qué es el benchmark “Would you ship this Italian”?
Es una tarea de evaluación publicada en Kaggle Benchmarks por Giuseppe Castelluccio, que mide si los modelos de IA distinguen italiano defectuoso publicado en sitios reales de su corrección nativa. Usa 29 pares de strings sacados de auditorías de QA hechas por el propio autor.
¿Qué modelo de IA detectó mejor los errores de italiano en el benchmark?
Gemini 3.8 Flash, Gemini 3.7 Flash y Gemini 3.5 Flash-Lite empataron en el primer puesto con 26 pares totalmente correctos sobre 29 en al menos uno de sus dos runs. Gemini 3.5 Flash-Lite, el más barato del lote, llegó a dejar en paz los 29 fixes nativos en una corrida.
¿Cómo se armó el benchmark de traducciones con bugs reales?
El autor recopiló los strings y sus correcciones durante auditorías de QA sobre sitios de software realizadas antes del desafío, y volvió a verificar cada corrección como hablante nativo para el benchmark. El código de la tarea lo escribió con asistencia de Claude Code durante el desafío.
¿Por qué los modelos de IA fallan en detectar errores de formato numérico?
Porque los modelos tratan los números como datos válidos en vez de texto a revisar. Solo detectaron errores de formato numérico 18 veces de 48 posibles, muy por debajo del 100% que lograron con términos sin traducir o calcos del inglés.
¿Qué significa que un modelo “flaguee” una traducción correcta como error?
Significa que el modelo marca como defectuoso un texto que un hablante nativo ya aprobaría, generando trabajo innecesario para el equipo de localización. GPT-5.4 nano flagueó un tercio de los fixes nativos correctos pese a detectar tantos bugs reales como los modelos líderes.
Conclusión
El benchmark deja algo claro: ningún modelo de IA probado es un revisor de italiano confiable al 100%, y el punto flojo no es lo que uno esperaría. Los modelos captan sin problema los términos sin traducir o los calcos obvios, pero se les escapan las convenciones numéricas, algo que cualquier corrector humano nativo detecta al toque, italiano o no.
Si tu equipo usa un modelo de IA para revisar copy en otros idiomas antes de publicar en tu sitio, hay dos criterios concretos para llevarte de acá: primero, no confíes en un solo run, corré la revisión más de una vez si el volumen de texto lo justifica; segundo, prestá especial atención manual a los formatos numéricos, porcentajes y símbolos de “más/menos”, porque ahí es donde la mayoría de los modelos falla en silencio, sin que el resto del texto dé ninguna pista de que algo anda mal. Si además estás por lanzar o migrar un sitio multilenguaje, tener buena infraestructura de hosting en donweb.com no reemplaza una revisión editorial humana, pero sí te da margen para iterar rápido cuando encontrás estos errores después de publicar.
Fuentes
- Would you ship this Italian? A benchmark built from real website bugs – artículo original de Giuseppe Castelluccio en dev.to
- Italian UI strings: shipped vs fixed – tarea, notebook y runs públicos en Kaggle Benchmarks