En pocas palabras: El prompt chaining 2.0 construye razonamiento multi-paso en modelos grandes mediante pipelines con contratos JSON, branching dinámico, Tree-of-Thought y prompting maiéutico, según el artículo técnico de dev.to del 28 de septiembre de 2026 sobre Claude Opus y GPT-5.4 Pro.
El 28 de septiembre de 2026, un análisis técnico publicado en dev.to catalogó las técnicas de prompt chaining que dominan el desarrollo de agentes con modelos grandes: pipelines con contratos JSON, branching dinámico, Tree-of-Thought y prompting maiéutico, todas pensadas para reducir errores en cadenas de razonamiento multi-paso con Claude Opus y GPT-5.4 Pro.
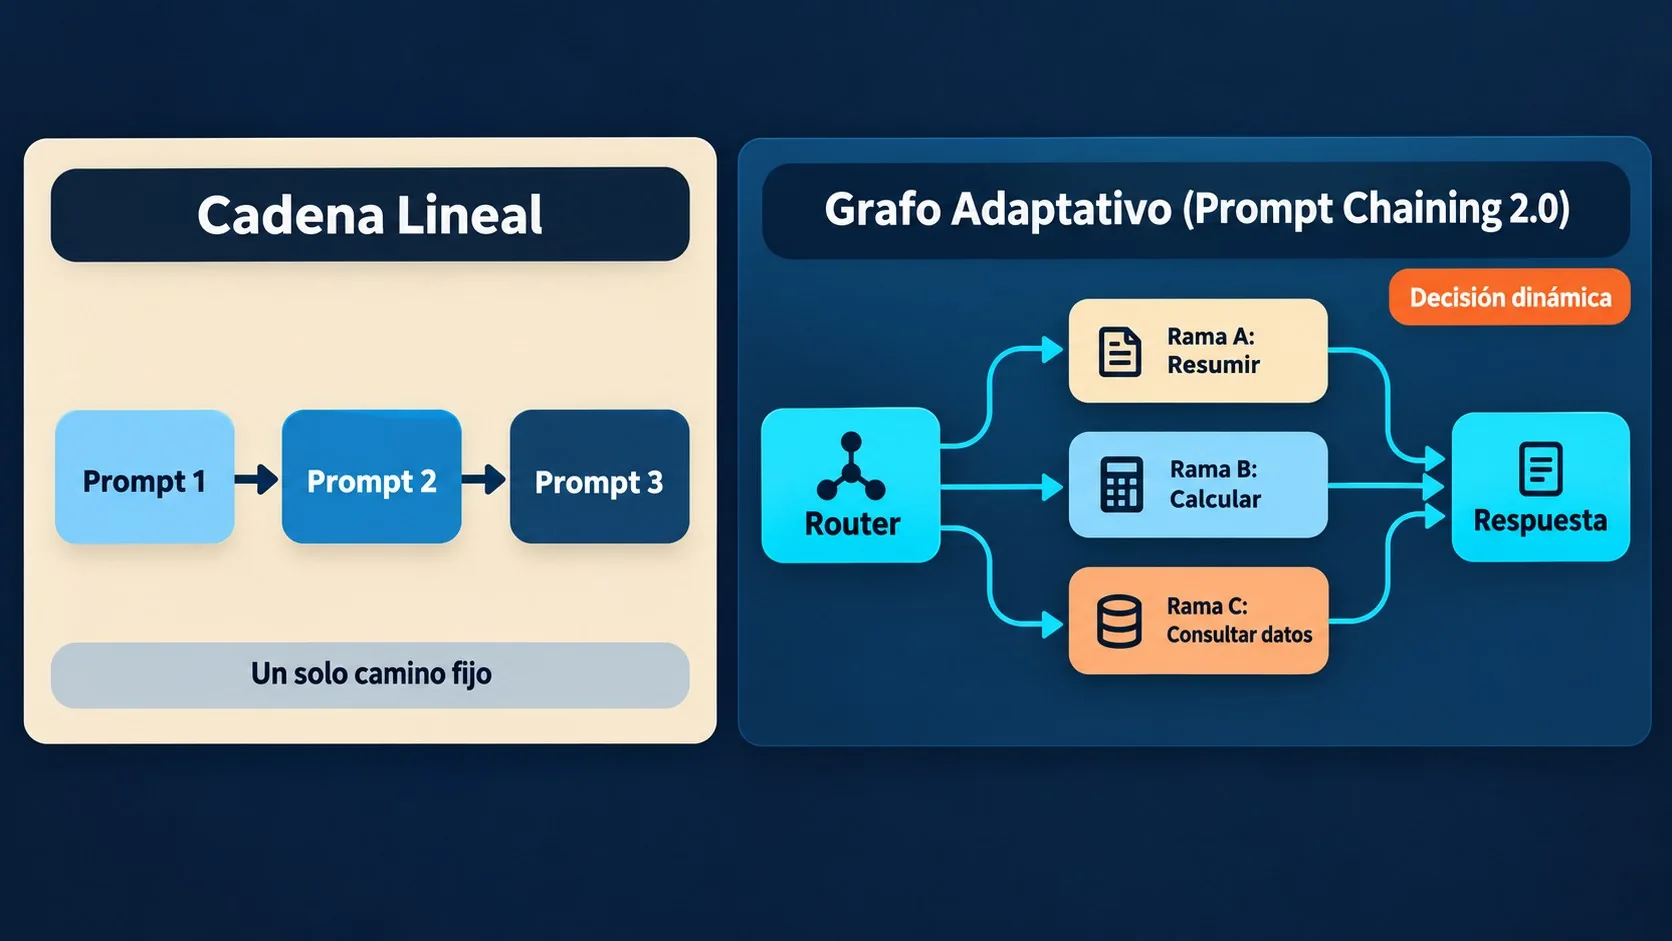
El prompt chaining es una técnica de ingeniería de prompts que divide una tarea compleja en una secuencia de sub-prompts conectados, donde la salida de cada paso alimenta al siguiente. En su versión 2.0, según describe el artículo técnico de dev.to, el modelo elige dinámicamente la próxima rama de razonamiento según su nivel de confianza, en vez de seguir un camino lineal fijo.
En este artículo:
- En 30 segundos
- ¿Qué es el prompt chaining 2.0 y en qué se diferencia del encadenamiento tradicional?
- ¿Qué técnicas nuevas incluye el prompt chaining 2.0 para razonamiento multi-paso?
- ¿Cómo se integra el prompt chaining con Claude Opus y GPT-5.4 Pro?
- ¿Qué limitaciones y riesgos tiene encadenar prompts en producción?
- ¿Cómo implementar una cadena de prompts en un pipeline real?
- Qué está confirmado y qué no
- Errores comunes al armar una cadena de prompts
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El prompt chaining 2.0 pasa de cadenas lineales a grafos adaptativos con tres ejes: flexibilidad estructural, condicionamiento dinámico y anclaje semántico.
- Tree-of-Thought (ToT) genera múltiples “pensamientos” por paso y los puntúa con un modelo verificador liviano, con una mejora reportada de 12-15% en corrección según el artículo de dev.to.
- Claude Opus 4.6 salió el 5 de febrero de 2026 según el anuncio oficial de Anthropic; para el 22 de septiembre de 2026 ya está disponible Claude Opus 5.5, más barato y más rápido.
- Claude Opus 5.5 cuesta 4 dólares por millón de tokens de entrada y 20 dólares por millón de salida, un 20% menos que Opus 5, según el mismo comunicado de Anthropic.
- El riesgo central de encadenar prompts es la propagación de errores entre pasos cuando no hay validación de esquema JSON en cada conector.
¿Qué es el prompt chaining 2.0 y en qué se diferencia del encadenamiento tradicional?
El prompt chaining tradicional es una secuencia lineal donde cada sub-prompt recibe el texto crudo del paso anterior y devuelve un nuevo string, un modelo documentado por IBM Research según cita el artículo de dev.to. Sirve para pipelines deterministas tipo “extraer → transformar → cargar”, pero se queda corto cuando el problema no tiene un camino único.
La versión 2.0 agrega tres ejes que cambian la lógica de fondo. Primero, flexibilidad estructural: la cadena puede ser un árbol, un DAG o incluso un loop cíclico, expresado como grafo en JSON. Segundo, condicionamiento dinámico: el modelo decide en tiempo real qué rama seguir según un score de confianza o una señal externa. Tercero, anclaje semántico: retrieval por embeddings que inyecta conocimiento de dominio sin inflar el prompt con texto de más.
¿Y esto para qué sirve en la práctica? Para que un sistema de troubleshooting distribuido, ponele, no siga un guion rígido cuando el error real no encaja en ninguno de los pasos previstos.
¿Qué técnicas nuevas incluye el prompt chaining 2.0 para razonamiento multi-paso?
El artículo de dev.to describe cinco técnicas concretas, cada una con un caso de uso distinto. No son excluyentes: en un pipeline real conviven varias, según la etapa. En las novedades de GPT-5.6 Sol para usuarios Plus profundizamos sobre esto.
Pipelines estructurados con contratos JSON
Cada sub-prompt tiene un esquema de entrada y salida bien definido, con validación estricta. El ejemplo del artículo es un análisis de riesgo financiero en tres pasos: extraer cifras (activos, pasivos, ingreso neto), calcular ratios de deuda-a-patrimonio y retorno sobre patrimonio, y emitir un veredicto de riesgo. Esto emula el modelo ETL clásico pero le suma una capa de razonamiento explicada en cada paso.
Branching condicional dinámico
Acá entra un router prompt que devuelve una etiqueta (SUMMARIZE, CALCULATE, QUERY_DB, FINISH) y un orquestador que mapea esa etiqueta a un nodo de ejecución concreto, en loop hasta llegar a un tag terminal. El costo de este paso de ruteo es bajo, unos 20 tokens por decisión según el artículo, lo que lo hace viable incluso en cadenas largas.
Tree-of-Thought (ToT) prompting
Tree-of-Thought expande una sola cadena de razonamiento en una búsqueda por amplitud: el modelo genera varios “pensamientos” posibles en cada nivel de profundidad y un modelo verificador liviano (el artículo menciona algo tipo Claude-mini) puntúa cada rama para podar el árbol. El artículo reporta una mejora de 12-15% en corrección de respuesta sobre benchmarks de razonamiento, aunque aclara que esto surge de una versión simplificada de scoring y que en producción conviene reemplazarlo por un modelo crítico entrenado.
Prompting maiéutico
Tomado del método socrático, funciona en tres pasos: pedirle al modelo que liste sus supuestos, que justifique su razonamiento en dos o tres oraciones, y recién ahí que responda. La utilidad dentro de una cadena es que el campo de supuestos se puede cruzar contra una base de conocimiento externa antes de avanzar al siguiente paso, lo que reduce la propagación de errores entre eslabones.
Directional-stimulus steering
Es la versión liviana del prompting maiéutico: en vez de un diálogo socrático completo, se antepone una directiva corta que orienta el estilo de razonamiento, del tipo “pensá como un data engineer” o “adoptá una postura conservadora ante el riesgo”. El artículo sugiere guardar estas directivas en un archivo YAML e inyectarlas según lo que decida el router. Te puede servir nuestra cobertura de nuestra guía de herramientas para desarrolladores.
¿Cómo se integra el prompt chaining con Claude Opus y GPT-5.4 Pro?
Claude Opus incorpora una spec de tool_use que declara un set de herramientas en el mensaje de sistema y genera automáticamente objetos tool_call, según describe el artículo de dev.to, eliminando la capa manual de routing que armamos a mano en la técnica de branching. Cada “tool” puede ser una función Python, un endpoint REST containerizado o incluso otra llamada a Claude.
Ahora bien, acá hay algo que vale la pena marcar. El artículo de dev.to, publicado el mismo 28 de septiembre de 2026, habla de “Claude 4.6 Opus Agentic Workflows” como si fuera el modelo de punta del momento. Pero al 28 de septiembre de 2026 esa versión ya no es la vigente: según el historial oficial de Anthropic, Claude Opus 4.6 salió el 5 de febrero de 2026, y desde entonces la compañía lanzó Opus 4.7 (16 de abril), Opus 4.8 (28 de mayo), Opus 5 (24 de julio) y Opus 5.5 (22 de septiembre), este último descripto por Anthropic como “el Opus más fuerte hasta ahora” y disponible hoy como el modelo de punta. O sea: el artículo técnico que estamos resumiendo ya está citando una versión con siete meses de atraso respecto al catálogo real de Anthropic al momento de su publicación.
¿Importa esto para el lector? Sí, y bastante. Los primitivos de tool_use que describe el artículo siguen siendo válidos como concepto, pero el pricing y las capacidades de agente concreto hay que chequearlos contra la versión vigente, Opus 5.5, no contra 4.6. Opus 5.5 cuesta 4 dólares por millón de tokens de entrada y 20 por millón de salida (un 20% menos que Opus 5), con cache reads a 0,20 dólares por millón de tokens, un 60% más barato que la generación anterior, según el comunicado oficial de Anthropic.
Sobre “GPT-5.4 Pro Parallel Agents”, que el artículo de dev.to menciona como la contraparte de OpenAI con primitivos nativos de “agentic steps” y “parallel branches”: no encontramos un anuncio oficial de OpenAI que confirme esos detalles de forma independiente. Tomalo con pinzas hasta que aparezca la fuente primaria.
| Técnica | Cuándo conviene usarla | Costo/latencia relativo | Riesgo principal |
|---|---|---|---|
| Pipeline estructurado (JSON) | Tareas deterministas con salida tabular | Bajo (llamadas fijas) | Esquema mal validado propaga errores |
| Branching dinámico | Tareas con múltiples rutas posibles | Medio (router + N nodos) | Loops sin límite de iteraciones |
| Tree-of-Thought | Problemas de razonamiento con varias soluciones candidatas | Alto (genera y puntúa varias ramas) | Scoring débil sin modelo crítico entrenado |
| Prompting maiéutico | Validar supuestos antes de responder | Medio (3 llamadas por paso) | Supuestos no verificados contra fuente externa |
| Directional-stimulus | Ajustar tono/estilo sin reestructurar todo | Bajo (una directiva corta) | Directiva ambigua no cambia el resultado |
¿Qué limitaciones y riesgos tiene encadenar prompts en producción?
El riesgo más frecuente es la propagación de errores entre pasos cuando no hay validación de esquema en cada conector. Si el paso de extracción devuelve un JSON con un campo faltante y nadie lo chequea, ese hueco viaja intacto hasta el veredicto final (spoiler: el usuario recién lo nota cuando el número no cierra).
Cada llamada extra al modelo suma costo y latencia. Subís el modelo, lo probás en local, funciona bárbaro, armás la cadena de cinco pasos, la mandás a producción y de repente la factura mensual se triplica porque nadie calculó cuántos tokens consume el router en cada iteración del loop de branching. Sobre eso hablamos en el nuevo agente de Copilot para Jira.
El Tree-of-Thought tiene otra trampa. La mejora de 12-15% en corrección que reporta el artículo de dev.to viene de una implementación simplificada, con un modelo verificador liviano tipo “sí/no” sobre consistencia lógica. Eso no es una garantía universal: en producción conviene reemplazar ese scoring ad hoc por un modelo crítico entrenado específicamente, algo que el propio artículo recomienda pero no detalla cómo entrenar.
Si vas a correr estos orquestadores 24/7, necesitás infraestructura estable: un VPS o servidor que no se caiga a mitad de un loop de branching con quince llamadas pendientes. Para eso, donweb.com tiene planes de hosting cloud pensados para procesos que corren sin supervisión.
¿Cómo implementar una cadena de prompts en un pipeline real?
El ejemplo del artículo de dev.to arma un pipeline de evaluación de riesgo financiero en Python con tres funciones encadenadas: step_extract, que saca activos, pasivos e ingreso neto de un reporte con temperature 0.0 para minimizar variación; step_ratios, que calcula deuda-a-patrimonio y retorno sobre patrimonio a partir del JSON anterior; y step_verdict, que emite un nivel de riesgo (bajo, medio, alto) con temperature 0.3, usando el modelo gpt-5.4-pro.
- Extracción determinística: temperature en 0.0 para que el paso de extracción de cifras no invente números.
- Contratos JSON explícitos: cada función espera y devuelve un esquema fijo, lo que hace el debugging trivial cuando algo falla.
- Orquestador simple: una función
run()que encadena los tres pasos y se puede meter directo en un pipeline de CI/CD.
La ventaja de este patrón es que cualquiera que haya armado un pipeline de datos reconoce la lógica al toque: es ETL con una capa de razonamiento en el medio.
Qué está confirmado y qué no
- Confirmado: Claude Opus 4.6 salió el 5 de febrero de 2026 y Claude Opus 5.5 el 22 de septiembre de 2026, ambos según el anuncio oficial de Anthropic, con pricing público de 4 dólares por millón de tokens de entrada y 20 por millón de salida para Opus 5.5.
- Confirmado: las cinco técnicas de prompt chaining 2.0 (pipelines JSON, branching dinámico, ToT, maiéutico, directional-stimulus) están descriptas con código de ejemplo en el artículo de dev.to del 28 de septiembre de 2026.
- No confirmado de forma independiente: los primitivos “GPT-5.4 Pro Parallel Agents” que menciona el artículo de dev.to, ya que no hay un anuncio oficial de OpenAI adjunto que los detalle.
- No confirmado como garantía universal: la mejora de 12-15% en corrección de ToT, que corresponde a una implementación simplificada y no a un benchmark independiente verificado.
Errores comunes al armar una cadena de prompts
- No validar el JSON entre pasos: si el conector no chequea el esquema de salida antes de pasarlo al siguiente nodo, un campo vacío o mal tipado revienta silenciosamente varios pasos después, cuando ya es difícil rastrear el origen.
- Usar temperature alta en pasos de extracción: para sacar cifras de un documento, temperature 0.0 es lo que corresponde. Subirla “para variar un poco” mete alucinaciones justo donde no las podés tolerar.
- No poner límite a los loops de branching: un router mal calibrado puede quedar rebotando entre SUMMARIZE y CALCULATE sin llegar nunca a FINISH. Poné un contador máximo de iteraciones, siempre.
- Confundir prompt chaining con chain-of-thought: el chain-of-thought pasa dentro de una sola llamada, pidiéndole al modelo que razone paso a paso en un mismo prompt. El prompt chaining encadena múltiples llamadas independientes, cada una con su propio contrato de entrada y salida.
Preguntas Frecuentes
¿Qué es el prompt chaining y para qué sirve?
El prompt chaining es una técnica que divide una tarea compleja en una secuencia de sub-prompts conectados, donde la salida de un paso alimenta al siguiente. Sirve para tareas que no se resuelven bien en una sola llamada, como análisis financiero multi-paso o troubleshooting de sistemas distribuidos.
¿Cuál es la diferencia entre prompt chaining y chain of thought?
El chain-of-thought ocurre dentro de una sola llamada al modelo, pidiéndole que razone paso a paso antes de responder. El prompt chaining encadena múltiples llamadas separadas, cada una con su propio prompt, contrato de entrada y salida, y a veces hasta un modelo distinto por paso. Más contexto en la comparativa de costos y routing en DeepSWE.
¿Cómo se usa el prompt chaining en Claude o GPT?
En Claude Opus, la spec de tool_use declara las herramientas disponibles en el mensaje de sistema y el modelo genera objetos tool_call automáticamente, sin necesidad de armar el router a mano. Con GPT, según el ejemplo del artículo de dev.to, la orquestación se arma con funciones Python que llaman al modelo en cada paso y parsean el JSON de salida.
¿Qué es el Tree of Thought prompting?
El Tree-of-Thought (ToT) es una técnica que expande una cadena de razonamiento en una búsqueda por amplitud: el modelo genera varios “pensamientos” posibles en cada nivel de profundidad y un modelo verificador puntúa cada rama para descartar las menos consistentes. El artículo de dev.to reporta una mejora de 12-15% en corrección sobre benchmarks de razonamiento con una implementación simplificada de este método.
¿Cómo evitar que se propaguen errores en una cadena de prompts?
Validando el esquema JSON de cada paso antes de pasarlo al siguiente nodo de la cadena. El prompting maiéutico ayuda porque el campo de “supuestos” que genera cada paso se puede cruzar contra una base de conocimiento externa antes de avanzar, lo que corta el error antes de que llegue al veredicto final.
Conclusión
El prompt chaining dejó de ser un truco de research para convertirse en un patrón de diseño de producción, con contratos JSON, routers y modelos verificadores como piezas estándar. Lo que cambió en esta versión 2.0 no es tanto la idea de encadenar prompts (eso ya lo hacíamos hace rato) sino que ahora el modelo participa de la decisión de qué rama seguir, en vez de que el desarrollador la codifique a mano.
Si estás armando algo así, arrancá simple: un pipeline estructurado de tres pasos con validación de esquema, sin ToT ni branching todavía. Medí costo y latencia real antes de sumar complejidad. Y ojo con las fuentes que citan versiones de modelos: el mismo artículo que estamos comentando ya quedó siete meses atrás respecto al catálogo real de Anthropic el día que se publicó, así que antes de fijar pricing o capacidades en un contrato, chequeá la página oficial del modelo que vas a usar.