Un usuario pregunta en el chat de soporte algo casi idéntico a lo que ya preguntó hace una hora. La respuesta existe, la llamada al modelo cuesta. ¿Se reutiliza? Esa es la pregunta que M. T. Ramkrushna publicó este viernes 20 de noviembre en DEV Community, con cuatro opciones sobre la mesa: no cachear nada (A), cachear solo coincidencias exactas (B), usar un único umbral de similitud para todo (C) o combinar caché exacta con caché semántica acotada, con vencimiento y umbral calibrado (D). Su postura: coincidencia exacta en todos los casos y caché semántica solo donde hay muchas repeticiones.
La discusión no es un ejercicio teórico. Los números de ahorro son concretos y están publicados; el riesgo también. Un hit equivocado no se parece a un error: se parece a una respuesta normal del bot, con la misma tipografía y la misma seguridad. Por eso la decisión de cachear no es solo de costo, es de tolerancia al error.
En este artículo:
- ¿Qué es una caché semántica de respuestas LLM y cómo funciona?
- Cuánto se ahorra: hasta 68,8% menos llamadas a la API
- ¿Por qué un umbral de similitud fijo devuelve respuestas equivocadas?
- ¿Cuándo conviene reutilizar una respuesta cacheada y cuándo no?
- ¿Cómo se elige el umbral con datos propios?
- Qué se puede concluir con estos datos y qué no
- Referencias
- Fuentes
¿Qué es una caché semántica de respuestas LLM y cómo funciona?
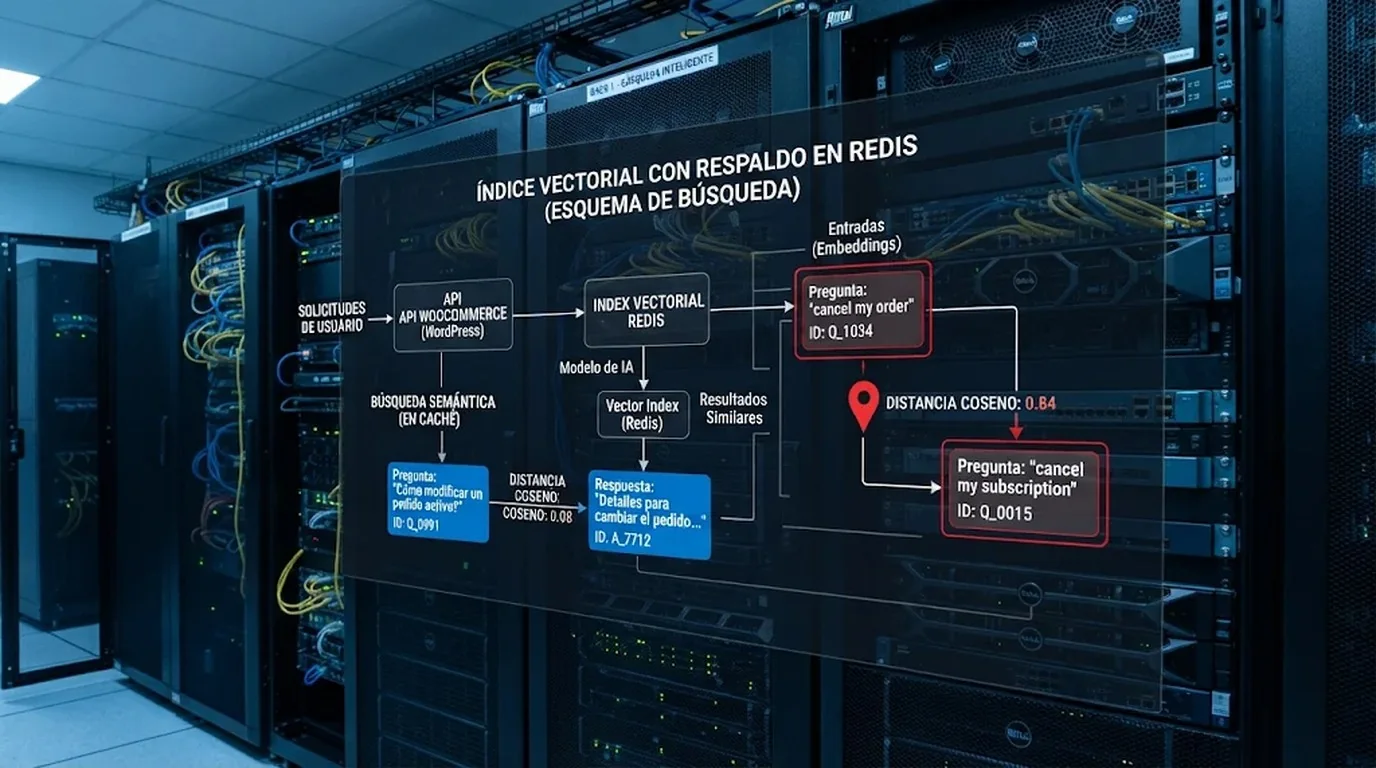
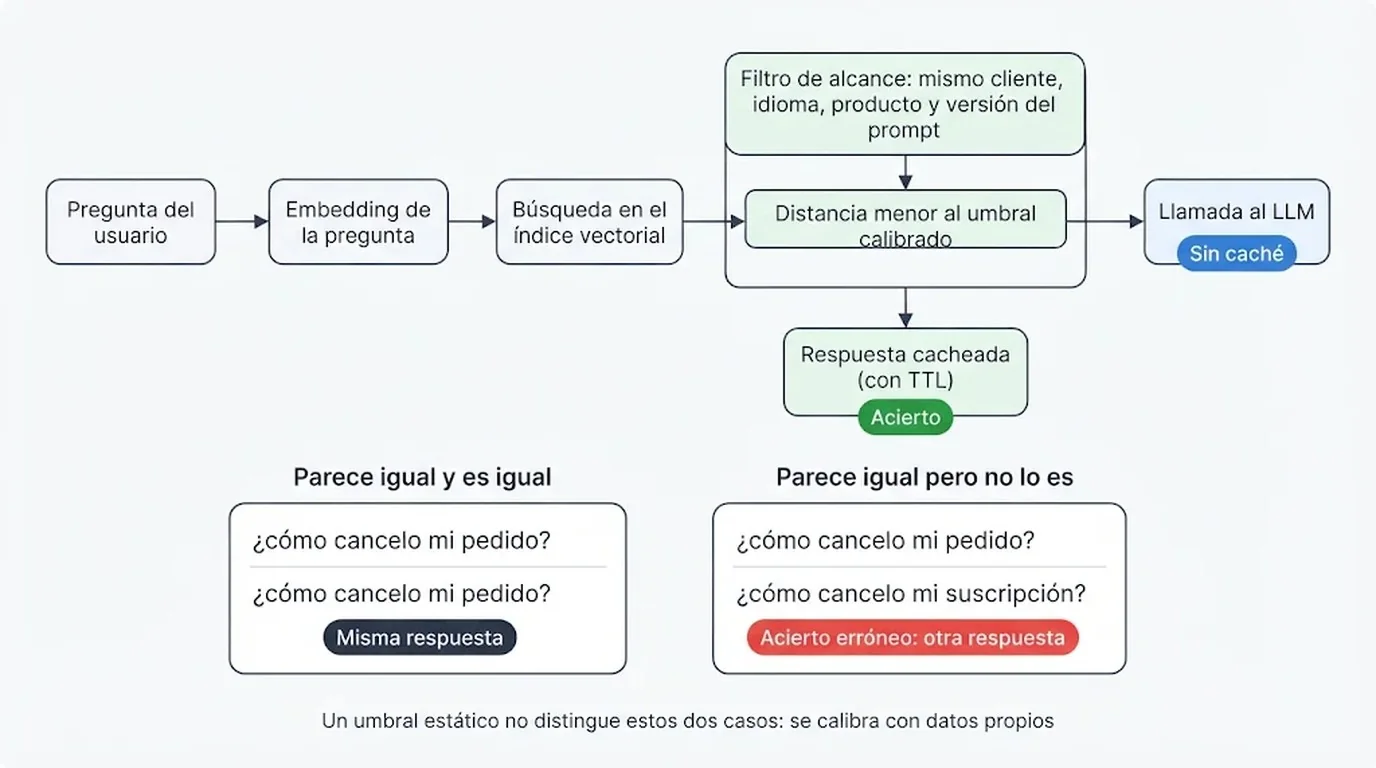
Una caché semántica de respuestas LLM guarda cada pregunta junto con la respuesta y el embedding de esa pregunta. Cuando llega una consulta nueva, calcula su embedding, busca en el índice vectorial la pregunta cacheada más cercana y, si la distancia queda por debajo de un umbral, devuelve la respuesta guardada sin llamar al modelo. La caché exacta, en cambio, solo acierta si el texto normalizado es idéntico. Tema relacionado: nuestra guía completa de ChatGPT.
El recorrido completo, con los componentes que intervienen:
- Coincidencia exacta primero. Se normaliza el texto (espacios, mayúsculas) y se busca un hash idéntico. Es barato y no puede devolver la respuesta de otra pregunta.
- Embedding de la consulta. Si no hubo hit exacto, se vectoriza la pregunta con el mismo modelo que se usó para indexar.
- Búsqueda del vecino más cercano. El índice vectorial devuelve la pregunta cacheada más próxima, idealmente restringida con filtros de contexto (cliente, idioma, producto, versión del prompt y del modelo).
- Comparación contra el umbral. Ahí se decide si las dos preguntas son «suficientemente parecidas».
- Hit o miss. En un hit se registra la distancia y la pregunta que matcheó; en un miss se llama al modelo y se guarda el par con su tiempo de vida (TTL).
Ese paso cuatro es el que concentra el problema: un solo parámetro tiene que decidir a la vez cuánto se ahorra y cuánto se arriesga.
Cuánto se ahorra: hasta 68,8% menos llamadas a la API
El paper GPT Semantic Cache (Regmi & Pun, arXiv 2411.05276, noviembre de 2024) describe una caché semántica sobre Redis y reporta una reducción de llamadas a la API de hasta 68,8%, con tasas de acierto de caché de entre 61,6% y 68,8% y un «positive hit rate» superior al 97%, es decir, respuestas cacheadas que resultaron correctas al ser evaluadas.
Vale mirar en qué tráfico se midió: soporte técnico, consultas de pedidos y envíos y preguntas de compra. Categorías de atención al cliente donde la misma pregunta vuelve a entrar muchas veces, con variaciones menores. El dato no dice que cualquier aplicación ahorre un 68,8%: dice que en tráfico repetitivo y de baja personalización el ahorro puede ser alto. Extrapolarlo a un asistente que responde sobre el estado de cuenta de cada usuario sería un error de lectura. Complementá con nuestra guía sobre qué modelo de GPT estás usando.
¿Por qué un umbral de similitud fijo devuelve respuestas equivocadas?
Porque dos preguntas pueden estar muy cerca en el espacio de embeddings y necesitar respuestas distintas. Un umbral lo bastante permisivo como para capturar paráfrasis reales también captura pares que se parecen en la forma pero no en el fondo: el ejemplo del propio post es «How do I cancel my order?» contra «How do I cancel my subscription?», dos consultas que un usuario nunca querría ver respondidas de la misma manera.
El paper vCache: Verified Semantic Prompt Caching (Schroeder et al., arXiv 2502.03771, con revisión de febrero de 2026 y presentación en ICLR 2026) sostiene que los umbrales estáticos aplicados a todas las consultas no ofrecen garantías formales de corrección, producen tasas de error inesperadas y dejan aciertos sin aprovechar. Su propuesta es aprender un umbral por cada pregunta cacheada, en línea, contra una tasa máxima de error definida por quien opera el sistema; frente a baselines de umbral estático y de embeddings ajustados, reportan hasta 12,5 veces más aciertos de caché y 26 veces menos errores.
Los valores por defecto de las herramientas más usadas dan una idea de la escala con la que se trabaja: 0,1 en RedisVL y 0,8 en GPTCache, según lo relevado en noviembre de 2026. Sobre esto profundizamos en «Cuándo llega GPT-6 Astra a Copilot».
| Implementación | Parámetro | Escala | Valor por defecto |
|---|---|---|---|
RedisVL SemanticCache | distance_threshold (distancia coseno) | 0 a 2; más bajo, más estricto | 0,1 |
| GPTCache | similarity_threshold | 0 a 1 | 0,8 |
| vCache | umbral por prompt aprendido en línea | contra una tasa de error máxima fijada por el usuario | no aplica: se estima |
Además del umbral, RedisVL expone ttl, filterable_fields y la posibilidad de refrescar el TTL en cada hit, mientras que GPTCache permite enchufar distintos evaluadores de similitud, desde un chequeo de distancia hasta evaluadores basados en modelo y en reranking. Son las piezas con las que se puede acotar el riesgo sin apagar la caché.
¿Cuándo conviene reutilizar una respuesta cacheada y cuándo no?
Conviene cuando la pregunta se repite mucho, no depende de datos personales ni de estado de cuenta y su respuesta no cambia rápido: documentación estable, políticas vigentes, preguntas frecuentes de producto. No conviene cuando la respuesta depende del usuario, de la hora o de información privada, ni en tráfico con poca repetición, donde se paga el costo de embeber cada consulta y casi nunca se acierta.
Las cuatro opciones del post se ordenan así:
- A, sin caché: simple y siempre correcto en términos de frescura, pero se paga precio y latencia completos en cada repetición. Puede tener sentido con volumen bajo.
- B, solo coincidencia exacta: casi gratis y estructuralmente incapaz de responder otra pregunta. Es el piso razonable para cualquier chatbot.
- C, un umbral global: es donde aparecen los hits incorrectos, sobre todo con preguntas personales, entidades que se leen parecido y respuestas que quedaron viejas.
- D, exacta más semántica acotada: conserva el ahorro y le pone cerco al riesgo con alcance, vencimiento y umbral medido.
La opción D se sostiene sobre cuatro decisiones concretas. La primera es el alcance: cachear solo preguntas no personales y particionar las entradas con filtros de tenant, idioma, producto y versión de prompt o modelo, de modo que un hit solo pueda venir del mismo contexto. La segunda es el vencimiento: un TTL para que las respuestas sobre precios, políticas o documentación no sobrevivan a su fuente. La tercera es la calibración del umbral con datos propios. La cuarta es la trazabilidad: registrar cada hit con la pregunta que matcheó y su distancia, y poder borrar entradas puntuales además de vaciar la caché completa.
¿Cómo se elige el umbral con datos propios?
Juntando pares reales del propio tráfico y etiquetándolos en dos grupos: paráfrasis que deberían compartir respuesta y pares «parecidos pero distintos» que no. Con ese set se barren distintos umbrales y se mide cuántos falsos positivos y cuántos aciertos legítimos produce cada uno. El umbral se elige por error medido, no por el valor que trae la librería.
Las métricas que hay que vigilar no son solo el hit rate. También el wrong-hit rate, con muestreo y revisión humana, y el costo y la latencia ahorrados. En una interfaz de atención al usuario, la precisión de las respuestas servidas desde caché funciona mejor como piso de calidad que como un objetivo agresivo de aciertos.
¿Cómo invalido las respuestas cacheadas cuando cambia la documentación?
Con dos mecanismos combinados: un TTL que expire solo y una versión en el alcance que separe por completo las entradas viejas de las nuevas. Cuando cambia la base de conocimiento o el system prompt, se sube la versión del filtro y las respuestas anteriores dejan de ser candidatas sin necesidad de borrar nada. Para casos puntuales, RedisVL permite eliminar entradas por ID o clave con drop, y clear para vaciar las claves de la caché dejando el índice en pie.
Qué se puede concluir con estos datos y qué no
Lo que está respaldado: que la caché semántica reduce llamadas en tráfico repetitivo con números medidos en un conjunto acotado de categorías; que los umbrales estáticos no ofrecen garantías de corrección y que un esquema con umbral por pregunta, orientado a una tasa de error máxima, reporta mejores resultados que los baselines estáticos. Lo que no se puede concluir: que un umbral determinado funcione en otro producto, ni que el ahorro de un caso de soporte se replique en un asistente con datos por usuario.
Como criterio práctico de verificación —una propuesta editorial, no un test que hayamos corrido—, antes de habilitar caché semántica en producción conviene armar un conjunto de 100 a 200 pares tomados del histórico real, con etiquetas de «misma respuesta» y «respuesta distinta», y correr el barrido de umbrales sobre ese set. Si la tasa de falsos positivos en los pares críticos no es aceptable para el negocio, la respuesta es la opción B: quedarse en coincidencia exacta hasta tener mejores datos. La pregunta del viernes no se responde con una preferencia técnica, se responde con la medición de cuántos errores está dispuesto a tolerar quien opera el bot.
Referencias
- M. T. Ramkrushna, «Would you serve a cached LLM answer to a question that only looks the same? (Friday AI question)», DEV Community, 20 de noviembre de 2026: dev.to
- S. Regmi y C. Phakami Pun, «GPT Semantic Cache: Reducing LLM Costs and Latency via Semantic Embedding Caching», arXiv 2411.05276: arxiv.org/abs/2411.05276
- L. G. Schroeder et al., «vCache: Verified Semantic Prompt Caching», arXiv 2502.03771: arxiv.org/abs/2502.03771
- Redis, documentación de la API de caché LLM (clase
SemanticCache): redis.io - GPTCache, evaluación de similitud: gptcache.readthedocs.io
- GPTCache, configuración: gptcache.readthedocs.io
Fuentes
- S. Regmi y C. Phakami Pun, «GPT Semantic Cache: Reducing LLM Costs and Latency via Semantic Embedding Caching» (arXiv 2411.05276) – paper que documenta una caché semántica LLM sobre Redis: hasta 68,8% menos llamadas a la API, tasas de acierto de 61,6% a 68,8% y aciertos positivos por encima del 97%
- L. G. Schroeder et al., «vCache: Verified Semantic Prompt Caching» (arXiv 2502.03771) – paper que observa que los umbrales estáticos no dan garantías formales de correctitud y propone aprender un umbral por prompt con una tasa de error máxima definida por el usuario
- Redis, documentación de la API de caché LLM (SemanticCache) – referencia oficial de
distance_thresholden unidades COSINE [0-2] con valor por defecto 0,1, además dettl,filterable_fieldsyrefresh_ttl_on_hit - GPTCache, evaluación de similitud – evaluadores de similitud conectables, del chequeo de distancia simple a los basados en modelo y rerank
- GPTCache, configuración – módulo de configuración con los parámetros por defecto de la librería, incluido el umbral de similitud de 0,8
- M. T. Ramkrushna, «Would you serve a cached LLM answer to a question that only looks the same? (Friday AI question)», DEV Community – la pregunta original con las cuatro opciones (A sin caché, B coincidencia exacta, C umbral único, D exacta más semántica acotada) y el razonamiento del autor