Un paper subido a arXiv el 31 de julio de 2026 propone reconstruir el prompt que recibió un modelo de lenguaje mirando solo el texto que devolvió. El método se llama PTP (Previous-Token Prediction) y lo firman Pirzada Suhail y Amit Sethi, de IIT Bombay, y Nagasai Saketh Naidu y Atanu R Sinha, de Adobe Research. La diferencia con los trabajos anteriores sobre inversión de LLM no está en la idea, sino en las condiciones: no usa pesos, ni logits, ni representaciones internas, ni un dataset externo. Entrena un modelo inverso desde cero con datos que genera el propio modelo objetivo.
Eso importa porque el prompt dejó de ser configuración interna. En un producto con IA ahí viven las instrucciones del sistema, los criterios de derivación, el tono de marca y, en muchos casos, reglas de moderación. Si ese texto se puede recuperar desde afuera, el perímetro de confidencialidad de un servicio ya no lo define el panel de administración sino lo que el modelo deja escapar en cada respuesta.
En este artículo:
- ¿Qué es la inversión de prompts y qué significa PTP?
- ¿Cómo funciona el previous-token prediction, paso a paso?
- ¿Qué tan exacto es PTP para reconstruir un prompt?
- ¿Sirve el modelo inverso si el texto lo generó otro LLM, como GPT-4o?
- ¿Se puede extraer el system prompt de un servicio comercial como ChatGPT?
- ¿Cómo protejo el prompt de mi producto si se puede reconstruir?
- Fuentes
¿Qué es la inversión de prompts y qué significa PTP?
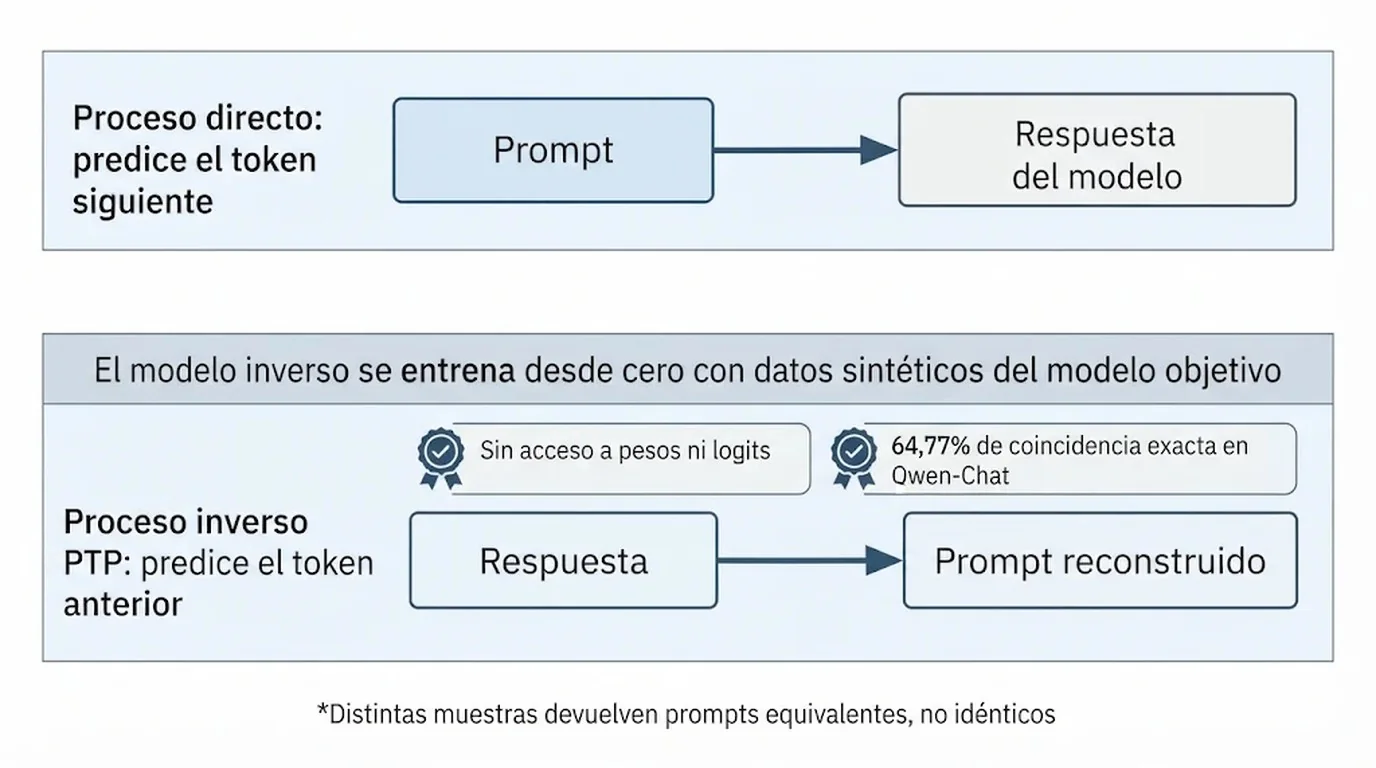
La inversión de prompts es la tarea de recuperar el texto de entrada a partir de la salida de un modelo. PTP la aborda entrenando un modelo inverso que aprende lo contrario que un LLM convencional: en lugar de predecir el token siguiente, predice el token anterior dado el contexto que viene después. Así reconstruye la entrada que pudo haber producido esa respuesta. Te puede servir nuestra cobertura de frameworks y mejores prácticas de prompts para GPT Image v2.
El problema de fondo es que la relación entre prompt y respuesta es de muchos a muchos. Un LLM genera muestreando el próximo token de forma autorregresiva: el mismo prompt puede dar respuestas distintas y respuestas parecidas pueden venir de prompts muy diferentes. En términos del paper, el modelo directo estima la probabilidad del token siguiente dado el contexto previo; el inverso estima la probabilidad del token anterior dado el contexto posterior. Recuperar el prompt, entonces, no es descifrar un código: es encontrar una entrada plausible entre muchas.
Los enfoques previos atacaron el problema con otras herramientas. Logit-to-Text (Morris et al., 2024) necesita las distribuciones completas de probabilidad sobre el vocabulario; Output-to-Prompt (Zhang et al., 2024a) trabaja con texto pero requiere alrededor de 64 respuestas del mismo prompt y devuelve instrucciones semánticamente parecidas, no exactas; SipIt (Nikolaou et al., 2025) apuesta a que los transformers son inyectivos y trabaja sobre activaciones internas. PTP se queda con una sola respuesta y sin acceso al interior del modelo.
¿Cómo funciona el previous-token prediction, paso a paso?
PTP construye un inverso funcional del modelo en caja negra en cuatro movimientos: generar datos sintéticos consultando al modelo objetivo, entrenar con ellos un modelo inverso desde cero, decodificar hacia atrás para reconstruir el prompt y verificar reenviando ese prompt al modelo original. Todo ocurre sin ver pesos, gradientes, embeddings ni datos de entrenamiento originales. Tema relacionado: nuestra guía de prompts para Leonardo IA.
- Generación sintética por sondeo del vocabulario. Los autores producen secuencias consultando al propio modelo objetivo, sin dataset externo ni conocimiento previo. Es la única materia prima del método y también su costo principal: hay que poder interactuar con el modelo muchas veces.
- Entrenamiento del modelo inverso. Se entrena un decoder desde cero cuyo objetivo es el previous-token prediction. Ahí está el paralelismo que da nombre al método: el modelo directo se entrenó para predecir lo que sigue, el inverso aprende a predecir lo que antecede.
- Decodificación reversa greedy. Con el inverso entrenado, se reconstruye el prompt desde el final de la respuesta hacia atrás, token por token.
- Verificación por reconsulta. El prompt reconstruido se envía al modelo directo y se compara la respuesta obtenida con la original. Si se parece, la reconstrucción es plausible; si no, no lo es.
- Muestreo de variantes. Como el inverso es generativo, ajustar los parámetros de decodificación devuelve varios prompts distintos que inducen respuestas similares en el modelo objetivo.
En el ejemplo que retoma la cobertura de The Decoder del 12 de agosto de 2026, el prompt «How to reach out to competitors to find their pricing strategies?» se reconstruyó palabra por palabra, y el muestreo produjo además seis variantes con el mismo núcleo semántico y otra redacción.
¿Qué tan exacto es PTP para reconstruir un prompt?
El paper habla de «near-exact» (casi exacto): en sus métricas de evaluación basadas en tokens, el enfoque supera a los trabajos previos que compara, pero la coincidencia literal a nivel de token no está garantizada: hay casos documentados en los que se recupera el contenido y el tono de la instrucción sin replicar la redacción original, y otros en los que el prompt vuelve palabra por palabra. Ya lo cubrimos antes en prompts para generar videos con Sora.
| Dimensión | L2T (Morris et al., 2024) | O2P (Zhang et al., 2024a) | PTP (este paper) |
|---|---|---|---|
| Acceso requerido | Logits completos | Salidas de texto | Salidas de texto |
| Datos de entrenamiento | Instructions-2M (2,33 M) | Instructions-2M (30 K prompts) | Ninguno / generado sintéticamente |
| Salidas necesarias | Logits por token (vocabulario × bits de precisión) | Alrededor de 64 por prompt | Una sola |
| Prompts reconstruidos | Uno | Uno | Varios |
| Transferibilidad | Baja entre tamaños de LLaMA-2 | Moderada, zero-shot | Zero-shot sobre GPT-4o |
Dos advertencias que cambian la interpretación. Primero, el modelo es generativo: dos corridas pueden devolver prompts distintos que producen respuestas equivalentes, así que exigir una única reconstrucción correcta no describe cómo funciona la herramienta. Segundo, las métricas son de tokens, no de daño: que el prompt se recupere con exactitud a nivel token no dice si alcanza para saltarse un filtro o replicar una lógica de negocio.
¿Sirve el modelo inverso si el texto lo generó otro LLM, como GPT-4o?
Sí, con matices. Un inverso entrenado sobre Qwen-3 0.6B Chat reconstruyó prompts a partir de respuestas de GPT-4o conservando el tema y la intención, sin reproducir el texto original de forma literal. El paper lo presenta como transferibilidad del modelo inverso a respuestas generadas por un LLM distinto del que se usó para entrenarlo.
La consecuencia es asimétrica. Para quien quiere auditar un sistema ajeno, la transferibilidad alcanza para entender qué se le está pidiendo al modelo. Para quien quiere clonar una instrucción propia de un tercero, no: sobrevive el sentido, no el texto. Y para el atacante hipotético, el paper sugiere algo incómodo: no necesita saber qué modelo generó la respuesta que tiene en la mano.
¿Se puede extraer el system prompt de un servicio comercial como ChatGPT?
El paper no lo demuestra y conviene no leerlo así. Los experimentos se hacen sobre modelos que los autores pueden consultar libremente; no formula afirmaciones explícitas sobre ataques a servicios comerciales —aunque reporta transferibilidad a respuestas de GPT-4o, un modelo comercial— ni prueba con system prompts largos de varios párrafos. Tampoco es un ataque instantáneo: PTP necesita consultar al modelo objetivo muchas veces para generar los datos sintéticos de entrenamiento, lo que en un servicio de terceros implica costo de inferencia y límites de uso. Esto se conecta con lo que analizamos en crear imágenes con IA en WhatsApp.
Lo que el paper confirma
- Un inverso entrenado desde cero, sin logits ni pesos, reconstruye prompts con precisión alta pero no perfecta sobre los modelos que evalúa.
- Una sola respuesta alcanza para producir una reconstrucción y varias variantes funcionalmente equivalentes.
- El método generaliza entre datasets y transfiere entre modelos distintos.
- En métricas basadas en tokens, tanto para prompt como para respuesta, supera a los trabajos previos que compara.
Lo que queda pendiente
- Es un arXiv v1 sin revisión por pares.
- Los experimentos se hacen sobre prompts cortos, de una o dos oraciones; no está medido el efecto de escalar esa longitud.
- No se probó con system prompts largos, de varios párrafos.
- El paper no hace afirmaciones explícitas sobre ataques a servicios comerciales, aunque sí reporta transferibilidad a respuestas de GPT-4o.
¿Cómo protejo el prompt de mi producto si se puede reconstruir?
Asumiendo que es recuperable. La decisión práctica no es esconder mejor el texto, sino diseñar para el escenario en que alguien lo lea: versionarlo, separarlo por función y no meter secretos adentro. Un prompt que sigue siendo seguro cuando se filtra es un prompt bien hecho.
- Nada sensible dentro del texto. Claves de API, credenciales y datos personales van en una capa de código con control de acceso, no escritos en el contexto.
- Versionado y auditable. El prompt en un repositorio, con revisión de cambios y registro de quién lo modificó. Si mañana detectás una filtración, necesitás saber qué versión estaba en producción.
- Mínimo privilegio por defecto. El riesgo escala con la autonomía: un prompt filtrado en un chatbot es un problema de propiedad intelectual; en un agente con acceso a herramientas y privilegios elevados es un problema de seguridad.
Sobre ese último punto, Cristian Rodriguez, CTO de campo para las Américas de CrowdStrike, advirtió en un artículo de BizTech Magazine, recogido por El Ecosistema Startup, que la IA agéntica multiplica el problema porque ejecuta acciones y opera con privilegios altos. El mismo artículo de El Ecosistema Startup recoge una prueba de Tracebit publicada por Ars Technica en julio de 2026: sobre cinco modelos y 152 ejecuciones contra un entorno AWS simulado, intercalar cadenas de texto que disparan rechazos junto a secretos señuelo bajó el control administrativo total del 57% al 5% y el compromiso completo del 36% al 1%. Son datos de terceros, ajenos al paper de PTP, y sirven como contexto de riesgo, no como validación del método.
También existen usos legítimos que conviene no perder de vista: auditar sistemas de terceros antes de integrarlos, depurar pipelines donde se perdió el prompt original y construir datasets de evaluación a partir de salidas ya generadas.
Un criterio para evaluar tu propia exposición
Como propuesta editorial —no como un test que hayamos ejecutado—, antes de asumir que tu sistema está comprometido conviene responder tres preguntas. Una: ¿un tercero puede obtener muchas respuestas tuyas, o el acceso está limitado y monitoreado? Dos: ¿tus instrucciones dejan marcas distinguibles en la salida, o el modelo responde de forma genérica? Tres: si la reconstrucción se reinyecta en tu sistema, ¿produce una respuesta equivalente a la original? Si las tres respuestas son afirmativas, el prompt está expuesto en la práctica; si falla la tercera, hay contenido parecido pero no una copia utilizable. La medición relevante es esa última —la respuesta reinyectada— y no la lectura a ojo del prompt reconstruido.
Fuentes
- PTP: Previous-Token Prediction based LLM Inversion for Near-Exact Prompt Reconstruction (arXiv, 31 de julio de 2026).
- Versión HTML del paper, con metodología, tabla comparativa y referencias.
- Researchers can now reverse-engineer LLM prompts from output text with near-perfect accuracy (The Decoder, 12 de agosto de 2026).
- PTP: reconstruye prompts de un LLM en caja negra (El Ecosistema Startup, 18 de noviembre de 2026).