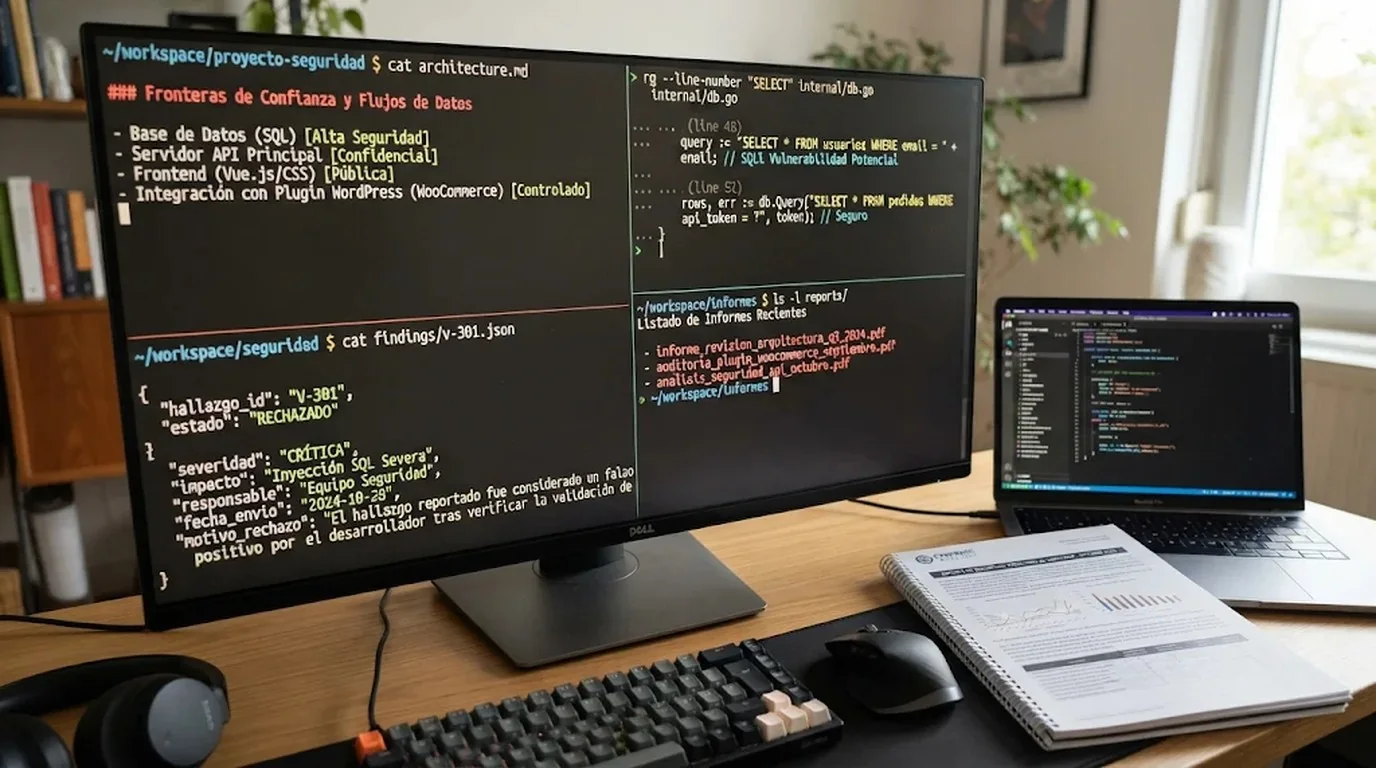
Un chat abierto sobre un repositorio devuelve notas. Algunas sirven; bastantes son conjeturas. El equipo de investigación de Rokkhe publicó el 18 de noviembre de 2026 un artículo que arranca justo en esa grieta —la distancia entre «el modelo dijo» y «esto es un hallazgo»— y propone una arquitectura chica que se puede levantar sobre un repo propio: cuatro fases, roles separados, un esquema de datos y un validador con permiso para rechazar. El texto aclara su alcance desde el principio: no reclama tasas de detección, no incluye pruebas de concepto de exploit y no reemplaza a un revisor humano. También declara que fue redactado con asistencia de IA y revisado por el equipo, con las fuentes públicas chequeadas.
La forma no es original, y el artículo lo dice. Cloudflare escribió sobre revisores especialistas coordinados por un orquestador; Google Project Zero y DeepMind publicaron su trabajo con Big Sleep; Anthropic tiene /security-review y su GitHub Action; OpenAI, Codex Security; Semgrep, su triage multimodal. Lo que aporta este noveno post de la serie de hardening de Rokkhe es la versión mínima y reproducible de ese patrón, sin flota interna ni plataforma propia.
En este artículo:
- ¿Qué es un harness de seguridad para LLM y qué problema resuelve?
- ¿Cómo funciona un harness de revisión de seguridad paso a paso?
- ¿Cómo se hace el scout que mapea los límites de confianza?
- ¿Qué debe decir el brief del hunter y para qué sirve sumar Semgrep?
- ¿Cómo se evita el falso positivo? Un validador que intenta refutar
- ¿Un harness con IA reemplaza a un pentest o a Semgrep?
- ¿Qué hace /security-review de Claude Code dentro de este esquema?
- Criterio práctico de verificación (propuesta editorial)
- Fuentes
¿Qué es un harness de seguridad para LLM y qué problema resuelve?
Un harness de seguridad para LLM es un bucle local de revisión que corre sobre un repositorio propio y reparte el trabajo en etapas con roles distintos: mapear la arquitectura, cazar candidatos por clase de ataque, intentar refutar cada candidato y registrar el resultado en un archivo con esquema fijo. Se diferencia de preguntarle a un chat en que ninguna etapa puede declarar un hallazgo por su cuenta.
El problema que ataca es el ruido. Pedirle a un modelo de propósito general que busque vulnerabilidades suele devolver una lista larga de cuestiones teóricas, consejos desactualizados y hallazgos que ya están mitigados dos archivos más allá. Cloudflare, según recoge el artículo, es explícito sobre lo que un revisor de seguridad no debería marcar: riesgos teóricos con precondiciones improbables, sugerencias de defensa en profundidad cuando el control principal ya alcanza, e issues en código que el merge request no toca.
La tesis del autor es que no hace falta copiar la infraestructura de una gran empresa para quedarse con la forma. Hace falta la disciplina: roles separados, un esquema y un veto. Lo explicamos a fondo en nuestra guía de Claude Code a escala y en la guía de Claude Code.
¿Cómo funciona un harness de revisión de seguridad paso a paso?
Funciona en cuatro fases encadenadas: scout, hunt, disprove y write it down. El scout mapea la arquitectura y los límites de confianza; el hunt busca candidatos con un brief cerrado; el disprove abre una corrida nueva para intentar tirar cada candidato; y el registro final escribe solo los sobrevivientes, con un veredicto explícito y un modo acotado de comprobarlos.
| Fase | Qué produce | Veredicto admitido |
|---|---|---|
| Scout | architecture.md corto: componentes, entradas no confiables, sinks, checks existentes y archivos sin examinar | Ninguno: no reporta vulnerabilidades |
| Hunt | candidates.json con archivo, línea, fuente, sink y control faltante | candidate |
| Disprove | findings.json con la revisión de un validador en sesión nueva | confirmed / needs_validation / rejected |
| Write it down | REPORT.md legible para humanos, más el JSON versionado | Solo sobrevivientes |
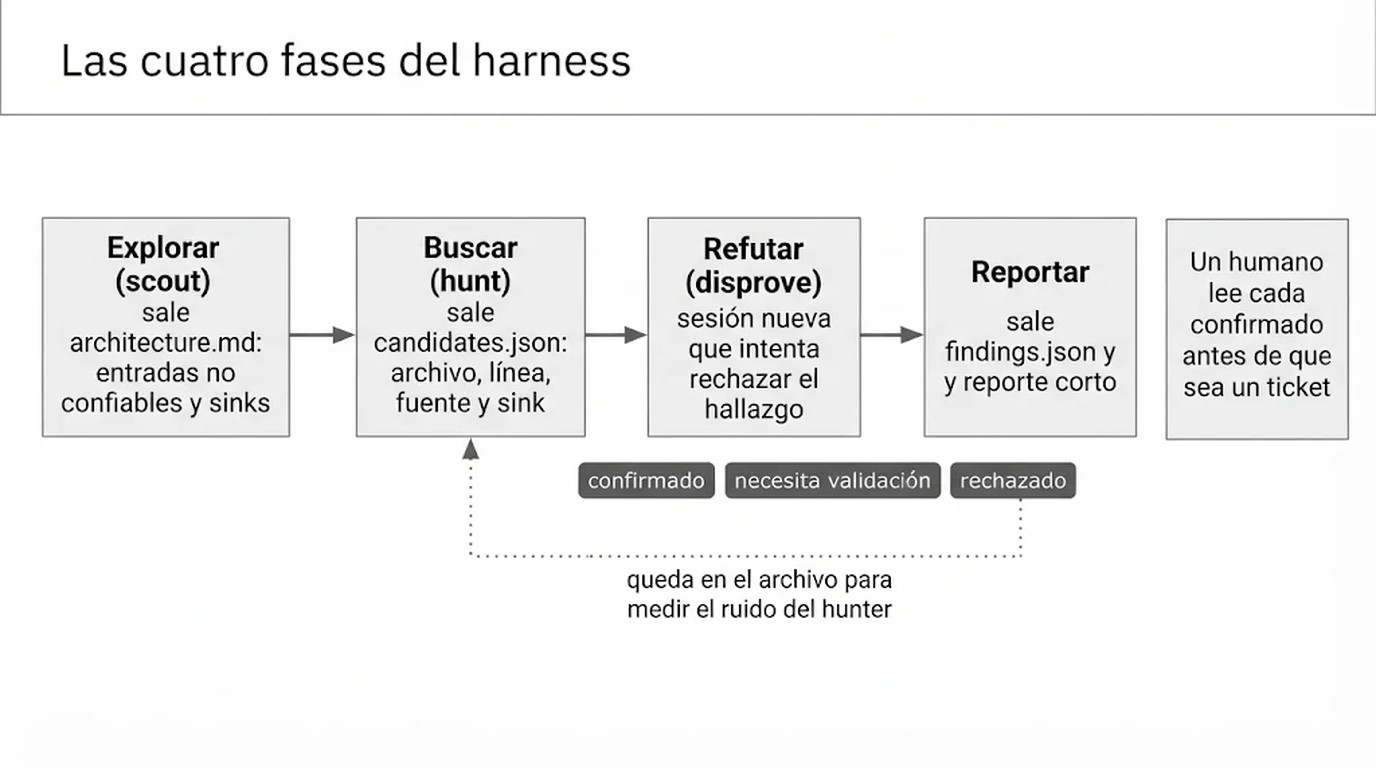
El bucle completo se maneja con cuatro invocaciones, según el esqueleto del artículo:
python3 harness.py scout --repo ./demo --out ./out/architecture.md
python3 harness.py hunt --repo ./demo --arch ./out/architecture.md --out ./out/candidates.json
python3 harness.py validate --repo ./demo --in ./out/candidates.json --out ./out/findings.json
python3 harness.py report --in ./out/findings.json --out ./out/REPORT.md
La implementación queda del lado de quien lo arma: puede llamar a la API de un proveedor, a /security-review de Claude Code o a un modelo local. El post insiste en que lo que importa son las etapas y el esquema, no el vendor.
¿Cómo se hace el scout que mapea los límites de confianza?
El scout se resuelve con comandos de solo lectura sobre el árbol del repo y un brief de cinco puntos que pide componentes, entradas no confiables, sinks privilegiados, controles de autenticación y autorización ya existentes, y una lista de archivos todavía sin examinar. Su salida es un architecture.md corto, sin veredictos de vulnerabilidad.
El artículo sugiere arrancar por lo barato: listar los archivos del lenguaje que uses excluyendo node_modules y .git, y después buscar patrones que delatan sinks. Cubrimos ese tema en detalle en la guía completa de Claude.
rg -n "exec\(|subprocess|os\.system|innerHTML|eval\(|fetch\(|requests\." \
 --glob '!node_modules' --glob '!.git'
El brief dice explícitamente «estás explorando, no cazando» y agrega una instrucción poco habitual: si no estás seguro, decilo. La salida tiene que poder leerse de una sola sentada. Y hay una regla de corte que vale la pena copiar tal cual: si el scout no puede nombrar los sinks —base de datos, shell, fetch de URL, filesystem, herramientas del modelo—, se hace a mano antes de seguir. Un hunter sin mapa se pierde.
¿Qué debe decir el brief del hunter y para qué sirve sumar Semgrep?
El brief del hunter define dos listas: qué marcar y qué no. Del lado del «sí» quedan la inyección en SQL, shell o templates, la autorización faltante sobre un objeto o función, el SSRF sobre una URL que provee el usuario, los secretos en el código y los datos no confiables que llegan a un sink peligroso. Del lado del «no», los riesgos teóricos sin ruta desde una entrada no confiable, los detalles de estilo y las librerías nuevas para adoptar.
Cada candidato tiene que citar archivo, línea, fuente no confiable, sink y control ausente. El veredicto permitido en esta etapa es candidate, nunca confirmed. Y conviene correr un hunter por vez o en sesiones aisladas: si las notas se mezclan, el mapa se ensucia.
La parte más práctica del planteo es arrancar desde un escáner determinista para que el modelo triagee en lugar de inventar. Un ejemplo del propio artículo:
semgrep scan --config auto --json-output=semgrep.json .Según la documentación de Semgrep Multimodal, en beta a noviembre de 2026, hay un paso de filtrado de ruido que marca los hallazgos que considera probables falsos positivos; una persona acepta (se cierra) o rechaza (se reabre). Si se usa ese camino, el humano se queda en el medio del bucle. El repositorio codex-security de OpenAI también documenta la importación de hallazgos de Semgrep. En los dos casos la regla es la misma: el modelo propone, la aplicación o el revisor dispone. Relacionado: comparativa entre Sonnet y Opus.
¿Cómo se evita el falso positivo? Un validador que intenta refutar
Se evita con una corrida nueva que recibe solo los archivos citados y el registro del candidato, y cuyo trabajo es argumentar en contra. El validador rechaza si el sink no es alcanzable desde una entrada no confiable, si ya existe un control que aplica el límite, o si el claim es genérico. Solo confirma cuando puede nombrar fuente, sink, control ausente y una forma acotada de comprobarlo con una prueba.
Cloudflare, según recoge el post, recomienda un validador separado, idealmente con un modelo distinto del que encontró el bug. Si el presupuesto es ajustado, puede ser el mismo modelo; el mínimo es una sesión nueva y un brief que contradiga al hunter.
Los veredictos son tres: confirmed, needs_validation y rejected. La distinción entre los dos primeros no es cosmética. El «cómo se probaría» tiene que ser algo acotado y autorizado —«el token de Alice devolvió el objeto de Bob en staging»—, no una cadena de exploit. Si el comportamiento no se puede observar en local, el veredicto es needs_validation y la severidad queda retenida. Cloudflare sostiene ese corte de tres vías y no asigna gravedad a lo no validado; conviene copiarlo.
El registro mínimo que propone el artículo, pensado para vivir en git junto al código:
{
 "id": "F-001",
 "title": "Authorization missing on order GET",
 "verdict": "confirmed",
 "source": "app/api/orders.py:88 request.user not checked",
 "sink": "Order.objects.get(id=...)",
 "boundary": "object-level authorization",
 "how_to_test": "In staging, call GET /orders/{bob} as alice; expect 403.",
 "validator_notes": "No ownership check in get_order."
}
Dos detalles separan un experimento de un proceso. Primero, los rechazos quedan en el archivo: son la forma de medir si el hunter es ruidoso y no se publican como si fueran issues. Segundo, la validación del esquema —claves requeridas, veredictos admitidos— se hace con un JSON Schema o un script de veinte líneas, no con otro LLM.
Y antes de que un confirmed se convierta en ticket, alguien lo lee. Si esa persona no puede seguir el camino en el código, el hallazgo se baja de categoría. Ese paso humano es el último filtro del bucle y el único que decide qué entra al backlog.
¿Un harness con IA reemplaza a un pentest o a Semgrep?
No. El harness es un bucle de revisión que se puede correr seguido, sobre código propio; un escáner determinista sigue sumando candidatos y una persona sigue decidiendo qué es un hallazgo. Lo que no hace es sustituir a un pentest ni a SAST.
Tampoco conviene auto-mergear los parches que propone el modelo. Un cambio propuesto necesita los mismos tests y la misma revisión que cualquier otro. Los sistemas públicos que envían parches —las AI patches de OSS-Fuzz, en beta— verifican que cada parche compile y arregle el crash, y tienen «patch shepherds» humanos que lo revisan antes de que llegue a los mantenedores.
El resto son límites de despliegue, y el artículo los subraya sin vueltas. Correr sobre un repo demo público o un clon propio, nunca sobre un sistema de cliente sin permiso. Y no pegar código de clientes ni secretos de producción en un endpoint de modelo de terceros sin contrato y sin un pipeline aprobado por el equipo de seguridad. Hasta que ese camino exista, demo.
Sobre las expectativas hay honestidad por partida doble. El post cita a los autores de Big Sleep, que describieron su trabajo como altamente experimental, señalaron que el modelo rendía mejor con herramientas y un punto de partida concreto —análisis de variantes sobre un fix reciente— y admitieron que un fuzzer específico para el objetivo probablemente sería al menos igual de efectivo. Y agrega que el primer harness de cualquiera va a ser más ruidoso que esos write-ups. El validador y el humano son la manera de que ese ruido no llegue al backlog.
¿Qué hace /security-review de Claude Code dentro de este esquema?
En los términos del artículo, /security-review de Claude Code y su GitHub Action son la versión productizada de «revisar y después validar»: el mismo patrón de dos tiempos que el harness arma a mano. Para quien ya trabaja con Claude Code, harness.py puede invocarlo como motor de una o varias fases en lugar de llamar a la API de un proveedor. El artículo de Rokkhe incluye entre sus fuentes una referencia de Anthropic, «Automate security reviews with Claude Code»; antes de decidir si se reemplaza una etapa o se terceriza el bucle completo, conviene consultar esa referencia.
Lo que queda claro es que la definición de «confirmed» en tu proceso no la toma el vendor. Ese es el trabajo del esquema.
Criterio práctico de verificación (propuesta editorial)
Antes de meter el harness en el flujo de trabajo, una corrida de prueba sobre un repo demo alcanza para decidir si vale la pena. La propuesta de esta nota es medir tres cosas en ese primer ciclo, con el mismo repositorio y el mismo modelo: cuántos candidatos produjo el hunter, cuántos sobrevivieron al validador y cuántos de los confirmados podés trazar vos mismo hasta la línea citada en menos de diez minutos. Los rechazos no son basura: son el denominador del ruido.
Este criterio es una propuesta editorial, no una medición del artículo ni una prueba que hayamos realizado. El post de Rokkhe no publica métricas y es explícito en que no reclama tasas de detección para ningún modelo.
Un segundo chequeo, todavía más barato: leer el architecture.md del scout. Si no nombra los sinks ni las entradas no confiables del repo, el resto del bucle va a producir candidatos que nadie puede verificar. Ahí se corta y se hace a mano.
Fuentes
- Build a small LLM security-review harness: scout, hunt, disprove, write it down, Rokkhe research team, 18 de noviembre de 2026.
- Anthropic — «Automate security reviews with Claude Code» (referencia citada por el artículo de Rokkhe).