En este artículo:
- ¿Por qué un evaluador puede aprobar una respuesta de IA que es incorrecta?
- ¿Qué es el testing contrastivo de contexto y cómo se aplica?
- ¿Qué casos debe cubrir una matriz de pruebas de regresión?
- ¿Cómo se escribe esa matriz como test automatizado?
- ¿Qué pasa cuando falta evidencia, sobra contexto o hay registros en conflicto?
- ¿Cómo se traslada el método a otros flujos de IA además de los reembolsos?
- Un criterio práctico para verificar el propio evaluador
- Fuentes
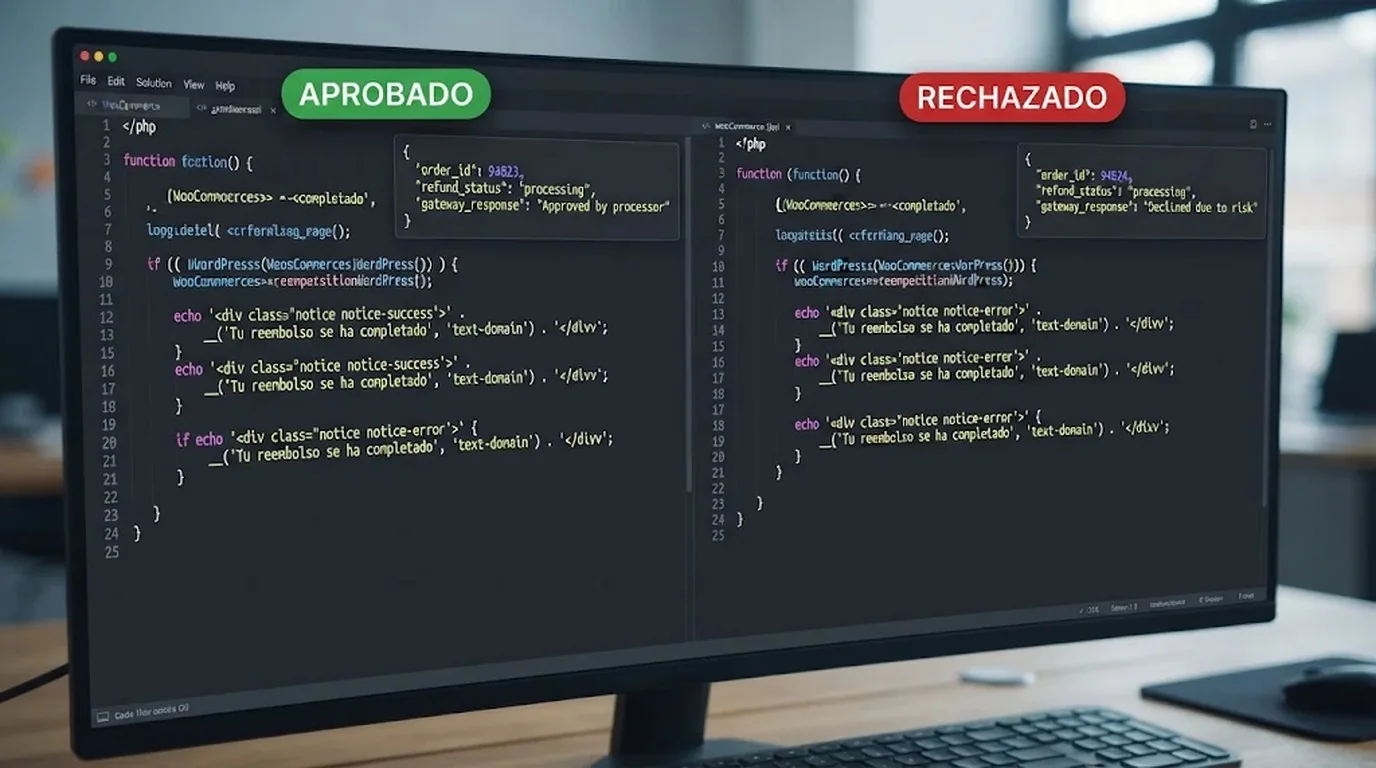
Dos versiones de la misma aplicación de soporte generan exactamente la misma frase: «Tu reembolso está completo». En la primera, el registro verificado dice que el reembolso ya se completó y el evaluador devuelve pass. En la segunda, el mismo texto se produce cuando el estado verificado sigue en proceso, y el veredicto correcto es fail. La oración no cambió: cambió la evidencia contra la que se la juzga.
Ese contraste es el núcleo de un artículo técnico publicado el 17 de noviembre de 2026 en DEV Community, que describe cómo prueba un evaluador de respuestas de atención al cliente construido con IA. El problema que plantea no es de redacción sino de testing: cuando un asistente arma sus respuestas a partir de registros de clientes, transacciones, historiales de pedidos u otro estado de la aplicación que cambia con el tiempo, la calidad del texto dice poco sobre su veracidad.
¿Por qué un evaluador puede aprobar una respuesta de IA que es incorrecta?
Porque juzga cómo suena la respuesta y no qué afirma. Un evaluador que mide claridad, cortesía o corrección gramatical no tiene manera de detectar que «tu reembolso está completo» contradice un registro que dice processing. Para atrapar ese error, el veredicto tiene que comparar cada afirmación del texto con el dato verificado de la aplicación en el momento de la evaluación. Para más detalles técnicos, mirá nuestra guía completa sobre Sora.
La distinción parece obvia escrita así, pero es la que se pierde cuando la evaluación se reduce a una consigna del tipo «¿esta respuesta es clara y profesional?». La frase del ejemplo cumple con esos criterios en cualquiera de los dos escenarios. Lo que el evaluador necesita resolver no es si el texto está bien escrito, sino si lo que sostiene está respaldado por la información que el sistema tiene efectivamente verificada.
El patrón se repite en cualquier flujo donde el asistente habla en nombre de un sistema: estados de pago, entregas, suscripciones, verificaciones de cuenta, reservas. En todos los casos hace falta acceso al estado autoritativo para poder contradecir al modelo. Sin ese acceso, el evaluador solo puede medir estilo.
¿Qué es el testing contrastivo de contexto y cómo se aplica?
Es una técnica de diseño de pruebas que consiste en mantener fija la respuesta generada y variar el contexto verificado: si la evidencia cambia, el veredicto del evaluador también debería cambiar. No es un framework ni un producto. En el ejemplo, la misma frase sobre el reembolso pasa de pass a fail solo por cambiar el estado verificado de completed a processing. Cubrimos ese tema en detalle en el análisis de red teaming de agentes.
Conviene aclarar el alcance del término: «context-contrastive testing» es una etiqueta práctica que usa la autora del artículo, no una denominación estándar de la industria. Lo generalizable es la regla operativa. Si se sostiene el texto y se mueve el dato, el veredicto tiene que moverse; si no se mueve, el evaluador está mirando la respuesta y no la evidencia. La idea emparenta con un enfoque conocido en evaluación de modelos, el de los contrast sets, que también trabaja sobre variaciones mínimas del contexto para poner a prueba los límites de una decisión.
¿Qué casos debe cubrir una matriz de pruebas de regresión?
Una matriz mínima cubre cuatro relaciones entre lo que afirma la respuesta y lo que dice el dato verificado: dos afirmaciones distintas, cada una probada contra un estado que la contradice y otro que la respalda. Con esas cuatro filas se comprueba que el evaluador no sea un aprobador serial ni un rechazador serial, sino que sus decisiones sigan la evidencia.
| Afirmación de la respuesta | Estado verificado | Resultado esperado |
|---|---|---|
| Reembolso completado | processing | fail |
| Reembolso completado | completed | pass |
| Reembolso fallido | processing | fail |
| Reembolso fallido | failed | pass |
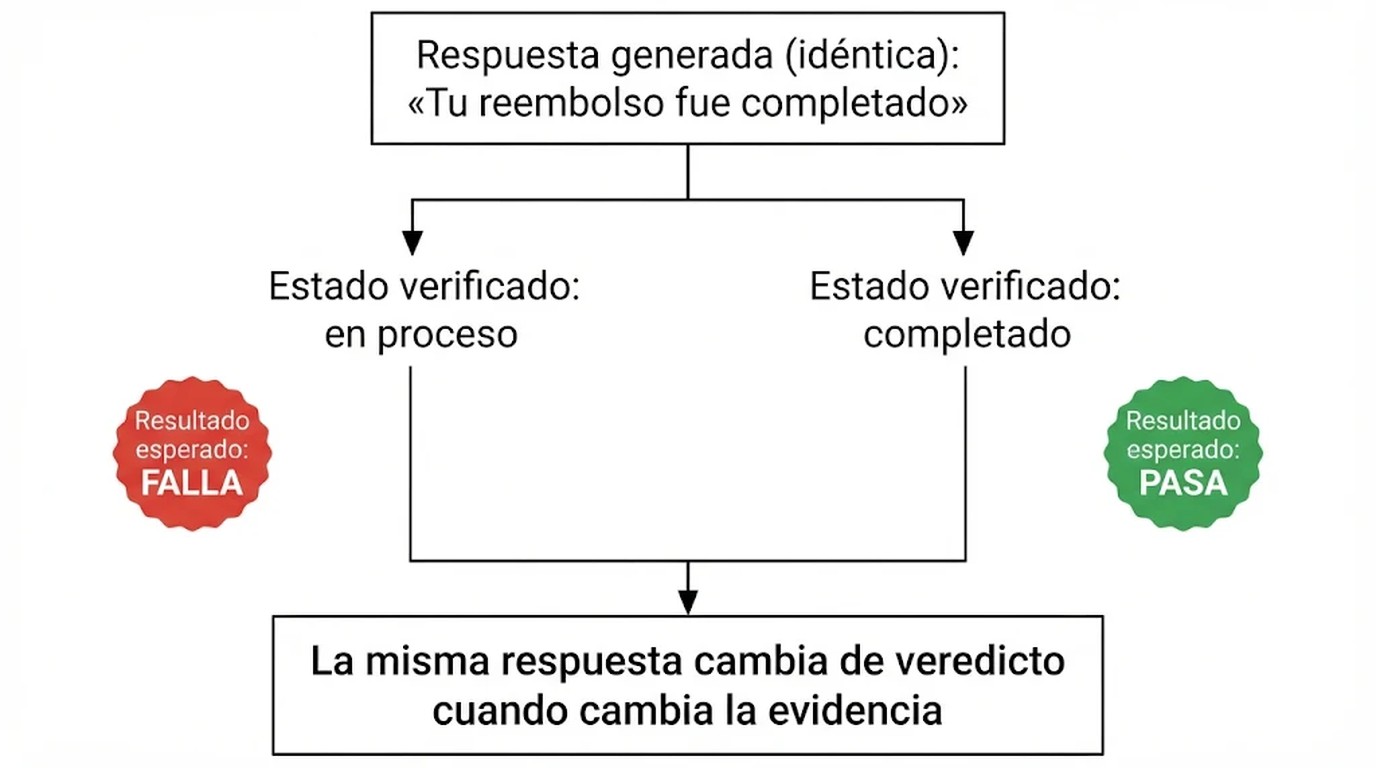
Probar solo el caso que debe fallar deja pasar a un evaluador que rechaza todo; probar solo el que debe pasar deja pasar al que aprueba todo. La matriz completa es la que establece que el criterio sigue la evidencia y no una inclinación. En el proyecto de la autora, estas cuatro relaciones están implementadas como escenarios de regresión, y ese detalle es el que convierte la idea en una red de seguridad: si alguien toca la lógica de evaluación y una respuesta correcta empieza a fallar —o al revés—, el test lo marca. Te puede servir nuestra cobertura del avance de ChatGPT frente a Google.
¿Cómo se escribe esa matriz como test automatizado?
Se escribe como una tabla de casos. Cada entrada define la respuesta, el contexto verificado y el veredicto esperado; el test recorre el arreglo, llama al evaluador con ese contexto y compara el resultado real con el esperado. La estructura importa más que la herramienta: definir, ejecutar, comparar. Cualquier framework de testing con soporte de casos parametrizados sirve.
const cases = [
 { response: "Your refund has been completed.", refundStatus: "processing", expected: "fail" },
 { response: "Your refund has been completed.", refundStatus: "completed", expected: "pass" },
 { response: "Your refund has failed.", refundStatus: "processing", expected: "fail" },
 { response: "Your refund has failed.", refundStatus: "failed", expected: "pass" }
];

describe("refund claim evaluation", () => {
 test.each(cases)("returns $expected for refund status $refundStatus", async ({ response, refundStatus, expected }) => {
 const result = await evaluateSupportResponse({
 response,
 context: { refund_status: refundStatus }
 });

 expect(result.verdict).toBe(expected);
 });
});
El nombre de la función y la forma del resultado son ilustrativos: el propio artículo lo aclara. En un proyecto real hay que usar la interfaz y el esquema de veredicto del evaluador que se esté probando. Lo que se replica no es el código sino la estructura: respuesta definida, contexto verificado aportado, veredicto esperado explícito, ejecución del evaluador y comparación estricta del resultado.
¿Qué pasa cuando falta evidencia, sobra contexto o hay registros en conflicto?
Una matriz de dos estados no alcanza para producción. El artículo propone tres dimensiones adicionales —contexto irrelevante, evidencia faltante y evidencia conflictiva— y aclara que las plantea como territorio a desarrollar y verificar, no como cobertura que sus cuatro tests de reembolso ya tengan. La distinción es honesta y conviene retenerla antes de dar por resuelto el problema. Ya lo cubrimos antes en las auditorías de código comparadas.
- Contexto irrelevante. Si cambia el canal de contacto preferido y el estado del reembolso sigue en completed, el veredicto no debería moverse. Ese caso detecta si el evaluador se apoya en cualquier dato disponible en lugar de en el dato pertinente.
- Evidencia faltante. Sin estado de reembolso disponible no corresponde aprobar con confianza. Un resultado del tipo unknown es preferible a forzar un pass o un fail, porque la ausencia de evidencia no demuestra que la afirmación sea falsa.
- Evidencia conflictiva. Con varios eventos de reembolso o transacciones que se contradicen, el sistema necesita un criterio defendible para identificar el registro relevante. Elegir el registro que hace quedar bien a la respuesta generada es exactamente el error que hay que evitar.
¿Cómo se traslada el método a otros flujos de IA además de los reembolsos?
Se traslada identificando, para cada flujo, tres cosas: qué afirmaciones puede hacer el asistente, cuál es la fuente autoritativa de verdad y qué cambios de contexto deberían alterar el veredicto esperado. Con esos tres elementos definidos, la matriz de casos se arma igual que en el ejemplo del reembolso, sin importar el dominio.
| Aplicación | Afirmación generada por la IA | Contexto a verificar |
|---|---|---|
| Soporte de entregas | «Tu pedido fue entregado» | Estado de entrega verificado |
| Pagos | «Tu pago se realizó con éxito» | Estado de la transacción |
| Suscripciones | «Tu suscripción fue cancelada» | Estado de la suscripción |
| Soporte de cuentas | «Tu cuenta está verificada» | Registro de verificación |
| Reservas | «Tu turno está confirmado» | Estado de la reserva |
La consecuencia práctica para un equipo es que el evaluador deja de ser una capa que opina sobre el tono y pasa a ser una capa que audita hechos. Eso exige que la aplicación le entregue el estado verificado junto con la respuesta, y que ese estado se capture en el mismo momento en que se generó el texto. Si el contexto se consulta después, el test mide otra cosa.
Un criterio práctico para verificar el propio evaluador
Lo que sigue es una propuesta editorial de verificación, no un resultado de pruebas ni una técnica atribuida al artículo. La idea es someter al evaluador a una muestra de respuestas que ya existen, con el contexto que tenían cuando se generaron, y observar si su veredicto cambia cuando corresponde.
- Tomar una muestra de respuestas reales del registro de producción, no respuestas inventadas para la ocasión.
- Para cada una, recuperar el estado verificado que existía al momento de generarla y fijarlo como contexto del caso.
- Enumerar los estados posibles de ese dato y armar, para cada afirmación, el par contradicho respaldado.
- Correr el evaluador con cada combinación y registrar cuántos veredictos cambian cuando cambia la evidencia.
- Congelar como regresión los casos que hoy dan el resultado correcto, para que un cambio de lógica no los rompa en silencio.
Un evaluador que devuelve el mismo veredicto para todas las respuestas de la muestra, con contextos distintos, es una señal de alarma más informativa que cualquier puntaje promedio de calidad. Y un evaluador que solo se probó contra el caso feliz no está verificado: está decorado.
La frase que abre el planteo se puede leer como un principio de ingeniería: no alcanza con probar que una respuesta de IA puede aprobar; hay que probar que el evaluador sabe cuándo esa misma respuesta debe fallar. Aplicada a cada afirmación que un asistente puede hacer sobre el estado de un cliente, esa pregunta separa un evaluador que mide estilo de uno que verifica hechos. El artículo cierra su lista de lecturas complementarias con la guía pública de buenas prácticas de evaluación de OpenAI, un documento útil para enmarcar estas pruebas dentro de una estrategia de medición más amplia.
Fuentes
- How to Test AI Responses Against Changing Customer Context, DEV Community, 17 de noviembre de 2026.
- Publicación sobre ingeniería de contexto y agentes de IA, LinkedIn (debate profesional relacionado).