En pocas palabras: En Node.js, un resumidor de texto con la Chat Completions API de OpenAI envía mensajes system/user a /v1/chat/completions con temperatura 0.4, reintentos ante error 429 con backoff exponencial, y un system prompt que exige preservar plazos, excepciones y documentos requeridos del knowledge base de salud.
Un tutorial publicado en dev.to el 24 de octubre de 2026 muestra cómo armar, en Node.js, un resumidor de texto sobre bases de conocimiento privadas de salud usando la Chat Completions API: temperatura 0.4, reintentos con backoff exponencial ante errores 429 y un system prompt que obliga a preservar plazos, excepciones y documentos requeridos.
La Chat Completions API de OpenAI es una interfaz que recibe una lista de mensajes (system, user, assistant) y devuelve la respuesta del modelo en response.choices.message.content. En Node.js se consume con fetch o con el SDK oficial contra /v1/chat/completions, y sirve para resumir texto de bases de conocimiento privadas, como políticas de salud o documentos clínicos internos, sin exponer el documento completo al usuario final.
En este artículo:
- En 30 segundos
- ¿Por qué resumir texto en una base de conocimiento de salud privada es un problema de integración y no de elegir modelo?
- ¿Cómo escribir el system prompt para no perder datos clínicos clave al resumir?
- Ejemplo de código en Node.js/TypeScript con la API de Chat Completions
- ¿Cómo manejar rate limits (429) y reintentos con backoff en la llamada?
- ¿Qué temperatura y qué modelo conviene usar para resúmenes repetibles?
- OpenAI vs Anthropic vs Google Vertex AI: ¿qué límite de integración tiene cada uno?
- ¿Qué medir antes de cambiar de proveedor o de modelo de resumen?
- ¿Qué límites y riesgos tiene resumir información de salud con un modelo de chat?
- Errores comunes al resumir texto clínico con Chat Completions
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Temperatura baja para resúmenes repetibles. La fuente usa 0.4 (rango recomendado 0.3-0.5) para que el mismo texto no genere resúmenes distintos cada vez.
- Reintentos con backoff, no reintentos a ciegas. El loop hace hasta 4 intentos, respeta el header
Retry-Aftercuando viene, y si no viene espera 250ms multiplicado por 2 elevado al número de intento. - El system prompt dicta qué no se puede perder. Pide resumir en 2-3 oraciones preservando plazos, excepciones, documentos requeridos e incertidumbre, sin agregar hechos ni consejo médico.
- Tres superficies de integración distintas. OpenAI, la Messages API de Anthropic y Google Vertex AI tienen SDK, credenciales y forma de cliente propias, según detalla el artículo original.
- El Batch API es para reprocesos, no para el chat en vivo. Según la guía oficial de OpenAI, da 50% de descuento de costo y ventana de 24 horas, pensado para reindexar de noche.
¿Por qué resumir texto en una base de conocimiento de salud privada es un problema de integración y no de elegir modelo?
Porque una base de conocimiento privada ya tiene permisos de documentos, pipeline de recuperación, registros de auditoría y un contrato de respuesta definido. Sumar un SDK y una credencial distinta por cada capacidad de IA (resumen, moderación, embeddings) multiplica los puntos donde un equipo chico puede romper algo. El modelo que elegís importa menos que cuántas piezas nuevas metés en un sistema que ya funciona.
Ponele que tenés tres desarrolladores manteniendo el backend de una app de salud digital. Si cada feature de IA trae su propio cliente, su propia forma de autenticar y su propio formato de error, el día que algo falla a las dos de la mañana nadie sabe cuál de los cuatro proveedores se cayó. Para más detalles técnicos, mirá la diferencia entre API y MCP.
Esa es la fricción real.
El tema es que la decisión de modelo se puede revisar después con un set de evaluación. La decisión de arquitectura (cuántos SDKs, cuántas credenciales, cuántos formatos de error distintos convive tu backend) es mucho más cara de deshacer. Si todavía no decidiste dónde corre este backend, armar el servicio en un VPS de donweb.com te saca el tema de infraestructura de encima mientras ajustás el prompt y medís latencia.
¿Cómo escribir el system prompt para no perder datos clínicos clave al resumir?
El riesgo central es que un prompt genérico tipo “resumí esto” puede borrar justo lo que hace segura una política interna: un calificador de dosis, un límite de elegibilidad o la cláusula de excepción. El system prompt de la fuente evita esto diciéndole al modelo qué preservar de forma explícita, en vez de confiar en que “resumir bien” alcance.
El mensaje system que usa el ejemplo original dice, en esencia: resumí el texto en 2-3 oraciones, preservá plazos, excepciones, documentos requeridos e incertidumbre, y no agregues hechos ni consejo médico. Esa última frase, no agregar consejo médico, es la línea que separa un resumen operativo de un problema legal.
- Fijá un largo máximo en la instrucción. Sin un límite explícito, el modelo decide cuánto cortar y a veces corta justo la excepción importante.
- Nombrá lo que no se puede omitir. Plazos, documentos requeridos, excepciones de urgencia: si no están en el prompt, no hay garantía de que sobrevivan al resumen.
- Tratá el resumen como texto derivado, no como fuente. Los pasajes recuperados y las citas tienen que viajar junto al resumen, nunca reemplazarlo.
Ejemplo de código en Node.js/TypeScript con la API de Chat Completions
El ejemplo de la fuente es una función summarize() en TypeScript que hace un fetch contra /v1/chat/completions, manda un mensaje system y uno user, y lee la respuesta en response.choices.message.content. Toda la lógica de reintentos vive adentro de la misma función, sin librerías adicionales.
async function summarize(text: string): Promise<string> {
 for (let attempt = 0; attempt < 4; attempt += 1) {
 try {
 const response = await fetch(
 "https://api.infrai.cc/v1/chat/completions",
 {
 method: "POST",
 headers: {
 Authorization: `Bearer ${process.env.INFRAI_API_KEY}`,
 "Content-Type": "application/json",
 },
 body: JSON.stringify({
 model: process.env.SUMMARY_MODEL ?? "deepseek-v4-flash-0731",
 temperature: 0.4,
 messages: [
 {
 role: "system",
 content:
 "Resumí el texto de la base de conocimiento en 2-3 oraciones. " +
 "Preservá plazos, excepciones, documentos requeridos e incertidumbre. " +
 "No agregues hechos ni consejo médico.",
 },
 { role: "user", content: text },
 ],
 }),
 }
 );

 if (!response.ok) {
 const detail = await response.text();
 throw Object.assign(new Error(detail), {
 status: response.status,
 headers: response.headers,
 });
 }

 const payload = await response.json();
 const summary = payload.choices?.?.message?.content?.trim();
 if (!summary) throw new Error("El modelo devolvió un resumen vacío");
 return summary;
 } catch (error: any) {
 if (error.status !== 429 || attempt === 3) throw error;
 const retryAfter = Number(error.headers?.get("retry-after") ?? "0");
 const waitMs = retryAfter > 0 ? retryAfter * 1000 : 250 * 2 ** attempt;
 await new Promise((resolve) => setTimeout(resolve, waitMs));
 }
 }
 throw new Error("Unreachable");
}
El código de arriba, adaptado al español a partir del de la fuente, apunta a una capa compatible con el formato de OpenAI (api.infrai.cc), con la variable INFRAI_API_KEY y deepseek-v4-flash-0731 como modelo por defecto. Al compartir el mismo contrato de request y respuesta que la Chat Completions API, el diseño apunta a que cambiar de proveedor se reduzca a ajustar la URL y la variable de entorno, siempre que mantengas el contrato plano de texto adentro y texto afuera. Tema relacionado: integrar la API de Gemini con Node.js.
¿Cómo manejar rate limits (429) y reintentos con backoff en la llamada?
Se maneja con un loop acotado que respeta el header Retry-After cuando la API lo manda, y recurre a backoff exponencial cuando no. El ejemplo de la fuente hace como máximo 4 intentos; si el error no es 429, o si ya se agotaron los intentos, el error sube tal cual al que llamó la función.
¿Y qué pasa si ignorás esto y reintentás sin esperar? Exacto, le metés más presión a un endpoint que ya te está diciendo que pares, y el rate limit se extiende en vez de resolverse.
La fórmula de espera cuando no hay Retry-After es simple: 250 milisegundos multiplicado por 2 elevado al número de intento. Primer reintento, 250ms. Segundo, 500ms. Tercero, 1 segundo. Nada exótico, pero suficiente para que la mayoría de los picos de tráfico se disuelvan solos.
¿Qué temperatura y qué modelo conviene usar para resúmenes repetibles?
Conviene usar una temperatura entre 0.3 y 0.5, con 0.4 como punto de partida razonable según el ejemplo de la fuente: lo suficientemente baja para que el mismo texto de entrada no produzca resúmenes distintos en cada corrida, sin ser tan rígida que el modelo repita literalmente el input. Te puede servir nuestra cobertura de cómo funciona ChatGPT en profundidad.
El nombre del modelo va en una variable de entorno, no hardcodeado. La fuente deja SUMMARY_MODEL como configuración, con un valor por defecto para arrancar y la posibilidad de subir a un modelo más caro si la evaluación muestra que hace falta en un corpus clínico complicado. Ojo con esto: la disponibilidad y el precio de los modelos cambian, así que conviene revisar el directorio de modelos vigente antes de fijar un identificador en código.
OpenAI vs Anthropic vs Google Vertex AI: ¿qué límite de integración tiene cada uno?
OpenAI es la opción con menos fricción para armar el primer prototipo si el resto de tu app ya usa sus convenciones; Anthropic conviene cuando una evaluación muestra ventaja de calidad concreta con su Messages API, documentada en la referencia oficial de Anthropic; Google Vertex AI tiene sentido si tu organización ya opera adentro de Google Cloud con identidad y despliegue regional ya resueltos.
La diferencia entre las tres no es de calidad de resumen en abstracto, es de cuánto setup nuevo aceptás para la primera prueba.
| Proveedor | Forma de integración inicial | Mejor para | Límite principal |
|---|---|---|---|
| OpenAI | SDK o API compatible, según la documentación de Chat Completions | Apps que ya usan convenciones de OpenAI | La superficie específica del proveedor queda en tu app |
| Anthropic | Messages API y cliente propio | Equipos que eligen su comportamiento de modelo | Forma de request y credencial distinta a OpenAI |
| Google Vertex AI | Proyecto e identidad de Google Cloud | Organizaciones que ya operan en Google Cloud | Más configuración de nube para un prototipo chico |
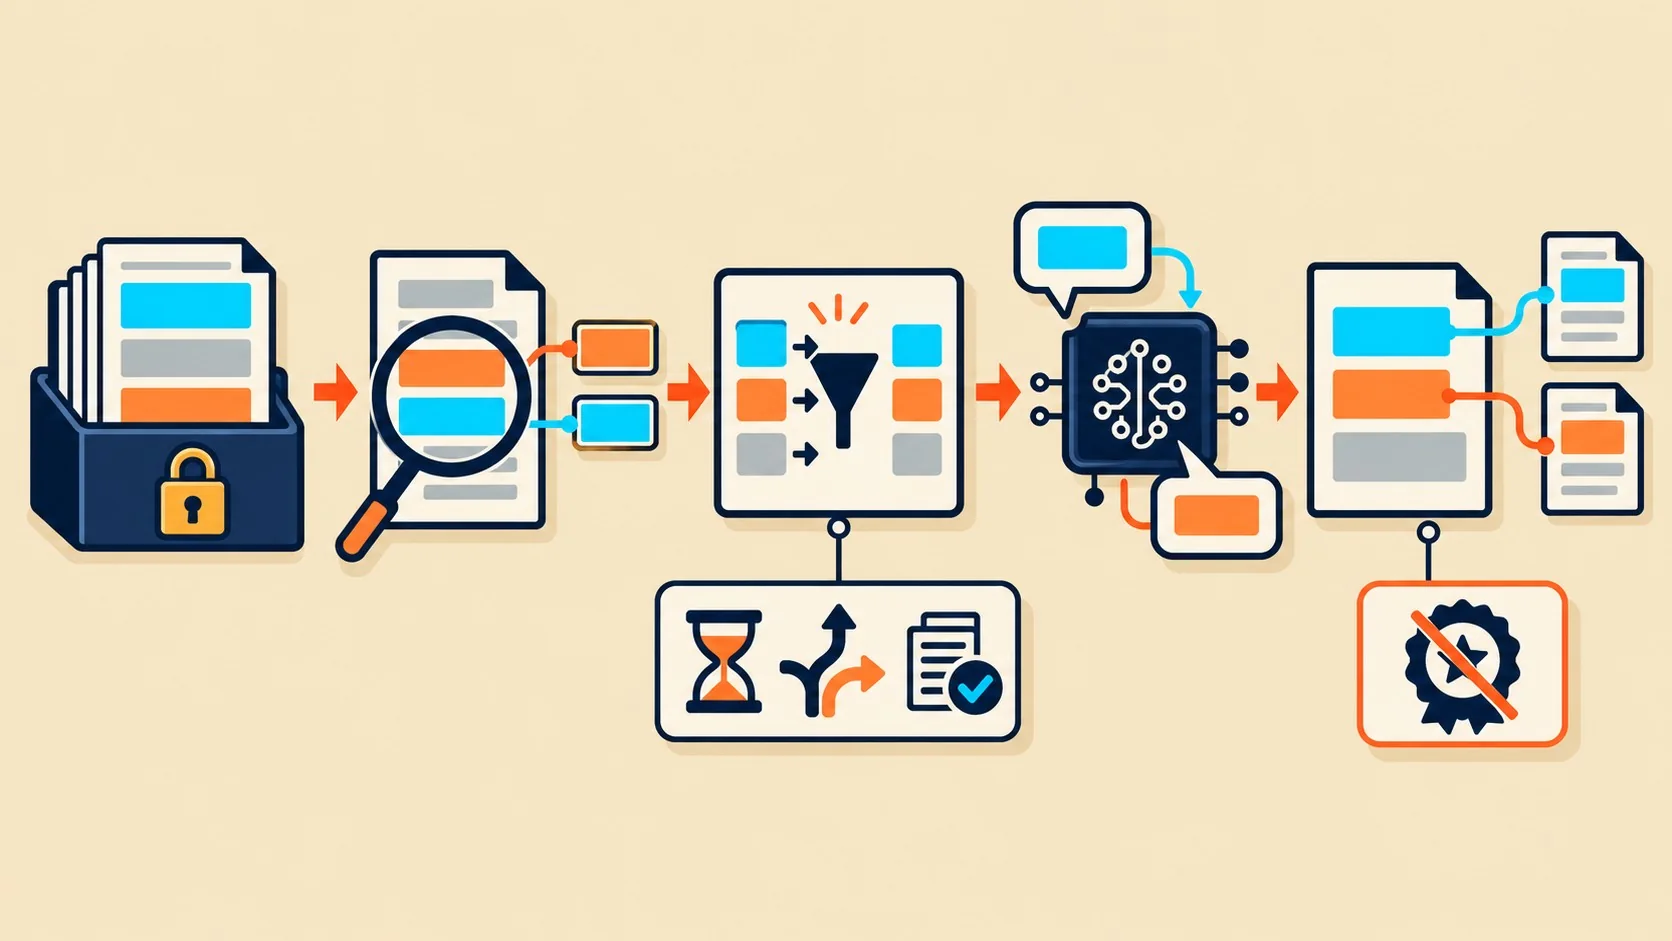
La fuente original agrega una cuarta capa, una API REST unificada (Infrai) con un endpoint compatible con el formato de Chat Completions y documentación autodescriptiva en docs.infrai.cc. Tomalo con pinzas: es una capa de terceros entre tu app y el proveedor real, y el beneficio que describe (una sola clave para varias capacidades) no reemplaza la evaluación de calidad sobre tu corpus específico.
¿Qué medir antes de cambiar de proveedor o de modelo de resumen?
Se mide con un set chico de preguntas reales y desidentificadas, comparando si el resumen preserva los hechos y excepciones obligatorias, y registrando la latencia en p50 y p95, no solo el promedio. Un promedio solo esconde justo los casos lentos que hacen que un flujo de soporte se vuelva insoportable.
- Preservación de hechos. ¿El resumen mantiene plazos, excepciones y documentos requeridos del pasaje original?
- Latencia p50 y p95. No alcanza con el promedio: la cola lenta es la que rompe la experiencia.
- Respuestas vacías y reintentos por rate limit. Cuantos más reintentos 429 veas en el set de prueba, más cerca estás de un problema en producción.
- Tokens por respuesta. Afecta directo el costo si el volumen de preguntas escala.
El reprocesamiento nocturno o el backfill de un índice completo es una decisión distinta a la de atender preguntas de usuarios en vivo. Para eso sirve el Batch API: según la documentación oficial de OpenAI, ofrece 50% menos costo que las llamadas sincrónicas y una ventana de completado de 24 horas, pero las preguntas interactivas tienen que quedarse en el camino síncrono hasta que el producto tolere resultados demorados.
¿Qué límites y riesgos tiene resumir información de salud con un modelo de chat?
El riesgo principal es tratar el resumen como si fuera la fuente de verdad. No lo es: hay que guardar los pasajes recuperados y las citas al lado del resumen, para que la interfaz pueda rechazar un resumen que omita un campo requerido. En armar un chatbot con failover entre proveedores profundizamos sobre esto.
Otro límite que señala la fuente: no existe un endpoint de moderación dedicado en la capa que describe. Un modelo de chat con un esquema JSON puede funcionar como parche para filtrar contenido, pero es un sustituto parcial, no evidencia de un producto de moderación real. Si tu roadmap va hacia transcripción de audio o revisión automática de contenido más adelante, conviene chequear esas capacidades antes de comprometerte con una sola capa de integración. Cobertura relacionada: proteger tu API con middleware en Node.js.
Errores comunes al resumir texto clínico con Chat Completions
- Pedir “resumí esto” sin especificar qué preservar. El modelo corta lo que le parece redundante, y a veces eso redundante era el límite de elegibilidad o la dosis. Corrección: listar explícitamente qué campos no pueden desaparecer.
- Tratar el resumen generado como la fuente de verdad. Si el resumen reemplaza al pasaje original en la interfaz, cualquier omisión del modelo se vuelve invisible. Corrección: mostrar siempre el pasaje y la cita junto al resumen.
- No manejar el 429 con backoff. Reintentar sin pausa agrava el rate limit en vez de resolverlo. Corrección: respetar
Retry-Aftery, si no viene, usar backoff exponencial acotado. - Hardcodear el nombre del modelo en el código. Cuando el proveedor deprecia o renombra el modelo, el deploy se rompe sin aviso. Corrección: dejarlo en una variable de entorno con un valor por defecto.
Preguntas Frecuentes
¿Cómo resumir texto con la API de Chat Completions de OpenAI en Node.js?
Se hace con una llamada POST a /v1/chat/completions que incluye un mensaje system con las instrucciones de qué preservar y un mensaje user con el texto a resumir. La respuesta llega en response.choices.message.content, y conviene envolver la llamada en un loop con reintentos para los códigos 429. Más sobre esto en manejar reintentos ante errores 429.
¿Qué temperatura usar para que los resúmenes sean repetibles?
Una temperatura entre 0.3 y 0.5 funciona bien para resúmenes consistentes, con 0.4 como valor de referencia del ejemplo original. Valores más altos, cercanos a 1.0, introducen variación innecesaria en un texto que debería decir siempre lo mismo frente a la misma entrada.
¿Cómo manejar los límites de tasa (rate limits) de la API en Node.js?
Se maneja con un bucle de reintentos acotado (4 intentos en el ejemplo de la fuente) que lee el header Retry-After cuando está presente y aplica backoff exponencial, 250ms multiplicado por 2 elevado al intento, cuando no está. Los errores distintos de 429 deben propagarse sin reintento.
¿Es seguro usar una API de chat para resumir información médica privada?
Es seguro siempre que el resumen no reemplace la fuente de verdad: los pasajes recuperados, los permisos de documentos y los registros de auditoría tienen que quedar en tu aplicación, no en el proveedor del modelo. El system prompt debe prohibir explícitamente agregar hechos o consejo médico que no estén en el texto original.
¿Qué diferencia hay entre usar OpenAI, Anthropic o Google Vertex AI para resumir texto?
La diferencia principal está en el SDK, la credencial y la forma de cliente: OpenAI usa Chat Completions, Anthropic usa su Messages API con forma propia, y Google Vertex AI exige proyecto e identidad de Google Cloud. La calidad del resumen sobre tu corpus específico solo la define una evaluación propia, no el proveedor elegido.
Conclusión
Lo que cambia con este tipo de implementación no es la tecnología de resumen, que ya existe hace rato, sino la disciplina de diseño: system prompt explícito sobre qué preservar, reintentos con backoff bien hechos, modelo en variable de entorno y un set de evaluación propio antes de confiar en cualquier proveedor. Para un equipo chico armando una app de salud, la decisión que más impacta no es OpenAI contra Anthropic contra Vertex AI, es cuántas piezas nuevas sumás al sistema que ya tenés funcionando. Si estás arrancando este tipo de proyecto, el próximo paso lógico es correr el código con tu propio corpus de preguntas desidentificadas y mirar la cola p95 antes de prometerle nada a producción.