En pocas palabras: Sí: una API unificada mantiene el chatbot disponible enrutando entre OpenAI, Claude y Gemini detrás de un solo contrato, pero solo resuelve latencia y caídas (como un error 429), no calidad. Según la guía del 23 de octubre de 2026, hay que validar cada modelo de respaldo contra un catálogo etiquetado antes de habilitar el failover automático.
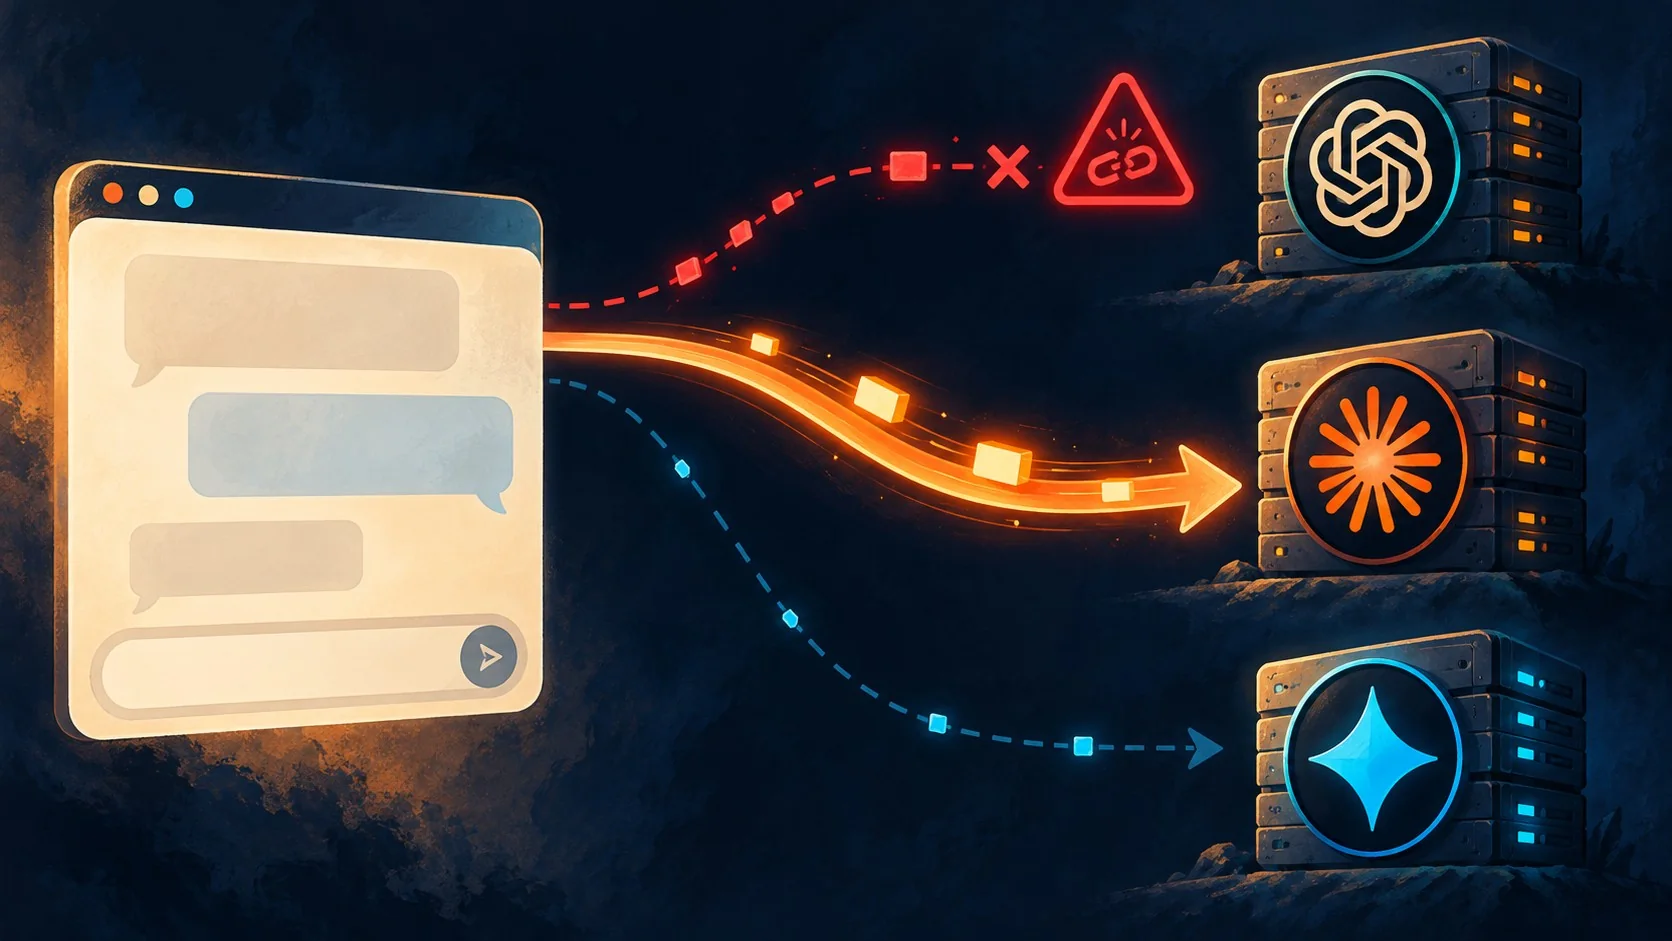
Un chatbot LLM unificado enruta automáticamente las solicitudes entre OpenAI, Claude y Gemini detrás de un solo contrato de API, así el servicio sigue respondiendo cuando un proveedor devuelve error 429 o se cae. Según una guía técnica publicada en dev.to el 23 de octubre de 2026, el patrón resuelve disponibilidad, pero no resuelve calidad por sí solo.
Una API unificada multi-proveedor es una capa de software que expone una sola interfaz (normalmente compatible con el formato de OpenAI) y, por detrás, decide a qué proveedor mandar cada solicitud: OpenAI, Anthropic o Google. El frontend de tu chatbot le habla siempre a esa interfaz; quien cambia de proveedor es la capa de routing, no tu código de UI.
En este artículo:
- En 30 segundos
- ¿Por qué un chatbot con un solo proveedor LLM no es confiable en producción?
- ¿Qué es una API unificada multi-proveedor y cómo funciona el failover?
- ¿El failover garantiza la calidad de las respuestas del chatbot?
- API unificada vs. integración directa con OpenAI, Claude o Gemini: ¿cuál conviene?
- ¿Qué debe cambiar y qué debe mantenerse fijo al diseñar el routing?
- ¿Cómo implementar reintentos y backoff ante errores 429 sin duplicar trabajo?
- ¿Cuándo conviene usar la API unificada y cuándo la integración directa?
- Errores comunes al armar un chatbot con failover multi-proveedor
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El patrón central: frontend fijo más capa de routing que decide entre OpenAI, Claude o Gemini según disponibilidad.
- Un error 429 no es una señal de calidad: el modelo de respaldo puede acertar la categoría y fallar en el nivel, el idioma o el objetivo de la respuesta.
- La guía propone dos políticas separadas: escritura en catálogo con modelo quality-first que rechaza output incompleto, y chat interactivo con presupuesto de latencia y failover tras timeout.
- El reintento ante 429 debe ser acotado, respetar el header Retry-After, sumar jitter y terminar con un error accionable, nunca un loop infinito.
- Infrai aparece en la fuente como ejemplo de API unificada: una key, una factura, superficie compatible con OpenAI.
¿Por qué un chatbot con un solo proveedor LLM no es confiable en producción?
Porque toda la disponibilidad de tu servicio queda atada a un único punto de falla. Si OpenAI aplica un rate limit a tu cuenta, o Anthropic tiene una degradación de servicio, tu chatbot se cae con ellos, sin alternativa.
El caso que describe la fuente es concreto: un chatbot in-app para una plataforma edtech que enriquece descripciones de cursos desordenadas (título, descripción, nivel del alumno) y les asigna categoría, idioma y objetivo de aprendizaje. Ponele que ese flujo corre en horario pico, con un volumen alto de ediciones de catálogo, y de repente el proveedor principal empieza a devolver 429 en cascada. Sin un plan B, la cola de enriquecimiento se frena y el equipo de contenido queda esperando.
Acá no hay vuelta: un solo proveedor significa un solo límite de tasa, una sola ventana de mantenimiento, una sola decisión de pricing que te puede afectar de un día para otro. Eso no lo arregla elegir “el mejor modelo” del momento, porque el problema no es de calidad sino de continuidad operativa.
¿Qué es una API unificada multi-proveedor y cómo funciona el failover?
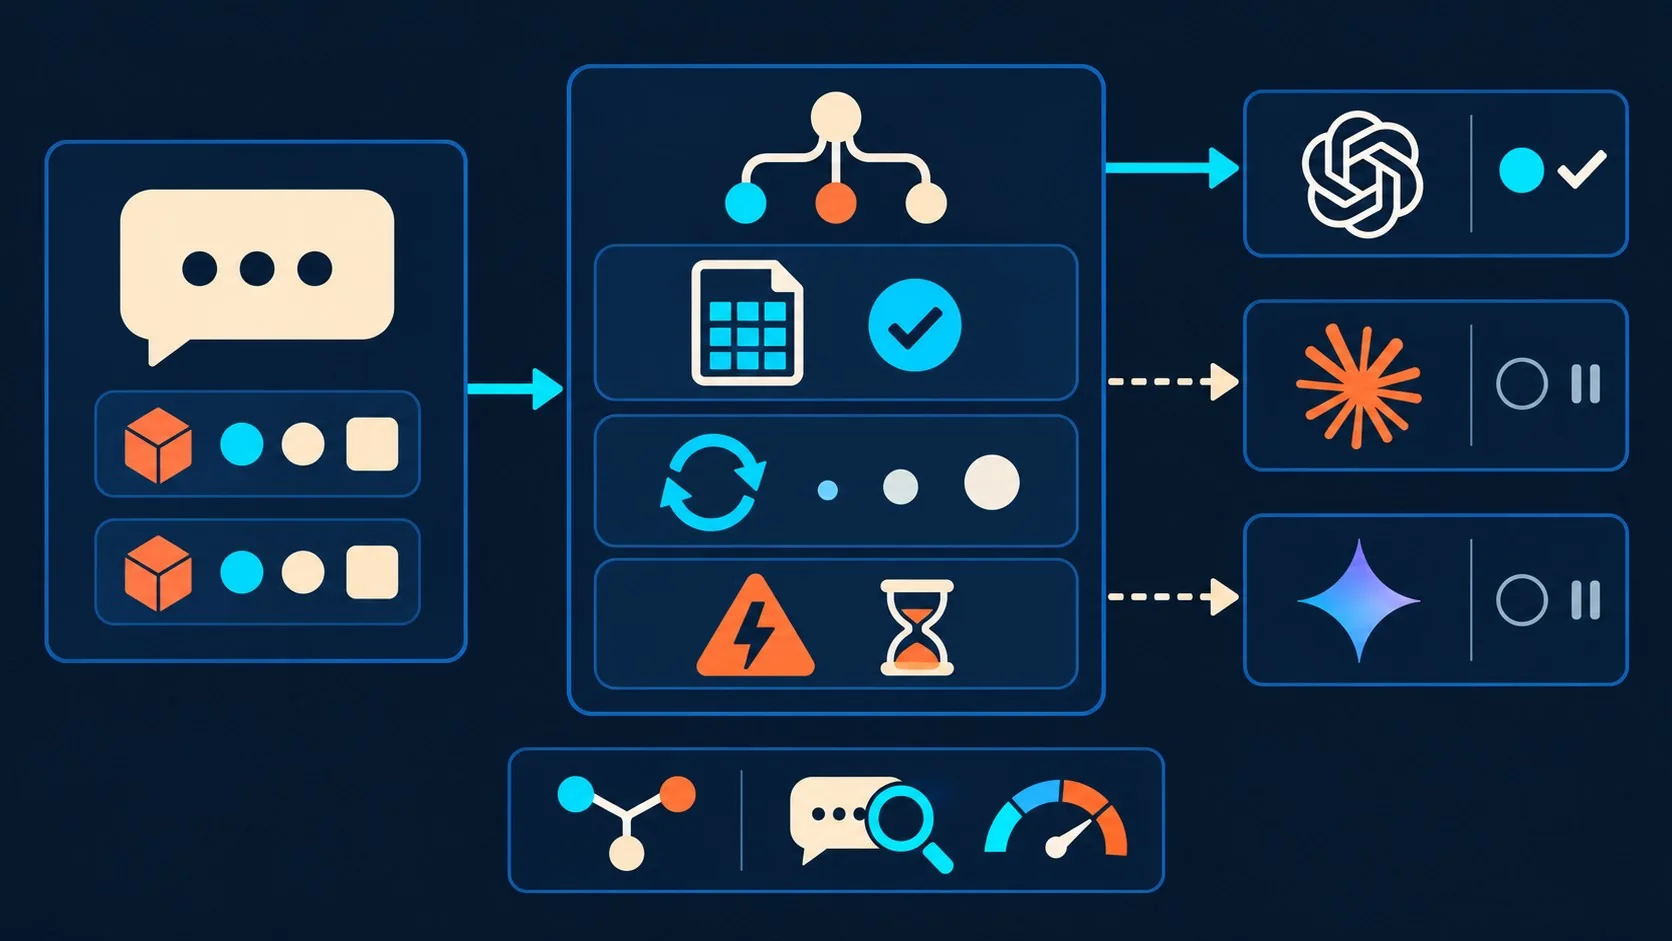
Es una capa intermedia que mantiene un contrato fijo con el frontend y decide, solicitud por solicitud, a qué proveedor enviarla. El frontend manda siempre lo mismo: texto del producto o curso, alumno objetivo y un formato de salida restringido. La capa de routing elige el modelo sin que el código de UI se entere.
Te puede servir nuestra cobertura de todo lo que necesitás saber sobre Sora si querés ver otro caso de un producto de OpenAI detrás de una capa de acceso específica.
En el ejemplo de la fuente, el cliente se conecta a una superficie compatible con OpenAI y usa el valor de modelo auto: ese valor le dice al gateway “elegí vos un proveedor disponible”, y tu servicio sigue siendo responsable de validar la respuesta y aceptarla o no. Es una decisión de routing, no una decisión de frontend.
Un 429 no es una puntuación de calidad.
¿El failover garantiza la calidad de las respuestas del chatbot?
No. El failover protege disponibilidad, no exactitud. Un modelo más barato o más rápido puede devolver una categoría plausible pero con la franja de edad, el nivel de idioma o el objetivo de aprendizaje equivocados, y vos no te enterás hasta que alguien revisa el catálogo a mano.
¿Y cómo te das cuenta antes de que eso pase? La fuente recomienda correr un catálogo etiquetado chico contra cada modelo candidato antes de habilitar el fallback automático, y puntuar categoría, nivel, idioma y objetivo por separado, no como un combo único. Un modelo que responde 300 milisegundos más rápido pero asigna mal el nivel con frecuencia no es “la opción rápida” en ningún sentido útil: te genera trabajo editorial después, que es justo lo que querías evitar con la automatización.
El punto es que un error 429 te dice que un proveedor está saturado. No te dice nada sobre si el proveedor de respaldo entiende bien tu dominio.
API unificada vs. integración directa con OpenAI, Claude o Gemini: ¿cuál conviene?
Depende de si tu problema duro es la continuidad entre proveedores o aprovechar una capacidad específica de uno solo. La fuente plantea cuatro caminos con trade-offs distintos, resumidos en esta tabla:
| Opción | Mejor caso de uso | Trade-off principal |
|---|---|---|
| Integración directa con OpenAI | Un solo proveedor, una familia de modelos estable | Cliente específico del proveedor y trabajo de fallback propio |
| Integración directa con Anthropic | Razonamiento largo de clasificación con equipos Claude-first | Un segundo proveedor exige una integración separada |
| Integración directa con Gemini | Aplicaciones centradas en Google y flujos multimodales | El routing entre otros proveedores queda como tarea tuya |
| API unificada multi-proveedor | Un solo contrato de chatbot con failover automático | Tenés que testear equivalencia de modelos y calidad de salida |
Si lo que buscás es correr varios modelos propios en infraestructura propia en lugar de depender de proveedores externos, ya lo cubrimos antes en armar un cluster de Macs para correr LLMs, que es otro enfoque al mismo problema de disponibilidad.
La recomendación de la fuente es elegir la ruta unificada cuando la continuidad pesa más que exprimir cada solicitud a través de un proveedor preferido. Una sola key y una sola factura entre proveedores también simplifica el seguimiento de uso: sacás el desorden de credenciales y dashboards, pero no sacás la necesidad de evaluar la salida a nivel aplicación.
¿Qué debe cambiar y qué debe mantenerse fijo al diseñar el routing?
El schema de salida y las validaciones de aceptación se mantienen fijos; el proveedor es lo único que puede variar. Esa separación es la que te permite cambiar de modelo sin tocar el frontend ni romper lo que ya validaste.
La fuente propone dos políticas según el caso:
- Escritura en catálogo: rutea al modelo quality-first y rechaza cualquier output que no tenga los campos requeridos (categoría, nivel, idioma, objetivo de aprendizaje).
- Sugerencias interactivas: fijá un presupuesto de latencia y recién ahí activá el failover, después de un timeout del proveedor o de un 429, no antes.
Calidad y latencia tiran para lados distintos. Quien edita el catálogo puede esperar un poco más por un enriquecimiento de alta confianza; un chat en vivo que sugiere un curso, no.
¿Cómo implementar reintentos y backoff ante errores 429 sin duplicar trabajo?
Reintentás solo cuando el error es un 429, nunca ante errores de validación o de formato, y limitás la secuencia a un puñado de intentos con backoff exponencial. El ejemplo de código de la fuente (en TypeScript, sobre un cliente con maxRetries: 0 propio) sigue esta lógica:
- Solo reintentá 429: cualquier otro status (solicitud mal formada, error del servidor) debe fallar de inmediato, porque reintentarlo no arregla nada.
- Respetá el header Retry-After: si el proveedor te dice cuánto esperar, esperá eso, no un valor fijo tuyo.
- Sumá jitter: un poco de aleatoriedad evita que todos tus reintentos pegunten al proveedor en el mismo instante exacto.
- Parate después de dos o tres intentos con un error claro, no con un loop que cuelga la solicitud del usuario.
- Mandá un identificador de solicitud propio (algo como
X-Client-Request-Id, que la documentación de la API de OpenAI describe explícitamente para troubleshooting), así un reintento de tu aplicación no genera trabajo duplicado del otro lado.
Subís el enriquecimiento a producción, probás con una docena de descripciones de curso, funciona bárbaro, pasa una semana y de golpe empiezan a llegar 429 en horario pico porque nadie calculó el límite de tokens por minuto de la cuenta, el reintento no tenía jitter y terminaste mandando seis solicitudes idénticas al mismo proveedor en medio segundo. Por eso la capa de validación va antes del routing, no después: una solicitud mal formada se corta ahí mismo, y el proveedor que está caído lo maneja la capa de routing, no un loop de cliente ajustado a mano.
Si esta capa de routing corre en infraestructura propia, conviene pensar también dónde la hospedás. Un VPS cercano geográficamente a tus usuarios reduce la latencia de ida y vuelta antes de que la solicitud llegue siquiera al proveedor de LLM.
¿Cuándo conviene usar la API unificada y cuándo la integración directa?
Conviene la API unificada cuando el problema duro es mantener uptime entre proveedores y simplificar la operación; conviene la integración directa cuando necesitás una capacidad específica de un proveedor, su semántica nativa de herramientas, o la menor superficie de dependencia posible para una aplicación de bajo riesgo.
Para un prototipo de un solo proveedor, la API directa suele ser la opción más limpia. El cliente oficial y la referencia de la API de OpenAI te dan la superficie más acotada si OpenAI ya es la decisión de producto. La Messages API de Anthropic es un camino directo sólido cuando el comportamiento específico de Claude es central. La API de Gemini, que desde junio de 2026 adoptó la Interactions API como interfaz por defecto según la documentación oficial de Google, encaja bien en equipos que ya operan en el ecosistema de identidad y modelos de Google.
La regla práctica de la fuente es simple: preservá un solo contrato de solicitud, testeá cada modelo de fallback contra los mismos fixtures y fallá en forma cerrada cuando la salida no cumpla el schema del catálogo. El failover automático protege disponibilidad. Las validaciones de calidad son lo que evita que esa protección termine convertida en metadata de curso mal etiquetada.
Errores comunes al armar un chatbot con failover multi-proveedor
- Tratar el failover como garantía de calidad: activar el modelo de respaldo sin medirlo antes contra un set etiquetado. El resultado típico es categorías plausibles pero con el nivel o el idioma mal asignado, y nadie lo nota hasta que el catálogo ya está publicado.
- Reintentar cualquier tipo de error: meter el 400 (solicitud mal formada) en el mismo loop de reintentos que el 429. Eso solo demora el error visible, no lo evita.
- No mandar un request identifier propio: sin un
X-Client-Request-Ido equivalente, un timeout te deja sin forma de saber si el proveedor procesó tu solicitud o no, y el reintento puede duplicar trabajo del lado del catálogo. - Dejar el reintento sin jitter ni tope: un backoff fijo sin aleatoriedad hace que varias instancias de tu servicio reintenten al mismo tiempo exacto, lo que empeora la saturación en lugar de aliviarla.
Preguntas Frecuentes
¿Cómo evitar que mi chatbot se caiga si OpenAI devuelve un error 429?
Implementando una capa de routing detrás de un contrato fijo que redirija la solicitud a un proveedor alternativo (Claude o Gemini) cuando el principal devuelva 429, en vez de reintentar indefinidamente contra el mismo proveedor saturado. El reintento debe ser acotado, respetar el header Retry-After y sumar jitter antes de fallar al proveedor de respaldo.
¿Qué es una API unificada multi-proveedor para LLM?
Es una interfaz única, normalmente compatible con el formato de OpenAI, que enruta cada solicitud hacia OpenAI, Anthropic o Google por detrás sin que el frontend del chatbot cambie. El valor de modelo “auto” delega esa elección de proveedor al gateway, mientras tu aplicación sigue validando la respuesta final. Complementá con cómo rinden estos modelos en auditorías de código.
¿Conviene usar una API unificada o integrar directamente con OpenAI, Claude o Gemini?
Conviene la unificada cuando el problema central es mantener disponibilidad entre proveedores y simplificar facturación y monitoreo. Conviene la integración directa cuando necesitás una capacidad propia de un proveedor específico, como la semántica de herramientas de Claude o los flujos multimodales de Gemini.
¿Cómo mantener la calidad de las respuestas cuando el modelo de respaldo cambia automáticamente?
Corriendo un catálogo etiquetado chico contra cada modelo candidato antes de habilitar el fallback, y puntuando por separado categoría, nivel, idioma y objetivo de aprendizaje. Un modelo más rápido que falla seguido en una de esas dimensiones genera más trabajo editorial del que ahorra en latencia.
¿Cómo implementar reintentos con backoff para errores 429 en llamadas a un LLM?
Reintentando únicamente ante status 429, respetando el valor del header Retry-After cuando el proveedor lo envía, sumando jitter aleatorio al tiempo de espera y deteniendo la secuencia después de dos o tres intentos con un error accionable. Cualquier otro tipo de error (solicitud mal formada, 500) debe fallar de inmediato sin reintento.
Conclusión
El patrón que describe la fuente no es nuevo en sistemas distribuidos (failover detrás de un contrato fijo), pero aplicarlo a LLMs trae un matiz que no existe en una base de datos replicada: el proveedor de respaldo puede responder rápido, con status 200, y seguir estando mal para tu dominio. Esa es la diferencia entre resolver disponibilidad y resolver calidad, y son dos problemas separados que necesitan dos soluciones separadas.
Si estás armando un chatbot que depende de un solo LLM hoy, el primer paso realista no es meter una API unificada de una. Es armar el catálogo etiquetado chico que menciona la fuente, correr tus candidatos a modelo de respaldo contra él, y recién después decidir si el ahorro en continuidad justifica el trabajo de validación que viene con tener más de un proveedor en producción.
Fuentes
- How to Build a Unified LLM Chatbot: Quality, Latency, and Failover – guía técnica original en dev.to
- Documentación oficial de la API de OpenAI – referencia de endpoints, rate limits y headers
- Messages API de Anthropic – referencia oficial del endpoint de mensajes de Claude
- Documentación oficial de la API de Gemini – Google AI for Developers