En pocas palabras: Se arma conectando las Macs Apple Silicon ociosas de la red: exo reparte el modelo entre equipos, llama.cpp lo sirve, Ray Serve rutea los pedidos y Prometheus mide el consumo. Una guía de dev.to del 14/10/2026 afirma 8 tokens por segundo con Llama-2-7B en una Mac Studio M2 Max.
Una guía publicada en dev.to el 14/10/2026 propone armar un cluster de Macs para LLM con equipos Apple Silicon ociosos: exo reparte el modelo, llama.cpp lo sirve, Ray Serve rutea los pedidos y Prometheus mide el consumo. Es una guía de comunidad, no un anuncio de Apple.
Un cluster de Macs para LLM es un conjunto de computadoras Apple Silicon conectadas en red que se reparten la ejecución de un modelo de lenguaje, ya sea dividiéndolo entre equipos (inferencia distribuida) o replicándolo en cada uno para atender más pedidos. Aprovecha la memoria unificada, donde CPU y GPU comparten la misma RAM física, y sirve a quien tiene Macs subutilizadas y quiere correr modelos propios en local.
En este artículo:
- En 30 segundos
- ¿Qué propone la guía de dev.to para aprovechar Macs ociosas?
- ¿Cómo se arma un cluster de Macs para LLM con exo?
- ¿Cómo aprovecha llama.cpp la memoria unificada de Apple Silicon?
- ¿Se puede usar Ray Serve para repartir pedidos entre Macs?
- ¿Cuánto cuesta y cómo se monitorea el cluster?
- ¿Qué significa para equipos en Latinoamérica?
- ¿Qué está confirmado y qué no?
- ¿Cómo verificar la guía antes de copiarla?
- Errores comunes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- La guía de dev.to combina exo, llama.cpp, Ray Serve y Prometheus, y afirma 8 tokens por segundo con Llama-2-7B en una Mac Studio M2 Max, sin metodología.
- El README de exo describe descubrimiento automático de dispositivos. En el fragmento que revisamos no aparece el comando
exo cluster init --config inventory.yamlque usa la guía. - El texto tiene errores internos: pide “35 de 32 capas” y su cuenta de costo da US$0,043 por día, no “menos de US$0,04”.
- Ray Serve replica el modelo en cada nodo. Repartir un modelo grande entre equipos es trabajo de exo.
¿Qué propone la guía de dev.to para aprovechar Macs ociosas?
La guía, publicada en dev.to el 14/10/2026, propone usar las Macs con Apple Silicon que quedan prendidas sin trabajo de noche como pool de inferencia. Las piezas son exo para el mesh, llama.cpp para servir el modelo, Ray Serve para rutear pedidos y Prometheus con powermetrics para medir. Arranca con un dato: una Mac Studio M2 Max sirve Llama-2-7B a 8 tokens por segundo, según el propio texto.
Ahora bien, hay contexto para leerla con cuidado. El cierre admite “This article was drafted with AI assistance” y termina promocionando un producto del autor, “Prompt Engineering for AI Roles: Hiring Manager & Engineer Guide”.
Los 8 tokens por segundo no traen cuantización, tamaño de contexto ni método de medición. Tomalo con pinzas (es un número de la fuente, no un benchmark).
¿Cómo se arma un cluster de Macs para LLM con exo?
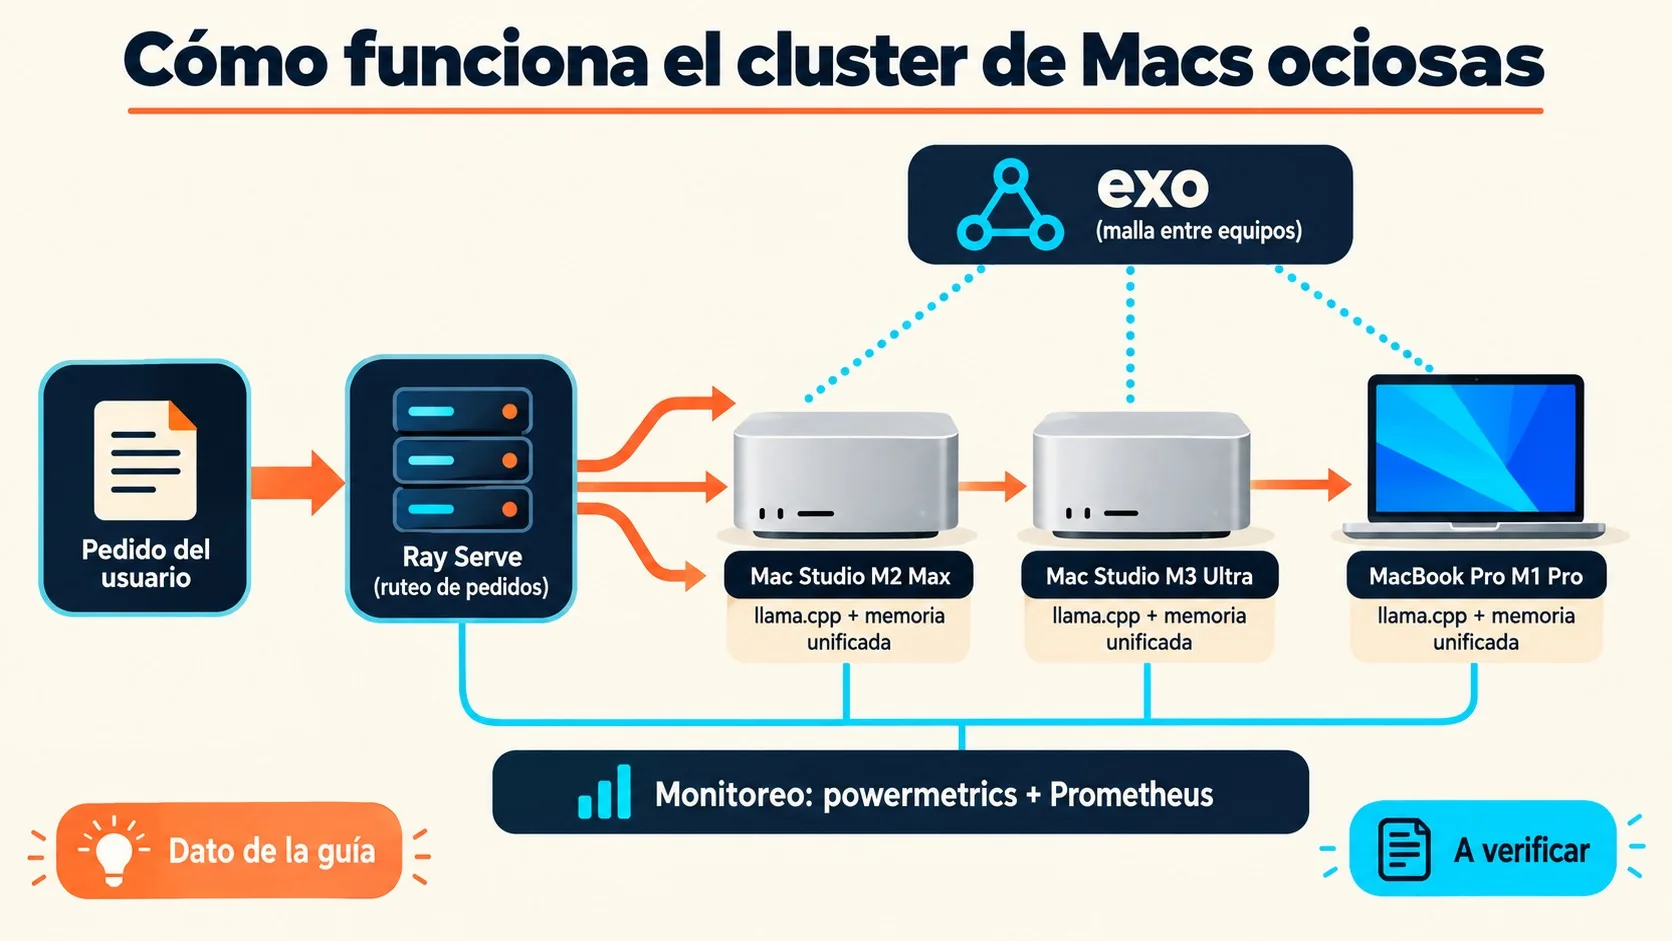
Según el README oficial de exo, los dispositivos que corren exo se descubren solos, sin configuración manual, y cada uno expone una API y un dashboard en http://localhost:52415. La guía de dev.to cuenta otra historia: inventario con arp-scan, un YAML y exo cluster init en cada nodo.
El inventario de la guía registra host, núcleos de GPU y memoria unificada de cada Mac. Sirve como planilla de control. Pero arp-scan --localnet | grep -i apple solo filtra por fabricante, así que va a listar también Macs Intel (inferencia nuestra, no de la fuente). Más contexto en montar Ollama como self-hosting sin permisos de root.
Lo que el README sí documenta, y la guía omite (los requisitos de versión y la lista de equipos son los que figuraban en el README al 14/10/2026, fecha de esta nota, y pueden cambiar):
- Backend MLX. exo usa MLX para inferencia y MLX distributed para la comunicación entre equipos.
- Paralelismo de tensores. El README habla de hasta 1,8x de aceleración con 2 dispositivos y 3,2x con 4.
- RDMA sobre Thunderbolt 5. Según el README al 14/10/2026, requiere macOS 26.2 y una Mac con Thunderbolt 5 (M4 Pro Mac mini, M4 Max Mac Studio, M4 Max MacBook Pro o M3 Ultra Mac Studio). El README declara una reducción de latencia del 99% entre equipos. Esa lista de equipos y la versión mínima de macOS cambian con el tiempo: confirmalas en el README vigente antes de comprar o actualizar.
- App para macOS. Según el README al 14/10/2026, pide macOS Tahoe 26.2 o posterior y se instala con
brew install --cask exo. Chequeá el requisito actual en el README antes de instalar. - Aislamiento de clusters. La variable
EXO_ZENOH_NAMESPACEevita que tu cluster de pruebas se mezcle con otro en la misma red.
Los benchmarks del README (4 Mac Studio M3 Ultra de 512 GB con DeepSeek v3.1 y Kimi K2 Thinking) los atribuye a Jeff Geerling. Es hardware de otra liga que el de la guía, con dos M2 Max, una M3 Ultra y una M1 Pro. Que esas aceleraciones se repitan en esa mezcla, sobre una LAN común, no está demostrado en ninguna de las fuentes.
Y los detalles de RDMA muerden: cada equipo tiene que conectarse a todos los demás, los cables tienen que ser TB5, en una Mac Studio no sirve el puerto Thunderbolt 5 al lado del Ethernet y las versiones de macOS deben coincidir exactamente, incluso las betas. Instalás exo, abrís el dashboard, las Macs aparecen, cargás un modelo, todo anda hasta que un cable no es TB5 o una máquina quedó en otra versión del sistema y ahí perdés la tarde.
¿Cómo aprovecha llama.cpp la memoria unificada de Apple Silicon?
En Apple Silicon, CPU y GPU direccionan las mismas páginas de memoria física, así que no hay copias por PCIe, según la guía. llama.cpp aprovecha eso con --n-gpu-layers, que define cuántas capas del modelo van a la GPU. Con esa bandera, el servidor se levanta así: ./llama-server -m model.gguf -c 4096 --n-gpu-layers 35 --port 8080.
Acá la guía se contradice. Dice que en una M2 Max se pueden descargar “35 de 32 capas” de un modelo de 7B. Llama-2-7B tiene 32 capas, así que 35 pide más de las que existen. Lo razonable es que equivalga a offload completo, pero confirmalo en el log.
Después afirma que la M3 Ultra puede con las 32 capas “porque la GPU de 80 núcleos aguanta todos los pesos”. Como el texto nunca da la memoria de cada equipo, esa distinción entre M2 Max y M3 Ultra queda sin respaldo. Tampoco hay forma de verificar la “versión 0.3.0” de llama.cpp que menciona: mirá los releases del proyecto en vez de fiarte del número. Te puede servir nuestra cobertura de cómo viaja cada petición hasta la respuesta.
Para comprobar la residencia de capas, la guía sugiere llama-server -m model.gguf --verbose 2>&1 | grep "gpu_layers". El texto exacto del log puede cambiar entre versiones, así que leé la salida completa y no solo lo que devuelva el grep.
¿Se puede usar Ray Serve para repartir pedidos entre Macs?
Sí, como replicador y enrutador de pedidos, pero no para dividir un modelo entre Macs. En la guía, cada actor de Ray Serve carga su propia copia del modelo con llama.cpp. Eso es replicación, y sube la capacidad de atender pedidos en paralelo sin permitir modelos más grandes que la memoria de una sola Mac.
El flujo de la fuente: ray start --head --port=6379 en el nodo más potente, y en cada worker ray start --address=<head-ip>:6379 --resources='{"GPU": 1}'. Después, un deployment con num_gpus: 0.25.
Ahí hay dos cosas. Declarar "GPU": 1 a mano es un recurso lógico que vos anunciás, y no prueba que Ray detecte la GPU Metal. El issue #28321 de Ray (abierto desde el 07/09/2022, etiquetado como enhancement y P2) pide soporte de mps en torch dentro de RLlib. Es otro componente, así que no alcanza para afirmar el estado de Ray en general, pero tampoco hay nada que cierre el tema.
Segunda cosa: con GPU 1 por nodo y 0,25 por réplica, Ray puede agendar hasta cuatro réplicas por Mac (inferencia nuestra), o sea cuatro copias del modelo en memoria unificada. Y la “menor cola” que describe el texto no aparece en el código de ejemplo, que solo reenvía el prompt al LlamaCPP.
¿Cuánto cuesta y cómo se monitorea el cluster?
La guía estima que cuatro Macs consumen unos 120 W en total y que un día cuesta “menos de US$0,04” con US$0,015 por kWh. La cuenta no cierra: 120 W durante 24 horas son 2,88 kWh, y a US$0,015 dan US$0,0432. Para más detalles técnicos, mirá qué hardware necesitás para ejecutar modelos localmente.
Con una tarifa hipotética diez veces mayor (US$0,15/kWh, un ejemplo nuestro), el día saldría US$0,43. En la Argentina la cuenta depende de tu tarifa vigente, un dato que las fuentes no traen. La fórmula es simple: watts divididos por 1000, por las horas, por tu precio del kWh. Y la guía no aclara si esos 120 W son carga sostenida o consumo promedio.
Para medir, la guía usa sudo powermetrics --samplers gpu_power -i 1000 -n 1 y un exportador de Prometheus llamado mac_gpu_exporter, que lee cada 10 segundos. La alerta es avg_over_time(mac_gpu_utilization[5m]) > 0.8, y un job de launchd despertaría Macs dormidas. No encontramos un repositorio público de ese exportador en las fuentes, y el texto tampoco dice quién ejecuta el job si las Macs duermen.
Como alternativa, el README de exo menciona macmon (opcional) para ver uso de GPU, consumo y temperatura en Apple Silicon. Sin él, exo mide solo memoria con psutil. El README avisa que la versión 0.6.1 de Homebrew todavía se cuelga en Apple M5, y recomienda un fork fijado.
¿Qué significa para equipos en Latinoamérica?
Si ya tenés Macs prendidas en la oficina, probar el esquema cuesta poco, pero mandá la cuenta de luz a tu propia tarifa y no a la de la guía. Si necesitás exponer el endpoint con dominio fijo, un VPS de donweb.com puede hacer de proxy inverso hacia la red interna (la configuración queda de tu lado).
¿Qué está confirmado y qué no?
Confirmado en las fuentes:
- El README de exo documenta descubrimiento automático, MLX, tensor parallelism (1,8x con 2 dispositivos, 3,2x con 4), RDMA sobre Thunderbolt 5 con macOS 26.2 (requisito vigente al 14/10/2026) y compatibilidad con APIs de OpenAI, Claude y Ollama.
- La guía de dev.to existe, con fecha 14/10/2026, y declara asistencia de IA.
- El issue #28321 de Ray sigue abierto en la captura que revisamos.
Sin confirmar:
- El comando
exo cluster init --config inventory.yaml: no aparece en el fragmento del README que revisamos (el texto estaba cortado, así que puede estar más adelante). - Los 8 tokens por segundo y los 120 W: sin metodología.
- La existencia pública de
mac_gpu_exporter. - El ruteo por menor cola de Ray Serve en el código de ejemplo.
¿Cómo verificar la guía antes de copiarla?
Propuesta editorial nuestra, no de la fuente, y sin pruebas propias detrás:
- Una sola Mac primero. Levantá llama-server con
--verbose, anotá cuántas capas quedan en GPU y los tokens por segundo con tu modelo, y compará con los 8 de la guía. - exo sin el comando. Instalá exo en dos Macs y fijate si se ven solas en el dashboard antes de buscar
cluster init. - Watts reales. Medí con powermetrics en reposo y con carga, y multiplicá por tu tarifa.
- Memoria por réplica. Si usás Ray, contá cuántas réplicas levanta cada nodo y cuánta memoria ocupa cada copia.
Errores comunes
- Copiar el comando sin chequearlo. Si
exo cluster initno existe en tu versión, vas a perder tiempo. Corregilo mirando el README y el dashboard. - Creer que Ray reparte el modelo. Ray Serve replica copias. Si el modelo no entra en una Mac, necesitás el sharding de exo.
- Pedir más capas de las que tiene el modelo.
--n-gpu-layers 35en un 7B de 32 capas es un valor sin sentido. Leé el log y ajustá al número real. - Armar RDMA a ojo. Cables sin TB5, el puerto al lado del Ethernet o versiones de macOS distintas rompen el descubrimiento. Revisá los caveats del README.
- Dar por buena la cuenta de luz. Con la tarifa de la guía el día da US$0,0432. Recalculá con tu factura.
Preguntas Frecuentes
¿Se puede armar un cluster de Macs con Apple Silicon para correr LLM?
Sí. El README de exo describe un cluster que conecta varios dispositivos para correr modelos más grandes que los que caben en uno solo, con MLX como backend. Las aceleraciones publicadas (1,8x con 2 equipos y 3,2x con 4) corresponden a configuraciones con RDMA sobre Thunderbolt 5.
¿Qué es exo?
exo es un proyecto de código abierto, mantenido por exo labs, que conecta tus dispositivos en un cluster de IA. Según su README, descubre los equipos solo, reparte el modelo según la topología y es compatible con las APIs de OpenAI, Claude Messages y Ollama. Tema relacionado: nuestra guía para correr LLMs en local.
¿Ray reconoce la GPU de Apple Silicon?
Las fuentes no lo confirman. El issue #28321 de Ray, abierto desde 2022, pide soporte de mps en torch para RLlib y sigue abierto. La guía declara "GPU": 1 a mano, un recurso lógico que no prueba detección de la GPU Metal.
¿Cuánto consume una Mac Studio corriendo un LLM todo el día?
Las fuentes no traen un dato por Mac Studio. La guía estima unos 120 W para cuatro Macs, es decir 2,88 kWh por día en total, sin aclarar la carga. Para saber el tuyo, medí con powermetrics y multiplicá por tu tarifa.
¿Cómo se configura –n-gpu-layers en llama.cpp en una Mac?
Se pasa la cantidad de capas a descargar a la GPU, por ejemplo --n-gpu-layers 32 para un modelo de 7B de 32 capas. Verificá en el log de --verbose cuántas quedaron realmente en GPU y no pidas más capas de las que tiene el modelo.
Conclusión
La idea de aprovechar Macs ociosas es razonable, y exo tiene respaldo documentado para armarla. La guía de dev.to sirve como punto de partida, pero no como receta: tiene una cuenta de costo que no cierra, un conteo de capas imposible y un comando que no encontramos en el README.
Qué hacer: probá una Mac sola, medí tus propios tokens por segundo y watts, y dejá exo descubrir las máquinas antes de buscar comandos extra. Si el modelo entra en una Mac, Ray Serve alcanza para repartir pedidos. Si no entra, el cluster de Macs para LLM necesita sharding de exo, y con eso conviene mirar primero qué Macs tienen Thunderbolt 5, según la lista vigente en el README.