En pocas palabras: Para armar un agente LangGraph con FastAPI y SSE, definís un grafo ReAct con nodos agent y tools, lo exponés con POST /chat (JSON) y POST /chat/stream (eventos token, tool, done y error), y limitás mensajes a 4000 caracteres y 10 pasos de recursión por defecto.
Un agente LangGraph FastAPI reparte el trabajo así: LangGraph orquesta el ciclo del agente y sus herramientas, y FastAPI lo expone por HTTP con /chat (JSON) y /chat/stream (Server-Sent Events). El ejemplo de Salada de Dados, publicado el 14/10/2026, usa Open-Meteo como herramienta real.
LangGraph es una librería de LangChain para definir el flujo de un agente de IA como un grafo: nodos que ejecutan pasos, aristas que los conectan y un estado compartido que viaja entre ellos. FastAPI es el framework web de Python que recibe las requests HTTP. Server-Sent Events (SSE) es un estándar para que el servidor empuje eventos al cliente sobre una respuesta HTTP abierta.
En este artículo:
- En 30 segundos
- ¿Cómo funciona un agente LangGraph con nodos, aristas y estado?
- ¿Cómo se expone un agente LangGraph con FastAPI?
- ¿Cómo conecta el agente la herramienta de clima de Open-Meteo?
- ¿Cómo se hace streaming con Server-Sent Events en FastAPI y LangGraph?
- ¿Por qué conviene separar el agente de la capa HTTP?
- ¿Qué le falta a un agente LangGraph FastAPI para producción?
- Qué está confirmado y qué no
- ¿Cómo verificar el comportamiento antes de adoptarlo?
- Errores comunes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Qué es: un repo mínimo con LangGraph (flujo del agente), FastAPI (HTTP), SSE (streaming) y la API gratuita de Open-Meteo como herramienta.
- Endpoints: POST /chat devuelve la respuesta completa en JSON; POST /chat/stream emite eventos token, tool, done y error.
- Límites incluidos: mensajes de hasta 4000 caracteres y un recursion_limit de 10 pasos por request, según el README.
- Qué no es: un sistema de producción. No tiene autenticación, rate limiting, memoria de conversación ni base de datos.
- Ojo con la licencia: la API gratuita de Open-Meteo es solo para uso no comercial.
¿Cómo funciona un agente LangGraph con nodos, aristas y estado?
Un agente LangGraph es un grafo compilado: definís un estado, nodos que lo modifican y aristas que fijan el orden. En el ejemplo, el estado es la lista de mensajes y hay dos nodos: agent llama al LLM con la conversación y las herramientas disponibles, y tools ejecuta lo que el modelo pidió y devuelve el resultado.
El README del repo lo describe como un loop ReAct escrito a mano para que cada paso se vea. En la documentación de LangGraph el patrón de armado es el mismo: un StateGraph, add_node, add_edge desde START y compile().
Me gusta esa decisión. Si venís de tutoriales que esconden el loop detrás de un helper, acá ves dónde cortar cuando algo se pone raro.
Cada vuelta agent → tools consume 2 pasos. Con el AGENT_RECURSION_LIMIT por defecto de 10, el README calcula hasta 4 rondas de herramientas más la respuesta final; si el modelo insiste en llamar herramientas, la corrida se corta y el cliente recibe un error genérico.
¿Cómo se expone un agente LangGraph con FastAPI?
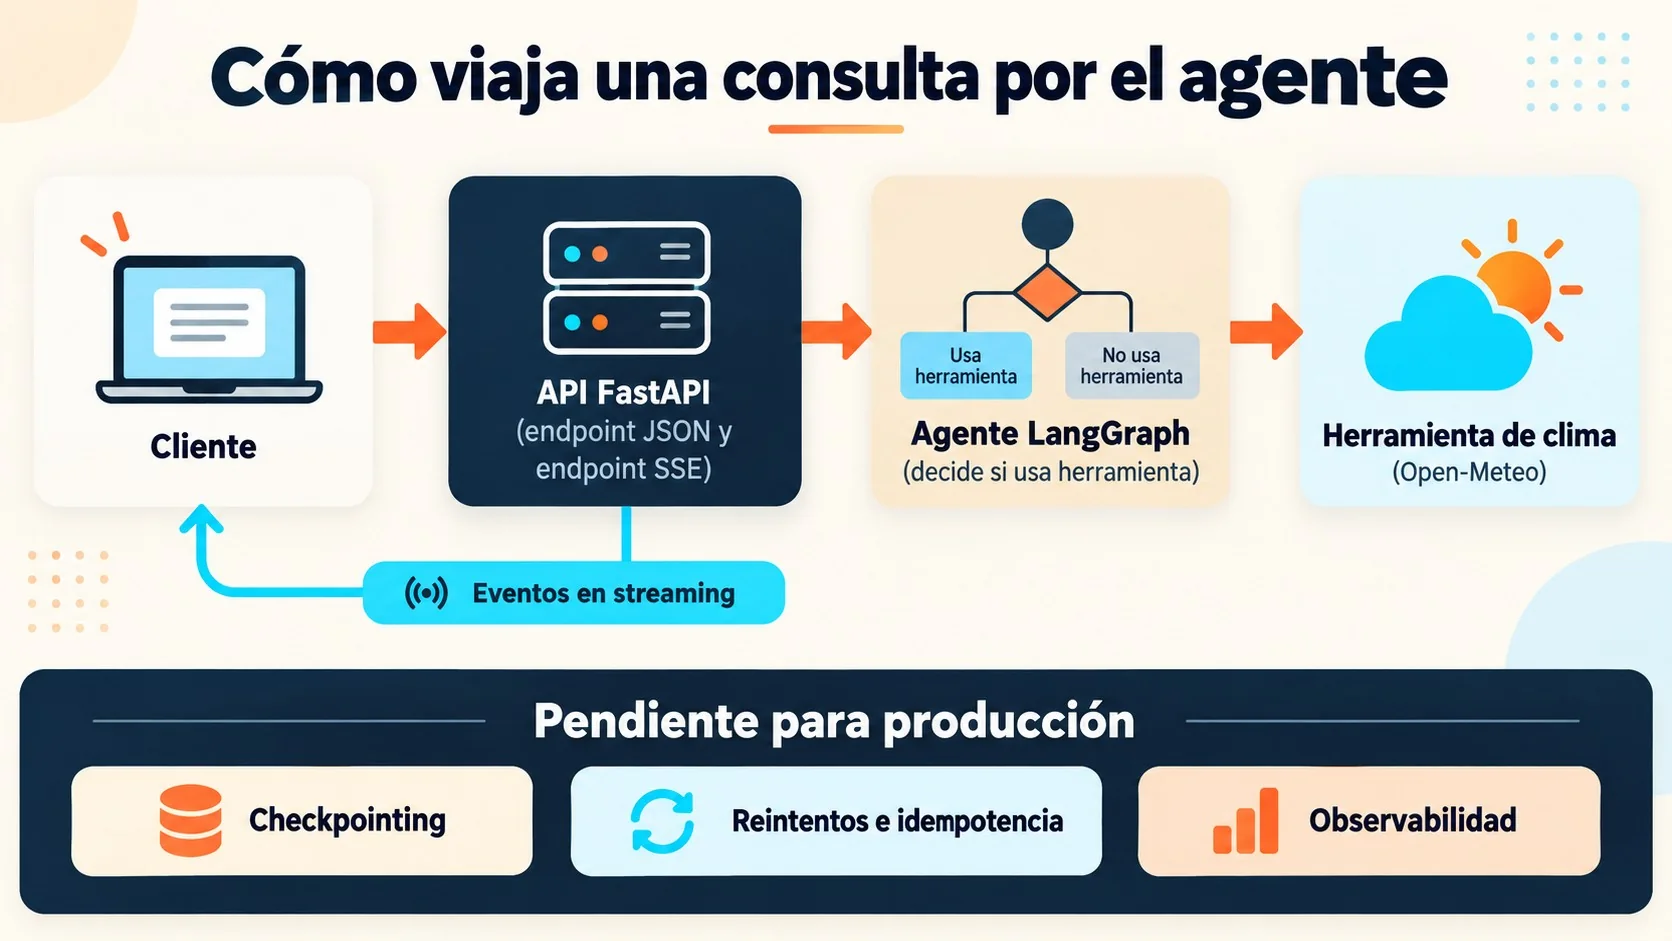
Se pone el grafo detrás de una app FastAPI con dos endpoints sobre el mismo agente: POST /chat espera la respuesta final y la devuelve como JSON, y POST /chat/stream manda eventos a medida que el agente trabaja. Además hay un GET /health. Necesitás Python 3.11+ y una API key de Anthropic u OpenAI. Más contexto en los riesgos de seguridad en agentes de IA.
La configuración se resume en una variable, LLM_MODEL, con formato proveedor:modelo. El README usa como ejemplos anthropic:claude-sonnet-5-5 y openai:gpt-5, y cambiar de proveedor es tocar el .env y reiniciar, sin cambios de código.
uvicorn app.main:app --reload

curl -N -X POST http://localhost:8000/chat/stream \
 -H "Content-Type: application/json" \
 -d '{"message": "What is the weather like in Lisbon right now?"}'
La estructura del proyecto muestra la separación de responsabilidades:
- app/main.py: la app FastAPI.
- app/api/chat.py: los endpoints /chat y /chat/stream.
- app/agents/: state.py (lista de mensajes), tools.py (get_weather) y graph.py (LLM, herramientas y grafo).
- app/core/config.py: settings leídos del .env.
El cliente no necesita saber cómo el agente elige herramientas. Habla con una interfaz HTTP clara, que es el punto central del tutorial original.
¿Cómo conecta el agente la herramienta de clima de Open-Meteo?
El agente tiene una herramienta, get_weather, que consulta la API gratuita de Open-Meteo (no pide key). El modelo decide si la necesita, el nodo tools la ejecuta, el resultado vuelve al agente y este arma la respuesta. El tutorial lo resume en cinco pasos:
- El usuario hace una pregunta sobre el clima.
- El modelo decide si necesita la herramienta.
- La herramienta pide los datos externos.
- El resultado vuelve al agente.
- El agente responde con ese resultado.
Un ejemplo reproducible: preguntá por el clima en Lisboa y la respuesta debería traer la temperatura actual, señal de que se llamó la herramienta. Preguntá “What is LangGraph?” y debería llegar una respuesta sin evento tool, porque el agente solo llama herramientas cuando hace falta.
Acá aparecen problemas que una completion simple no tiene: fallos de red, errores de la herramienta, latencia y reintentos. Si Open-Meteo no responde, el README dice que la herramienta le pasa al LLM un mensaje genérico (el detalle va a los logs) y el agente puede avisarle al usuario en vez de tirar abajo toda la request.
El ejercicio que sugiere la fuente es el que yo haría: cambiá el clima por una API de tu propio sistema. Ahí vas a descubrir qué timeouts y qué errores tipados te faltan.
¿Cómo se hace streaming con Server-Sent Events en FastAPI y LangGraph?
Con FastAPI, declarás el endpoint con response_class=EventSourceResponse y usás yield para emitir eventos; con LangGraph, iterás astream() y convertís cada fragmento en un evento. Según la documentación de FastAPI, el soporte SSE llegó en la versión 0.135.0 y funciona con cualquier método HTTP, POST incluido.
El contrato de eventos del repo, según el README, es este:
- token: {“content”: “…”} cuando llega un pedazo del texto del LLM.
- tool: {“name”: “get_weather”} cuando una herramienta terminó de correr.
- done: {} cuando el agente terminó.
- error: {“detail”: “…”} cuando algo falló.
Un stream tiene cero o más token, un tool por cada herramienta que termina y siempre cierra con exactamente un done o un error. Ojo: token y tool pueden intercalarse, porque algunos modelos escriben “Let me check the weather…” antes de llamar la herramienta y otros llaman directo. No dependas de un orden fijo. Cubrimos ese tema en detalle en cómo se reescribe código a Rust con IA.
¿Qué modo de streaming de LangGraph usa el repo por dentro? El README no lo dice, y no revisé el código de app/api/chat.py. La documentación lista los modos updates, values, messages, custom, checkpoints, tasks y debug; messages devuelve tuplas (fragmento, metadata) con los tokens del LLM, así que es el candidato lógico para eventos token, pero eso es inferencia mía.
Para entender la idea, este es un boceto hipotético armado con las dos documentaciones. No es el código del repo y no lo ejecuté:
@app.post("/chat/stream", response_class=EventSourceResponse)
async def chat_stream(body: ChatRequest) -> AsyncIterable[ServerSentEvent]:
 try:
 async for part in graph.astream(
 {"messages": [{"role": "user", "content": body.message}]},
 stream_mode="messages",
 version="v2",
 ):
 msg, _meta = part["data"]
 if msg.content:
 yield ServerSentEvent(data={"content": msg.content}, event="token")
 yield ServerSentEvent(data={}, event="done")
 except Exception:
 yield ServerSentEvent(data={"detail": "The agent failed to produce an answer."}, event="error")
Dos aclaraciones. El formato v2 de la documentación pide LangGraph 1.1 o posterior, y la misma página recomienda la API de event streaming (LangGraph v1.2) para aplicaciones nuevas. Y el tipo de msg.content depende del proveedor, así que verificalo con el tuyo antes de serializarlo.
¿SSE o WebSockets para un agente de IA?
Para un agente que recibe una pregunta y devuelve una respuesta en partes, SSE alcanza: es una sola dirección (servidor a cliente) sobre HTTP común. Los WebSockets abren un canal en ambos sentidos y se justifican si el cliente tiene que mandar mensajes mientras el agente corre, por ejemplo para cancelar. Ninguna de las fuentes compara ambos; esta es mi lectura.
El stream de SSE es de ida, así que cancelar se resuelve cerrando la conexión, y ahí entra la pregunta que la fuente deja abierta: qué hace el servidor cuando el cliente se va.
¿Por qué conviene separar el agente de la capa HTTP?
Porque el agente es dueño del flujo y de las herramientas, y FastAPI maneja requests, responses y transporte. Con ese límite podés testear el agente solo, cambiar la API sin tocar el grafo y sumar otros clientes después. Es también el lugar natural para autenticación, persistencia y observabilidad. Lo explicamos a fondo en el malware que se cuela en repositorios de agentes.
El repo lo demuestra: su suite de pytest usa un LLM falso y un Open-Meteo mockeado, así que corre sin API key y sin red. Cubre validación de entrada, los caminos de éxito y falla de la herramienta, la secuencia de eventos de /chat/stream y el corte por recursion_limit.
¿Qué le falta a un agente LangGraph FastAPI para producción?
Le falta casi todo lo que rodea al agente: autenticación, rate limiting, memoria, base de datos, despliegue, observabilidad y manejo de errores tipado. El README del repo lo dice sin vueltas: está “diseñado para enseñar la arquitectura, no para desplegarse tal cual” (traducción propia).
El escenario que me imagino, y que no es raro: levantás el ejemplo, le preguntás por el clima en Lisboa, ves llegar los tokens por la terminal, te entusiasmás, lo publicás en un dominio, y a la semana alguien encuentra la URL y te quema la cuota de tokens porque nadie puso autenticación ni límite de requests.
Antes de exponerlo a internet
- Autenticación: cualquiera que encuentre la URL puede llamar a /chat, y cada llamada gasta tokens de tu key.
- Rate limiting: un cliente puede disparar miles de requests y cada una puede ejecutar varias llamadas al LLM.
- Licencia de Open-Meteo: la API gratuita es solo para uso no comercial; un producto comercial necesita su plan pago u otro proveedor.
Los guardrails que sí trae (tope de 4000 caracteres, límite de pasos, errores genéricos) son eso, guardrails. El README aclara que no son controles de costo: no limitan los tokens generados ni el gasto por cliente.
Antes de llamarlo “listo para producción”
- Memoria y persistencia: el grafo no tiene checkpointer, así que cada request arranca de cero. Un chat real necesita thread_id, checkpointing de LangGraph y una base (el README menciona PostgreSQL) compartida entre workers.
- Reintentos e idempotencia: reintentar es peligroso si la herramienta modifica sistemas externos. Un cobro no puede repetirse, y el checkpointing solo no lo garantiza; los efectos externos necesitan su propia protección.
- Observabilidad: sin logs estructurados, trazas y métricas no podés responder “¿por qué el agente hizo eso?” ni “¿cuánto cuesta?”. El tutorial nombra LangSmith como una opción de trazado por ejecución, nodo y llamada a herramienta.
- Despliegue y configuración: no hay Dockerfile, y el README pide correr con varios workers en vez de –reload, secretos en un gestor y reglas de CORS si el navegador está en otro dominio.
- Health checks: /health responde “ok” aunque el proveedor del LLM esté caído.
Sobre el hosting, la fuente no recomienda nada. Para una prueba, cualquier VPS o servidor cloud alcanza; si buscás infraestructura y dominios en Argentina, podés mirar donweb.com.
Una nota de transparencia: el tutorial cierra invitando a una lista de acceso anticipado de un “Production LangGraph + FastAPI Starter” del mismo autor. La lista de faltantes es útil igual, pero tené presente que quien la escribe vende la solución.
Qué está confirmado y qué no
Confirmado por el README y el tutorial:
- Endpoints y eventos: /chat, /chat/stream y /health, con eventos token, tool, done y error.
- Errores: /chat devuelve 502 si el agente falla; /chat/stream mantiene el 200 y manda un evento error al final.
- Límites: mensaje vacío o más largo que MAX_MESSAGE_LENGTH (4000 por defecto) da 422; AGENT_RECURSION_LIMIT vale 10 por defecto.
- Ausencias: sin checkpointer, sin base de datos, sin Dockerfile.
Sin confirmar o sin cubrir:
- Modo de streaming interno: el README no dice cuál usa el repo.
- Desconexión del cliente: el tutorial lo plantea como pregunta abierta, sin respuesta.
- Latencia y costo por request: ninguna fuente trae cifras, así que no podés estimar presupuesto con estos datos.
- Otros proveedores: el README menciona Google, Mistral y Ollama como posibles, pero solo detalla Anthropic y OpenAI.
¿Cómo verificar el comportamiento antes de adoptarlo?
Una propuesta editorial (no viene de la fuente ni la probamos): corré los casos de borde del propio README y sumá uno que el repo no cubre. Mensaje vacío debería dar 422; API key inválida debería dar 502 en /chat y un evento error con status 200 en /chat/stream; una pregunta sin herramienta no debería emitir tool. Ya lo cubrimos antes en un agente que automatiza tareas como Hermes.
El caso extra: abrí el stream con curl -N, cortalo con Ctrl+C a mitad de respuesta y mirá los logs del servidor. Si el agente sigue corriendo y gastando tokens, ya sabés qué tenés que resolver antes de publicar.
Errores comunes
- Mirar solo el status code del stream. En /chat/stream el 200 ya salió cuando falla el agente. Corrección: leé eventos hasta recibir done o error.
- Usar EventSource con un POST. La API nativa del navegador solo manda GET. Corrección: usá fetch() y leé response.body como stream, o una librería SSE con soporte POST.
- Asumir un orden fijo de eventos. Los token y tool se intercalan según el modelo. Corrección: procesá lo que llegue sin depender de la secuencia.
- Tratar el tope de pasos como control de costo. Corta loops, no limita gasto. Corrección: sumá autenticación, rate limiting y límites de tokens por cliente.
- Correr async en Python menor a 3.11 sin config. La documentación de LangGraph pide pasar RunnableConfig a ainvoke() para que el streaming funcione. Corrección: usá Python 3.11+, como pide el repo.
Preguntas Frecuentes
¿Cómo expongo un agente de LangGraph como API con FastAPI?
Compilás el grafo en un módulo aparte y lo llamás desde endpoints FastAPI: uno que espera el resultado final y devuelve JSON, y otro que emite eventos. El repo de ejemplo lo hace con POST /chat y POST /chat/stream, y mantiene el agente separado de la capa HTTP.
¿Cómo hago streaming de las respuestas de un agente con Server-Sent Events?
Declarás el endpoint con response_class=EventSourceResponse (FastAPI 0.135.0 o posterior) y emitís ServerSentEvent con yield mientras iterás astream() de LangGraph. FastAPI envía un comentario keep-alive cada 15 segundos sin actividad, según su documentación.
¿Cuál es la diferencia entre SSE y WebSockets para un agente de IA?
SSE es unidireccional (servidor a cliente) sobre HTTP, y WebSockets es bidireccional. Para respuestas en partes de un agente, SSE suele alcanzar; WebSockets se justifican si el cliente debe enviar datos mientras el agente corre. Es criterio editorial, ninguna de las fuentes lo compara.
¿Cómo conecto una herramienta externa como Open-Meteo a un agente LangGraph?
Definís la herramienta (en el repo, get_weather en app/agents/tools.py), se la exponés al LLM y agregás un nodo tools que ejecute lo que el modelo pida. El resultado vuelve al nodo agent. Open-Meteo no requiere API key, pero su plan gratuito es solo no comercial.
¿Qué le falta a un agente LangGraph con FastAPI para estar listo para producción?
Autenticación, rate limiting, memoria con checkpointing, base de datos, reintentos con idempotencia, observabilidad, secretos, CORS, Docker y health checks reales. El propio README del repo aclara que el ejemplo enseña la arquitectura y no está pensado para desplegarse tal cual.
Conclusión
El repo es una buena base para aprender cómo encajan LangGraph, FastAPI y SSE con una herramienta real, y su contrato de eventos (token, tool, done, error) es claro y fácil de consumir. No es un servicio para publicar.
Mi recomendación: clonalo, corré los casos de borde del README, agregá la prueba de desconexión del cliente y reemplazá Open-Meteo por una API propia. Antes de abrirlo a internet, resolvé autenticación y rate limiting. Todo lo demás (memoria, reintentos, trazas) se agrega después, pero la key expuesta se paga rápido.
Fuentes
- Documentación de LangGraph – Streaming: modos stream/astream, formato v2 y tokens del LLM
- Documentación de FastAPI – Tutorial de Server-Sent Events
- Documentación de FastAPI – Referencia de fastapi.sse
- Repositorio langgraph-fastapi-example – README, estructura y límites del ejemplo
- Tutorial original en dev.to – How to Build a LangGraph Agent with FastAPI and SSE Streaming (14/10/2026)