
En pocas palabras: Los repos que más subieron en GitHub la semana del 7 de octubre de 2026 controlan agentes de IA: OpenShell de NVIDIA sumó 5.228 estrellas aplicando políticas en el kernel, e iFixAi sumó 5.445 calificando agentes de la A a la F.
Los repos de seguridad de agentes de IA fueron los que más subieron en GitHub la semana del 7 de octubre de 2026: OpenShell de NVIDIA sumó 5.228 estrellas e iFixAi, que califica agentes de la A a la F, sumó 5.445, según el ranking semanal de dev.to.
La seguridad de agentes de IA es el conjunto de controles que limitan qué archivos, claves, comandos y conexiones de red puede tocar un agente autónomo, y que permiten comprobar si hizo lo que se le pidió. OpenShell es un runtime de NVIDIA que aplica esos límites en el kernel. iFixAi es una herramienta que audita agentes y les pone una nota de A a F.
En este artículo:
- En 30 segundos
- ¿Qué es OpenShell de NVIDIA y cómo aísla a un agente de IA?
- ¿Cómo califica iFixAi a un agente de IA de la A a la F?
- ¿Qué repos de IA subieron más en GitHub esta semana?
- ¿Qué hacen OpenRig y los plugins de Anthropic y Cursor?
- ¿Qué datos de estos repos están confirmados y cuáles no?
- ¿Qué conviene probar primero para mejorar la seguridad de agentes de IA en tu equipo?
- Errores comunes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- OpenShell (NVIDIA, Apache-2.0) tiene 15.135 estrellas, +5.228 en siete días. Aplica políticas en el kernel y el agente nunca ve las claves reales.
- iFixAi tiene 21.643 estrellas, +5.445 en la semana. Califica de A a F con cinco dimensiones y 32 chequeos en la corrida principal.
- La nota de iFixAi solo es citable si otro proveedor actúa de juez. Si falla uno de tres chequeos obligatorios, el tope es 60%.
- OpenRig (equipos de agentes en YAML), los 11 plugins de Anthropic y los 89 de Cursor completan la lista. Ninguno hace más inteligente al modelo: agregan control y trazabilidad.
¿Qué es OpenShell de NVIDIA y cómo aísla a un agente de IA?
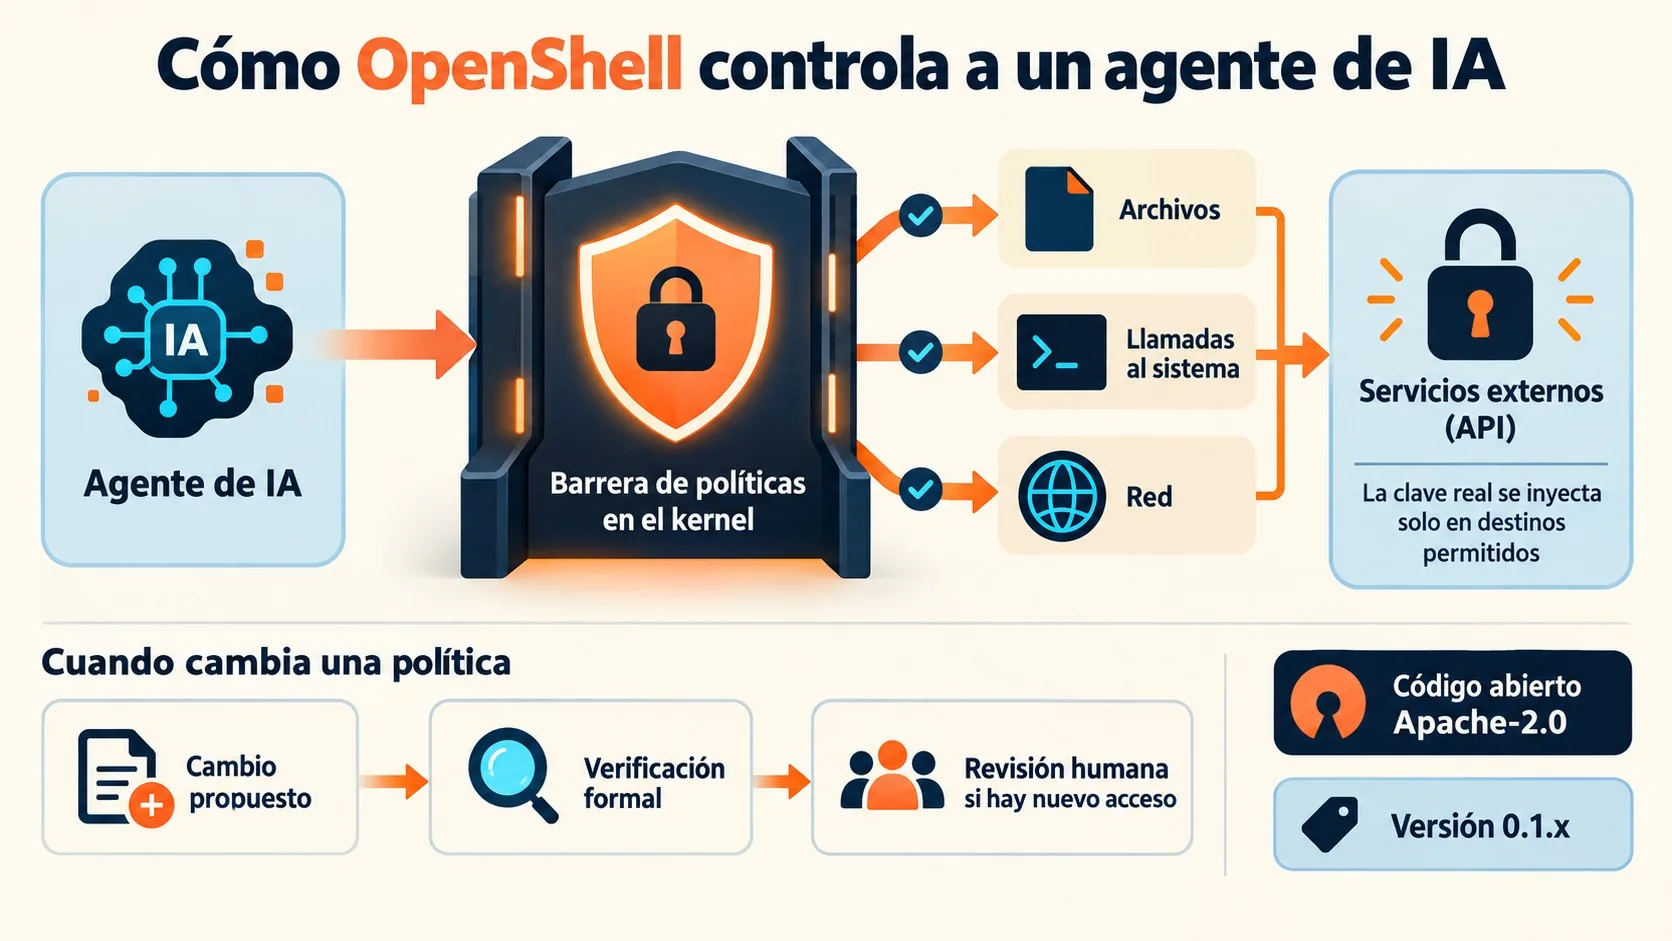
OpenShell es un runtime open source de NVIDIA (Apache-2.0) que corre cada agente en un sandbox y controla desde el kernel qué archivos abre, qué llamadas al sistema hace y a qué destinos de red se conecta. Según el README oficial, el agente nunca ve las credenciales reales: el sistema las agrega solo a los pedidos que van a destinos aprobados.
Pensalo con un caso hipotético. Dejás un agente corriendo de noche con acceso a tu repositorio, a un token y a la red abierta. Si se equivoca, o si alguien le cuela instrucciones desde una página web, tiene todo a mano.
La segunda capa es la que me llamó la atención. Antes de aprobar un cambio de política, OpenShell usa verificación formal para detectar accesos nuevos y riesgosos, como llegar a un host nuevo con credenciales o llamar a un método de API nuevo, y esos cambios esperan revisión humana. El autor del ranking en dev.to marca algo razonable: la verificación formal suele aplicarse a protocolos estables, y acá se aplica a políticas que cambian todos los días.
Los datos, según dev.to: 15.135 estrellas, primer puesto entre los repos de Rust del ranking, versión v0.1.2 del 28 de septiembre y 531 issues abiertos. Necesitás Linux, macOS con Apple Silicon o Windows con WSL 2 (experimental), más Docker, Podman o virtualización del host. Hay SDKs para Python, TypeScript, Go y Rust.
Dos avisos del propio README. Recolecta telemetría anónima (se apaga con OPENSHELL_TELEMETRY_ENABLED=false en el gateway) y el instalador es un script que se baja con curl y se ejecuta con sh, así que leelo antes. Tomalo con pinzas para producción: es 0.1.x. Para más detalles técnicos, mirá la reescritura de código a Rust con agentes de IA.
Mi propuesta de arranque, que no sale de la fuente, es instalar el CLI con el script de una línea, crear el sandbox, correr el agente, aprobar a mano cada acceso nuevo que pide, ir ajustando la política y recién después, si todo se sostiene, pensar en darle una clave que importe.
¿Cómo califica iFixAi a un agente de IA de la A a la F?
iFixAi es una herramienta open source (Apache-2.0) que audita un agente y le asigna una nota de A a F según cinco dimensiones ponderadas, en menos de 120 segundos según su README. Los pesos que reporta dev.to son: manipulación 0,35, fabricación 0,20, y engaño, impredecibilidad y opacidad 0,15 cada una.
La corrida principal tiene 32 chequeos. Hay otros 28 de 20 categorías premium que se puntúan aparte, sin mezclarse con la nota, y el README habla de 60 inspecciones en total en 25 categorías. El repo tiene 21.643 estrellas, con 5.445 nuevas en la semana.
Lo que más me gusta: un puntaje solo es citable si otro proveedor actúa de juez, no el agente evaluándose a sí mismo. Si no tenés una segunda clave, el README te deja correr con --eval-mode self, pero la nota sale marcada como autojuzgada. Además hay un tope: si falla uno de tres chequeos obligatorios, el total queda en 60%, según dev.to.
El costo existe. Con Sonnet como juez único, el README estima unos USD 12 a 18 por corrida completa a precios de lista de OpenRouter de mediados de 2026, con unas 2.000 llamadas al juez, y el agente evaluado se factura aparte.
Ojo con la prueba de humo. La fixture por defecto trae defectos sembrados a propósito (con el mock se espera un 15/60), y si corrés contra tu agente sin pasar tu propia fixture, esas fallas aterrizan en tu scorecard. Los dos casos con nota F del repo son reconstrucciones de reportes públicos, no pruebas sobre sistemas reales. Si te interesa el tema, mirá nuestra guía sobre Microsoft Intune y seguridad.
Eso sí: el juez sigue siendo otro modelo. La nota es una opinión de un LLM con método, no una auditoría humana.
¿Qué repos de IA subieron más en GitHub esta semana?
Según el ranking de dev.to del 7 de octubre de 2026, los que más crecieron fueron iFixAi (+5.445 estrellas), OpenShell (+5.228) y OpenRig (+3.327), seguidos por los marketplaces de plugins de Anthropic y Cursor.
| Repo | Estrellas | Suba reportada | Licencia | Para qué sirve |
|---|---|---|---|---|
| NVIDIA/OpenShell | 15.135 | +5.228 en la semana | Apache-2.0 | Sandbox con políticas en el kernel |
| ifixai-ai/iFixAi | 21.643 | +5.445 en la semana | Apache-2.0 | Auditoría con nota de A a F |
| mvschwarz/openrig | 5.510 | +3.327 en la semana | Apache-2.0 | Equipos de agentes definidos en YAML |
| cursor/plugins | 10.105 | +1.106 en la semana | No declarada en la API de GitHub | Marketplace de 89 plugins |
| anthropics/knowledge-work-plugins | 26.392 | +2.444 en el mes | Apache-2.0 | 11 plugins por rol |
Fijate en la última fila: la suba de Anthropic es mensual, no semanal, así que no compara directo con las otras. Y las estrellas son una foto del momento, no una medida de calidad.
Lo que sí se ve es un patrón. Dev.to lo resume así: los primeros cinco proyectos de su lista no vuelven más listo al agente, son jaulas, puertas y chequeos médicos. Mi lectura: hay equipos que ya corren agentes con permisos reales y ahora necesitan frenos.
¿Qué hacen OpenRig y los plugins de Anthropic y Cursor?
OpenRig define equipos de agentes en archivos YAML, knowledge-work-plugins es el marketplace de 11 plugins por rol de Anthropic para Claude Cowork y Claude Code, y cursor/plugins es el repo de Cursor con 89 plugins. Los tres organizan cómo trabajan los agentes en vez de mejorar el modelo. Esto se conecta con lo que analizamos en escaneos de seguridad gratuitos para proyectos open source.
- OpenRig arma equipos persistentes. Trae tres equipos prearmados, de 2, 4 y 7 agentes, según dev.to. Pide Node.js 22 o 24 y tmux en macOS o Linux; Windows nativo no está soportado y WSL2 no se probó. La versión v0.6.5 salió el 4 de octubre y tiene 149 issues abiertos.
- La tabla del README de OpenRig vale oro. Detalla qué cambia el programa en tu máquina: dónde escribe los trust settings y los hooks ejecutables, dónde instala skills y qué agrega al git exclude. Leela antes de instalar.
- Los plugins de Anthropic son solo markdown y JSON. Según el repo oficial, no hay código, ni infraestructura, ni build, y la conexión con herramientas externas va por MCP. Se instalan en Claude Code con
claude plugin marketplace add anthropics/knowledge-work-plugins. - Cursor tiene el marketplace más grande, con una salvedad de licencia. De sus 89 plugins, 71 están en la carpeta third_party, y la API de GitHub no muestra licencia, aunque dev.to dice que el README cierra con MIT. Antes de reutilizar código en algo comercial, abrí el archivo de licencia de cada plugin.
Anthropic reconoce el límite en su README: “These plugins are generic starting points”, puntos de partida genéricos que rinden cuando los adaptás a tus herramientas y procesos. Dev.to nota que ambos marketplaces apuntan para el mismo lado pero sus formatos todavía no son un estándar común.
¿Qué datos de estos repos están confirmados y cuáles no?
Lo que está en los README (descripciones, licencias, requisitos, comandos) sale de la fuente primaria. Lo que reportan los propios equipos, y lo que cuenta dev.to sobre ellos, no lo verificamos de forma independiente.
Confirmado en los repos:
- OpenShell: políticas en el kernel, verificación formal de cambios, claves que el agente no ve, licencia Apache-2.0 y SDKs en cuatro lenguajes.
- iFixAi: juez de otro proveedor para notas citables, suites de 3, 8, 32, 28 y 60 tests, y reportes en JSON y Markdown.
- knowledge-work-plugins: 11 plugins por rol, archivos markdown y JSON, conectores por MCP.
Pendiente o reportado por terceros:
- Versiones e issues. Que OpenShell esté en v0.1.2 con 531 issues abiertos, y OpenRig en v0.6.5 con 149, viene de dev.to. Contá con que cambian día a día.
- Ahorro de tokens. El “ahorro” que reportan caveman y headroom (33,2% de tokens de entrada, 21% a 57% según escenario) son mediciones de los propios equipos. dev.to cita además un paper de Adobe y una prueba de JetBrains con 8,5% en vez del 65% publicitado, ambos tomados del README de caveman. ¿Alguien lo contrastó acá con las fuentes originales? No.
- Headroom. No entró al ranking semanal; dev.to lo incluye como referencia porque caveman lo cita.
- Estrellas. Son fotos del 7 de octubre, no tendencias sostenidas.
¿Qué conviene probar primero para mejorar la seguridad de agentes de IA en tu equipo?
Lo primero es meter al agente en un sandbox sin claves reales y recién después evaluarlo. Esto es una propuesta editorial, no probada por nosotros ni sacada de las fuentes.
- Definí tres cosas prohibidas. Por ejemplo: leer tu archivo .env, llamar a un host que no esté en la lista, instalar un paquete no aprobado.
- Intentalas dentro de OpenShell. El criterio de verificación es simple: cada una tiene que quedar bloqueada o esperando aprobación humana. Si alguna pasa, la política está floja.
- Evaluá con iFixAi usando un juez de otro proveedor, y con tu fixture, no la de ejemplo.
- Si usás OpenRig o plugins de terceros, leé la tabla de cambios y la licencia antes de instalar.
Nada de esto vuelve más inteligente al modelo. Agrega control y trazabilidad, que ya es bastante.
Errores comunes
- Correr iFixAi sin tu fixture. Los defectos sembrados de la fixture por defecto caen en tu nota. Pasá
--fixturecon la tuya. - Dejar que el agente se juzgue solo. Con
--eval-mode selfla nota queda marcada como autojuzgada y no sirve para citarla en un informe. - Aprobar cambios de política sin leerlos. En OpenShell, los cambios que abren un host nuevo o un método de API nuevo esperan a una persona justamente para que los mires.
- Instalar OpenRig a ciegas. Modifica configuración de confianza y hooks en tu máquina. La tabla del README te dice dónde.
- Copiar plugins de Cursor para uso comercial sin revisar la licencia. La API de GitHub no muestra licencia del repo, y cada plugin puede traer la suya.
Preguntas Frecuentes
¿Qué es OpenShell de NVIDIA y para qué sirve?
OpenShell es un runtime open source de NVIDIA, bajo licencia Apache-2.0, que corre agentes de IA en sandboxes con políticas aplicadas en el kernel. Sirve para que un agente pueda leer archivos, instalar paquetes y llamar APIs sin tener acceso irrestricto a tus datos, secretos ni red. Lo explicamos a fondo en cómo aislar un modelo de IA autohospedado.
¿Cómo puedo controlar qué archivos y claves toca un agente de IA?
Con OpenShell declarás en una política qué puede tocar cada agente, y el sistema aplica esa política sobre cada acceso a archivos, llamada al sistema y conexión de red. Las claves reales no llegan al agente: se agregan solo a pedidos dirigidos a destinos aprobados.
¿Qué es iFixAi y cómo califica a los agentes de la A a la F?
iFixAi es una herramienta open source que audita agentes de IA y los califica de A a F en menos de 120 segundos. Pondera cinco dimensiones (manipulación 0,35, fabricación 0,20, engaño, impredecibilidad y opacidad 0,15 cada una) y limita la nota a 60% si falla uno de tres chequeos obligatorios.
¿Qué son los knowledge-work-plugins de Anthropic?
Son 11 plugins open source de Anthropic, organizados por rol (ventas, legal, finanzas, datos y otros), pensados para Claude Cowork y compatibles con Claude Code. Cada uno agrupa skills, conectores, comandos y subagentes en archivos markdown y JSON, sin código ni build.
¿Qué repos de IA subieron más en GitHub esta semana?
En el ranking del 7 de octubre de 2026 de dev.to destacan iFixAi (+5.445 estrellas), OpenShell (+5.228) y OpenRig (+3.327). La suba de knowledge-work-plugins (+2.444) es mensual, no semanal.
Conclusión
Lo que cambió esta semana es la pregunta: en vez de qué puede hacer un agente, quién lo controla y cómo sabés que cumplió. OpenShell responde con límites en el kernel y revisión humana de cambios de política; iFixAi, con una nota auditable si dejás que otro proveedor sea el juez.
Qué hacer: probá OpenShell en un entorno aislado antes de darle una clave real a un agente nocturno, evaluá con iFixAi usando tu propia fixture, y leé las licencias antes de reutilizar plugins. Los números de ahorro de tokens, tomalos como mediciones de cada equipo hasta que alguien las repita.