En pocas palabras: Para agregar voz a un bot de Discord, pedí el audio a la API de ElevenLabs con un POST al endpoint de text-to-speech que incluya un voice_id válido y el header xi-api-key, y reproducilo con FFmpegPCMAudio de discord.py. El bot necesita permisos Connect y Speak.
Un bot de Discord con voz necesita permisos Connect y Speak, PyNaCl y FFmpeg instalados, una API key de ElevenLabs y un endpoint con un voice_id válido. El tutorial de dev.to omite varios de esos puntos y trae errores de código que dejan al bot mudo.
Un bot de Discord con voz es una aplicación que se conecta a un canal de voz y reproduce audio sintetizado a partir de texto, usando un servicio de text-to-speech (TTS) como ElevenLabs. El bot recibe un comando, pide el audio a la API y lo transmite con FFmpeg a través de discord.py. Sirve para anuncios, respuestas automáticas o personajes de voz en servidores comunitarios.
En este artículo:
- En 30 segundos
- ¿Qué necesita un bot de Discord con voz para hablar en un canal?
- ¿Cómo conectar la API de ElevenLabs con discord.py paso a paso?
- ¿Por qué el código del tutorial original puede fallar?
- ¿Cuánta latencia tiene la voz con IA y qué límites hay?
- ¿Conviene clonar una voz para un bot de Discord?
- Qué está confirmado y qué no
- Errores comunes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El flujo del tutorial es simple: comando
!speak, llamada POST a ElevenLabs con el headerxi-api-key, MP3 de vuelta y reproducción conFFmpegPCMAudio. - El endpoint del ejemplo pone
eleven_monolingual_v1donde la documentación de ElevenLabs espera unvoice_id. El modelo va en el campomodel_id(default:eleven_multilingual_v2, según la documentación consultada en octubre de 2026; puede cambiar, así que revisalo). - Los números del autor (500 ms a 1 s de latencia, 200 requests por minuto en el plan gratuito) no están confirmados en la documentación que consultamos.
- Clonar una voz exige consentimiento de la persona. La cifra de “10 a 20 segundos de audio” del tutorial hay que contrastarla con ElevenLabs antes de usarla.
¿Qué necesita un bot de Discord con voz para hablar en un canal?
Necesita un token de bot con el intent de contenido de mensajes, permisos Connect y Speak en el canal, una versión de Python con soporte vigente (o Node.js), discord.py, aiohttp y una API key de ElevenLabs. Python 3.8 llegó a fin de soporte en octubre de 2024, así que verificá cuál es el mínimo que pide discord.py hoy y no des por buena la versión que figura en tutoriales viejos. A eso hay que sumarle dos cosas que el tutorial no nombra: PyNaCl y FFmpeg instalados en la máquina.
- Token y intents. El tutorial pide un token con intent “Bot” y habilitar
message_contenten el código. Además tenés que activar el Message Content Intent en el portal de desarrolladores de Discord (esto es inferencia nuestra, el tutorial no lo dice). - Permisos de voz. La tabla de problemas comunes del tutorial dice que si el bot entra y no habla, falta que su rol tenga “Connect” y “Speak”.
- PyNaCl y FFmpeg. discord.py necesita PyNaCl para el cifrado de voz y FFmpeg en el sistema para convertir el audio. La fuente no los menciona; el API Reference de discord.py sí documenta
FFmpegPCMAudio. - Secretos fuera del código. Tokens en variables de entorno o en un
.env, nunca en el repo.
Si querés el bot online 24/7, una PC personal que se apaga o se queda sin internet no sirve. Un VPS resuelve eso, por ejemplo en donweb.com, y para un bot que solo hace llamadas HTTP y streamea audio alcanza con una instancia chica.
¿Cómo conectar la API de ElevenLabs con discord.py paso a paso?
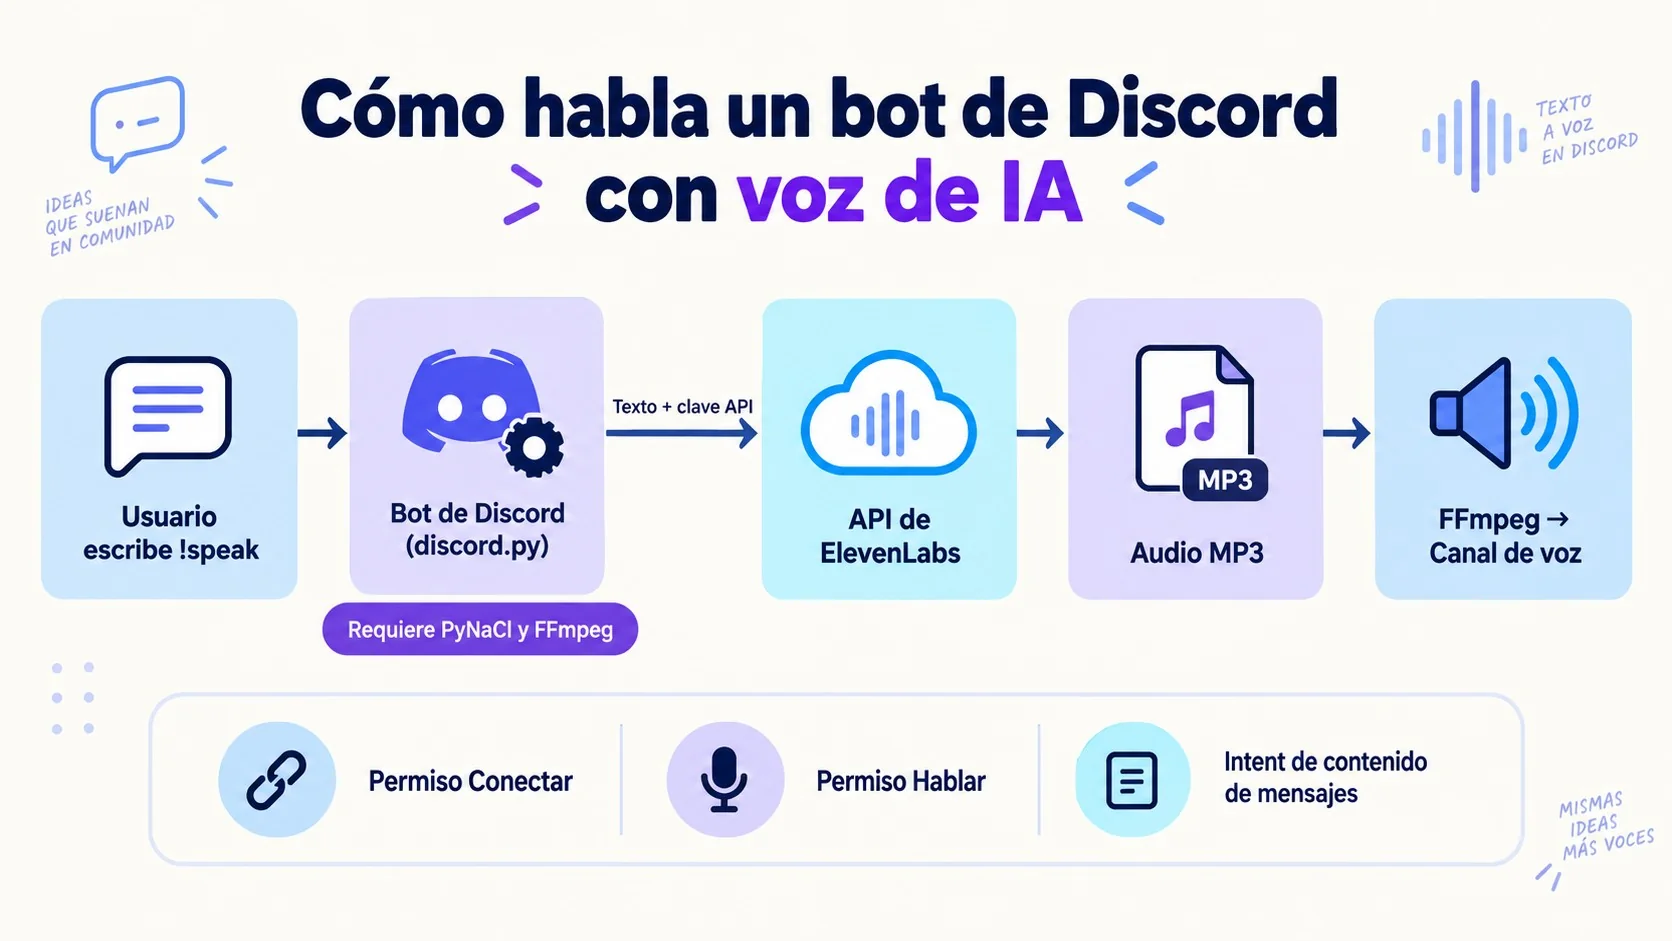
El flujo es: el usuario escribe !speak con un texto, el bot verifica que esté en un canal de voz, se conecta, manda el texto a ElevenLabs por POST con JSON y el header xi-api-key, recibe un MP3 y lo reproduce con FFmpegPCMAudio. Son seis pasos y ninguno es complicado.
- Leer el comando. El bot ignora mensajes de otros bots y corta el texto después de
!speak. - Ubicar al usuario. Si no está en un canal de voz, el bot responde por texto y no hace nada más.
- Conectarse al canal. Una sola vez; después reutiliza la conexión.
- Pedir el audio. POST al endpoint de text-to-speech con
texty, opcionalmente,voice_settings. - Recibir el MP3. Si la respuesta no es 200, el tutorial lanza una excepción y avisa en el canal de texto.
- Reproducir. Se arma una fuente de audio con FFmpeg y se la pasa al cliente de voz.
Los voice_settings del ejemplo son stability 0.5, similarity_boost 0.75, style 0.5 y use_speaker_boost en false. El autor aclara que bajar la estabilidad suena más natural pero más impredecible. La página del endpoint convert no detalla los valores por defecto de esos campos, así que no pudimos confirmarlos. Antes de copiar números, revisalos. Si después querés sumarle al bot respuestas generadas con ChatGPT, tenés todo lo que podés hacer con ChatGPT en nuestra guía.
Si no querés escribir todo desde cero, el repo discord-elevenlabs-tts-bot (licencia MIT, indica Python 3.8+, una versión que ya no tiene soporte oficial: verificá la compatibilidad antes de usarlo) trae comandos slash /say, /voice, /volume (0 a 100) y /stop, más cola de audio y voces por usuario. Es una base más sólida que el snippet de dev.to.
¿Por qué el código del tutorial original puede fallar?
El código del tutorial tiene al menos seis problemas que explican por qué un bot que “conecta” no reproduce audio. Tres los contrastamos contra la documentación o el código; los otros tres son inferencia nuestra al leer el código. Ninguno lo ejecutamos.
- Endpoint equivocado (verificado contra la documentación). La URL termina en
eleven_monolingual_v1, pero la documentación define la ruta como/v1/text-to-speech/{voice_id}, convoice_idobligatorio. El modelo se elige enmodel_id, cuyo default documentado eseleven_multilingual_v2según la documentación de ElevenLabs consultada en octubre de 2026. Ese default puede cambiar, así que confirmalo en la página del endpoint. - Falta
import io(verificado en el código). Usaio.BytesIOsin importarlo y explota conNameError. - Falta
pipe=True(según la documentación de discord.py).FFmpegPCMAudiorecibe un nombre de archivo por defecto; para pasarle bytes en memoria hay que indicarpipe=True. Confirmá el parámetro en la página enlazada del API Reference. - Falta PyNaCl (inferencia). El tutorial no lo menciona y tampoco figura en las fuentes consultadas; sin esa dependencia, la conexión de voz puede fallar.
- El cliente de voz (inferencia). El código guarda en
vcel canal y después llama avc.play. Un canal no reproduce audio; hay que usar el objeto que devuelveconnect(). - El snippet de streaming (inferencia). Descarga desde una URL, escribe en un FFmpeg aparte y después crea otro
FFmpegPCMAudio("pipe:0")que no está conectado a nada. No une el audio de ElevenLabs con el reproductor.
Subís el tutorial, lo pegás, ponés el token, ejecutás, ves “Playing: hola” en el chat y el canal sigue en silencio, y recién después de media hora mirando logs te das cuenta de que el error estaba antes de que el audio existiera. Con código así, es lo esperable.
Una propuesta de verificación (nuestra, no de la fuente): primero reproducí un MP3 local fijo para aislar a Discord y FFmpeg. Recién cuando suene, probá la llamada a ElevenLabs y fijate que devuelva 200 antes de enchufarla al reproductor.
¿Cuánta latencia tiene la voz con IA y qué límites hay?
El autor del tutorial afirma que la respuesta de ElevenLabs tarda entre 500 ms y 1 s según la carga. Es una declaración suya, sin medición adjunta, y la documentación que consultamos no da una cifra de latencia. Tomalo como orden de magnitud y medilo en tu propio servidor. Cubrimos ese tema en detalle en nuestra guía sobre los modelos GPT.
Lo que sí figura en la documentación del endpoint:
- Formato de salida. El default es
mp3_44100_128. MP3 de 192 kbps exige plan Creator o superior, y PCM o WAV a 44,1 kHz exigen plan Pro o superior. - Latencia configurable, pero deprecada.
optimize_streaming_latency(valores de 0 a 4) figura como deprecated. No construyas el bot alrededor de ese parámetro. - Idioma.
language_codeno se admite en los modelos multilingual_v2, que es el default. El tutorial recomienda fijar el código de idioma en el payload; con ese modelo, no tendría efecto.
Sobre el tope de 200 requests por minuto en el plan gratuito que menciona el tutorial: no lo encontramos en la documentación consultada. Revisá los límites vigentes de tu plan en ElevenLabs antes de dimensionar nada.
El autor propone dos tácticas: pre-fetch con una cola de audios listos (por ejemplo, cachear los últimos 10 mensajes) y streaming para no esperar el archivo completo. El pre-fetch tiene sentido para frases repetidas, como anuncios fijos. El streaming es más trabajo y el ejemplo de la fuente no funciona tal cual, así que lo dejaría para una segunda versión. Como extensión, la fuente sugiere reconocimiento de voz con Whisper o respuestas generadas con ChatGPT; ninguna de las dos se desarrolla ahí.
Y el síntoma de “entra pero no habla”: revisá primero Connect y Speak en el canal, y después todo lo de la sección anterior.
¿Conviene clonar una voz para un bot de Discord?
Casi nunca. Según el tutorial, la clonación sirve para personajes distintivos, es más compleja que el TTS común y puede tener más latencia por el tamaño del modelo. Para anuncios y respuestas genéricas, una voz predefinida alcanza y se implementa en menos tiempo. Sobre eso hablamos en la llegada de GPT-6 Astra a Copilot.
El flujo que describe: subir una muestra, recibir un voice_id y usarlo en el pedido de TTS. Dice que alcanzan 10 a 20 segundos de audio. No pudimos confirmarlo en la documentación consultada, así que no lo tomes como requisito oficial; fijate qué pide ElevenLabs hoy para el tipo de clonación que elijas.
Sobre la legalidad: la fuente solo advierte que hay que tener consentimiento de la persona cuya voz se clona. No analiza leyes, y nosotros tampoco podemos darte asesoramiento legal. Si el bot imita a un streamer o a un conocido, pedí autorización por escrito y revisá los términos de ElevenLabs y de Discord.
Transparencia: el tutorial incluye un link de prueba gratuita de ElevenLabs que parece de afiliado. No lo enlazamos acá.
Qué está confirmado y qué no
- Confirmado en la documentación de ElevenLabs (consultada en octubre de 2026). Ruta con
voice_idobligatorio,model_idcon defaulteleven_multilingual_v2, formato de salida por defectomp3_44100_128, parámetro de latencia deprecado. - Declaraciones del autor, sin verificar. Latencia de 500 ms a 1 s, 200 requests por minuto gratis, 10 a 20 segundos para clonar, soporte de streaming.
- Inferencia nuestra. Necesidad de PyNaCl, bug del objeto
vc, snippet de streaming desconectado, habilitar el Message Content Intent en el portal. - Pendiente. Ninguno de estos fixes fue ejecutado por nosotros. Probalos en un servidor privado.
Errores comunes
- Copiar el endpoint sin tocarlo. Poner un nombre de modelo donde va el
voice_iddevuelve error. Corrección: usá/v1/text-to-speech/{voice_id}y mandá el modelo en el cuerpo. - Dar por buenos los defaults del ejemplo. Cambian el sonido de la voz. Corrección: revisá los valores en la documentación de ElevenLabs y después ajustá.
- Olvidar los permisos por canal. El rol puede tener Speak en el servidor y estar denegado en ese canal. Corrección: revisá los overrides del canal.
- Subir tokens al repo. Corrección: variables de entorno o
.env, y regenerá el token si ya se filtró. - Clonar una voz sin permiso. Corrección: consentimiento explícito de la persona, antes de subir cualquier muestra.
Preguntas Frecuentes
¿Cómo hago que mi bot de Discord hable en un canal de voz?
Conectá el bot al canal con discord.py, generá el audio con una API de text-to-speech y reproducilo con FFmpegPCMAudio sobre el cliente de voz que devuelve connect(). Necesitás PyNaCl, FFmpeg y permisos Connect y Speak. Tema relacionado: qué cambia con GPT-5.6 Sol.
¿Cómo conecto ElevenLabs con un bot de Discord en Python?
Hacé un POST a /v1/text-to-speech/{voice_id} con el header xi-api-key y un JSON que lleve text. La respuesta es audio, por defecto en mp3_44100_128, que le pasás a FFmpeg con pipe=True si lo tenés en memoria.
¿Qué permisos necesita un bot de Discord para hablar en un canal de voz?
Necesita Connect y Speak en el canal. Según el tutorial, si falta alguno el bot entra pero no reproduce audio. Revisá también los permisos específicos del canal, que pueden pisar los del rol.
¿Por qué mi bot de Discord se conecta al canal de voz pero no reproduce audio?
Las causas probables son permisos Speak ausentes, PyNaCl o FFmpeg sin instalar, y errores del código del tutorial (io sin importar, falta de pipe=True, usar el canal en vez del cliente de voz). Aislá el problema reproduciendo primero un MP3 local.
¿Se puede clonar una voz para un bot de Discord y es legal?
Técnicamente, ElevenLabs ofrece clonación y entrega un voice_id para usar en el TTS. Sobre la legalidad, las fuentes solo piden consentimiento de la persona. La respuesta depende de tu país y de los términos de cada plataforma, así que consultá a un abogado si el uso es público o comercial.
Conclusión
El tutorial de dev.to sirve como mapa del flujo, no como código para pegar. La idea es correcta: comando, API de ElevenLabs, MP3, FFmpeg. Pero el endpoint está mal armado, faltan dependencias y el reproductor usa el objeto equivocado. Mi consejo: armá el bot con los parámetros de la documentación oficial, probá la reproducción con un MP3 local antes de sumar la API y, si querés ahorrar tiempo, partí del repo con licencia MIT. Dejá la clonación de voz y el streaming para cuando lo básico ande, y tratá como no confirmados todos los límites y latencias que el autor da sin respaldo.