En pocas palabras: La API de Claude se cobra por consumo, en dólares por millón de tokens: en octubre de 2026 va desde USD 0,10 de entrada y USD 0,50 de salida con Haiku 5.5 hasta USD 10 y USD 50 con Fable 5.1. Sonnet 5.5 cuesta USD 2 y 10.
El precio API Claude depende del modelo y se cobra por millón de tokens: en octubre de 2026 va desde USD 0,10 de entrada con Haiku 5.5 hasta USD 10 con Fable 5.1, y de USD 0,50 a USD 50 de salida. En siete pasos calculás tu gasto real.
La API de Claude es la interfaz de Anthropic para integrar los modelos Claude en aplicaciones propias. Se factura por consumo: pagás tokens de entrada (el prompt) y de salida (la respuesta), en dólares por millón de tokens (MTok), sin cuota fija. Es un esquema distinto al de las suscripciones Pro o Max de claude.ai, que tienen precio mensual y límites de uso.
En este artículo:
- En 30 segundos
- Qué vas a necesitar
- Paso 1: Entender cómo cobra Anthropic la API y qué es un token
- Paso 2: Ver el precio de la API de Claude por modelo y por millón de tokens
- Paso 3: Calcular el costo de una llamada a la API de Claude
- Paso 4: Bajar el costo con Batch API y prompt caching
- Paso 5: Revisar qué cargos extra pueden aumentar la factura
- Paso 6: Elegir el modelo de Claude según el uso y el presupuesto
- Paso 7: Controlar el gasto de la API de Claude para evitar sorpresas
- Resultado final
- Errores comunes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Tarifas por MTok (entrada / salida): Haiku 5.5 desde USD 0,10 / 0,50, Sonnet 5.5 USD 2 / 10, Opus 5.5 USD 4 / 20 y Fable 5.1 USD 10 / 50.
- Fórmula de costo: tokens de entrada ÷ 1.000.000 × tarifa de entrada, más tokens de salida ÷ 1.000.000 × tarifa de salida.
- Ejemplo de referencia: una llamada de 10.000 tokens de entrada y 1.000 de salida cuesta USD 0,03 en Sonnet 5.5.
- Dos palancas de ahorro: Batch API descuenta 50% y las lecturas de caché cuestan entre 2,5% y 10% del precio de entrada, según el modelo.
- Ojo con el tokenizador: desde Claude 4.7 el mismo texto genera cerca de 30% más tokens, así que medí con tus textos y no por cantidad de palabras.
Qué vas a necesitar
Para proyectar tu gasto alcanza con una cuenta, un intérprete de Python y tres números propios que vas a sacar de tu caso de uso.
- Acceso a la Claude Console: según la documentación de modelos, ahí armás y probás prompts desde el navegador. Cómo cargar saldo y qué medios de pago acepta no figura en las páginas de precios que usamos, así que confirmalo dentro de la Console.
- Python 3 (gratis): cualquier versión reciente sirve para correr la calculadora del Paso 3. Si preferís una planilla, la fórmula es la misma.
- Tres datos tuyos: tokens de entrada típicos por llamada, tokens de salida típicos y cuántas llamadas hacés por mes. Si todavía no los tenés, estimalos con un prompt de prueba.
- Las páginas oficiales abiertas: la tabla de precios de la plataforma y claude.com/pricing. Los precios cambian a discreción de Anthropic, y lo que ves acá es lo que figuraba en esas páginas a octubre de 2026.
Costo de arrancar: la API no tiene cuota mensual fija, pagás lo que consumís. El resto de las herramientas es gratis.
Paso 1: Entender cómo cobra Anthropic la API y qué es un token
Anthropic suma en cada llamada los tokens de entrada (system prompt, historial, documentos y definiciones de herramientas) y los de salida (lo que genera Claude), y los cobra en USD por MTok. Así lo detalla la página oficial de precios, que aclara que los tokens del parámetro tools también cuentan como entrada.
Ponele que armás un bot de soporte: recibe un reclamo de 300 palabras, le pegás un system prompt de 2.000 y devuelve 150 palabras de respuesta. ¿Cuánto pagás? Depende de cuántos tokens son esas palabras, y ahí está la trampa.
Según la misma documentación, Claude 4.7 y los modelos posteriores usan un tokenizador nuevo que produce cerca de un 30% más de tokens para el mismo texto, con un aumento exacto que depende del contenido. Sonnet 4.6 y anteriores usan el tokenizador previo. Si migrás un workload viejo a un modelo nuevo y comparás solo la tarifa por MTok, te perdés ese 30%.
Resultado esperado: entendés que la unidad de cobro es el token y que tu cuenta se arma con dos tarifas distintas por modelo.
Ojo: contar palabras y multiplicar por un factor viejo es el error más común de este paso.
¿Cuántos tokens son mil palabras en español con Claude?
Las fuentes oficiales no publican una equivalencia entre palabras y tokens para el español, así que no hay una cifra confiable para citar. La única referencia concreta es el aumento de cerca de 30% en tokens con el tokenizador de los modelos 4.7 en adelante. Para saber tu número, mandá un texto representativo y leé el campo usage de la respuesta (lo vemos en el Paso 3).
¿Cuál es la diferencia entre pagar Claude Pro y pagar la API?
Claude Pro es una suscripción con precio mensual y límites de uso; la API es pago por token sin tope fijo. En claude.com/pricing, Pro cuesta USD 17 por mes con suscripción anual (USD 200 por adelantado) o USD 20 si pagás mes a mes, y Max arranca en USD 100 mensuales con 5x o 20x más uso que Pro.
Los límites de esos planes se reinician en una ventana móvil de cinco horas y los planes pagos suman límites semanales. La actividad en web, escritorio, móvil y Claude Code sale del mismo pozo de uso. El plan Enterprise combina un seat de USD 20 por mes (facturado anual) con consumo a tarifas de API, lo que confirma que el precio por MTok es la vara de la plataforma.
Mi lectura: si usás Claude en el chat, la cuenta se hace con la suscripción. Si tu aplicación llama a Claude, se hace con tokens. Las fuentes no indican que Pro incluya crédito de API, así que tratalos como gastos separados.
Paso 2: Ver el precio de la API de Claude por modelo y por millón de tokens
Los cuatro modelos actuales cuestan, por millón de tokens, entre USD 0,10 y USD 10 de entrada y entre USD 0,50 y USD 50 de salida. La tabla sale de la página de precios de la plataforma y de claude.com/pricing.
| Modelo | Entrada (USD/MTok) | Salida (USD/MTok) | Pensado para |
|---|---|---|---|
| Claude Fable 5.1 | 10 | 50 | Razonamiento exigente y trabajo agéntico de largo horizonte |
| Claude Opus 5.5 | 4 | 20 | Codificación agéntica y trabajo de conocimiento de larga duración |
| Claude Sonnet 5.5 | 2 | 10 | Mejor combinación de velocidad e inteligencia |
| Claude Haiku 5.5 (prompts hasta 100K tokens) | 0,10 | 0,50 | Clasificación, extracción y ruteo de alto volumen |
| Claude Haiku 5.5 (prompts de más de 100K tokens) | 0,50 | 2,50 | Igual, con prompts largos |
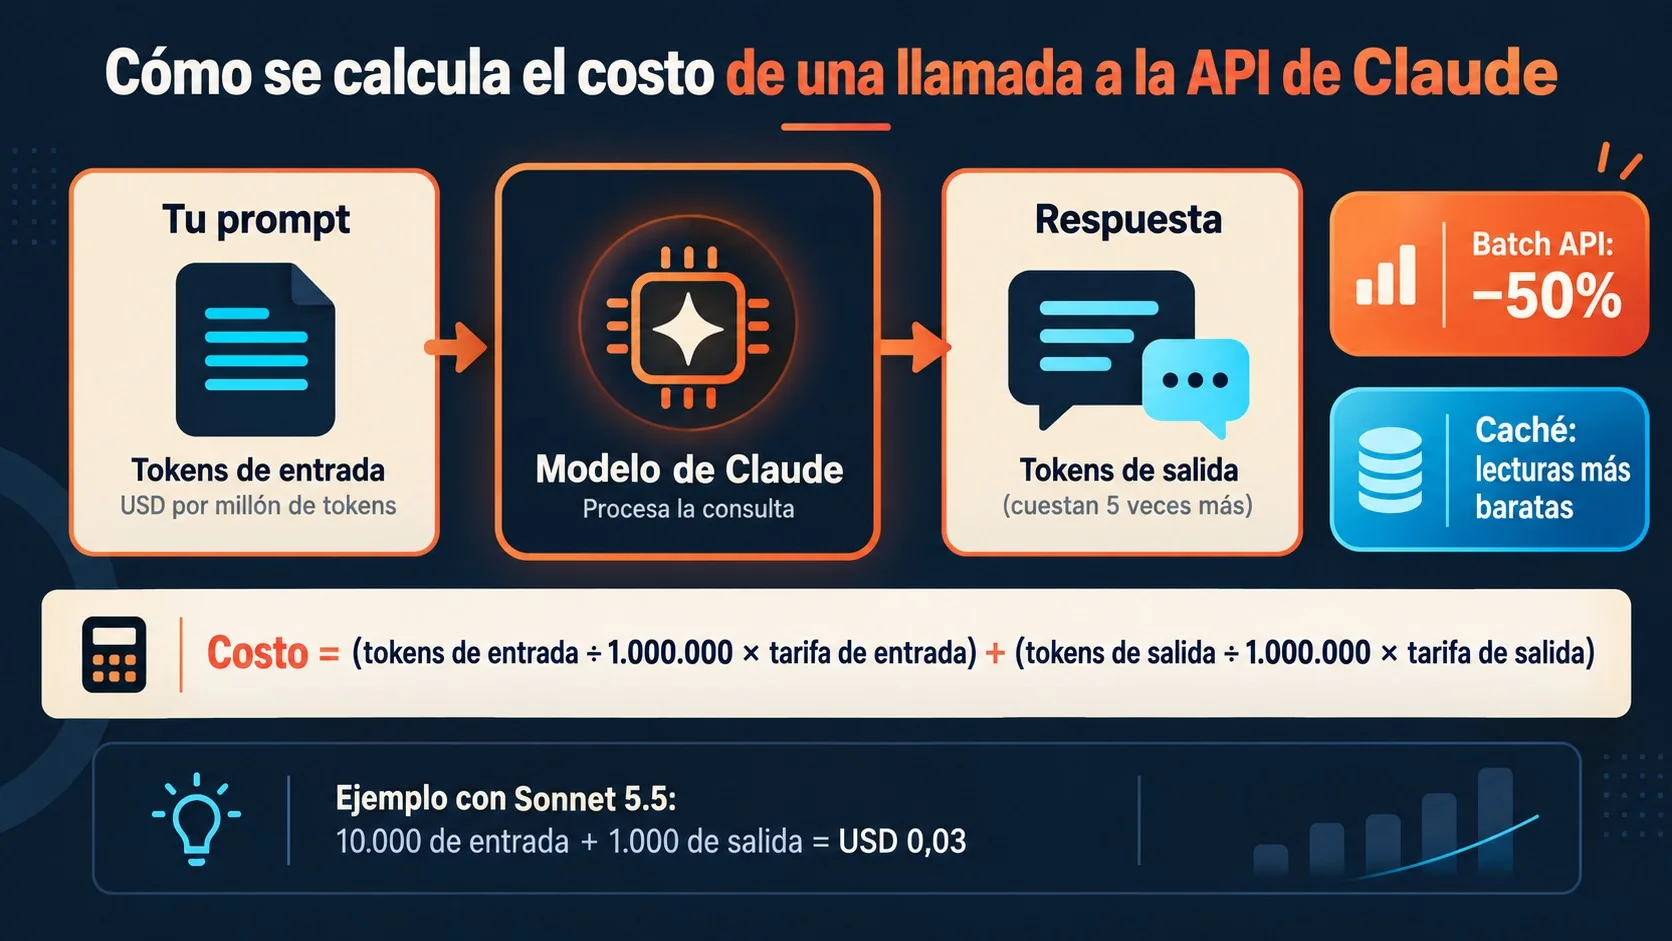
Los cuatro tienen ventana de contexto de 1M de tokens y salida máxima de 128K, según la página de modelos. Un patrón que conviene grabarse: en todos, la salida cuesta cinco veces la entrada.
El tema es qué pasa con los modelos viejos. La misma tabla oficial sigue listando versiones anteriores, y algunas salen bastante más caras que las actuales:
- Opus 4.1 y Opus 4: USD 15 de entrada y USD 75 de salida, es decir 3,75 veces lo que cuesta Opus 5.5.
- Opus 5, 4.8, 4.7, 4.6 y 4.5: USD 5 / 25 (Opus 5.5 es 20% más barato que Opus 5).
- Sonnet 4.6, 4.5 y 4: USD 3 / 15. Sonnet 5 figura a USD 2 / 10 en claude.com/pricing.
- Haiku 4.5: USD 1 / 5, y Haiku 3.5: USD 0,80 / 4.
- Fable 5, Mythos 5 y Mythos 5.1: USD 10 / 50.
Resultado esperado: tenés la tarifa de entrada y de salida del modelo que te interesa, y sabés si entra en el tramo de hasta 100K tokens de Haiku 5.5.
Ojo: citar precios de generaciones anteriores como si fueran los vigentes. Tarifas como Haiku 3.5 a USD 0,80 / 4 y Opus 4.1 a 15 / 75 corresponden a modelos legacy y no a los actuales. Revisá siempre la tabla oficial.
Paso 3: Calcular el costo de una llamada a la API de Claude
El costo de una llamada es la suma de dos multiplicaciones: tokens de entrada por la tarifa de entrada y tokens de salida por la tarifa de salida, ambas divididas por un millón.
costo = (tokens_entrada / 1.000.000 x tarifa_entrada)
 + (tokens_salida / 1.000.000 x tarifa_salida)
Para no hacerlo a mano cada vez, este script compara los cuatro modelos con los precios de la tabla del Paso 2:
# Precios en USD por millón de tokens: (entrada, salida)
PRECIOS = {
 "Fable 5.1": (10.00, 50.00),
 "Opus 5.5": (4.00, 20.00),
 "Sonnet 5.5": (2.00, 10.00),
 "Haiku 5.5": (0.10, 0.50), # solo prompts de hasta 100K tokens
}

def costo_llamada(modelo, tokens_entrada, tokens_salida):
 p_in, p_out = PRECIOS[modelo]
 return tokens_entrada / 1_000_000 * p_in + tokens_salida / 1_000_000 * p_out

for modelo in PRECIOS:
 print(modelo, round(costo_llamada(modelo, 10_000, 1_000), 5))
Con 10.000 tokens de entrada y 1.000 de salida, el resultado esperado es este:
- Fable 5.1: USD 0,15 por llamada.
- Opus 5.5: USD 0,06.
- Sonnet 5.5: USD 0,03.
- Haiku 5.5: USD 0,0015.
Ahora el caso liviano. Una llamada de clasificación a Haiku 5.5 con 2.000 tokens de entrada y 300 de salida cuesta USD 0,00035, o sea USD 35 cada 100.000 llamadas. Para proyectar el mes, multiplicá por tu volumen: 1.000 llamadas diarias de 10.000/1.000 en Sonnet 5.5 son 30.000 llamadas mensuales, y a USD 0,03 cada una da USD 900. Sobre eso hablamos en diferencias entre usar la API o MCP.
Eso sí: la estimación vale lo que valgan tus tokens. Para medir el consumo real, la respuesta de la API trae un objeto usage con los tokens de entrada y de salida de esa llamada (por ejemplo, "usage": {"input_tokens": 2000, "output_tokens": 300}, valores ilustrativos). Cuando usás caché, la respuesta también separa los tokens escritos y leídos de caché; confirmá los nombres exactos de los campos en la documentación antes de armar tu panel.
Ojo: el script usa la tarifa del tramo de hasta 100K tokens de Haiku. Si tus prompts pasan ese umbral, cambiá los precios a 0,50 y 2,50.
Paso 4: Bajar el costo con Batch API y prompt caching
Batch API descuenta 50% en entrada y salida para trabajos asíncronos, y el prompt caching cobra las lecturas de caché a una fracción de la tarifa de entrada. Según la documentación oficial de precios, una lectura (cache hit) cuesta 10% del precio base de entrada en general, 5% en Opus 5.5 y Sonnet 5.5, y 2,5% en Fable 5.1 y Mythos 5.1.
| Modelo | Lectura de caché (USD/MTok) | Escritura 5 min | Escritura 1 h | Batch (entrada / salida) |
|---|---|---|---|---|
| Fable 5.1 | 0,25 | 12,50 | 20 | 5 / 25 |
| Opus 5.5 | 0,20 | 5 | 8 | 2 / 10 |
| Sonnet 5.5 | 0,10 | 2,50 | 4 | 1 / 5 |
| Haiku 5.5 (hasta 100K) | 0,01 | 0,125 | 0,20 | 0,05 / 0,25 |
Las escrituras de caché cuestan 1,25 veces la entrada base para 5 minutos y 2 veces para una hora. La documentación aclara que el caché de 5 minutos se amortiza con una sola lectura y el de una hora con dos. Los multiplicadores se apilan con el descuento de Batch API y con la residencia de datos.
Un escenario hipotético para ver el efecto: tenés un system prompt de 20.000 tokens en Sonnet 5.5 y hacés 100 llamadas dentro de la ventana de 5 minutos.
- Sin caché: 100 × 20.000 = 2M de tokens de entrada × USD 2 por MTok = USD 4,00.
- Con caché: una escritura (20.000 × USD 2,50 por MTok = USD 0,05) más 99 lecturas (1,98M × USD 0,10 por MTok = USD 0,198), cerca de USD 0,25.
Eso es solo la parte de entrada; la salida se cobra igual. Y si tu tráfico no repite el prompt dentro de la ventana, escribís el caché, pagás el recargo y no lo leés nunca (el “ahorro” que te cuesta más caro).
Para Batch, retomá el ejemplo del Paso 3: la llamada de 10.000/1.000 en Sonnet 5.5 baja de USD 0,03 a USD 0,015, en Opus 5.5 de USD 0,06 a USD 0,03 y en Fable 5.1 de USD 0,15 a USD 0,075. La regla práctica es caché para prompts largos y repetidos, y Batch para lo que no necesita respuesta inmediata (reportes nocturnos, clasificación masiva, evaluaciones).
Ojo: Batch no se combina con fast mode, que no está disponible para trabajos por lotes.
Paso 5: Revisar qué cargos extra pueden aumentar la factura
Cinco cosas pueden subir tu factura por encima del cálculo base: fast mode, inferencia solo en EE. UU., el tramo largo de Haiku 5.5, las herramientas del lado del servidor y las respuestas largas.
- Fast mode: en research preview para Opus 5.5, cuesta USD 8 de entrada y USD 40 de salida por MTok, el doble del estándar. claude.com/pricing habla de hasta 2,5 veces más velocidad. La llamada de 10.000/1.000 pasa de USD 0,06 a USD 0,12.
- Inferencia solo en EE. UU.: el parámetro
inference_geocon valor “us” aplica un multiplicador de 1,1x en todas las categorías, incluidas escrituras y lecturas de caché. Sobre Sonnet 5.5, la llamada de ejemplo pasa de USD 0,03 a USD 0,033. - Tramo largo de Haiku 5.5: los prompts de más de 100K tokens pagan USD 0,50 / 2,50 en lugar de 0,10 / 0,50. Los demás modelos vigentes cobran toda la ventana de 1M al mismo precio por token.
- Herramientas del servidor: la búsqueda web cuesta USD 10 cada 1.000 búsquedas, sin contar los tokens de entrada y salida. La ejecución de código da 50 horas gratis por día por organización y después USD 0,05 por hora por contenedor. Managed Agents cobra USD 0,08 por hora-sesión de ejecución activa, más tokens a tarifa estándar.
- Salida larga: como la salida cuesta cinco veces la entrada, una respuesta de 4.000 tokens pesa más que un prompt de 10.000.
Capa aparte: si usás Claude desde Amazon Bedrock o Google Cloud, esas plataformas tienen precios regionales propios que se consultan en cada proveedor. Claude Platform on AWS y Claude en Microsoft Foundry facturan en Claude Consumption Units (CCU) a USD 0,01 cada una, con las mismas tarifas por token. Esto se conecta con lo que analizamos en usar Claude en Make.com sin API key.
Resultado esperado: sabés qué multiplicadores aplican a tu configuración y los sumaste a la fórmula del Paso 3.
Ojo: mandar inference_geo a un modelo anterior a Claude 4.6 devuelve error (más en la sección de errores).
Paso 6: Elegir el modelo de Claude según el uso y el presupuesto
Para tareas simples de alto volumen conviene Haiku 5.5, para uso general Sonnet 5.5, y para trabajo agéntico complejo Opus 5.5 o Fable 5.1. La documentación de modelos recomienda “empezar con Claude Opus 5.5 para la mayoría de las cargas de trabajo” (traducción nuestra) y reservar Fable 5.1 para cuando tus evaluaciones con Opus 5.5 en esfuerzo alto no alcanzan.
| Modelo | Velocidad (según la documentación) | Llamada de 10.000 / 1.000 tokens | Con Batch API |
|---|---|---|---|
| Haiku 5.5 | La más rápida | USD 0,0015 | USD 0,00075 |
| Sonnet 5.5 | Rápida | USD 0,03 | USD 0,015 |
| Opus 5.5 | Moderada | USD 0,06 | USD 0,03 |
| Fable 5.1 | Más lenta | USD 0,15 | USD 0,075 |
Mirá la distancia: Fable 5.1 sale 100 veces más que Haiku 5.5 para la misma llamada, y Sonnet 5.5 sale 20 veces más. Subís el modelo “por las dudas”, lo dejás corriendo sobre miles de documentos, nadie revisa si la tarea necesitaba tanto, a fin de mes llega la factura y recién ahí alguien pregunta por qué un clasificador de tickets usaba el modelo más caro del catálogo.
Un ejemplo con números. Procesar 10.000 documentos con Sonnet 5.5, a 3.000 tokens de entrada y 500 de salida cada uno, suma 30M de tokens de entrada (USD 60) y 5M de salida (USD 50): USD 110 en total, o USD 55 con Batch API.
Mi criterio, que es una inferencia a partir de estos números y no el resultado de pruebas propias: ruteá. Mandá a Haiku 5.5 lo que sea clasificación, extracción o ruteo (para eso lo describe la documentación) y escalá a Sonnet u Opus solo los casos donde el barato falla. Medí cuánto se escala y recién ahí decidí. Cobertura relacionada: armar un agente de IA en n8n.
Ojo: elegir por intuición y no por evaluación. Un modelo más caro no garantiza mejor resultado en tu tarea. Nuestros colegas de donweb.news lo analizan en proteger tu API key con middleware en Node.js.
Paso 7: Controlar el gasto de la API de Claude para evitar sorpresas
Para no llevarte sorpresas, fijá un tope de tokens de salida por llamada, registrá el usage de cada respuesta y revisá el consumo por modelo todas las semanas. Con esos tres hábitos detectás una fuga antes de que llegue la factura.
- Limitá la salida: el parámetro
max_tokenscorta la respuesta, y como la salida es la parte cara, es el control más barato que tenés. - Guardá el uso por llamada: anotá modelo, tokens de entrada, tokens de salida y proyecto. Con eso la fórmula del Paso 3 te da el gasto real y no el estimado.
- Fijá una política de modelo por tarea: qué tarea va a qué modelo, escrito, para que nadie suba el modelo sin justificarlo.
- Revisá los controles de la Console: no verificamos en las fuentes qué presupuestos, alertas o límites por clave ofrece hoy la Console para la API. claude.com/pricing sí lista controles de gasto por usuario y por organización en Team y Enterprise (planes de claude.ai), pero no son lo mismo. Confirmalo en tu cuenta antes de depender de ellos.
Hay preguntas que las fuentes de esta nota no responden, y prefiero decirlo antes que inventar: no traen información sobre créditos de prueba para la API (el plan Free es para chatear en claude.ai), ni sobre límites de uso por nivel, ni precios de OpenAI o Gemini para comparar. Si necesitás comparar con otro proveedor, usá la misma fórmula, tomá la tarifa por MTok de cada uno y medí los tokens con tus propios textos, porque cada tokenizador cuenta distinto. Lo explicamos a fondo en nuestra guía completa sobre Claude.
Si además tu aplicación corre en un servidor propio, el hosting y el dominio son un costo aparte de los tokens; para infraestructura en Argentina podés mirar donweb.com.
Resultado final
Al terminar tenés tres cosas: la tarifa de entrada y salida de cada modelo vigente, una calculadora en Python que devuelve el costo por llamada y una proyección mensual con tu volumen. También sabés qué multiplicadores (Batch, caché, fast mode, EE. UU.) cambian ese número.
Para verificarlo, corré el script del Paso 3 con tus tokens típicos y comparalo con el usage de diez llamadas reales. Si la diferencia es grande, el problema casi siempre está en la estimación de tokens, no en la fórmula.
Errores comunes
Estimar tokens por cantidad de palabras
Ocurre en los Pasos 1 y 3. Pasa porque desde Claude 4.7 el tokenizador genera cerca de 30% más tokens para el mismo texto, según la documentación, y un factor viejo te deja corto. Solución: mandá tres o cuatro prompts reales, leé usage en cada respuesta y calculá el promedio con esos números.
Calcular solo la entrada y olvidarse de la salida
Ocurre en el Paso 3. La salida cuesta cinco veces la entrada en los cuatro modelos actuales, así que un chat que responde largo se dispara aunque el prompt sea corto. Solución: sumá siempre los dos términos de la fórmula y poné un max_tokens razonable.
Cachear un prompt que no se vuelve a usar
Ocurre en el Paso 4. La escritura de caché cuesta 1,25x (5 minutos) o 2x (1 hora) la entrada base, y sin lecturas nunca se recupera. Solución: activá caché solo en prefijos que se repiten dentro de la ventana, y para el de una hora asegurate de tener al menos dos lecturas.
Error 400 al enviar inference_geo a un modelo anterior a Claude 4.6
Ocurre en el Paso 5. Según la documentación de precios, los modelos anteriores no admiten el parámetro y las solicitudes que lo incluyen devuelven un error 400. Solución: sacá inference_geo de la solicitud o pasá a un modelo 4.6 o posterior, sabiendo que “us” suma 1,1x. Algo parecido pasa con speed: "fast" en Opus 4.7, que devuelve error.
Preguntas Frecuentes
¿Cuánto cuesta la API de Claude por millón de tokens?
Depende del modelo: Haiku 5.5 arranca en USD 0,10 de entrada y USD 0,50 de salida, Sonnet 5.5 cuesta USD 2 y USD 10, Opus 5.5 USD 4 y USD 20, y Fable 5.1 USD 10 y USD 50. Son los valores de la página oficial de precios a octubre de 2026.
¿Cuál es el modelo de Claude más barato para usar por API?
Claude Haiku 5.5 es el más barato de la tabla oficial, con USD 0,10 por MTok de entrada y USD 0,50 de salida en prompts de hasta 100K tokens. Por encima de ese umbral sube a USD 0,50 y USD 2,50. Con Batch API baja a USD 0,05 y USD 0,25.
¿Cómo calculo cuánto me va a costar una llamada a la API de Claude?
Multiplicá los tokens de entrada por la tarifa de entrada, los de salida por la de salida, dividí todo por un millón y sumá. Con 10.000 tokens de entrada y 1.000 de salida, Sonnet 5.5 cuesta USD 0,03 por llamada.
¿Cuánto descuenta la Batch API de Claude?
La Batch API descuenta 50% en tokens de entrada y de salida para procesamiento asíncrono. En Sonnet 5.5 las tarifas pasan a USD 1 y USD 5 por MTok. No se puede usar junto con fast mode.
¿Se pueden combinar prompt caching y Batch API?
Sí, los multiplicadores de caché se apilan con el descuento de Batch API y con la residencia de datos, según la documentación oficial de precios. Las lecturas de caché cuestan 10% del precio base de entrada en general, 5% en Opus 5.5 y Sonnet 5.5, y 2,5% en Fable 5.1.
Conclusión
Con la fórmula de dos términos y la tabla del Paso 2 ya podés poner un número a tu proyecto antes de escribir la primera línea de código. Conviene repetir el cálculo cada vez que cambies de modelo, subas el volumen o agregues herramientas, porque Anthropic puede modificar planes y precios cuando quiera.
El siguiente paso lógico es medir tráfico real durante una semana, ver qué parte del prompt se repite (candidata a caché) y qué tareas pueden esperar (candidatas a Batch). Después probá bajar de modelo en las tareas simples. En un volumen alto, la diferencia entre Haiku 5.5 y Sonnet 5.5 pesa más que cualquier otro ajuste.